製造業多智能體系統的設計模式、反模式與架構選擇
Taxonomy of multi-agent design patterns, anti-patterns, and lessons from manufacturing
AWS Machine Learning Blog 梳理多智能體協調模式與常見反模式,並提供按任務及製造業限制選擇架構的指引。文章將模式分為由開發者預設流程的 Tier 1,以及由模型在執行時決定流程的 Tier 2,建議由 Tier 1 起步,僅在子任務需於執行過程中浮現時採用 Tier 2。
文章區分預先定義流程與模型自主決策兩類編排,並以製造業的延遲、安全與邊緣數據限制,説明各自適用情境和較簡單的架構選擇。
企業團隊正建立多代理系統;當早期實作未達預期,原因很少在於模型。多代理協調是分散式系統問題,而許多着手處理這個問題的團隊,尚未建立處理分散式系統所需的思維方式。
多個來源的數字一致:約 88% 的 AI 試點項目從未投入正式環境。Stanford HAI 證明,當協調開銷超過效益時,兩個模型協作的表現可能比各自單獨運作更差。模式很明顯:團隊增加複雜度的速度,快於建立理解的速度。十個各自有 95 % 可靠度的步驟,端到端可靠度只有 59.9%;20 個步驟則只有 35.8%。這個示意模型假設流程是嚴格循序的鏈式流程,並且沒有重試;但整體趨勢仍然成立:每次依賴其他步驟的交接都會增加風險。
在本文中,你會瞭解如何判斷某個使用情境是否需要多個代理、如何選擇協調模式,以及如何及早發現代價高昂的反模式。你亦會看到節拍時間、安全界限、邊緣數據和輪班週期如何影響架構。
多代理協調模式
協調模式按流程由誰控制分為兩個層級。在第一層,你會界定路徑。
在第二層,模型會在執行時選擇路徑。這種靈活性適用於無法預先界定步驟的工作,但代價是消耗更多 token、增加延遲,亦令除錯更困難。實際上,預設做法是先從第一層開始,只有在工作過程中才會浮現子任務時,才將任務移至第二層。
第一層:模式(確定性控制流程)
1.1 循序管線:實現線性執行的協調模式,每個節點的輸出都會傳送至下一個節點(A -> B -> C),以支援有序處理及可預測的執行時間
在下圖中,輸入會傳送至代理 A(擷取),再到代理 B(轉換),然後到代理 C(驗證),最後輸出。用戶在建置時定義這個順序,執行時不會作出任何決定。因此,這條管線容易除錯和測試,成本亦可預測。常見用途包括文件處理、擷取、轉換和載入(ETL)流程,以及保養索償分類。
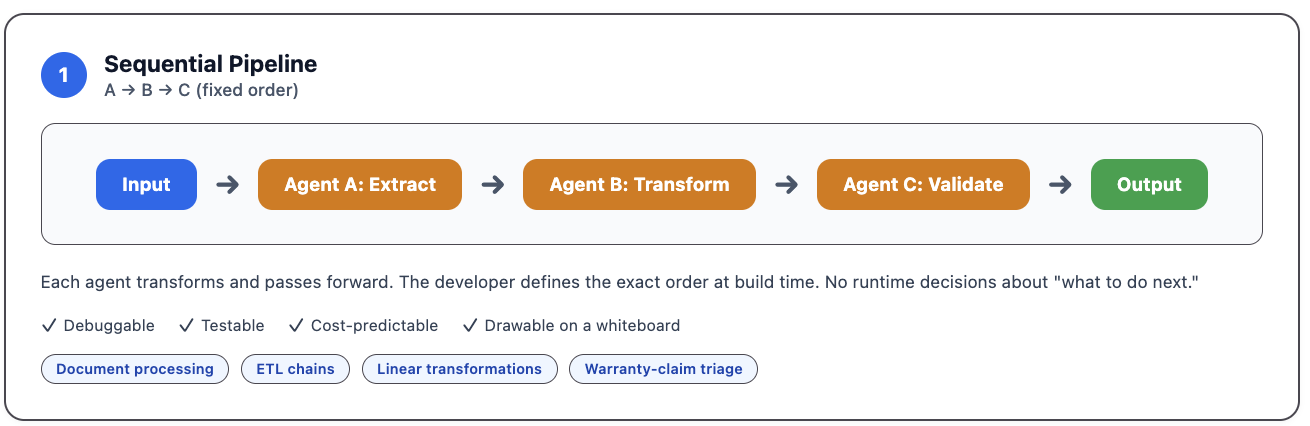
圖 1:循序管線中,每個代理的輸出都會傳送至下一個代理,依次進行擷取、轉換和驗證
1.2 條件式工作流程:以邏輯為基礎的連線會按條件選取下一個節點,讓工作流程可以分支,並將不同個案導向不同路徑。
在下圖中,用戶請求會傳送至代理 A(編寫程式碼),然後到代理 B(測試程式碼)。通過/失敗檢查會將通過的工作傳送至代理 D(部署)。失敗的工作會返回代理 A 重試,最多重試 N 次,之後再升級至由人員處理。協調層會強制執行這個上限,例如透過 AWS Step Functions 的迭代次數上限,避免形成本文稍後所述、沒有上限的迭代反模式。
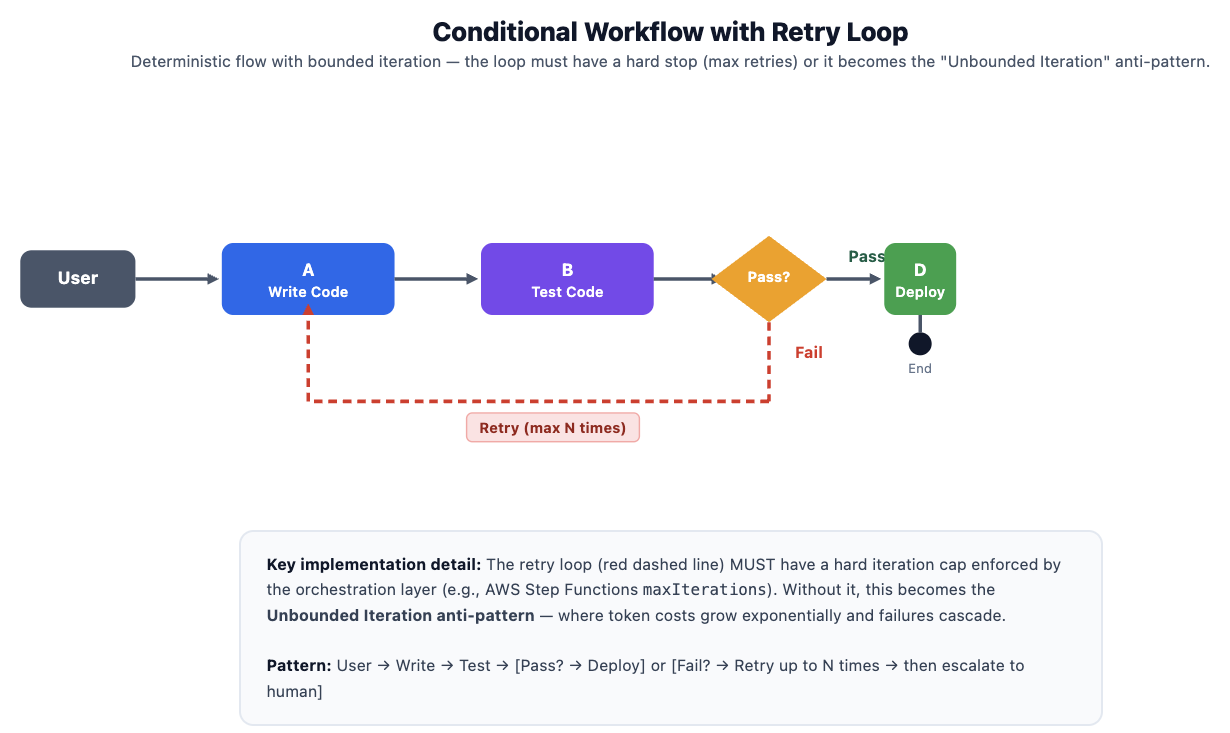
圖 2:條件式工作流程會在失敗時重試,最多 N 次,之後升級至由人員處理
1.3 條件式路由:
分類步驟會檢視輸入內容,並將其導向合適的處理路徑。每個請求只會執行一條路徑。最適用於意圖導向派送、品質閘口判斷、客戶查詢路由和異常分類。
以下圖示展示一名工廠主管的請求如何由分類器讀取,並只傳送給一個專責 Agent。查詢零件是否符合規格的請求會交給 Quality Agent;設備逾期保養的請求會交給 Maintenance Agent;更改輪班安排的請求則會交給 Scheduling Agent。這項判斷在入口點作出。
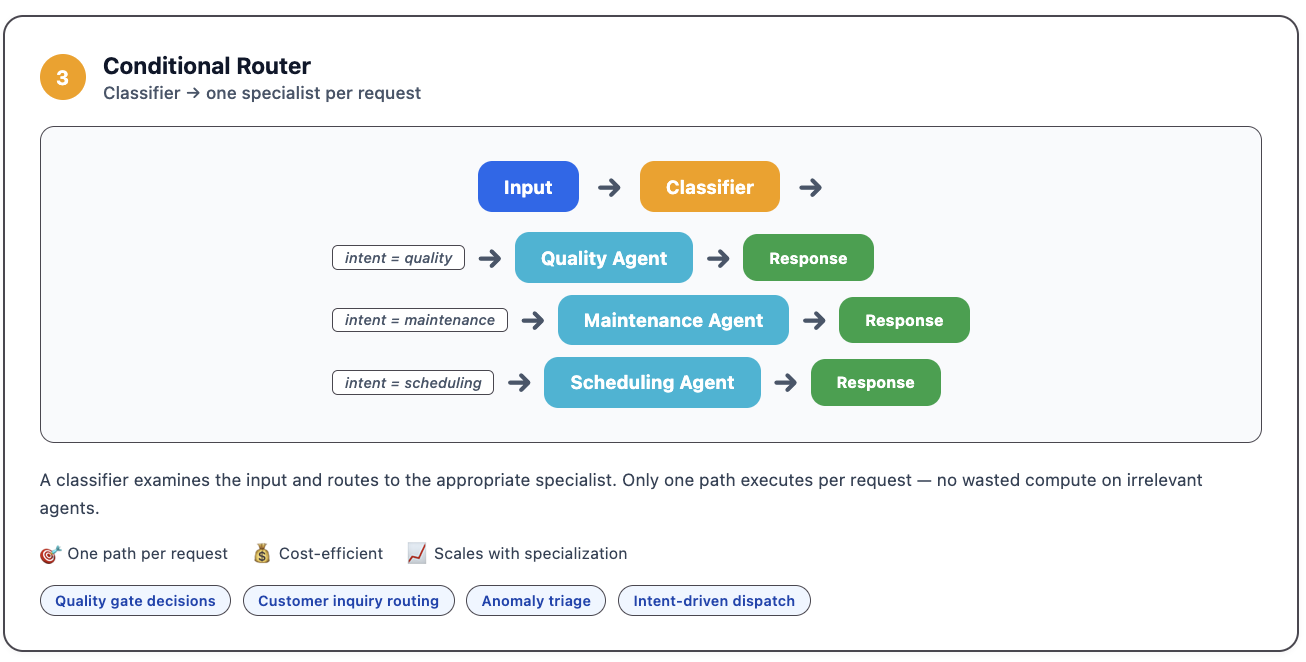
圖 3:條件式路由器會為每項請求執行一條路徑,並在升級至人工處理前進行有上限的重試
1.4 平行工作流程:一項任務會拆分為互相獨立的子任務,由不同處理器同時執行,各自使用自己的資料。所有處理器完成後,扇入步驟會合併結果;如果其中一條路徑失敗,只會重試該路徑。這種模式適用於多來源分析、批次處理,以及可拆分為互相獨立部分的工作。
以下圖示展示研究協調器如何拆解任務,並將其分派給三個同時運作的專責 Agent:財務數據 Agent、地緣政治 Agent 和物流 Agent,各自分析自己的資料來源。合併步驟會等待三個 Agent 全部完成,再綜合結果、解決衝突,並排列研究結果。延遲時間等於速度最慢的單一 Agent 所需的時間,而非三個 Agent 所需時間的總和。
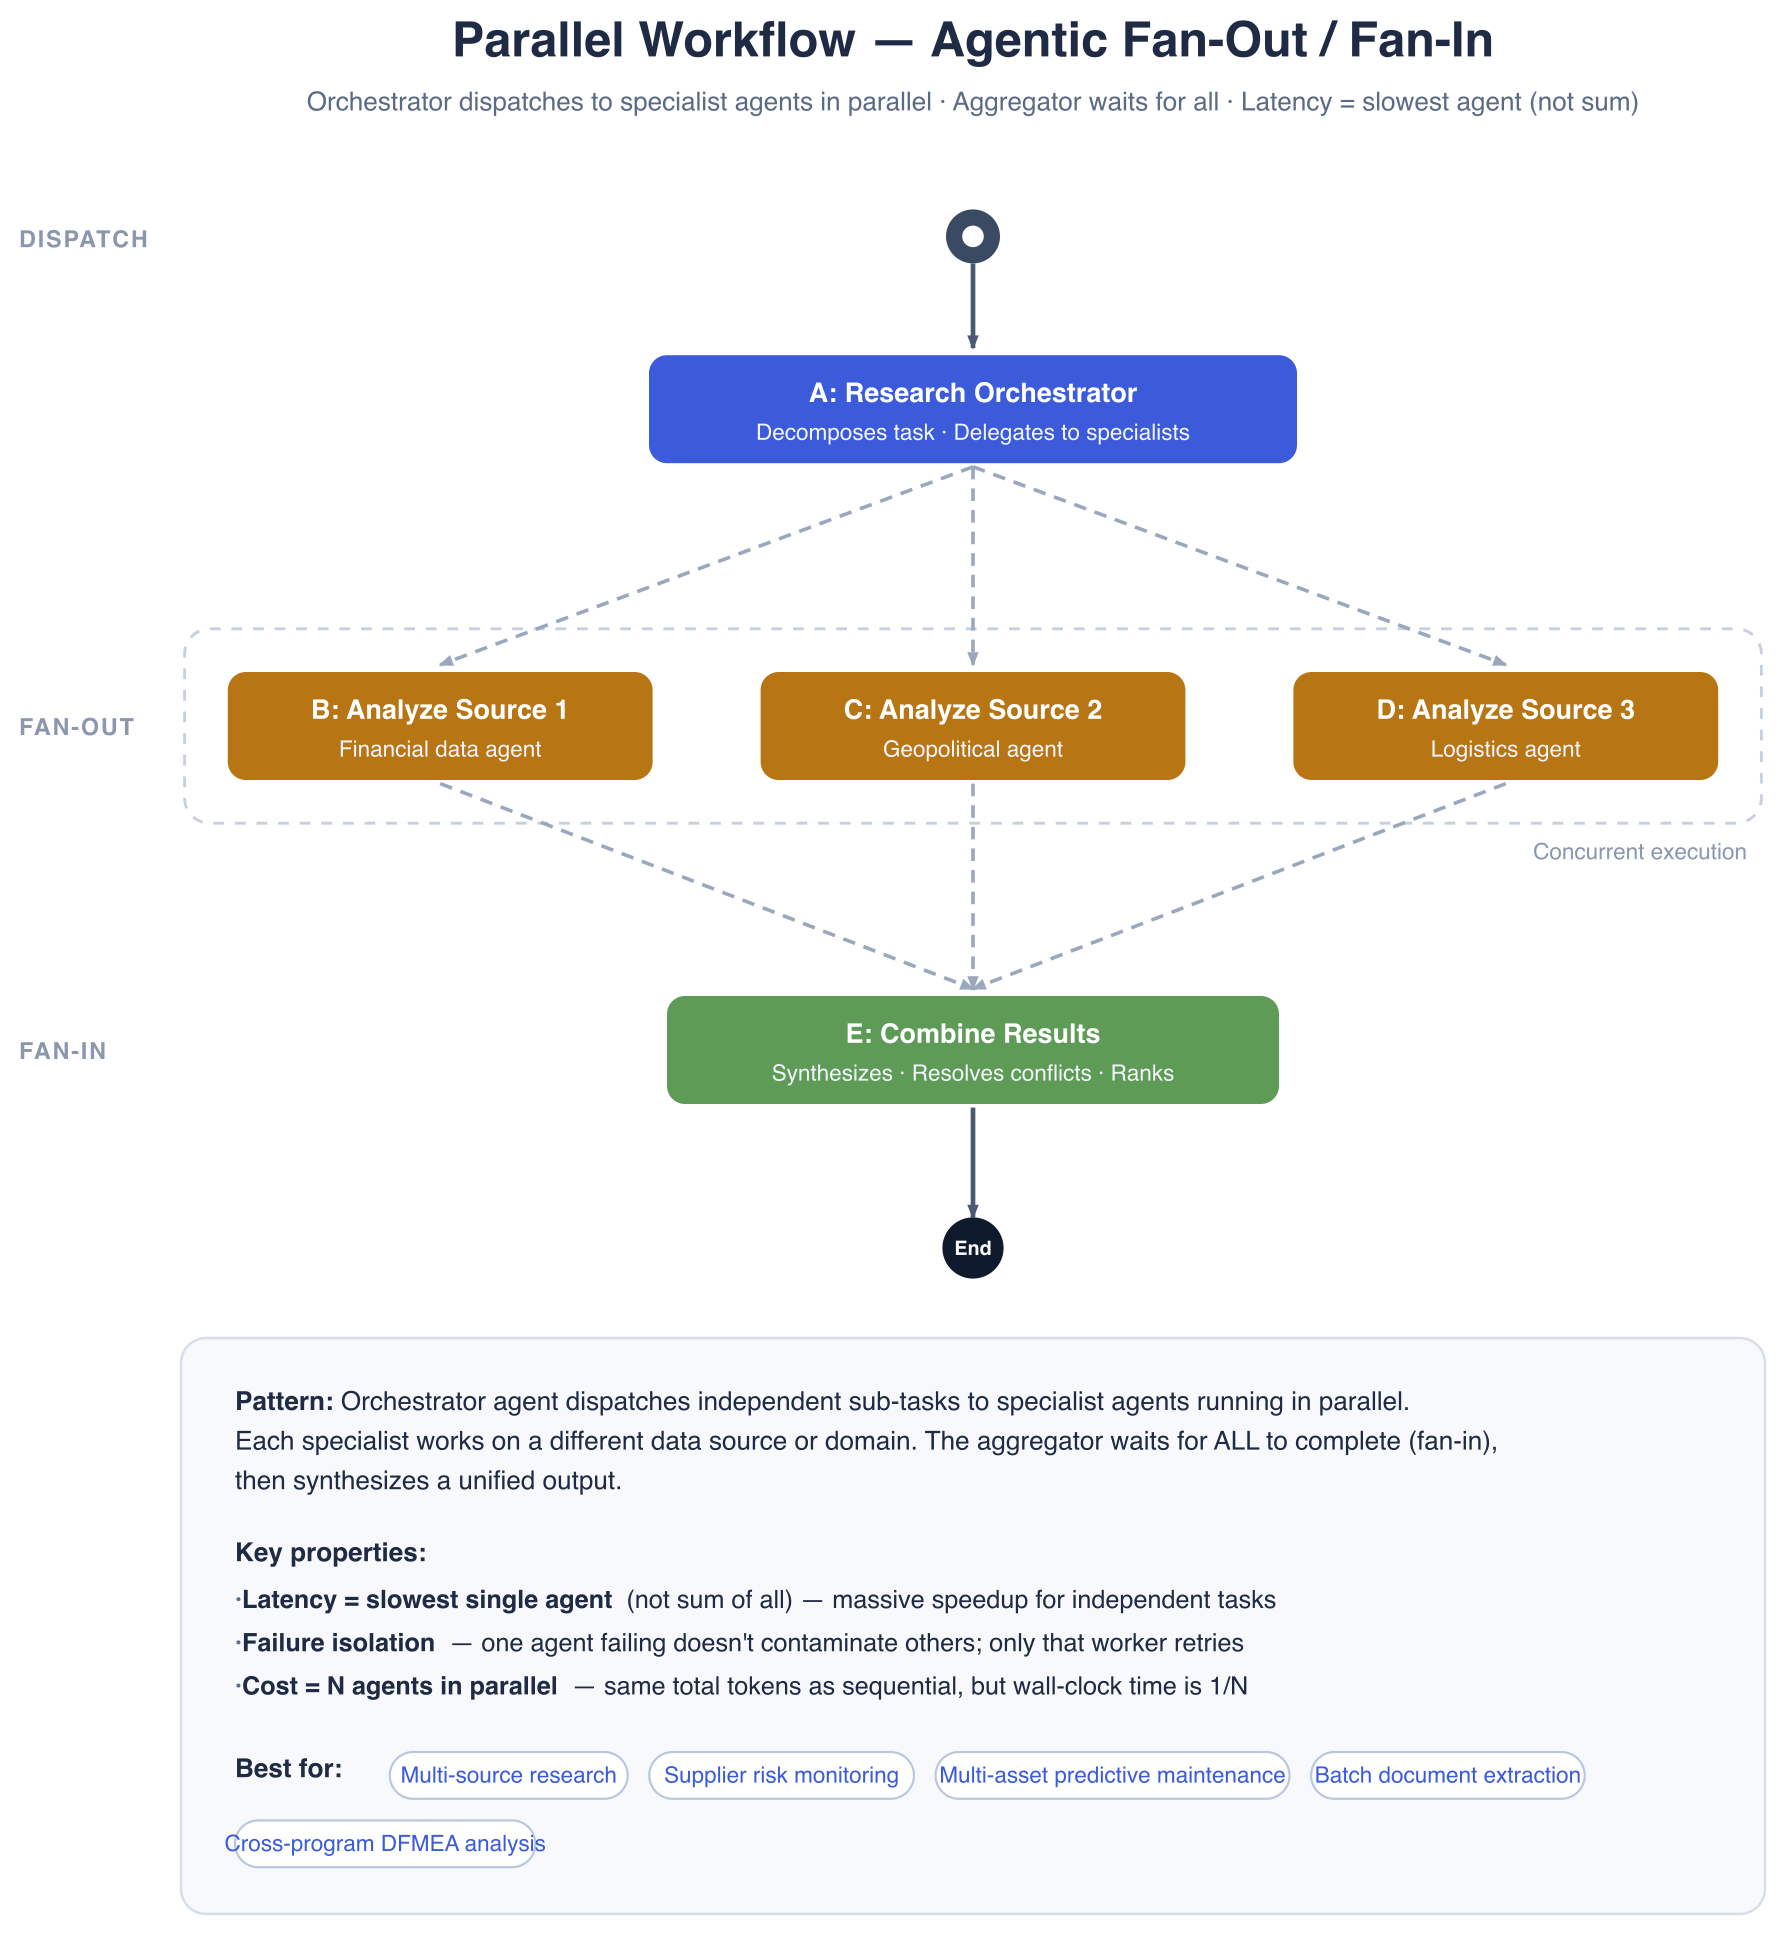
圖 4:以扇出方式將任務分派給專責 Agent,再透過扇入步驟綜合並排列結果
第二層:自主模式(由 LLM 決定控制流程)
在自主模式中,控制流程由 AI 模型本身在執行時決定,而非由開發人員預先設定。Agent 會讀取任務狀態,推理所需工作,並透過共享上下文協調,而非沿着固定路徑運作;這類模式涵蓋由結構化協調至完全自然浮現的行為等不同程度。
2.1 以計劃為本的協調
在以計劃為本的協調中,單一協調 Agent 會充當項目經理。協調 Agent 會維護一份明確的任務計劃,列出工作分配和相依關係;它可查看所有上下文,而每個工作 Agent 只會收到分配給自己的部分;它會根據目前計劃動態分配工作,並集中監察進度。關鍵設計選擇是讓工作 Agent 保持無狀態且互相獨立。如果其中一個 Agent 失敗,不會影響其他 Agent。協調 Agent 只會重試失敗的工作 Agent,而非整個工作流程。
以下圖示展示規劃 Agent 如何將任務拆解成明確的計劃,並把每個步驟分派給工作 Agent。每個步驟都會交由專責工作 Agent 處理(例如研究 Agent、分析 Agent 和報告 Agent),而每個 Agent 只會看到分配給自己的部分。
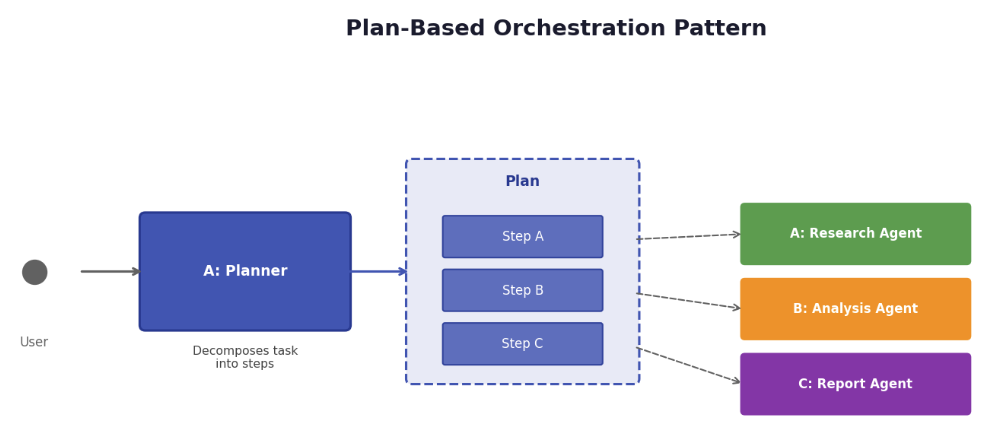
圖 5:以計劃為本的協調,由規劃 Agent 把每個步驟分派給無狀態的工作 Agent
2.2 交接模式
Agent 只掌握有限的本地資訊,並透過點對點委派協調。每個 Agent 會根據任務及自己所認識的 Agent,自行決定何時以及向誰移交控制權。控制權會連同狀態一併傳遞:每次移交都會附上經驗證的任務狀態、相關證據,以及任何尚未解決的問題,讓接收 Agent 可以繼續處理,而非重新解讀摘要。若交接只透過對話內容進行,就不算真正的交接。
以下圖示展示客戶服務 Agent 如何連同上下文,把控制權移交給技術支援 Agent 或帳單 Agent;技術支援 Agent 亦可進一步移交給資深工程師。每個 Agent 只認識一小羣可供移交的同伴。
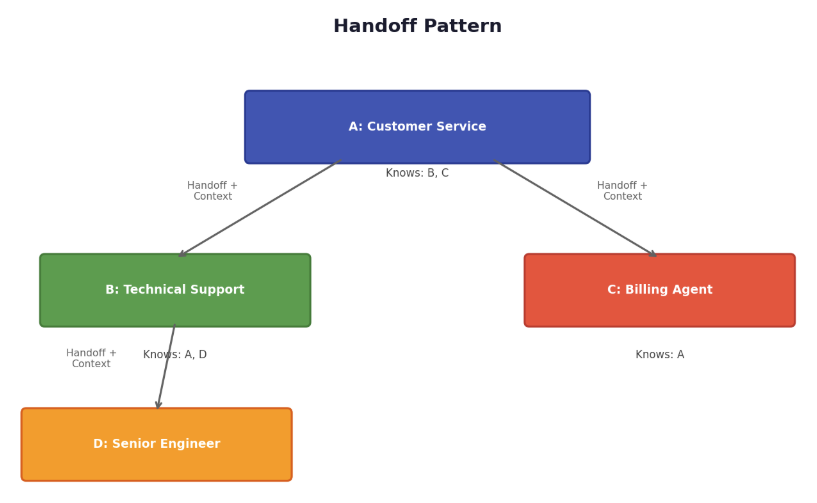
圖 6:交接模式透過本地委派,在同級 Agent 之間傳遞經驗證的狀態
2.3 由對話驅動的模式
在對話驅動模式(亦稱羣組聊天模式)中,所有 Agent 都參與同一個共享對話;編排透過輪流發言自然形成,而非依靠明確計劃或有結構的交接。這反映人類團隊協作的方式:每個人都能看到討論內容,並在適當時作出貢獻。
在下圖中,Agent 選擇機制會決定輪到誰發言,而 Agent A、B 和 C 各自為同一個共享對話作出貢獻;每一輪均包括一則訊息和一次工具呼叫。選擇機制決定發言輪替方式,而狀態則隱含於對話歷史中。
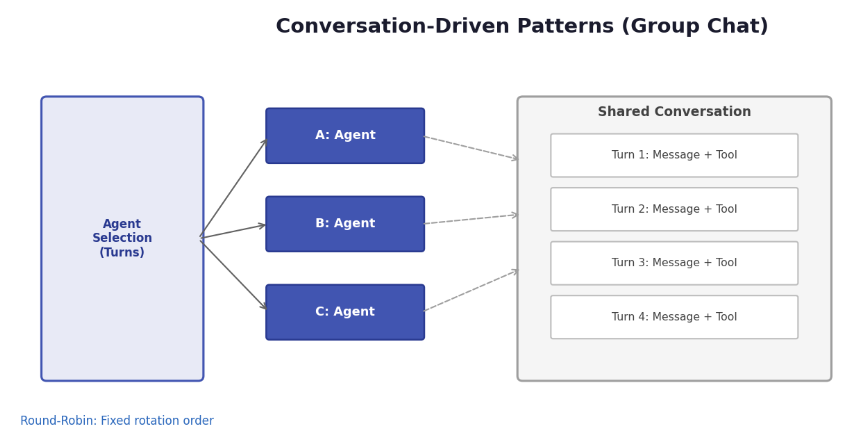
圖 7:對話驅動模式,由輪流發言選出下一個 Agent,狀態則隱含於對話中
控制流程特性:
- 可見度:廣播式,所有 Agent 都會看到共享對話中的所有訊息。
- 決策方式:根據對話上下文選擇下一位發言者,而非按預先制定的計劃。
- 狀態管理:隱含於對話歷史中。
- Turn-taking: Determined by selection mechanisms (round-robin, AI-driven)
- 輪替制。Agent 按固定且不斷重複的次序輪流發言,直至符合終止條件,令流程具可預測性。
- AI 驅動模式。由模型根據對話上下文選擇下一位發言者,而非依照固定次序。
2.4 辯論/共識
多個 Agent 會獨立評估相同輸入,再以多數決、由裁決 Agent 決定,或在意見不一時升級處理,來協調各自的結論。與對話驅動模式不同,Agent 在確立立場前不會看到其他 Agent 的推理過程,因此分歧能提供有用資訊,而不會因社交因素而趨於一致。
謹慎使用。辯論是這裏成本最高的模式;用於感知任務時,帶來的只是延遲,而非準確度提升(參見下文反模式 3 中的品質檢查案例)。只應用於高風險、低數量的決策;在這些情況下,判斷錯誤的代價高於審議所需的成本。
混合方式
實際上,大多數正式環境系統會按任務分解方式結合多種模式:
- 使用工作流程模式處理可預測且理解透徹的組件。
- 在靈活性和適應能力不可或缺的情況下,採用自主模式。
- 在所有編排類型中一致地實施任務管理模式(終止、委派)。
- 設計階層式組合,讓複雜 Agent 在內部不同層級採用不同模式。
核心原則:模式與任務相匹配。應按每項任務的固有特性及系統的可靠性要求選擇編排方式,而非強行以單一模式處理所有事情。
耗費預算的反模式
以下五種反模式在設計時看似合理,但日後都會導致 token 成本膨脹、錯過節拍時間窗口,或令決策在不知不覺間與生產現場脱節。
1. 全能 Agent
一個 Agent 在單一提示詞下配備 15 個或更多工具,負責整體設備效率(OEE)分析、可編程邏輯控制器(PLC)診斷和維護工作。隨着工具數量增加,工具選擇的表現會下降;出現問題時亦難以追查原因。
修正方法:限制每個 Agent 使用五個或以下工具,例如 OEE 分析 Agent、故障診斷 Agent 和維護文件撰寫 Agent。
2. 無限制迭代
Agent 不斷重試「再試一次」,卻沒有硬性停止上限。四個 Agent 組成的系統,在一次重試之前可能會消耗多得多的 token,而且沒有任何一次呼叫會觸發警報。重試只會加劇協調失誤,而非解決問題。
修正方法:在程式碼中設定硬性迭代上限、每個 Agent 的 token 上限,以及連接至自動停止機制的預算警報。由基礎架構強制執行限制。模型不會自行停止。
3. 自然語言契約
Agent 之間以沒有 schema 的自由文字互相傳遞內容。每經一手,解讀就變得更確定:「可能顯示磨損」變成「確認有磨損」,再變成維修工單。偏差在 Agent 之間發生,而那正是追蹤最薄弱的地方。
4. 過早採用多 Agent
在一個配備工具羣組的 Agent 已足以勝任的情況下採用多 Agent。每增加一個 Agent 都會帶來協調成本,而且增幅並非線性;效益約在四個 Agent 時趨於平緩。大多數「專家」只是同一個模型換了不同外衣。
修正方法:至少要有兩個不同的模型、不同的工具存取權限、並行執行,以及真正的相互依賴。少於兩個模型時,一個配備動作羣組的 Agent 就能完成工作。
測試方法:單一 Agent 能否透過切換工具處理各個階段?如果可以,這就不是多 Agent 問題。
5. 未設防的客戶接觸
Agent 在沒有審批步驟的情況下觸發現實世界的行動(電郵、上門服務、機器參數)。幻覺延伸至物理世界,不可逆行動造成連鎖影響,責任風險亦由退款擴大至產品責任。
修正方法:採取縱深防禦:建議 → Amazon Bedrock Guardrails → schema 驗證 → 業務規則 → 人工審批 → 執行。
每個 Agent 輸出傳達至客戶或安全系統的節點,都是信任邊界。
選擇架構
掌握各種模式及反模式後,架構選擇歸結為一連串簡短問題。
- 任務是否需要文字生成以外的操作?以直接呼叫模型作為基準,只有在有實測依據時才加入協調流程。摘要文件或根據規格生成程式碼,通常不足以構成這種理由。
- 解決方案的流程是否預先已知?如果可以列明各步驟及其先後次序,就根本不需要決定「要用多少個 Agent」。真正要作的選擇更簡單:由單一 Agent 呼叫工具,還是採用 Tier 1 工作流程。
- 工作是否需要真正不同的專業知識?不同領域之間如已有明確的交接流程,便有理由採用專門 Agent。同一領域則應交由單一 Agent 處理,無論它需要多少工具。
- 解決方案是否只能透過探索得出?如果行動次序已知,而且可以按「執行並驗證」循環運作,就應由單一 Agent 負責,即使它會動態規劃步驟也一樣。只有在工作過程中才會找出子任務時,Tier 2 增加的成本、延遲及除錯負擔才值得承受。
以下決策樹把這四個問題整理成一條可由上而下依序判斷的路徑。
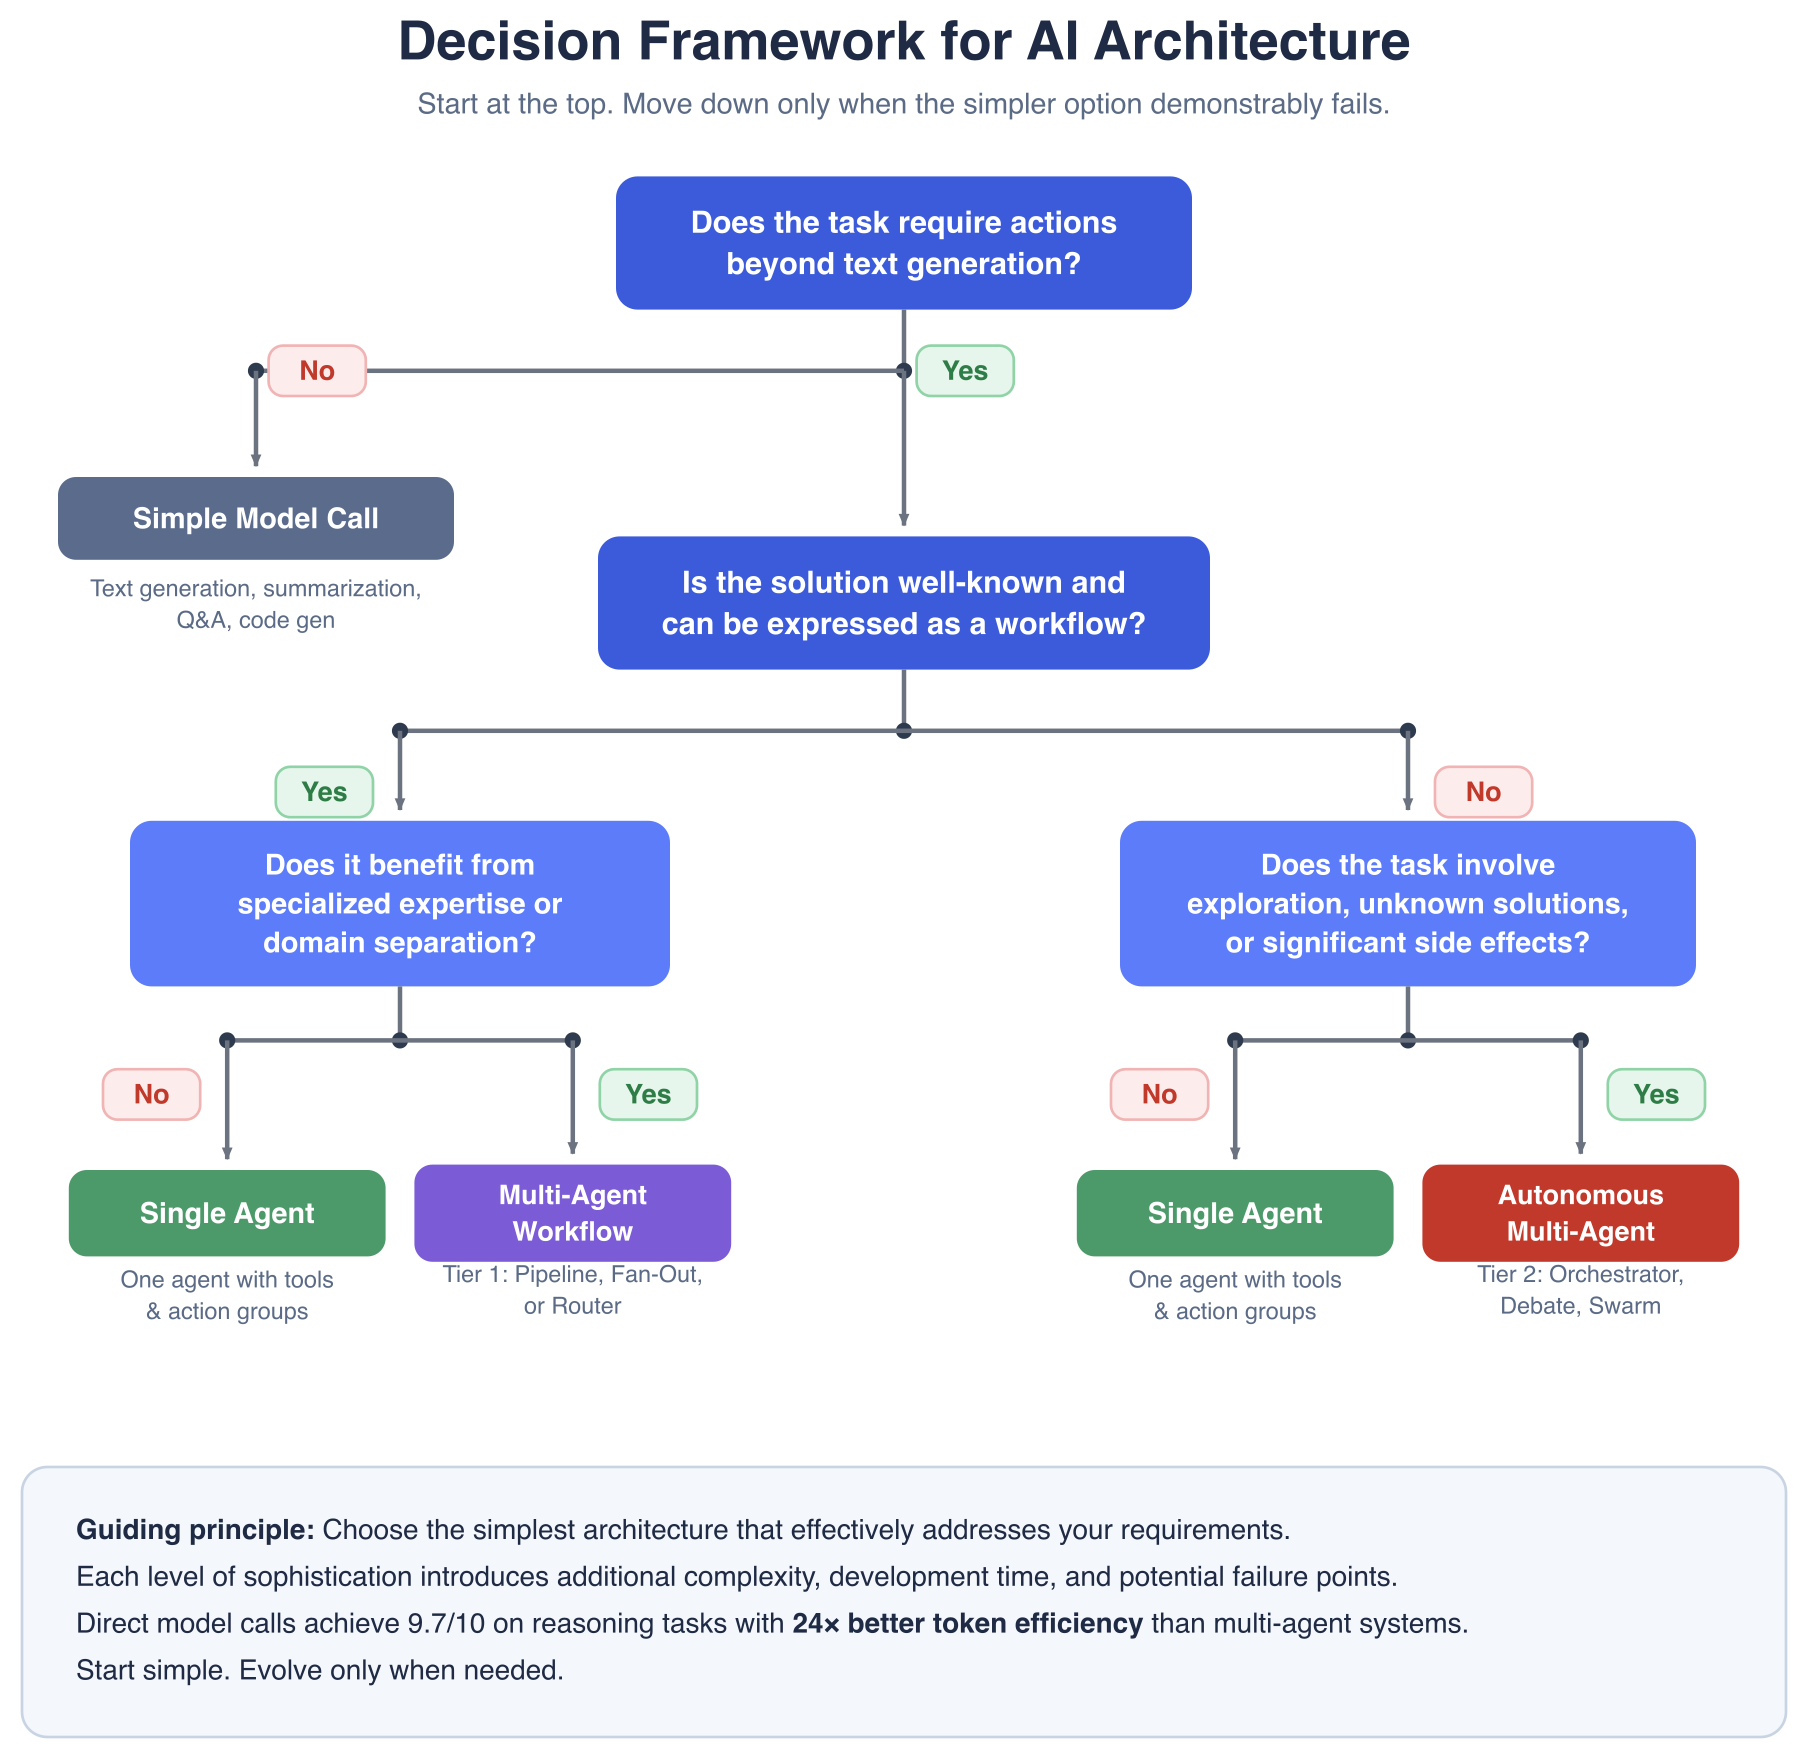
圖 8:選擇最簡單架構的決策樹,涵蓋由單次模型呼叫至 Tier 2 多 Agent 模式
決策樹首先會判斷任務是否需要執行文字生成以外的操作。如果不需要,呼叫一次簡單的模型即可。如果需要,決策樹會再判斷解決方案是否已廣為人知,並能否表達為工作流程。對於已有解決方案的情況,適合專業知識或領域分工的工作,會採用 Tier 1 多 Agent 工作流程(管線、扇出或路由器)。其餘工作則交由配備工具及動作羣組的單一 Agent 處理。對於尚無明確解決方案的情況,只有涉及探索或重大副作用的任務,才會採用 Tier 2 自主多 Agent 模式。其餘任務仍由單一 Agent 處理。指導原則是選擇符合要求的最簡單架構。
下圖從四個方面比較各種模式:何時應採用、Agent 之間的控制流程、結果的確定性,以及建置和營運成本。建置成本採用相對尺度,並非成本估算。
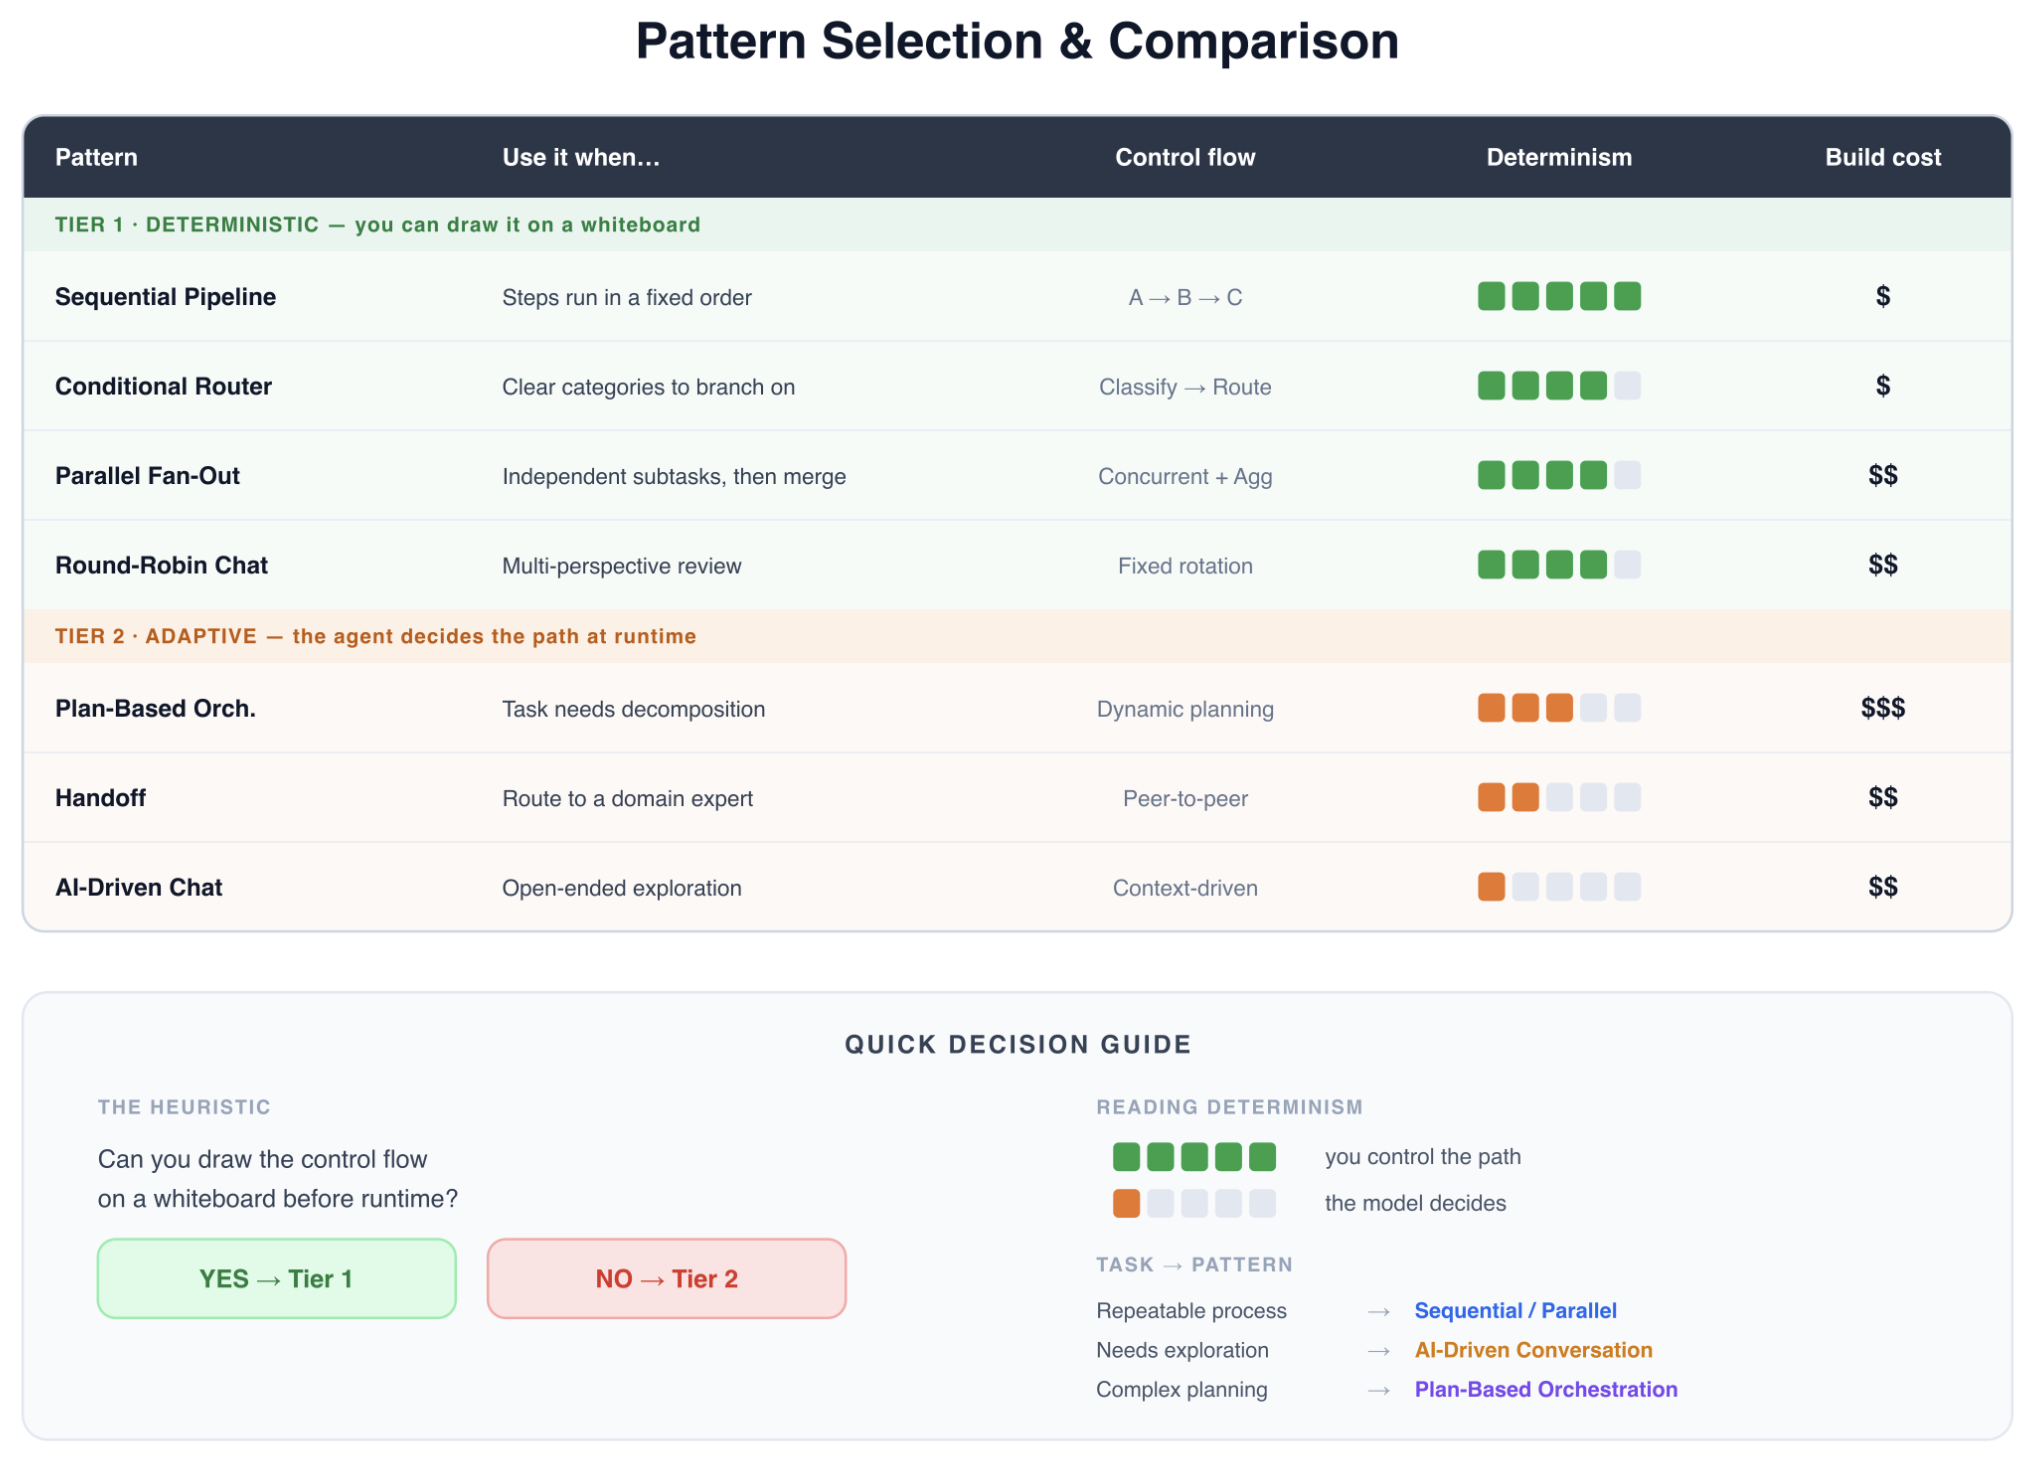
圖 9:按使用情境、控制流程、確定性及相對建置成本比較各種模式
Tier 1 模式的確定性高,建置成本則屬低至中等。Tier 2 將更多流程交由模型控制,而以計劃為基礎的協調模式建置成本最高。如果你能在執行前把控制流程畫在白板上,就應從 Tier 1 開始。
應用:將模式對應至製造業使用情境
| 使用情境 | 模式 | 理據 |
| 輪班交接摘要 | 順序管線 | 線性:原始記錄 → 摘要 → 報告 |
| 多工位根本原因分析 | 計劃式協調器 | 動態:分析期間發現子任務 |
| 即時品質關卡 | 條件式路由器 + 邊緣 Agent | 週期內:由本地模型作決定。Agent 推理不在流程路徑上 |
| 預測性維護排程 | 並行扇出/扇入 | 按資產類別使用獨立模型 |
| 工程變更單影響分析 | 辯論/共識 | 高風險:有理據支持對抗式審查 |
| 草擬供應商通訊 | 順序流程 + 人工把關 | 不得自動傳送(見「未經把關的客戶聯絡」) |
| 跨廠優化 | 計劃式協調器 | 多來源:動態查詢。求解器負責分配 |
製造業視角:改變權衡方式的四項限制
製造業並非一般的企業 IT 環境,而四項限制令相關取捨的代價不容忽視。
限制 1:生產線延遲 = 直接收入損失
在汽車車身工場,機械人會將車身焊接組合,生產線通常每小時處理 60 個工件。超過 40 個工位各有 60 秒的節拍時間,之後生產線便會前進。推理延遲若出現在工位的週期路徑上,就會佔用這 60 秒;而瓶頸工位一旦延誤,整條生產線都會減慢。即使產能只下降 2%,每年也可能對收入造成重大影響。
架構上的含意:應按 p99 而非平均值預留延遲預算。尾端延遲才是令生產線停下的原因。為每個 Agent 設置亞秒級、具確定性的後備方案,並按風險配對:
- 提供建議/標示品質問題:讓工件通過,同時加上標記,留待生產線末端覆核。
- 安全關鍵情況:採取隔離措施或確定性停機,不可繼續運作。
- 部署前,先為每個工位決定這項對應方式。
限制 2:安全問題會造成實際後果
聊天機械人產生幻覺會令人尷尬。焊接參數若是憑空捏造,則會造成結構缺陷,這些缺陷可能在撞擊測試或實際使用期間出現,並導致安全召回。以下兩種故障模式反覆出現:
- OT/IT 邊界狀態不同步:代理讀取製造執行系統(MES),得知工位 12 正在生產零件 #A,但手動 PLC 覆寫早已將其切換至零件 #B,因此代理為錯誤的零件調校參數。
- 安全邊界幻覺:維護代理從頭推理鎖定/掛牌程序,並判定工位 7 可以進入,但相鄰的工位 6 仍在運作,因而破壞聯鎖區域。
架構啟示:
邊界:保持確定性核心不變,包括 PLC、監控及資料採集系統(SCADA)和 MES,並在其外圍加設建議層。
- 代理負責觀察、分析和提出建議,不會直接執行操作。
- 安全限制應以確定性防護機制的形式,存放在外部服務中,讓代理查詢,而不是自行推理。這些限制絕不會嵌入提示詞,以免代理透過推理將其推翻。
驗證與核准:建議會先通過結構描述驗證和物理模擬,並在執行操作前一刻,根據 OT 的唯一可信資料來源核對;絕不會以快取超過一個週期的 OT 狀態為依據。之後會按建議的影響範圍交由相應級別核准:
- Level 0:代理自主處理。
- Level 1:操作員按一下即可確認。
- Level 2:工程師根據所呈現的分析作出決定。
- Level 3:管理層評估停線建議。
只有在此之後,經驗證的命令介面才會將允許的命令傳送至確定性控制系統。大型語言模型(LLM)提出建議,物理引擎和操作員作出最終裁決。
限制 3:資料存放於邊緣端
單一沖壓機每日會產生 50+ GB/day 的感測器資料,其價值會在數毫秒內迅速下降。將資料傳送至雲端的頻寬成本,比運算成本更高;而雲端作出回應時,沖壓機早已繼續運作。
架構啟示:混合式邊緣—雲端架構是實際可行的預設方案,而限制 2 所述的邊界在邊緣端同樣適用。
- 邊緣端(AWS IoT Greengrass):在資料源頭進行低於節拍時間的異常偵測、閾值監測,以及發出停止或繼續的訊號:邊緣代理提出建議,PLC 執行操作。
- 雲端:處理邊緣端無法勝任的工作,包括跨班次分析、跨廠趨勢關聯,以及利用整個設備羣的資料重新訓練模型。邊緣端只會提煉並傳送重要資訊。
限制 4:與輪班週期同步的代理生命週期
無限制的上下文會令代理逐漸偏離現況,因為過時的觀察資料會不斷擠走當前實況。完全重設則會令代理失去輪班之間的延續性。製造業早已透過有系統的交班流程,為員工解決這個問題;代理也需要遵循同樣的規範。
架構啟示:將代理記憶限制在輪班週期內。
- 初始化:載入輪班上下文,包括班組名單、生產目標,以及上一班的交接資訊。
- 累積:只在當前輪班時段內保留工作記憶。
- 交接:輪班結束時,輸出摘要,列出未處理事項、標記的異常和建議,供下一班人員參考。這樣既能仿效人員的交班流程,也不會令上下文無限增長。
以 AWS 為基礎
以下託管服務對應本文前文提出的關注事項。每一列列出的是機制,而不只是服務。
| 需求 | 服務 | 機制 |
| 執行環境 | AgentCore runtime,Amazon Bedrock AgentCore 的一項功能 | 代理程式的執行位置;其控制流程可以預先決定,亦可以由模型決定。可使用 Strands、LangGraph 或 CrewAI。 |
| 按班次劃分的記憶 | AgentCore memory,Amazon Bedrock AgentCore 的一項功能 | 受管理的短期及長期上下文,因此限制 4 所述按班次劃分的記憶只需設定,無須自行編寫狀態管理流程。 |
| 具型別的交接 | AgentCore Gateway,Amazon Bedrock AgentCore 的一項功能 | 將 API 和 AWS Lambda 函數轉換為具備經驗證結構描述的 Model Context Protocol (MCP) 工具,讓交接傳遞具型別的欄位,而非一般文字。 |
| 代理程式權限 | AgentCore Identity,Amazon Bedrock AgentCore 的一項功能 | 為每個代理程式提供獨一無二、可驗證的身份,並設有精細的存取控制。這是執行管控的環節,決定哪些代理程式可以連接哪些系統,以及代表誰行事。 |
| 代理程式之間的追蹤 | AgentCore Observability,Amazon Bedrock AgentCore 的一項功能 | 透過 Amazon CloudWatch Transaction Search 和 AWS Distro for Open Telemetry (ADOT),追蹤跨越執行環境、記憶、閘道及工具的 Span 和追蹤記錄。交接環節是多代理程式系統中最難觀測的部分,也是未具型別的合約會靜默失效之處。 |
| 人工審批介面 | AWS Quick | 升級層級的落點。AWS Quick Automate 可執行審批工作流程,並在 Slack 提供一鍵審批;其動作連接器亦可呼叫 Amazon Bedrock AgentCore 代理程式。 |
| 分級模型選擇 | Amazon Bedrock | 透過一個 API 使用不同模型系列,因此成本分級只需透過設定完成:為路由器的分類工作使用小型模型,為協調器的綜合工作使用更強大的模型。 |
結論
多代理程式系統改變汽車製造商大規模協調智能的方式,但前提是建基於正確的基礎。
本文提及的模式與反模式,源自實際部署案例;在這些案例中,欠佳的架構會導致 token 成本失控、違反節拍時間要求,最嚴重時更會帶來人身安全風險。在工廠規模下,成本效益方面不容有失,因為 token 用量會隨每個代理程式、機械人及班次增加。分級模型選擇、上下文壓縮,以及邊緣與雲端的分佈式部署,是以低得多的成本提供相同價值的主要手段。
建議從 Tier 1 模式開始,證明其價值後再擴展。大部分製造業應用場景,例如交接班摘要、品質關卡決策及預測性維護,都適合採用確定性工作流程。只有在真正開放式問題中,動態發掘子任務所帶來的效益足以抵銷額外成本、延遲及除錯複雜度時,才應採用自主協調。
關於作者

Kamlesh Mariwala
Kamlesh 是 AWS 資深生成式 AI 及機器學習解決方案架構師,專注於汽車及製造業。他協助客戶設計可擴展、安全且具成本效益的架構,運用 AWS 代理式 AI 和機器學習解決複雜的業務問題,並加快實現價值。

Malini Sethi
Malini 是 Amazon Web Services (AWS) 的解決方案架構師,專門負責汽車及製造業。她與大型汽車及工業客戶合作,設計並實施雲原生解決方案,以加快客戶在採用 AI 及 AWS Generative AI 方面的數碼轉型。加入現職前,她曾任 AWS ProServe 顧問,與客戶緊密合作,將複雜的技術挑戰轉化為可擴展、可投入生產的系統。她曾在 MIT 修讀機器學習。

Deepesh Koppunuru
Deepesh 是 AWS 的資深生成式 AI 機器學習解決方案架構師,與大型企業客戶合作,透過 AWS Generative AI 服務推動創新。Deepesh 熱衷於展示 AI 的變革力量,協助機構重新構想業務流程,並取得可衡量且帶來實際影響的成果。

Sandy Hsieh
Sandy 是 AWS 全球專家組織的資深數據及 AI 專家,支援汽車及製造業客戶採用生成式 AI、Agentic AI 及 Physical AI 解決方案。Sandy 擁有逾 10 年全球汽車業經驗,涵蓋供應鏈、車輛規劃及車載資訊娛樂系統等範疇。她持有 Carnegie Mellon University 機械工程碩士學位。
來源:AWS Machine Learning Blog · aws.amazon.com