Amazon SageMaker HyperPod Inference 現支援託管 NVIDIA Dynamo
Managed NVIDIA Dynamo on Amazon SageMaker HyperPod Inference
AWS 為 Amazon SageMaker HyperPod Inference 加入 NVIDIA Dynamo 託管支援,涵蓋多節點部署、分離式 prefill 與 decode 推理。
文章對照兩種部署路徑,並以 Qwen3-235B 基準呈現分離式 prefill 與 decode 在指定服務門檻下,最高吞吐量達聚合式的 2.05×。
要有效率地服務大型語言模型(LLM),需要充足的 GPU 記憶體,並仔細協調提示詞處理和 token 生成。例如,GLM-5.3 的 FP8 權重所需的 GPU 記憶體,已超過單一 ml.p5.48xlarge 執行個體的 640 GB,還未計算 KV cache 和執行階段開銷。當長提示詞和 token 生成共用相同的 GPU 時,長提示詞亦可能拖慢 token 生成。
Amazon SageMaker HyperPod Inference 現已支援 NVIDIA Dynamo,結合 Dynamo 的分散式推理功能與 HyperPod 的基礎設施管理,以應對這些挑戰。Dynamo 是一個開源分散式推理框架,支援多節點部署、分離式預填充和解碼,以及採用 vLLM、SGLang 和 TensorRT-LLM 等引擎的 KV 感知路由。HyperPod 則透過高效能 Elastic Fabric Adapter (EFA) 網絡、協調式 GPU 排程,以及節點健康狀態監控和復原功能,支援這些部署。在本文中,我們會透過部署範例説明多節點和分離式服務,分享基準測試結果,並概述在 HyperPod 上最佳化推理的最佳做法。
整合的運作方式
HyperPod Inference 附加元件會安裝 Dynamo 自訂資源定義,以及以下服務和排程元件:
- HyperPod Inference Operator 透過 InferenceEndpointConfig (IEC) 自訂資源管理端點部署。其
dynamoSpec區段會提供 Dynamo 設定。 - Dynamo operator 管理 DynamoGraphDeployment (DGD) 中定義的資源,包括前端、模型工作節點、副本數量和資源需求。
- Grove 協調相關的 pod 組羣,包括多節點工作節點,以及它們之間的擴展關係。
- Kubernetes AI (KAI) Scheduler 會將 pod 放置在 GPU 資源上,並採用羣組排程,將多節點工作節點所需的 pod 一併排程。
AWS Deep Learning Containers (DLCs) 提供 Dynamo 執行階段,而附加元件則管理整合元件的版本。如要採用受支援的 Dynamo 版本,請更新附加元件。
部署架構
下圖展示 Amazon SageMaker HyperPod 上 NVIDIA Dynamo 分離式推理的部署途徑、服務元件和基礎設施管理方式。Dynamo 前端會將請求路由至預填充工作節點,由後者處理提示詞;解碼工作節點則負責生成 token。這些分開的資源池可獨立擴展和調校。兩個資源池都會載入完整的模型權重,並透過 EFA 傳輸 KV cache。
Dynamo 亦支援聚合式服務,即預填充和解碼在同一個工作節點上執行。在任何一種拓撲中,工作節點都可以在單一執行個體上運行,或透過張量並行和流水線並行跨多個執行個體運行。Dynamo 的 KV 感知路由器在這兩種拓撲中,都會考慮可重用的前綴 KV cache 和工作節點目前的負載。重用前綴可減少提示詞的重複計算,並縮短首個 token 的生成時間;負載感知則有助避免工作節點過載。如要進一步瞭解 Dynamo 架構,請參閲 Dynamo Knowledge Base 概覽。
HyperPod 會監控節點、GPU 和 EFA 的健康狀態,並管理節點替換;編排元件則會重新建立受影響的工作節點。透過 InferenceEndpointConfig 設定並包含 dynamoSpec 的部署,支援透過 SageMaker 端點進行呼叫。
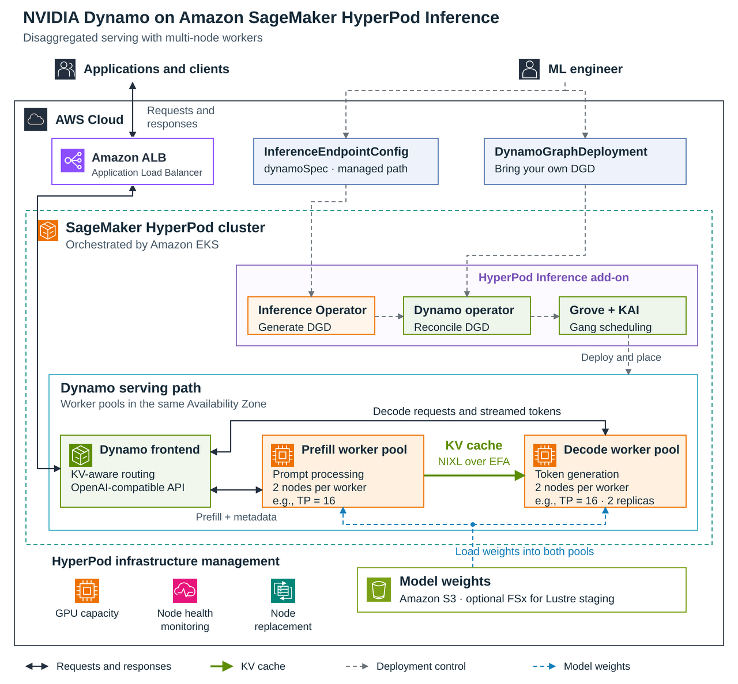
圖 1:Amazon SageMaker HyperPod Inference 上 NVIDIA Dynamo 的部署途徑、服務元件和基礎設施管理方式
兩種部署設定方式
無論你是初次使用 HyperPod、Dynamo,還是兩者都是,這個附加元件都提供兩種部署途徑,配合你的工作流程:
自備 DynamoGraphDeployment (DGD) 讓現有 Dynamo 用戶繼續使用上游文件、配方及資訊清單,並由 Dynamo operator 管理部署。如要將現有 DGD 部署至 HyperPod,請使用受支援的容器映像,並為叢集設定儲存、網絡及 Pod 放置方式。
採用 dynamoSpec 的 InferenceEndpointConfig 讓現有 HyperPod Inference 用戶使用熟悉的設定格式及 OpenAI 相容介面,部署新的 Dynamo 端點。推理引擎可選擇 vLLM、SGLang 或 TensorRT-LLM,預設使用 vLLM。operator 亦會提供 KV 感知路由及副本數的預設值。
兩種途徑均支援單一執行個體及多節點部署。在任何一種情況下,HyperPod 都會管理節點健康狀況及替換。下表概述兩種途徑各自的管理責任。
| 自備 DGD | 採用 dynamoSpec 的 InferenceEndpointConfig | |
| 由你撰寫 | 完整的 DGD 資訊清單 | 包含 dynamoSpec 的 IEC |
| 最適合 | 希望直接控制推理服務圖,或重用現有 DGD 的團隊 | 希望透過 IEC 管理端點設定的團隊 |
| 模型權重 | 由你設定下載或掛載權重 | operator 會暫存來自 Amazon Simple Storage Service (Amazon S3) 或 Amazon FSx 的權重 |
| 端點、TLS、註冊 | 由你設定及管理這些資源 | 由 HyperPod Inference Operator 管理 |
| 自動擴縮 | 由你設定及管理擴縮 | Kubernetes 事件驅動自動擴縮 (KEDA),透過 autoScalingSpec 支援聚合式及分離式部署 |
部署範例:GLM-5.3
以下摘錄採用 InferenceEndpointConfig (IEC) 部署方式,在 ml.p5.48xlarge 執行個體上使用 vLLM。Dynamo 專屬設定應放在 spec.dynamoSpec 底下。完整資訊清單包含模型來源及端點設定。
多節點聚合式服務
此設定會在兩個執行個體(16 GPUs)上執行一個模型工作者副本,並設定兩個前端副本處理請求。將 dynamoSpec.frontend.routingMode 設為 kv-aware 即可啟用 KV 感知路由。
spec:
  replicas: 1
  dynamoSpec:
    modelServer: vllm
    frontend:
      replicas: 2
      routingMode: kv-aware
    aggregation:
      nodesPerReplica: 2
tensorParallelism: 16在此,spec.replicas 控制模型工作者副本的數量,而 frontend.replicas 控制前端副本的數量。
多節點分離式服務
將 spec.dynamoSpec 底下的 aggregation 替換為以下 disaggregation 區塊,並保留前面的前端設定。預填充及解碼的副本數會分別設定。此範例會執行一個預填充副本及兩個解碼副本,每個副本均橫跨兩個執行個體,合共使用六個執行個體。
disaggregation:
  prefill:
    nodesPerReplica: 2
    tensorParallelism: 16
    replicas: 1
  decode:
    nodesPerReplica: 2
    tensorParallelism: 16
    replicas: 2
套用部署
使用 kubectl apply 套用完整資訊清單。HyperPod Inference Operator 會讓工作節點取得已設定的模型權重,並產生 DGD。Grove 和 KAI Scheduler 會協調配置,確保每個多節點工作者所需的 Pod 一同排程。
SageMaker 端點就緒並設定為支援聊天補全後,用戶端即可透過 SageMaker Runtime API 傳送 OpenAI 相容的請求酬載:
aws sagemaker-runtime invoke-endpoint \
--endpoint-name glm53 \
--content-type application/json \
--body '{"model":"zai-org/GLM-5.3","messages":[{"role":"user","content":"Hello"}],"max_tokens":128}' \
--cli-binary-format raw-in-base64-out \
out.json
基準測試
我們在 SageMaker HyperPod 上使用兩個模型對 Dynamo 進行基準測試,以比較不同的服務設定。
Qwen3-235B 的分離式預填充與解碼
我們使用 AIPerf,在兩個 p5en.48xlarge 執行個體(16 張 H200 GPU)上,透過 Dynamo 搭配 TensorRT-LLM,為 Qwen3-235B-A22B-FP8 比較聚合式與解耦式服務。請求包含 4,000 個輸入 token 和 200 個輸出 token。我們保留了符合兩項目標的實測數據點:P90 首個 token 時間低於一秒,以及每位用戶的中位數生成速度至少為每秒 50 個 token。在這些數據點中,解耦式服務的最高吞吐量是聚合式服務的 2.05×:在並發數分別為 80 和 32 時,每張 GPU 每秒輸出 207 個 token,對比 101 個。
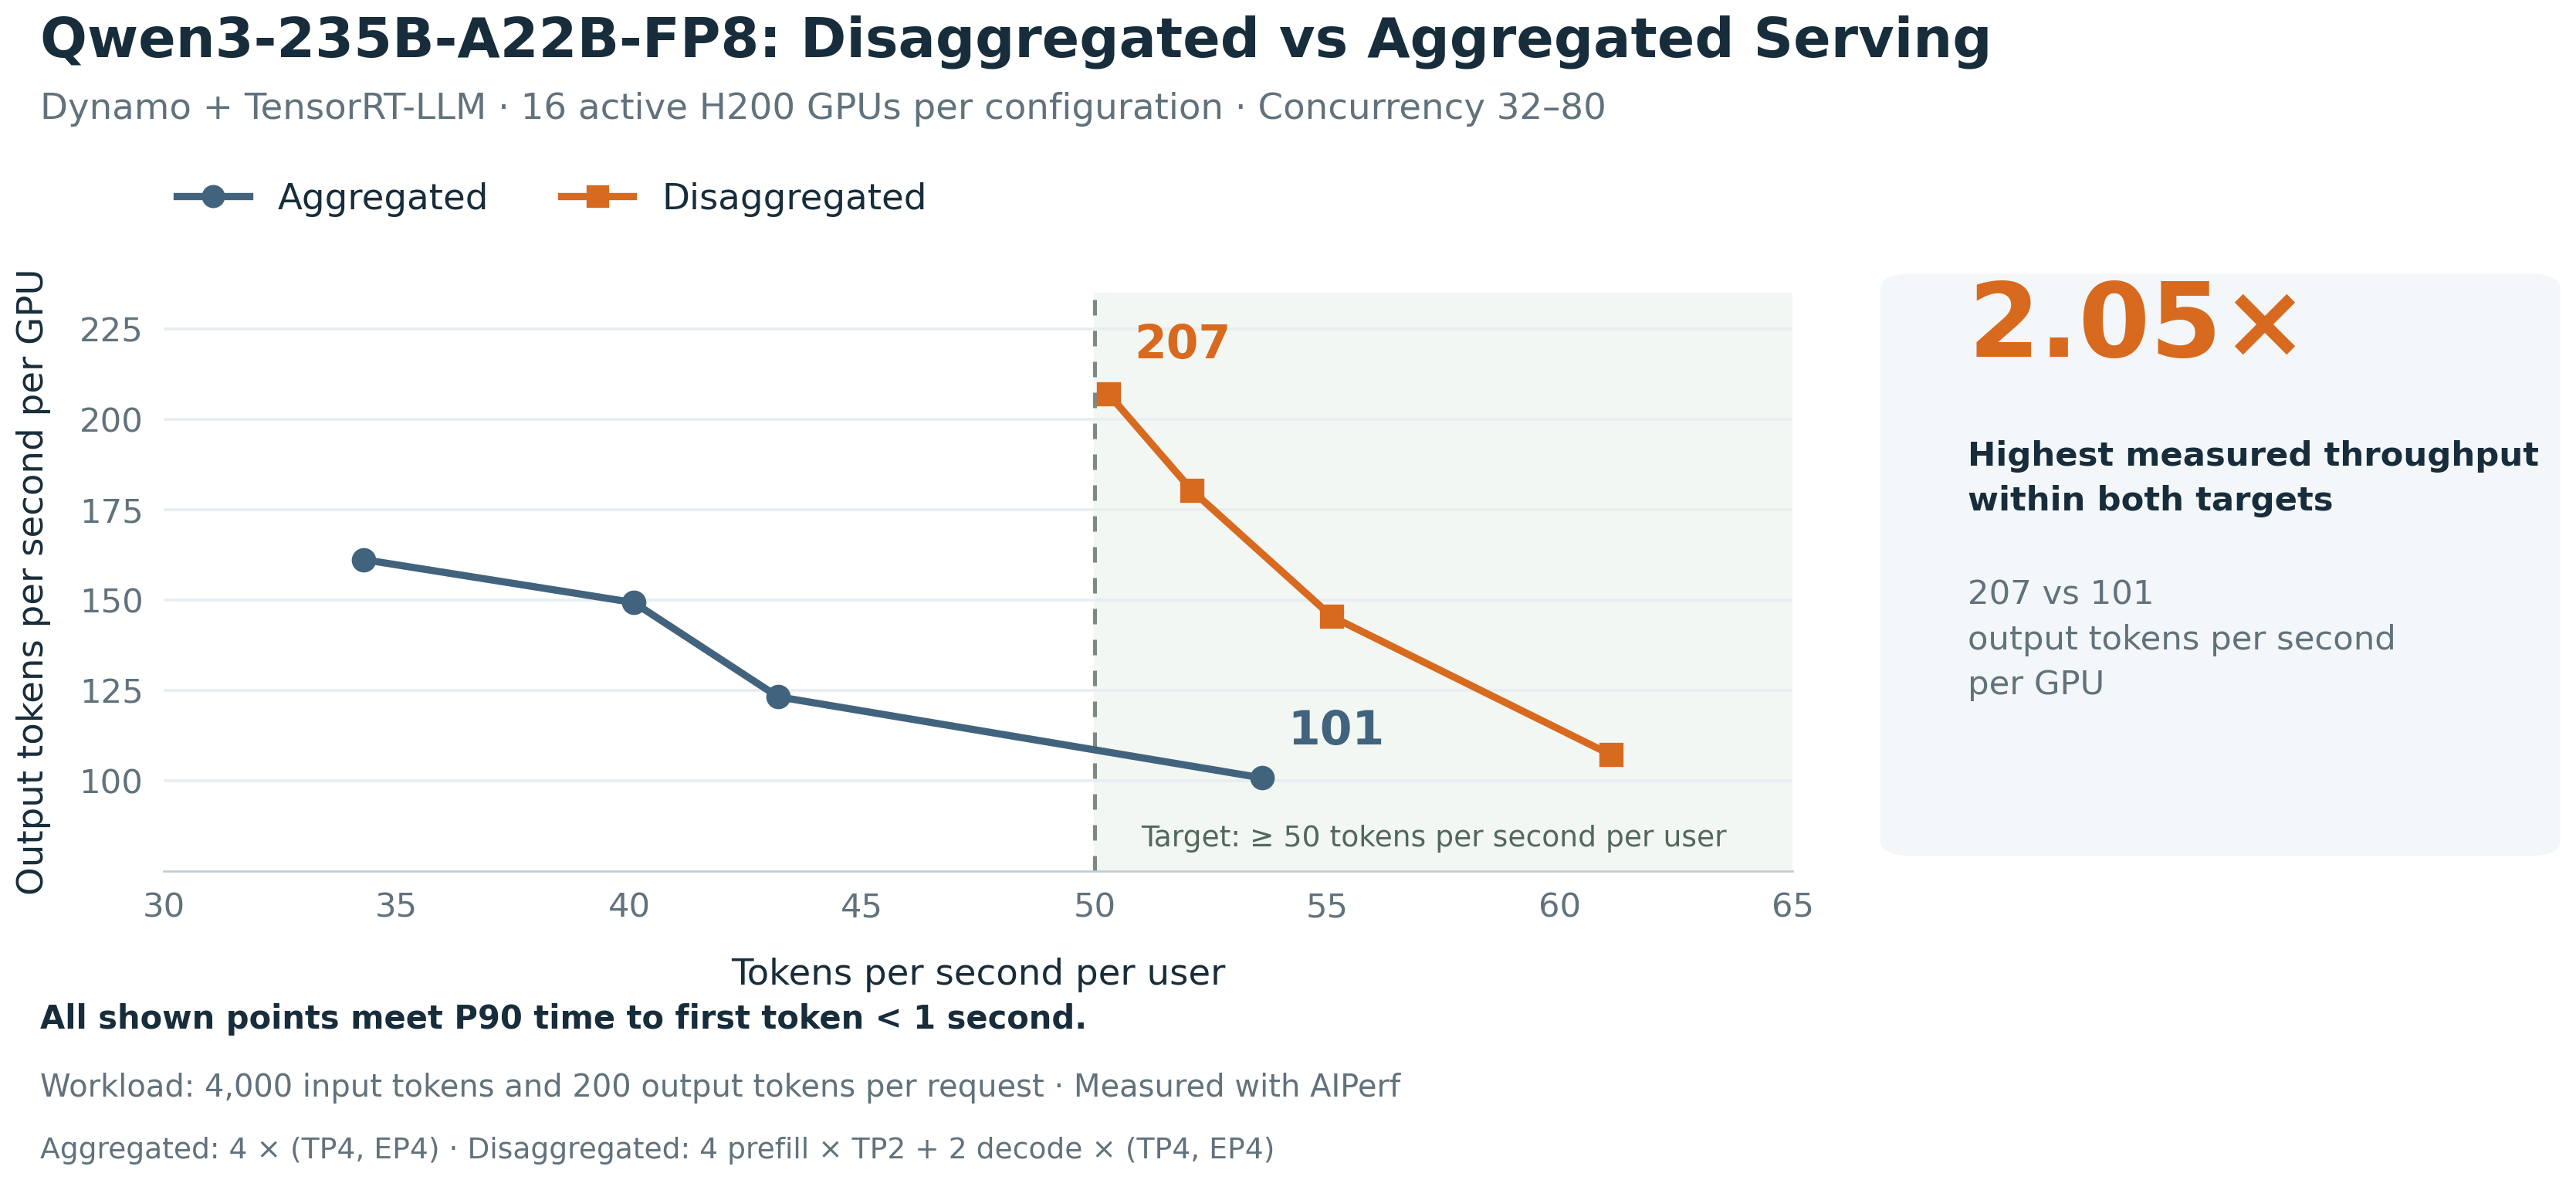
圖 2:Qwen3-235B-A22B-FP8 聚合式與解耦式服務吞吐量比較
Qwen3.5-397B 的多節點聚合式服務
對於所需 GPU 記憶體超出單一執行個體容量的模型,Dynamo 支援以聚合式及解耦式模式進行多節點服務。為評估跨節點工作者的效能,我們使用 AIPerf,透過 Dynamo 和 vLLM,對 Qwen3.5-397B-A17B-FP8 的多節點聚合式服務進行基準測試,採用 TP4 × PP2 和八張啟用中的 H200 GPU。此模型可在單一執行個體上運行,因此實際上不會將其拆分;在此,它作為受控基準。我們比較了單一 p5en.48xlarge 執行個體上的八張 GPU,與分佈在兩個執行個體上、每個執行個體四張 GPU 的配置,兩者採用相同的模型、並行度及工作負載設定。在並發數為 32、具備高前綴重用率的 Agent 工作負載下,雙節點配置達到每張 GPU 每秒輸出 126.4 個 token,相當於保留單節點吞吐量的 99.1%。這顯示 Dynamo 在 SageMaker HyperPod 上可以跨節點服務需要多於一個執行個體的模型。節點邊界本身不會造成明顯的吞吐量損失。
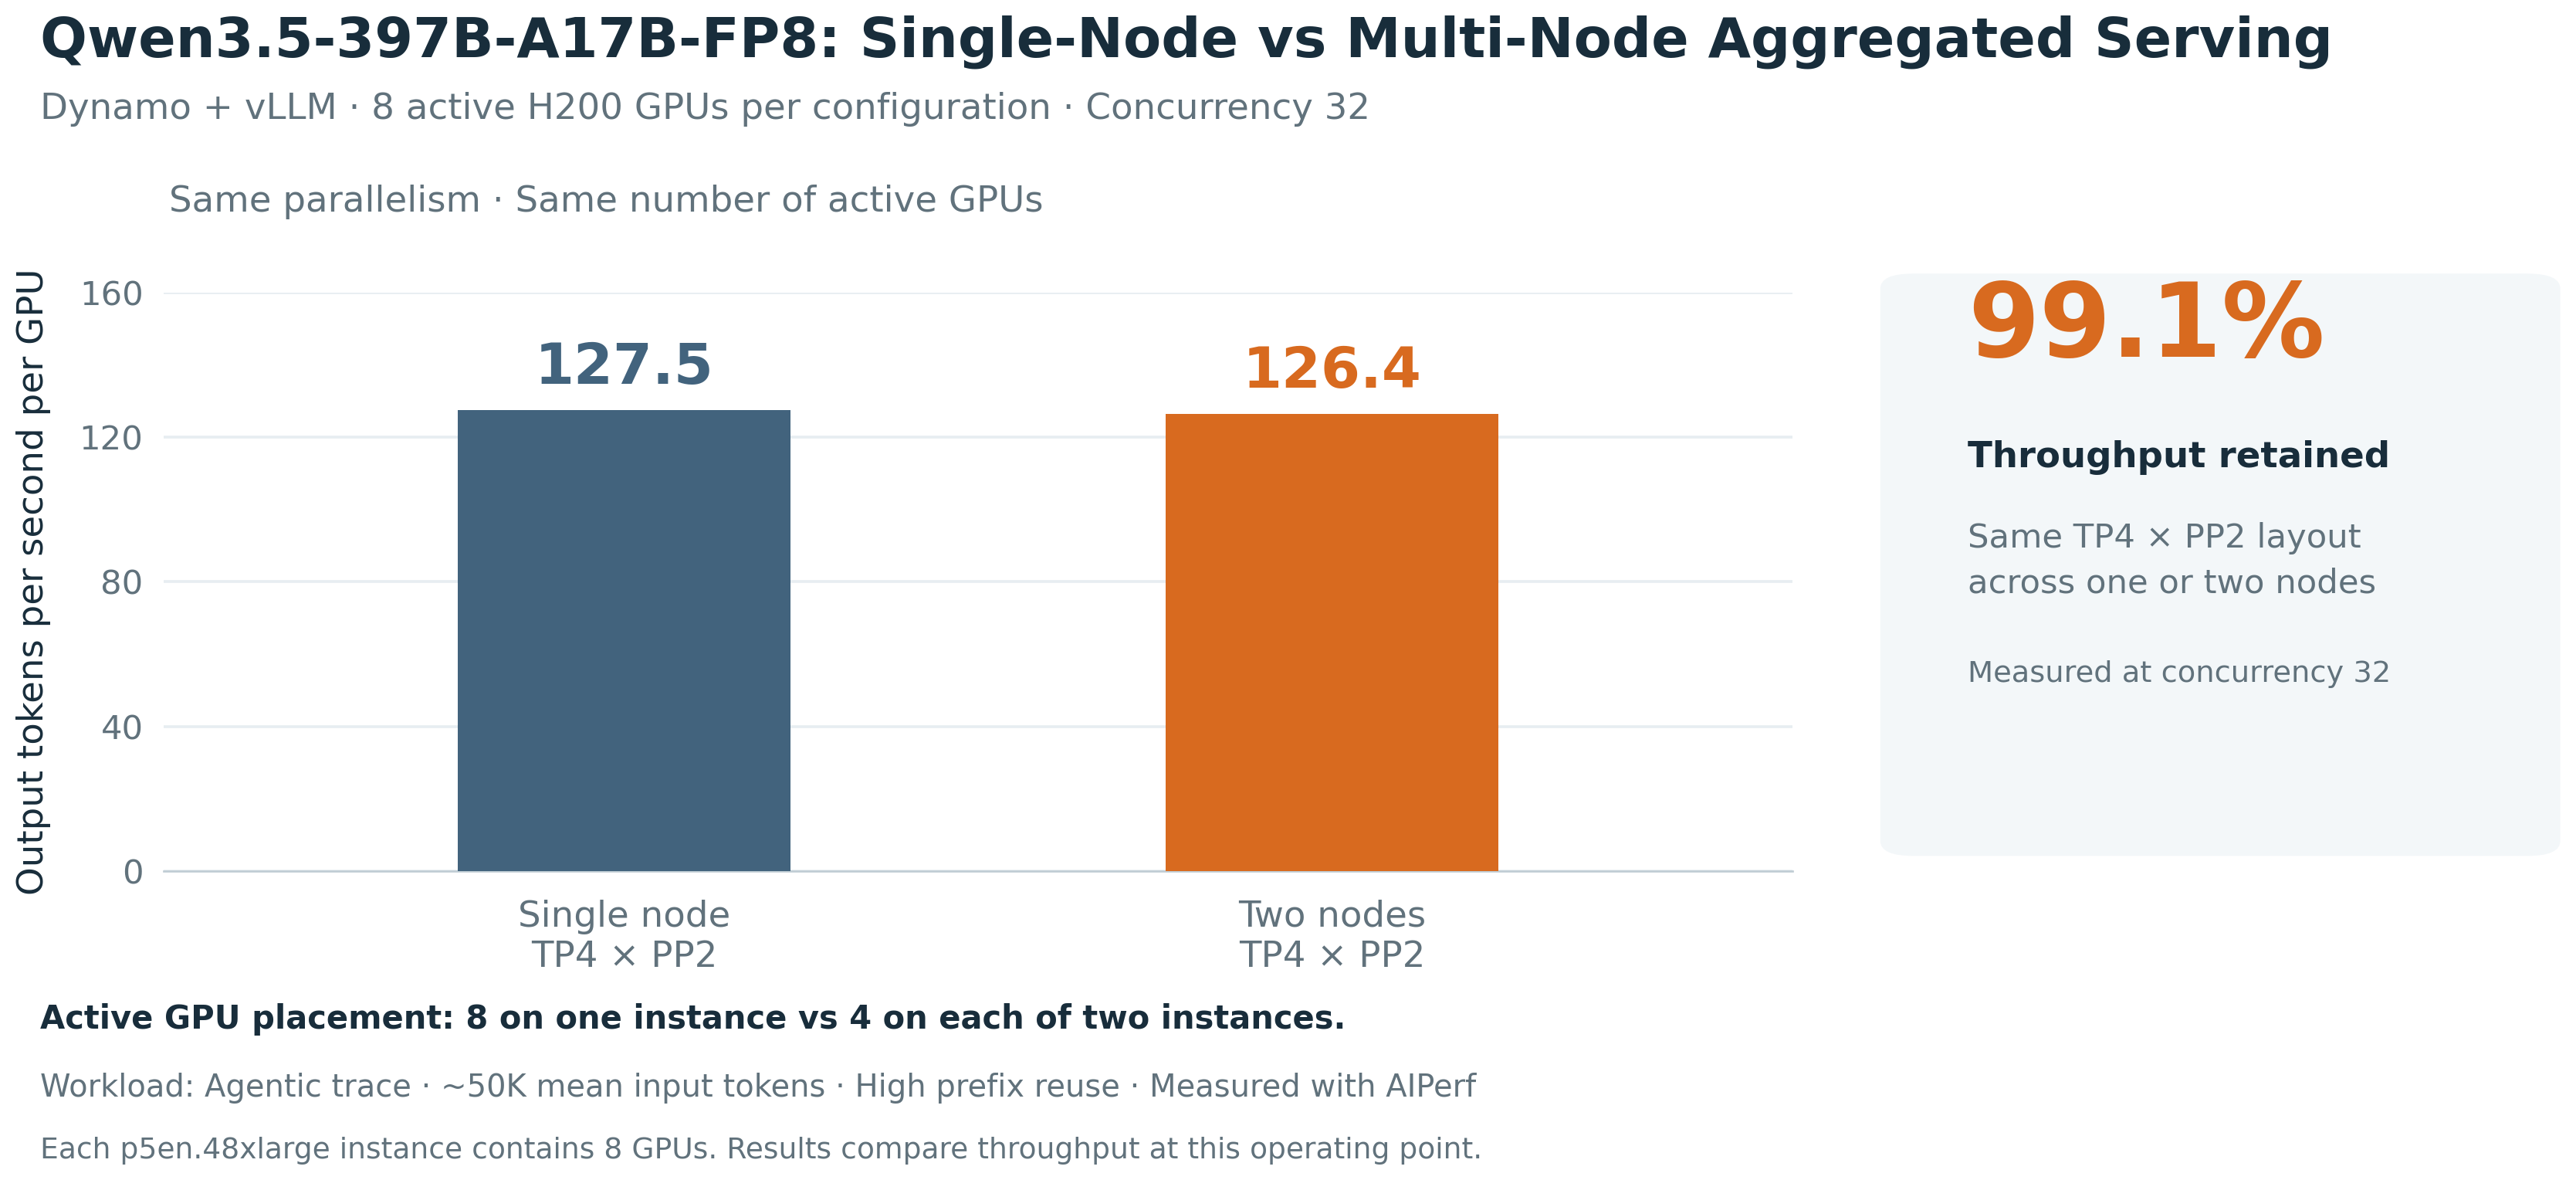
圖 3:Qwen3.5-397B-A17B-FP8 多節點聚合式服務的單節點與雙節點吞吐量比較
最佳化推理的最佳做法
NVIDIA Dynamo 提供配方和工具,協助你選擇服務配置、評測效能,並在 SageMaker HyperPod 上調校部署。
- 從合適的配方開始 – 根據模型、推理引擎和 GPU 類型,選擇 Dynamo 配方。設定工作者規模時,須將模型權重、KV 快取及執行階段記憶體納入考量。對於支援的配置,AISimulate 可協助你比較聚合式與解耦式服務、選擇並行度,並在 GPU 上測試前設定預填充和解碼工作者集區的規模。
- 基準測試前先確認通訊方式 – 對於跨執行個體部署,請確認通訊採用預期的 EFA 傳輸方式,包括預填充和解碼工作者之間的 KV 快取傳輸。請參閲 Dynamo EFA 指南。
- 使用具代表性的流量進行基準測試 – 使用 AIPerf 重播你的流量,或使用具代表性的提示詞長度、輸出長度及前綴重用率的生成式 Agent 軌跡。針對每種配置測試不同並發數,保留符合 SLA 的數據點,並根據成本和延遲方面的優先考慮作出選擇。
- 根據實測瓶頸進行調校 – 先調整拓撲和工作者配置,再調整引擎設定;每次只更改一項變數。請遵循效能調校指南,或使用 Dynamo 最佳化 Agent 技能協助進行基準測試和調校。在目標 HyperPod 部署上驗證每個候選配置。
結論
NVIDIA Dynamo on SageMaker HyperPod Inference 透過多節點服務、預填充與解碼分離,以及 KV 感知路由,簡化大型模型的部署和操作。受管附加元件會安裝服務元件,而預設設定則簡化端點設定。HyperPod 管理模型權重,根據 GPU 和推理指標自動調整叢集規模、監察節點健康狀況,並替換故障節點。這些功能結合起來,可減少繁重但無差異化的基礎設施工作,讓團隊專注於模型和應用程式。請參閲連結儲存庫中的設定指引和完整部署範例,開始使用。
致謝
作者謹此感謝 NVIDIA 的 Eliuth Triana、Felipe Garcia、Sanjana Checker、Junyuan Yang、Jiahong Liu、Anish Maddipoti、Jacob Kern 和 Abdullahi Olaoye 對本文的貢獻。我們亦感謝 AWS 的 Can Sun、Ophelia Yang、Aryaman Kothari、David Oh 和 Ayush Kumar 對本文的貢獻。
作者簡介

Vinay Arora
Vinay 是 AWS 的生成式 AI 專業解決方案架構師,過去 6 年來一直與客戶合作,運用 AWS 技術和基礎設施設計尖端 AI 解決方案。加入 AWS 之前,Vinay 在金融業累積了逾二十年的經驗,曾任職於銀行和對沖基金,並建立風險模型、交易系統和市場數據平台。Vinay 持有計算機科學及商業管理碩士學位。

Piyush Daftary
Piyush 是 AWS 的首席軟件工程師,負責在 Amazon SageMaker HyperPod 上建構大型語言模型推理系統。他專注於最佳化路由、分離式服務和自動調整規模架構,協助客戶盡量發揮 GPU 資源羣的效能。他的專業背景涵蓋分佈式系統、數據庫和搜尋技術。工作以外,他喜歡旅行和與家人共度時光。

Xuan Lu
Xuan 是 AWS 的軟件開發工程師,負責運用 Amazon SageMaker HyperPod Inference 建構和擴展大規模大型語言模型推理系統。他的工作專注於分佈式推理、智能請求路由和效能最佳化,並具備 Kubernetes 編排及大型語言模型服務基礎設施方面的經驗。工作以外,他喜歡旅行、探索大自然和閲讀科幻小説。

Preethi Ravula
Preethi 是 AWS ISV 團隊中負責生成式 AI、數據、儲存及分析的解決方案架構經理。她領導一支團隊,協助軟件供應商在 AWS 上建構和擴展生成式 AI。她負責 AI 策略和推理最佳化,並開發框架和實用指南,協助客戶在 AWS Trainium 和 NVIDIA GPU 上更快速、更具成本效益地執行大型語言模型工作負載。Preethi 曾在 GHC 2025、SJSU 和 Women in Tech Dublin 演講。她亦透過 AWS 一項教導學生使用 AWS 生成式 AI 服務建構應用程式的計劃,積極推動 AI 教育。

Sai Devulapalli
Sai 過去六年一直領導 Amazon SageMaker AI 全球 GTM 團隊。他與 AWS 全球各地面向客戶的 AI 專家領導人緊密合作,並與客戶企業的 C 級及副總裁級持份者交流,瞭解他們的需求,並就制定及執行公司 AI 平台策略提供指引。Sai 與 SageMaker AI 服務領導層合作,協助制定服務路線圖,讓服務更切合客戶需求。他在 AI/ML 平台領域已有 16 年經驗,曾在 Dell EMC 和 Pivotal 領導業務拓展及產品管理團隊;此前則在 Ericsson 領導北美的數據分析及機器學習業務。

Aryaman Kothari
Aryaman 是 Amazon SageMaker AI 的資深產品經理,負責 Amazon SageMaker HyperPod 上的 AI 推理,協助企業大規模運行 AI 模型,以應付生產工作負載。Aryaman 畢業於 Chicago Booth,此前曾負責 Quantiphi 對話式 AI 業務的產品及市場推廣。工作以外,他喜歡踢足球、沖泡 chai 和行山。

Kshitiz Gupta
Kshitiz 是 NVIDIA 的資深解決方案架構師,協助雲端客戶設計及優化 GPU 加速的數據與 AI 系統。他的工作涵蓋數據處理、向量資料庫及 LLM 推理,並與 AWS 及 Amazon 團隊緊密合作,將這些能力投入生產環境。工作以外,他喜歡音樂、瑜伽和行山。

Marc Karp
Marc 是 NVIDIA 的資深解決方案架構師,協助客戶在 GPU 上部署 AI 推理並擴展其規模。他的工作涵蓋推理技術堆疊各個環節,從模型優化、分散式服務,到驅動這些服務的引擎。工作以外,他喜歡旅遊和探索新地方。

Wenhan Tan
Wenhan 是 NVIDIA 的解決方案架構師,協助客戶大規模採用 NVIDIA AI 解決方案。他的工作重點是加速深度學習應用,以及解決推理和訓練方面的挑戰。
來源:AWS Machine Learning Blog · aws.amazon.com