如何在 Amazon SageMaker AI 上以知識蒸餾建立高效購物智能體
Build efficient agents with knowledge distillation on Amazon SageMaker AI
AWS 示範以 SeqKD 在 Amazon SageMaker AI 上微調 Qwen3.5-4B 購物智能體。流程以 Amazon Bedrock 上的 GLM-5.3 生成多步軌跡,並用 ShoppingBench 評分器保留成功樣本。
ShoppingBench 保留測試集顯示,4B 學生模型平均 ASR 比基礎模型高 24 個百分點,保留教師推理也比只訓練工具呼叫高約 13 個百分點。
你以一個前沿模型建立了購物助理,而且它運作正常。購物者提出「找一個售價低於二十美元、來自評分至少 4.5 星店舖的黑色腰包」,代理便搜尋商品目錄、檢視候選商品、核對條件,然後作出推薦。但這次互動實際上要花多少錢?代理式助理並非只呼叫一次模型,而是一個循環:搜尋、讀取結果、調整搜尋、核實、作出決定。完成一項任務可能需要多次呼叫該前沿模型,而每位購物者的每次呼叫都要付費。在生產環境的規模下,每項任務的成本會不斷累積,侵蝕項目的投資回報率(ROI),令項目無法推出。
提高代理式應用程式效率的方法之一,是使用較小的模型;它回應速度較快,託管成本效益也較高。問題在於品質:較小的模型通常無法勝任該任務,這正是當初選用較大模型的原因。知識蒸餾透過將較大型「教師」模型的行為遷移至較小的「學生」模型,讓學生模型學習重現教師模型的輸出,從而縮小差距;這樣便能以較小模型的速度和成本,保留大部分品質。
本文會介紹如何運用知識蒸餾,特別是序列層級知識蒸餾(SeqKD),在 Amazon SageMaker AI 上微調購物代理。我們會講解如何以一個前沿教師模型生成高品質的多步驟軌跡,並保留能完成任務的軌跡;如何將它們編碼以進行監督式微調;如何在無伺服器基礎設施上執行訓練;以及如何使用留出的基準測試集評估學生模型。
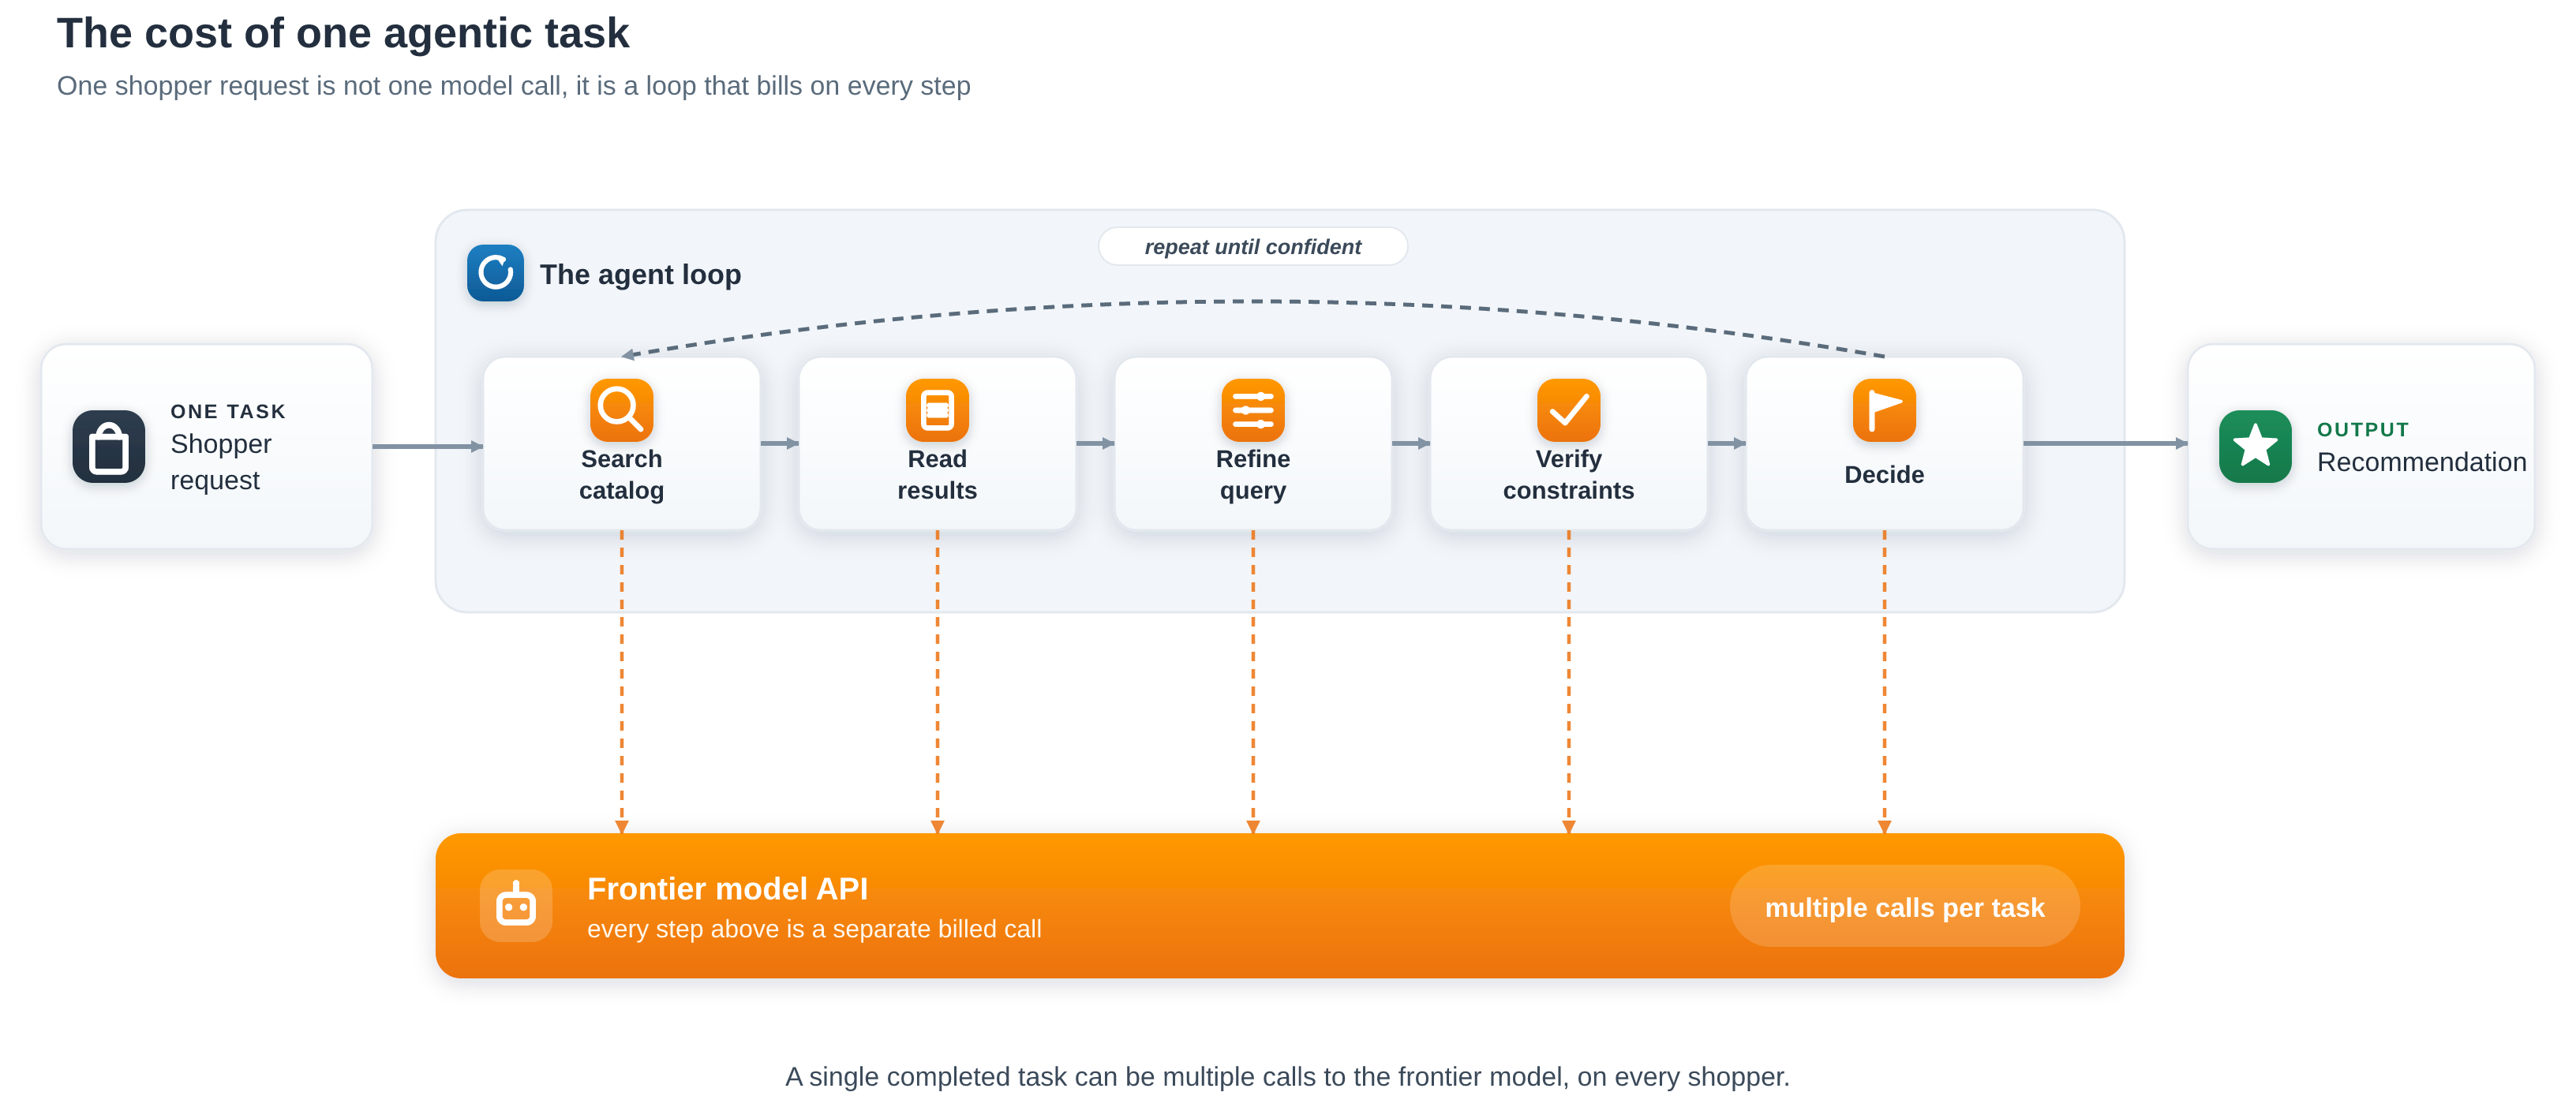
圖 1:一項代理式任務是一個循環,而非單次呼叫:代理會搜尋、讀取結果、調整搜尋、核實及作出決定,每個步驟都是一次需付費的前沿模型呼叫。完成一項任務可能需要多次呼叫,而每位購物者的每次呼叫都要付費
甚麼是序列層級知識蒸餾(SeqKD)?
最簡單而適用的蒸餾形式是序列層級知識蒸餾(SeqKD)。它會使用教師模型生成高品質回應,再以監督式微調(SFT)讓學生模型學習這些回應。SeqKD 只需要教師模型的文字,無須存取教師模型的 logits,也無須使用強化學習基礎設施,因此即使教師模型是封閉式或只提供 API,也能使用。與基於 logits 或 on-policy 等其他方法相比,它在蒸餾方法中屬於成本效益最高、可移植性最強的一類。教師模型負責撰寫答案,學生模型則以這些答案進行微調。由於這些答案會保存為數據集,你可以重複使用它們來訓練或測試不同的學生模型,而無須重新生成數據。
理論上,你會希望學生模型匹配教師模型在所有可能輸出上的完整分佈。問題是,這並不可行。可能序列的空間極其龐大,因此無法做到精確匹配。SeqKD 透過教師模型實際生成的樣本近似這個分佈,避開了這個問題。
對於 Agent 而言,教師模型產生的序列不是一段散文,而是一條軌跡:由推理、工具呼叫及其回傳的觀察結果按順序組成,每一步都會根據之前的所有內容而定。以整段序列訓練學生模型,教會它引導每項行動的推理,以及多步驟的行動過程本身,而不只是單一段落的答案文字。因此,Agent 任務是最能清楚展示序列層級 KD 的例子之一,因為被複製的序列就是模型的行為本身。
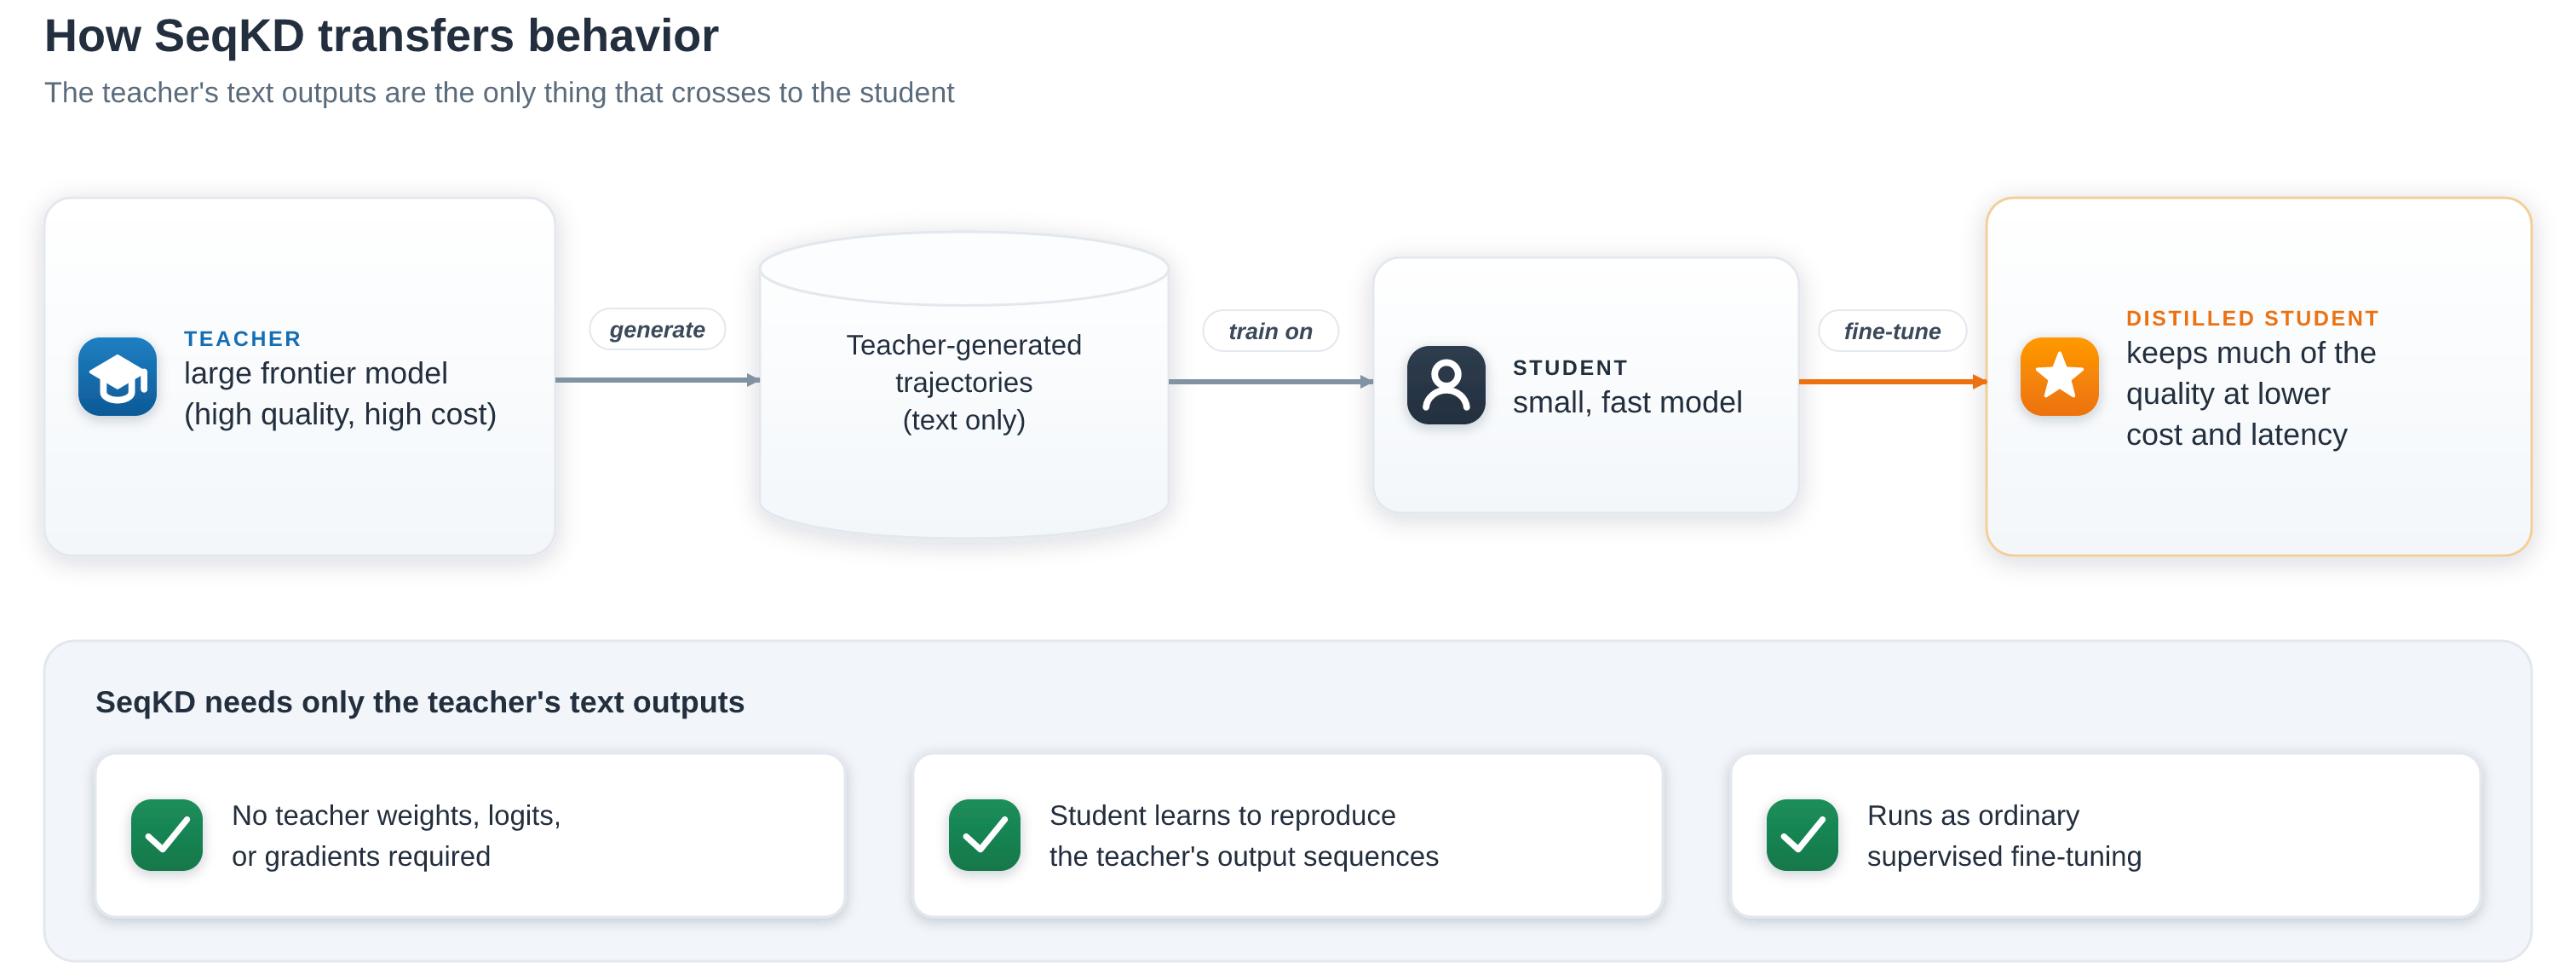
圖 2:SeqKD 只透過教師模型的文字輸出來轉移行為:教師模型產生軌跡,學生模型以這些軌跡進行訓練,最終模型在保留教師模型大部分效能的同時,具備小型模型的速度和成本優勢。訓練期間不需要教師模型的權重、logits 或梯度,因此可按一般監督式微調方式進行
何時適合選用 SeqKD
SeqKD 適用於以下特定情況:
你有輸入資料,但沒有高質素的目標輸出
這是 SeqKD 的核心應用情況,因為它本質上是一種資料生成方法。你提供輸入資料,由教師模型撰寫目標輸出,因此可以針對沒有現成高質素標籤的任務或領域進行微調。目標輸出可以簡單至單一答案,也可以複雜至多輪工具使用軌跡。本文探討這個範圍中要求較高的一端:Agent 軌跡,這類資料尤其難以取得。單一任務可以衍生出許多部分正確的執行過程,而要分辨成功與失敗的執行過程,則需要可靠的評分器。設有程式化評分器的基準測試正好能做到這一點,因此你可以讓教師模型產生軌跡,再只保留成功完成任務的軌跡。
你的教師模型是隻能透過 API 存取的前沿模型
這是前沿模型的常見情況。你無法存取權重並自行託管模型,也無法讀取其 logits 或對其進行微調。這代表你無法使用基於 logits 的蒸餾及 on-policy 方法,因為這些方法都需要存取模型內部資訊。SeqKD 只需要教師模型的文字回應,因此是仍然可行的方法;學生模型接手後,你也毋須再為每次請求支付前沿模型的價格。
你希望以強而具成本效益的方法起步
部分最強的小型推理模型,很大程度上是透過 SeqKD(以教師模型的推理軌跡進行監督式微調)建構而成,因此在條件合適時,SeqKD 是轉移推理能力的有效起點。DeepSeek-R1 蒸餾模型就是一個廣為人知的例子:研究人員以教師模型生成的推理軌跡微調較小的 Qwen 和 Llama 學生模型,將大型教師模型的推理能力蒸餾至這些模型。
先決條件
要執行此範例,你需要:
- 一個 AWS 帳戶,以及一個適用於 SageMaker AI 的 AWS Identity and Access Management (IAM) 角色。該角色須具備 Amazon Simple Storage Service (Amazon S3) 儲存貯體的讀取和寫入權限,以及呼叫教師模型的權限。
- 一個用來產生軌跡的前沿教師模型(本操作指南使用 Amazon Bedrock 上的模型)。
- 在受支援的 AWS 區域內使用 SageMaker AI 模型自訂功能的權限。
- Amazon SageMaker Studio(或已設定 AWS CLI的本機 IDE),使用執行 Python 3.12 或以上版本的核心,並安裝SageMaker Python SDK v3及
boto3(固定各版本)。Notebook 環境至少使用 ml.m5.4xlarge 執行個體,因為資料準備和本機評分步驟會在其 CPU 上執行。 - 具備 Python、監督式微調及使用工具的 Agent 的實務知識。
- 隨附的程式碼儲存庫,以及一項配備程式評分器的任務(本教學採用 ShoppingBench 測試集;請換成你自己的任務和評分器)。
方案概覽
本節會完整介紹整個流程。前沿教師模型 GLM-5.3 在 Amazon Bedrock 上執行,並以 ShoppingBench Agent 的身份產生軌跡。基準測試本身的評分器只保留能完成任務的軌跡,再透過 SageMaker AI model customization 的無伺服器監督式微調,使用這些已完成任務的軌跡微調 Qwen3.5-4B 學生模型。接着,系統會在留出的 ShoppingBench 分割上評估蒸餾後的學生模型,並透過執行工具循環的 SageMaker AI Inference 即時端點提供服務。
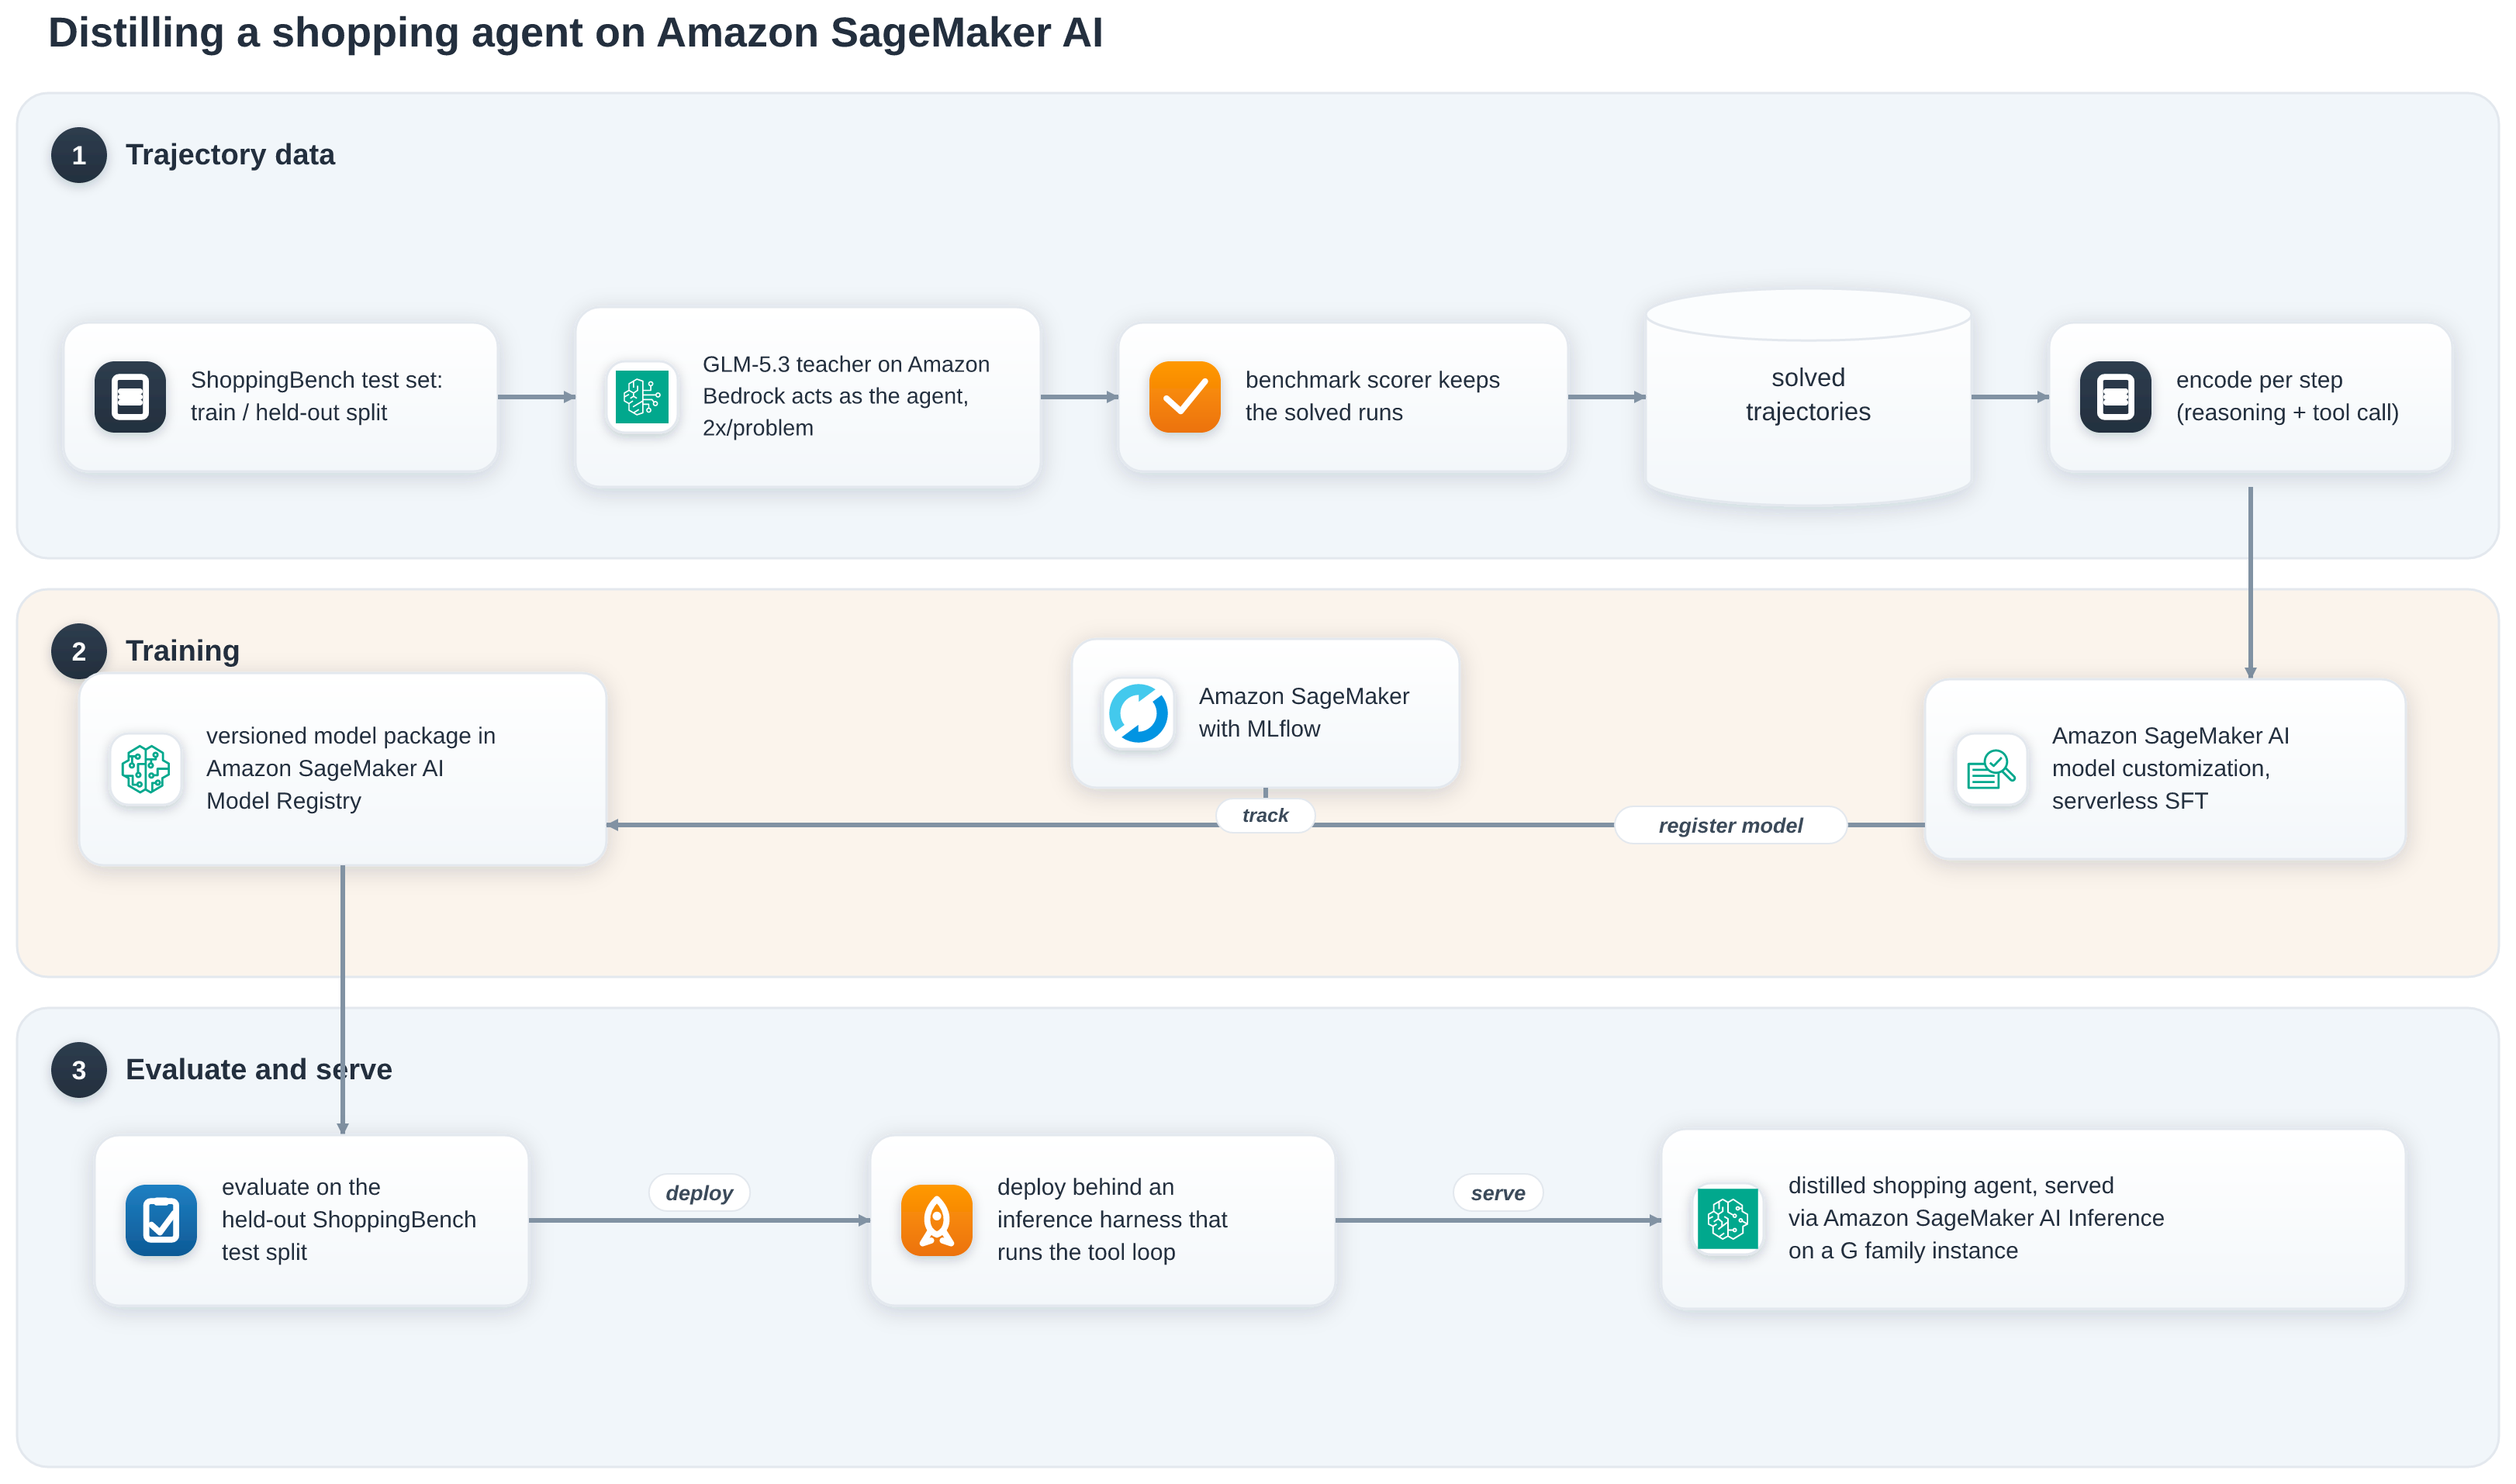
圖 3:在 Amazon SageMaker AI 上蒸餾購物 Agent:Amazon Bedrock 上的前沿教師模型在訓練問題中擔任 ShoppingBench Agent;ShoppingBench 自己的評分器只保留能完成任務的軌跡(拒絕採樣);每條已完成任務的軌跡均按步驟編碼;學生模型透過 Amazon SageMaker AI model customization 進行無伺服器微調;最後在留出的 ShoppingBench 測試子集上評估結果
準備數據集
要取得值得模仿的軌跡並不容易,而 ShoppingBench 評分器正是用來區分成功與失敗執行結果的關鍵。ShoppingBench 公開了 750 個合成購物問題,商品、商店和優惠券意圖各佔 250 個;每個問題都有隱藏的標準答案,以及界定成功條件的限制。我們按固定索引將問題劃分一次,分為 426 個訓練問題和 324 個留出的評估問題(商品 103 個、商店 105 個、優惠券 116 個),確保兩組不會重疊。
對每個訓練問題,前沿教師模型 GLM-5.3 在 Amazon Bedrock 上執行,開啟推理功能並將 temperature 設為 1.0,以 ShoppingBench Agent 的身份執行任務。它會搜尋約有 270 萬件商品的目錄、檢視候選商品,並推薦符合限制的商品。我們為每個問題對教師模型取樣兩次,產生 850 條軌跡,再由 ShoppingBench 自己的評分器只保留能完成任務的軌跡。temperature 設為 1.0 是刻意的安排。採樣而非貪婪解碼,可讓兩次嘗試探索不同的搜尋查詢和推理路徑,令更多問題至少有一條已完成任務的軌跡,並提供更多元的學習資料。這個拒絕採樣步驟能將能力強但不完美的教師模型轉化為乾淨的訓練集,因為教師模型只需有足夠高的成功率,讓成功的執行結果值得模仿。
每條已完成任務的軌跡都是一個完整回合:包括購物者的請求、教師模型在每個步驟中的推理和工具呼叫(搜尋、檢視、推薦、終止),以及環境傳回的觀察結果。我們會將推理與動作一併保留;「結果」部分顯示,這正是讓學生模型大部分程度追上教師模型的關鍵。
為訓練編碼軌跡
序列級蒸餾是對既有軌跡進行監督式學習,因此訓練期間不會呼叫任何工具,而應用程式接觸到的只有文字。由於這些軌跡是多步驟的工具使用對話,我們會將每條軌跡編碼為 messages 對話輪次清單,再由學生模型自身的對話範本呈現,令訓練器所見的 token 與 Agent 推理時產生的 token 一致。
每條軌跡的每個步驟都會成為一列訓練資料。user 輪次包含系統提示詞和目前為止的對話。assistant 輪次包含該步驟的推理,以及由此引出的工具呼叫:先是 … 區塊,接着是符合執行框架原生格式的 [{…}]。只有 assistant 輪次會計算損失,因此模型學習的是產生下一步推理和動作,而不是預測環境返回的觀察結果。包含多個步驟的軌跡會展開為多列資料。此處的已解決軌跡經篩選後,約可展開為 2,600 列訓練資料和 130 列驗證資料。
單列資料會將目前為止的對話(用戶)與要學習的下一個步驟(助理)配對:
{
  "messages": [
    {"role": "user", "content": "You are a shopping assistant. ...\n# Task\nFind a black waist bag under $20 from a shop rated 4.5 or higher.\n# Observations so far\n(none yet)"},
    {"role": "assistant", "content": "<think>Start with a broad search and let the price filter work before I narrow by shop rating.</think>\n<tool_call>[{\"name\": \"find_product\", \"parameters\": {\"q\": \"black waist bag\", \"price\": \"0-20\"}}]</tool_call>"}
  ]
}
之後的每個步驟都會各自成為一列資料,將新的觀察結果附加至用戶內容,並以接下來的推理和工具呼叫作為 assistant 目標,直至最後的 recommend_product 和 terminate 呼叫。每列資料都要使用模型的確切對話範本呈現。
應按問題而非資料列來劃分數據。教師模型會針對每個問題取樣兩次,而每條軌跡又會展開為多個步驟,因此許多資料列會共用同一個問題;若按資料列劃分,訓練集和驗證集之間便會洩漏幾乎相同的上下文。保留整個問題作為測試資料(約百分之五),可確保驗證集反映真實情況。
逐步編碼的代價是上下文重複,因為每列資料都會重述不斷增長的對話;而無伺服器微調會截斷超出 dataset_max_len 的內容,因此超出上限的資料列會失去部分必要內容。不要任由上限決定要截掉甚麼,而應確保資料列符合 token 預算。最有效的做法是精簡工具觀察結果,因為它們佔用了大部分 token。對於產品搜尋結果,只保留下一步決策所需的欄位(id、price、rating,以及正在核對的限制條件),刪除商品列表的原始文字,並限制每次搜尋保留的結果數量。如果軌跡仍超出預算,便限制每條軌跡的步驟數。此處 dataset_max_len 為 16,384 tokens,在精簡觀察結果後足以容納大部分軌跡。
每個劃分的 JSONL 檔案放到 S3 後,使用 SageMaker Python SDK v3 透過 DataSet.create 將各檔案註冊為模型定製資料集資產;這會返回訓練工作所需的 train_dataset 和 val_dataset。
微調學生模型
訓練使用SageMaker AI 模型定製進行無伺服器 SFT。你可以從模型中心選擇基礎模型,指定已編碼的資料集供訓練工作使用;受管理服務會配置運算資源、執行訓練工作並返回定製模型,而評估指標則會記錄在Amazon SageMaker with MLflow。由於數據已採用支援的格式,因此無須管理訓練指令碼、容器映像檔或執行個體。
工作會將輸出寫入一個 模型套件羣組,該羣組會為其產生的每個模型建立版本,因此請先使用 ModelPackageGroup.create 建立羣組(若名稱已存在則重用),並將其傳遞給訓練器。然後設定客製化工作。選擇基礎模型和訓練類型,指定訓練及驗證數據集,以及模型套件羣組;接着為 MLflow 實驗命名,讓工作執行期間指標持續串流至 MLflow。
from sagemaker.train.sft_trainer import SFTTrainer
from sagemaker.train.common import TrainingType

sft_trainer = SFTTrainer(
    model="huggingface-vlm-qwen3-5-4b",  # Qwen3.5-4B from the JumpStart model hub
    training_type=TrainingType.LORA,  # TrainingType.FULL for full fine-tuning
    training_dataset=train_dataset.arn,
    validation_dataset=val_dataset.arn,
    model_package_group=model_package_group,
    mlflow_experiment_name="seqkd-shopping-exp",
    s3_output_path="s3://<amzn-s3-demo-bucket>/seqkd/output/",
    accept_eula=True,
)
訓練器會使用一組有文件記錄的預設超參數開始訓練,你可以使用 sft_trainer.hyperparameters.to_dict() 查看,並在啟動前覆寫。本次訓練會提高序列長度,以容納多步驟軌跡;採用 64 的低秩適應(LoRA)秩,並在小型數據集上訓練三個 epoch:
sft_trainer.hyperparameters.dataset_max_len = 16384
sft_trainer.hyperparameters.max_epochs = 3
sft_trainer.hyperparameters.global_batch_size = 64
sft_trainer.hyperparameters.learning_rate = 0.0001
sft_trainer.hyperparameters.lora_rank = 64
sft_trainer.hyperparameters.lora_alpha = 256  # alpha / rank = 4
sft_trainer.hyperparameters.lr_warmup_steps_ratio = 0.1
sft_trainer.hyperparameters.train_val_split_ratio = 0.95
先以 dry run 驗證設定,再啟動受管理的工作,並在工作完成後讀取已註冊的 Model Package ARN。該 ARN 是可供部署的成品,評估及服務步驟都會使用它:
from sagemaker.core.resources import TrainingJob

sft_trainer.train(dry_run=True)  # checks the config without launching
training_job = sft_trainer.train(wait=True)  # launch and wait
model_package_arn = TrainingJob.get(
    training_job_name=training_job.training_job_name
).output_model_package_arn
評估學生模型
分兩個階段評估,先進行成本最低的階段。完整的端對端評估既耗時又消耗資源。它會在數百萬件產品上架設搜尋伺服器、部署端點,並對每個留出問題執行多步驟 Agent 循環。在進行完整評估前,先使用 SageMaker AI 模型評估執行低成本的受管理預檢;這項評估會逐個生成步驟,根據教師模型的真值動作進行評分。
預檢需要評分函數。模型評估支援由你提供的 Custom Scorer 獎勵函數;該函數每個樣本執行一次,比較學生模型生成的動作與教師模型的動作。對於工具呼叫蒸餾,應評核工具選擇(模型是否按正確次序呼叫正確的工具,不理會參數格式),因為這正是蒸餾最需要遷移的行為。為了聚焦工具選擇而非語法,獎勵函數會從學生模型的動作及教師參考內容中讀取工具名稱,而不要求兩者格式完全一致。
def reward_function(sample, index):
    pred = sample.get("model_response", "")
    ref = sample.get("reference_answer", "") or sample.get("response", "")

    ref_names = tool_names(ref)  # tool names from the teacher's <tool_call>[...]</tool_call>
    pred_names = tool_names(pred)  # tool names the student emitted, parsed leniently
    toolset = 1.0 if (pred_names and pred_names == ref_names) else 0.0

    return {
        "id": str(sample.get("id", f"sample-{index:03d}")),
        "aggregate_reward_score": toolset,  # the gate metric: tool selection
        "metrics_list": [
            {"name": "toolset_match", "value": toolset, "type": "Reward"},
        ],
    }
使用 Evaluator.create() 將該函數註冊為有版本管理的 Evaluator,然後呼叫 evaluate(),為每項任務執行一個 Custom Scorer 工作,同時為基礎模型和學生模型評分,讓每項結果都有可供比較的對象。
判斷準則很直接:學生模型必須在這項低成本預檢中勝過基礎模型。若勝出,便表示蒸餾已奏效,值得進行更全面的端對端評估;若未勝出,先修正訓練。
為蒸餾後的 Agent 提供服務
蒸餾後的模型不會自行執行工具。微調會教它在適當時機以文字輸出正確的工具呼叫,但仍須由其他程式執行該呼叫並傳回結果。推理時,你可以用一個小型、確定性的控制程式包裝模型:向模型提供提示詞、解析它輸出的工具呼叫、執行工具、附加觀察結果,再次提供提示詞,如此循環直至模型產生最終答案。這只是一般應用程式碼或現成的服務框架,並非強化學習,也不是 on-policy 訓練循環。
學生模型是基於開放權重基礎模型的 Low-Rank Adaptation (LoRA) 適配器,這會影響部署方式。與其合併適配器並部署第二份完整權重,不如只部署一次基礎模型,再把學生模型作為適配器掛載其上,讓兩者成為同一個即時端點上的兩個推理元件。呼叫時指定推理元件名稱,即可選擇由哪個模型作答,因此同一端點可同時提供基礎模型及蒸餾學生模型服務,方便並排比較。
我們使用 Deep Java Library Large Model Inference (DJL LMI) 容器提供開放權重模型服務。容器內置 vLLM 引擎,可進行高吞吐量生成;我們將版本固定為指定版本,而非 latest,確保重新部署時結果可重現。隨附的筆記本以簡單的 kd_serve 輔助程式封裝推理元件呼叫,因此,啟用 LoRA 服務後部署基礎元件,再掛載學生模型適配器,只需:
from sagemaker.core import image_uris
import kd_serve

# DJL LMI container (vLLM engine bundled in); pin the version for reproducible redeploys
image_uri = image_uris.retrieve("djl-lmi", region=region, version="0.36.0")

# 1. Deploy the base model as an inference component, with LoRA serving enabled.
endpoint_name, base_ic = kd_serve.deploy_base_endpoint(
    endpoint_name="seqkd-shopping-agent",
    role=role,
    region=region,
    image_uri=image_uri,
    base_model_id="Qwen/Qwen3.5-4B",
    instance_types=["ml.g5.2xlarge", "ml.g6.2xlarge", "ml.g6e.2xlarge"],
    max_lora_rank=64,
    max_loras=4,
    max_model_len=131072,
)

# 2. Resolve the student's adapter artifacts from its Model Package and attach them
# as a second inference component on the same base.
adapter_uri = kd_serve.resolve_adapter_uri(model_package_arn, region)
student_ic = kd_serve.attach_adapter(
    endpoint_name=endpoint_name,
    base_ic_name=base_ic,
    adapter_component_name=f"{endpoint_name}-student",
    adapter_s3_uri=adapter_uri,
    region=region,
)
instance_types 清單按優先次序排列。SageMaker AI Inference 會部署到第一個有可用容量的執行個體類型;如無可用容量,則會依序嘗試清單中的下一種類型。因此,學生模型會視乎可用情況,部署在 ml.g5.2xlarge、ml.g6.2xlarge 或 ml.g6e.2xlarge 上。基礎模型權重只載入一次,兩個推理元件共用這些權重;因此,加入適配器只需適配器大小的記憶體,無需再載入一份模型副本。
結果
我們在保留的 ShoppingBench 測試集上評估蒸餾學生模型,並與一組界定理想表現水平的參考基準比較:
- Base Qwen3.5-4B:未經微調、可直接使用的學生模型,代表表現下限。
- 蒸餾學生模型 (SeqKD):在教師模型生成的軌跡上微調的同一個 4B 模型,亦即本文介紹的方法。這是最值得關注的結果。
- GLM-5.3 教師模型:在 Bedrock 上生成訓練數據的前沿模型。我們同時報告取樣結果(温度 1.0,即生成數據時使用的設定)及貪婪解碼結果(温度 0)。
- 中型前沿模型:以 Agent 形式執行的強大專有模型,作為實際可達表現上限的參考。
所有模型均使用相同、未經修改的 ShoppingBench Agent 流程,涵蓋三種購物者意圖(產品、店舖及優惠券)。我們報告絕對成功率 (ASR),即 Agent 成功解決的保留問題比例,並按三種意圖取平均;缺少軌跡的個案則計作失敗。當建議的產品符合所有明確列出的限制條件時,該問題便計作已解決。以下數據來自單次使用 LoRA 學生模型的執行結果,因此不同執行之間的數值預計會有數個百分點的波動。
任務成功
最重要的結果是 324 個保留問題的絕對成功率,並按意圖分類及計算三種意圖的平均值:
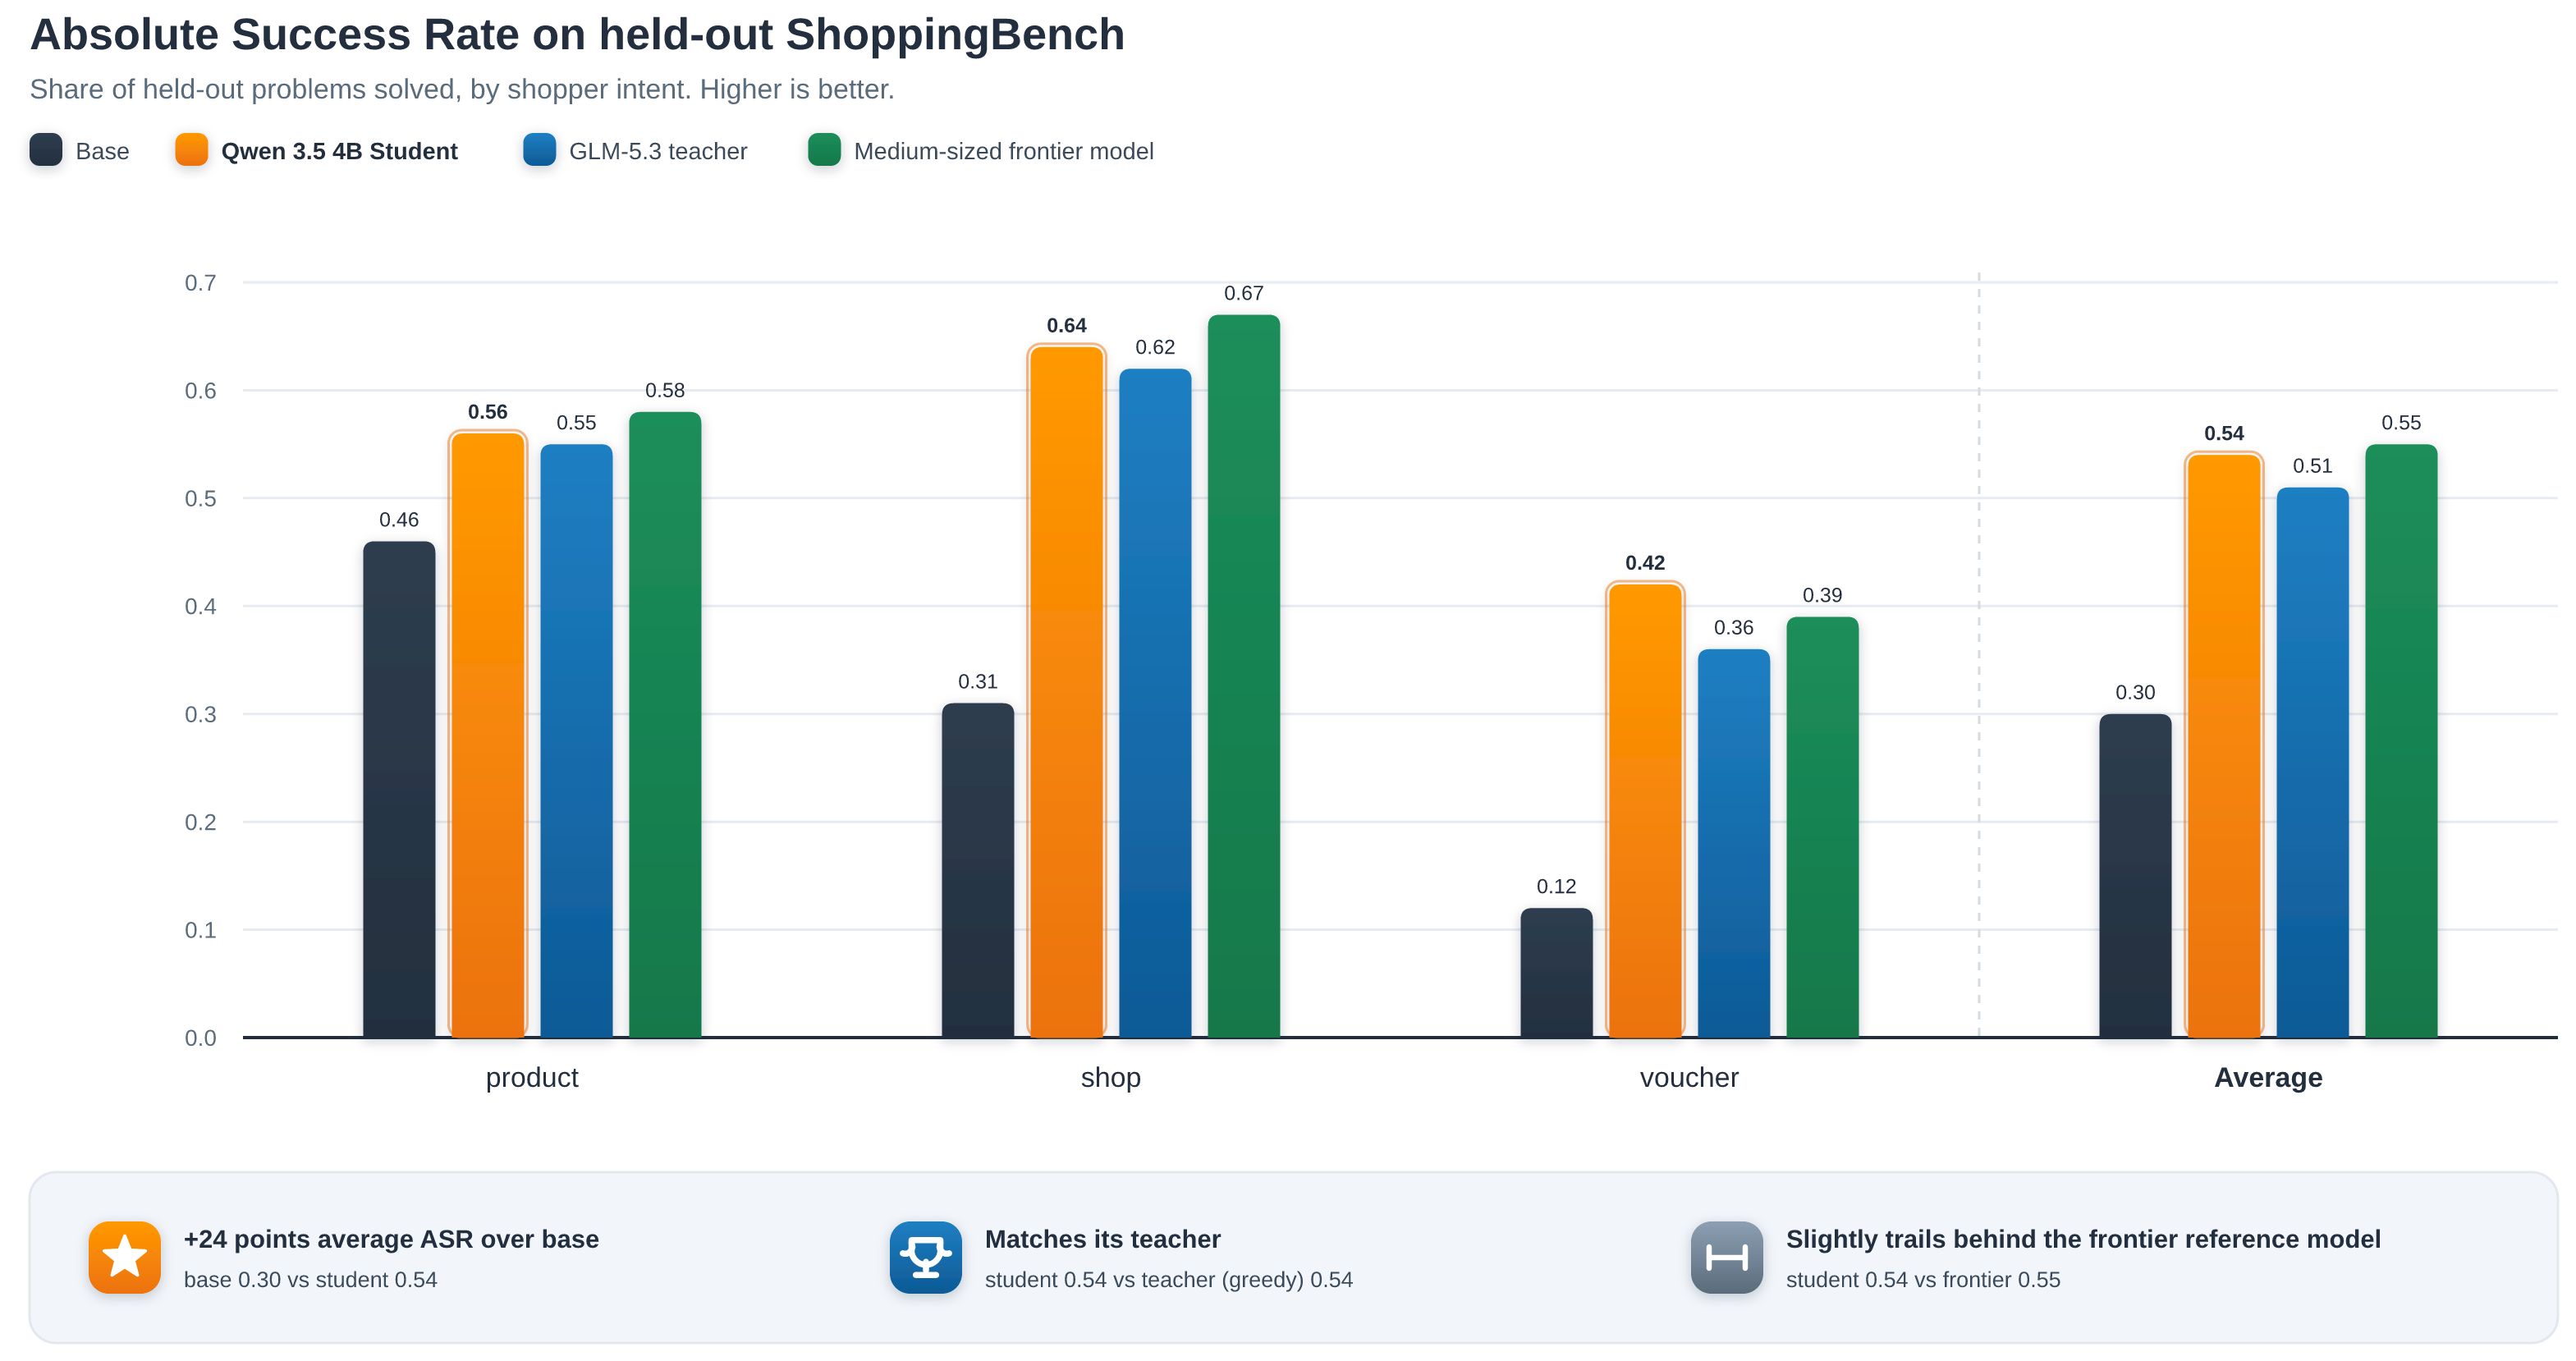
圖 4:保留的 ShoppingBench 測試集上按購物者意圖分類的絕對成功率 (ASR)。蒸餾後的 4B 學生模型(橙色)平均比基礎模型高 24 個百分點,追上了生成其訓練數據的 GLM-5.3 教師模型及一個中型前沿模型
| 模型 | 產品 | 店舖 | 優惠券 | 平均 |
| Base Qwen3.5-4B(未經微調) | 0.456 | 0.314 | 0.121 | 0.297 |
| 蒸餾學生模型 (SeqKD) | 0.563 | 0.638 | 0.422 | 0.541 |
| GLM-5.3 教師模型(取樣,温度 1.0) | 0.553 | 0.619 | 0.362 | 0.511 |
| GLM-5.3 教師模型(貪婪解碼,温度 0) | 0.544 | 0.638 | 0.439 | 0.540 |
| 中型前沿模型 | 0.583 | 0.667 | 0.388 | 0.546 |
總括而言,4B 模型幾乎完全恢復了其前沿教師模型的任務表現,在不同執行的波動範圍內與教師模型相當。我們以兩種方式呈現教師模型的結果,因為兩者回答的是不同問題。貪婪解碼會產生機率最高的單一路徑;當每個模型對每道題目只有一次作答機會時(如本次評估),這是較合適的選擇,因此貪婪解碼的教師模型得分為 0.540,高於抽樣教師模型的 0.511。我們以另一種方式生成訓練資料:在 temperature 1.0 下抽樣,讓多次嘗試探索不同路徑,再由評分器保留成功完成任務的結果。這種篩選也是學生模型略勝它所學習的抽樣教師模型的原因之一:拒絕抽樣只用教師模型成功完成任務的執行結果訓練學生模型,而非使用教師模型的平均輸出,因此學生模型模仿的是最佳結果的子集,而非完整的嘗試範圍。
訓練目標中的推理很重要
學生模型不但學習教師模型的工具呼叫,也學習其推理;這個選擇是取得此成果的重要原因。使用相同的執行軌跡訓練同一學生模型,但移除推理、只保留工具呼叫後,平均 ASR 會由 0.541 降至 0.415:
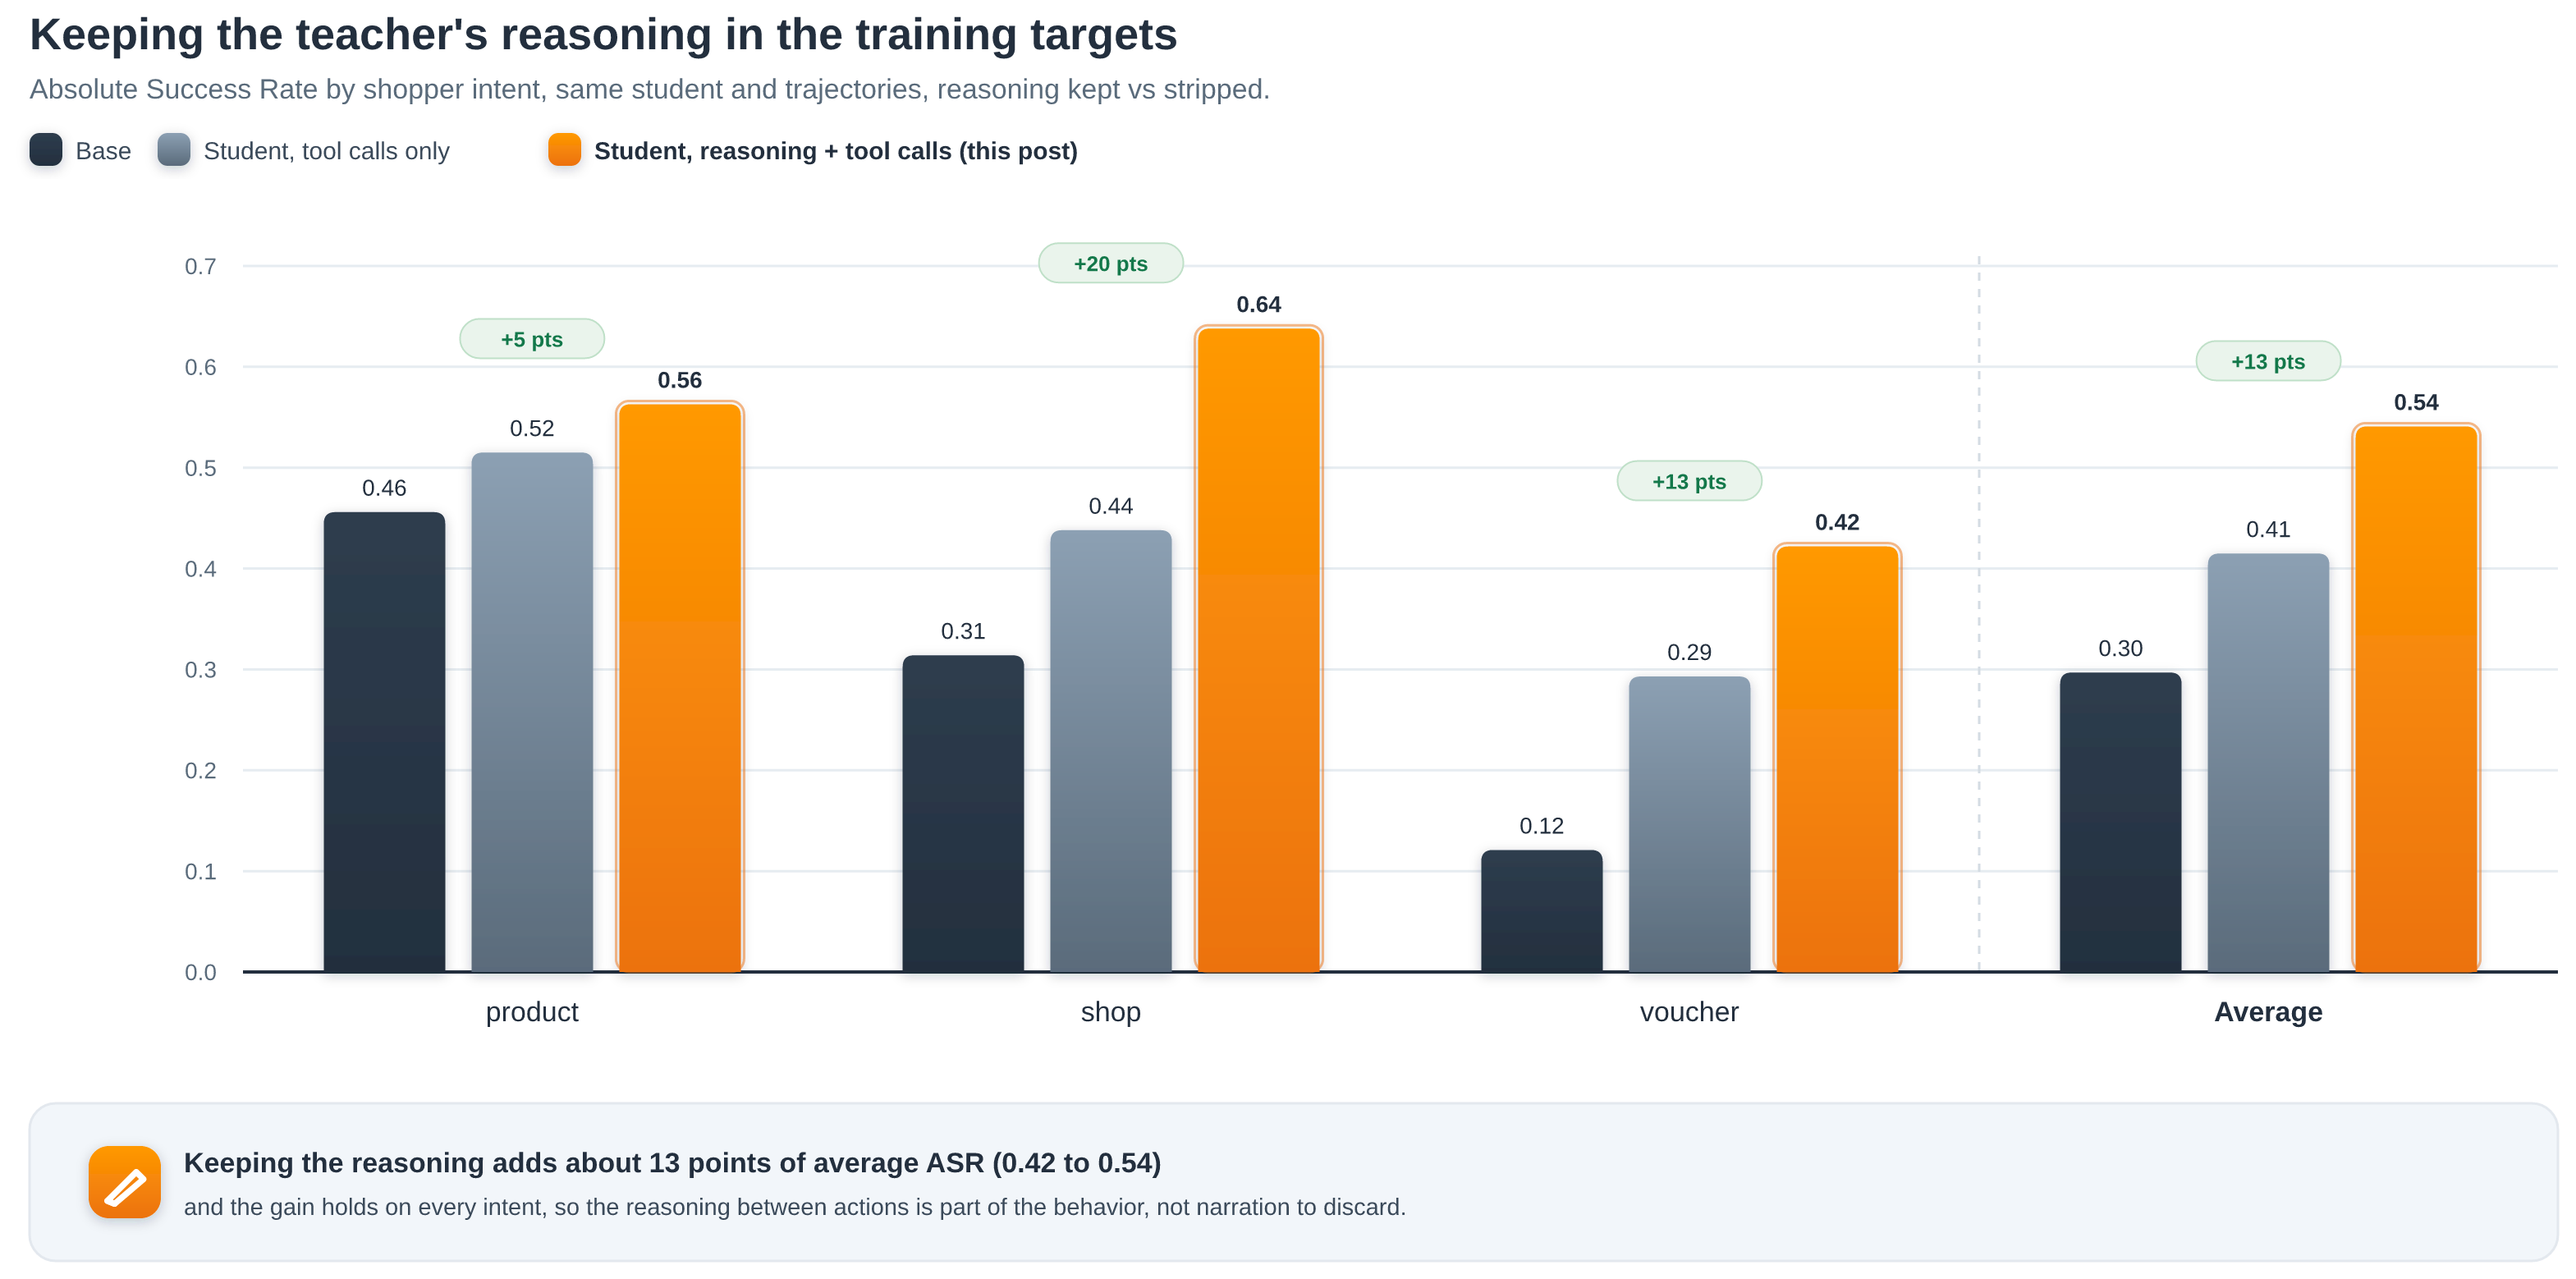
圖 5:基礎模型、只以工具呼叫訓練的學生模型,以及以教師模型的推理和工具呼叫訓練的學生模型,其絕對成功率。保留推理令平均 ASR 增加約 13 個百分點,而且所有意圖類別均有提升
兩種學生模型的表現都優於基礎模型,因此只使用工具呼叫的版本也確實有所提升;但保留推理,才令學生模型進一步達到教師模型的水平。動作之間的推理並非可以刪去的敍述,而是解決任務行為的一部分。
保留一般能力
ASR 衡量我們希望蒸餾的技能。另一方面,學生模型是否保留一般指令遵循能力,還是對購物任務過度擬合,也值得留意。我們使用 IFEval 檢查;這是一項一般指令遵循基準測試,會評分可驗證的格式指令,例如「答案必須恰好包含三個項目符號」。應把它視為回歸檢查,而非排行榜。學生模型的 prompt-strict 分數由基礎模型的 0.819 降至 0.741,instruction-strict 分數則由 0.872 降至 0.813,跌幅約為 6 至 8 個百分點(圖 6)。這是專門化預期要付出的代價。學生模型以部分一般指令遵循能力,換取購物任務上的大幅提升。如果跌幅大得多,就表示蒸餾可能令模型的能力範圍收窄得過分。
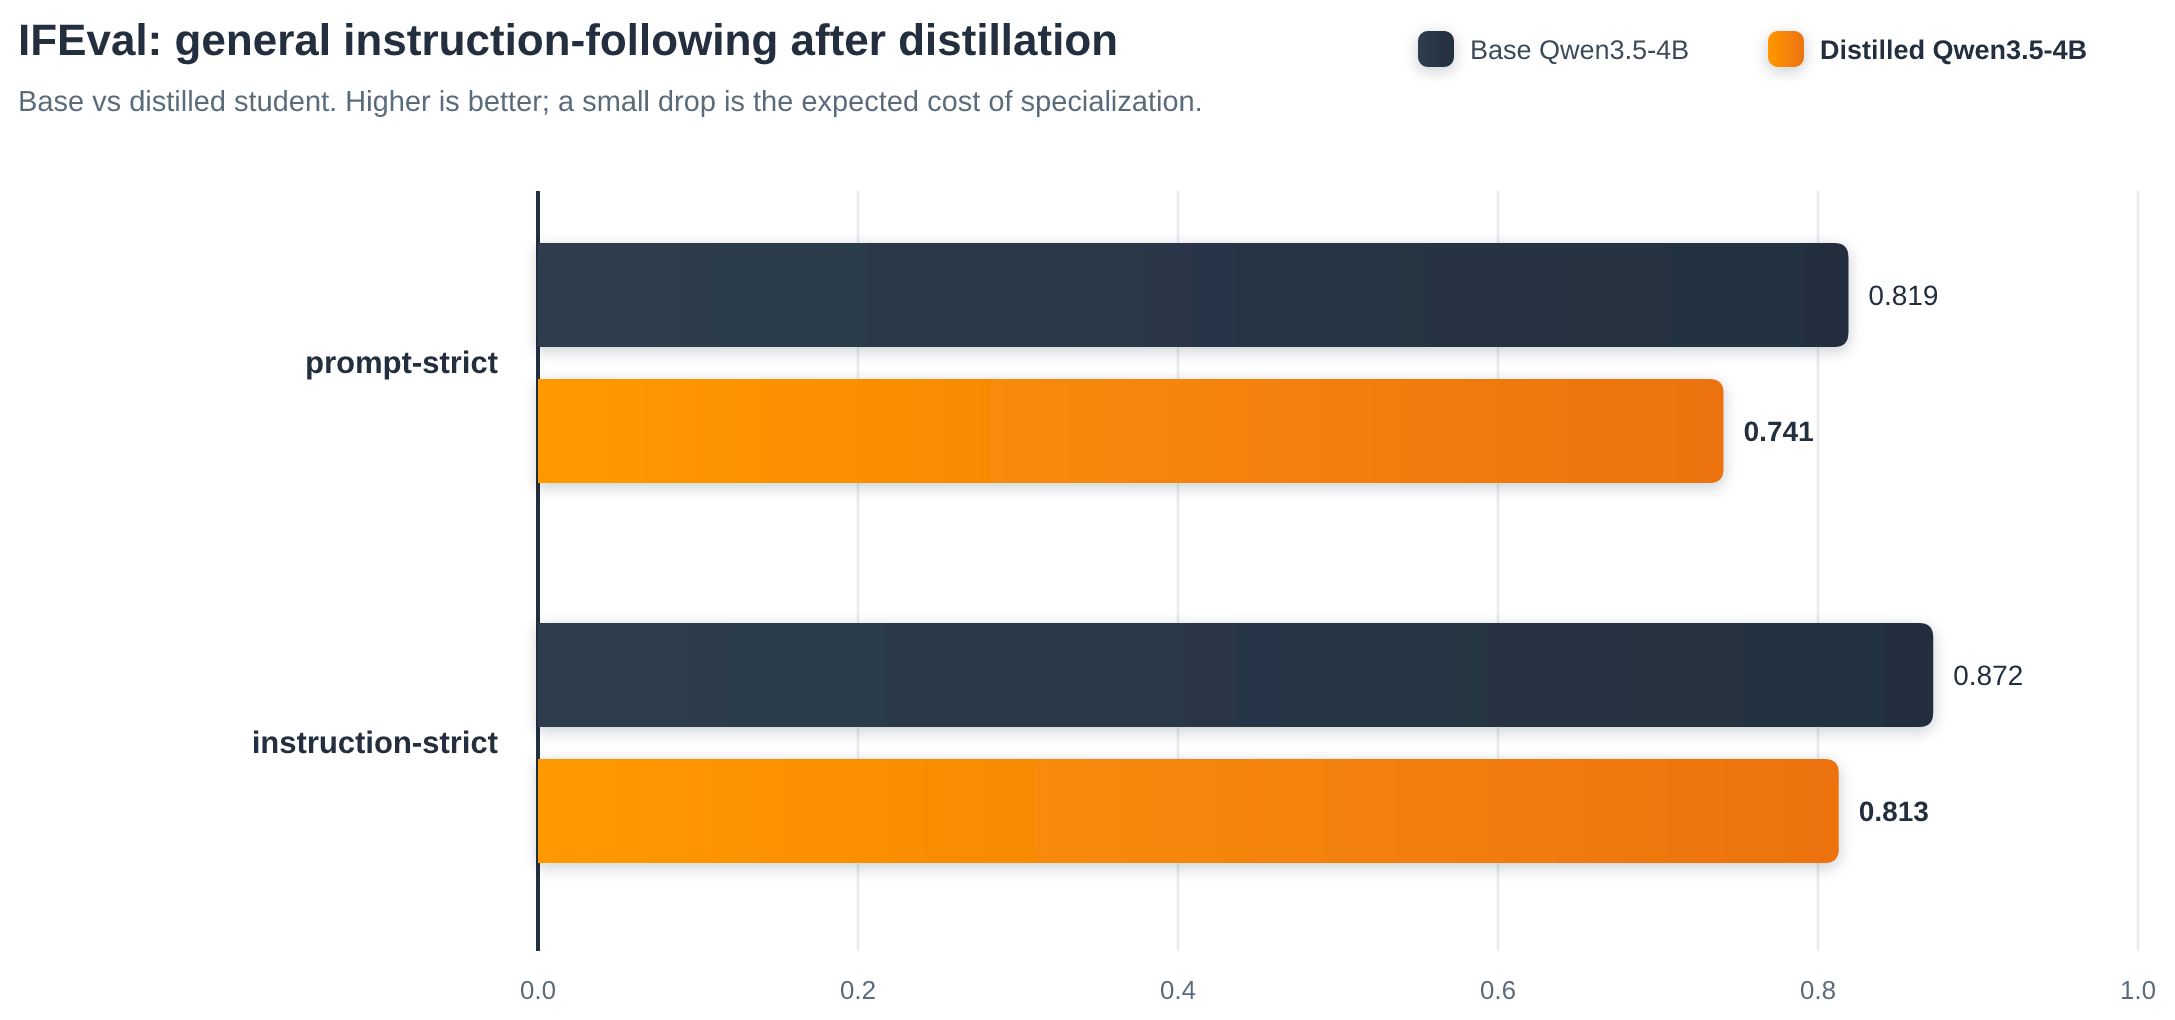
圖 6:基礎模型及蒸餾後學生模型在 IFEval 一般指令遵循測試中的表現,採用 prompt-strict 和 instruction-strict 指標。小幅下跌是專門應對購物任務的預期代價
優點與取捨
單看成功率不足以支持轉換。蒸餾的理由是,能以小型模型的成本和速度,取得較強模型的大部分表現。最明確的證據是,4B 學生模型的任務表現達到其前沿教師模型及一個中型前沿模型的水平,同時體積小巧,可在單一 G 系列執行個體上提供服務(本例為 NVIDIA A10G/L40/L40S)。
成本差異既關乎規模,也關乎成本模式。透過 API 使用前沿模型時,每項任務的每一步都會按 token 計費,因此成本會隨用量增加而持續累積;引言所述的 Agent 工作循環每次執行都要支付這筆成本。蒸餾後的學生模型則在你架設的端點上執行,按執行個體的使用時數計費,不論它處理一項任務還是數千項任務,費用都一樣;在擴展規模前,增加流量不會帶來額外費用。換言之,你是以固定的每小時費用,取代浮動的每次請求費用;而你能採用的模型越小,這筆固定費用就越低。
這裏沒有列出每項任務的成本或延遲數字,因為這取決於你的流量:G 系列執行個體可維持的吞吐量,以及分攤至每項任務的成本,都取決於你的請求模式、序列長度和並行度。請以自己的工作負載進行測量,並與目前的 SageMaker AI 定價及前沿模型供應商的 token 定價比較,而不要依賴單一的概括數字。
限制與最佳做法
學生模型能否勝任這項任務(能力上限)
蒸餾傳遞的是學生模型本身已能表達的分佈,而不是它欠缺的原始能力。當能力差距過大,學生模型只會模仿教師模型的格式,卻沒有學會解題。以大型教師模型的思維鏈訓練小型模型,會產生冗長而結構良好的推理,但答案仍然錯誤;以同樣方式訓練的 Agent,則會產生格式正確、卻毫無進展的工具呼叫,以改寫過的查詢反覆搜尋,並在未能符合約束條件前就用盡步數。兩者的症狀相同:執行軌跡愈來愈長,準確度卻原地踏步。出現這種情況時,請停止增加資料,改為擴大學生模型,或降低任務難度。
決定成敗的差距,在於任務與學生模型之間,而非學生模型與教師模型之間。只要任務本身在小型學生模型的能力範圍內,它就能達到遠大型教師模型的水準。這就是本文的購物 Agent 能奏效的原因。教師模型是混合專家模型,約有 40 billion 個啟用參數,約為學生模型 4 billion 的十倍;但購物任務在 4B 模型的能力範圍內,因此學生模型能達到教師模型的水準,而不只是生成更長的執行軌跡。
SeqKD 何時不再奏效
SeqKD 能提升簡單和中等難度問題的表現,但在最難的問題上會遇到瓶頸,因為學生模型必須從自身錯誤中恢復。相較於單步任務,這個問題在 Agent 身上更為明顯。在多步驟循環中,早期錯誤會不斷累積,因為學生模型看不到自身錯誤所導致的狀態。on-policy 方法正是為了縮小這個差距而設計,因此 SeqKD 通常是第一階段,而非終點。SeqKD 對基礎設施的要求也最低,因為它只使用教師模型的文字;相比之下,logit 蒸餾需要教師模型逐 token 的分佈,而 on-policy 方法則會評分學生模型自身生成的軌跡。先以純文字 SeqKD 暖啟動,再進入 on-policy 階段,是常見的做法;因此,本文涵蓋的是第一階段,而如何突破瓶頸則是順理成章的下一步。
左右成果的兩項選擇
首先,讓訓練目標符合你希望模型呈現的行為。在這個例子中,這代表每次工具呼叫都保留教師模型的推理,而不是將內容壓縮成最終答案,因為推理本身是解決任務的一部分(Results 量化了兩者的差距);此外,每個訓練目標都要按照代理在提供服務時使用的聊天範本格式呈現。其次,要如實評估。使用模型未曾見過的數據進行測試,因為基準測試數據外洩會令評分虛高;此外,除了學生模型必須超越的未訓練基礎模型,也要與教師模型及另一個獨立的前沿模型比較,才能看出學生模型與其蒸餾來源的差距。
清理資源
即時推理端點只要保持運作就會持續收費,因此取得結果後,應拆除先前為提供服務而啟動的端點。由於學生模型是以 adapter 推理元件的形式,建基於基礎推理元件提供服務,因此必須按照依賴次序移除各個元件:先移除 adapter 元件,再移除基礎元件,最後移除端點及其設定。隨附的 kd_serve 輔助程式會代你完成這些工作,並透過結構識別 adapter,無論元件名稱具體為何,都能妥善清理:
import kd_serve

# Deletes the adapter IC, then the base IC, then the endpoint and its configuration
kd_serve.teardown_endpoint(endpoint_name, region=region)
訓練工作本身不需要清理。無伺服器訓練會自動配置運算資源、執行訓練並釋放資源,因此已完成的訓練工作不會持續產生費用。已註冊的模型套件及其羣組也不會產生運算成本,因此可以保留作沿襲追蹤,日後重新部署。唯一會持續產生費用的是儲存在 S3 的數據(編碼後的軌跡及輸出成品);只要保留這些數據,就會產生儲存費用,因此請刪除不再需要的數據,或將其移至成本較低的儲存級別。
結論
本文介紹瞭如何透過序列層級知識蒸餾(SeqKD),將具代理能力的購物助理蒸餾成規模較小、成本較低的學生模型。我們在 Bedrock 上使用前沿教師模型生成高質素的單輪、多步驟軌跡,並使用 ShoppingBench 自家的評分器,只保留成功完成任務的軌跡;接着將每個步驟編碼為聊天格式的訊息,保留教師模型的推理及工具呼叫,再透過 SageMaker AI model customization 在無伺服器基礎設施上微調學生模型,以 MLflow 追蹤訓練,使用 SageMaker AI model evaluation 進行品質閘門檢查,最後將模型部署到會執行工具循環的推理端點。成果是一個 4B 學生模型,其任務品質幾乎完全達到前沿教師模型的水準。由於 SeqKD 只需要教師模型的文字輸出,即使教師模型是透過 API 存取的封閉式前沿模型,也適用;學生模型接手後,你便不必再為每個步驟支付前沿模型的費用。
SeqKD 是一個成效顯著的起點,但也有實際限制。要按任務選擇合適規模的學生模型,並在保留測試集上與有力的參照對象比較,而不應只與未訓練的基礎模型比較。若最棘手的一小部分問題難以透過模仿解決,可在 SeqKD 之後採用本文未涵蓋的 on-policy 方法,讓學生模型從自身生成的 rollout 中學習。
如要親自嘗試,請參閲隨附的程式碼儲存庫及SageMaker AI 文件。
作者簡介

Giuseppe Zappia
Giuseppe 是 AWS 的首席生成式 AI 專業解決方案架構師,專注協助大型企業在 AWS 上設計及部署生成式 AI 解決方案。他擁有超過 20 年全端軟件工程師經驗,過去 7 年在 AWS 專注於 AI 領域。

Ankita Agarwal
Ankita 是 AWS 的軟件開發工程師,負責 Amazon SageMaker AI 的分散式訓練及強化學習。她持有南加州大學電腦工程碩士學位。工作以外,她喜歡旅行。

Amin Dashti
Amin 是 AWS 的資深數據科學家及研究員,負責後訓練及模型自訂,包括強化學習、微調和知識蒸餾,以調整大型模型,並將其能力壓縮至較小且可部署的模型。他擁有超過 8 年經驗,曾為電腦視覺、自然語言處理及金融系統的統計推理建構和部署機器學習系統。他持有理論物理學博士學位,這塑造了他研究模型行為及評估的方法。

Michael Oguike
Michael 是 Amazon SageMaker AI 的產品經理。他致力運用科技及 AI 解決現實問題。在 AWS,他協助各行各業的客戶大規模建構、訓練及部署 AI/ML 模型。加入 AWS 前,Michael 曾設計及營運海上油氣井和設施。工作以外,他喜歡透過書籍和 podcast 節目探索行為科學及心理學。
來源:AWS Machine Learning Blog · aws.amazon.com