AWS CDK 如何在 Managed Amazon Bedrock Knowledge Base 上構建智能體檢索
Build agentic retrieval on a Managed Amazon Bedrock Knowledge Base with CDK
AWS Machine Learning Blog 示範以 Python AWS CDK,在 Managed Amazon Bedrock Knowledge Base 上構建跨兩個知識庫的智能體檢索系統。
文章展示如何用 CDK 管理跨堆疊依賴,並把跨知識庫檢索、追蹤與評估一併部署,提供企業檢索系統的實作路徑。
本文使用 AWS Cloud Development Kit (AWS CDK),在 Managed Amazon Bedrock Knowledge Base 上建置企業級代理式檢索。要了解這項建置的價值,不妨先看看一般的檢索增強生成(RAG)在哪些情況下會失效。大多數 RAG 系統的運作方式都相同:將問題轉換為嵌入向量,從單一索引擷取最相近的區塊,交給模型,再傳回答案。一次檢索、一次生成。對很多問題來説,這種設計恰如其分,無須建置更複雜的系統。
它的失效方式很容易辨認。若問題的答案涉及兩個語料庫,單次檢索可能只會返回模型所需資料的一半;這比甚麼也不返回更糟,因為答案讀來流暢,卻不完整。若問題的適合資料來源取決於問題本身,單一索引便沒有機制可作出選擇。若問題需要在看到首個結果後再次查閲語料庫,系統便無法進行這第二次查閲。
企業級代理式檢索透過讓推理代理參與其中,解決上述三種問題。代理會決定是否進行檢索、要查閲哪個知識庫,以及在撰寫答案前是否需要再次檢索。這正是Amazon Bedrock Knowledge Bases的演進方向。Managed Knowledge Base 推出後,檢索不再只是一次嵌入並擷取資料的呼叫,而是成為代理式功能:支援多輪規劃、由工具驅動的檢索,以及有根據並附有引文的答案。AgenticRetrieveStream API 將這些功能作為一級服務功能提供,而不是要你自行組裝。這種做法確實可行,但也帶來更棘手的營運問題。單次執行的管道可以透過閲讀程式碼來推敲;能夠反覆推理和檢索的代理,則會因應每個問題走上不同路徑。預設情況下,你既看不到它採取的路徑,也無從得知它產生的答案是否可靠。可觀測性不再只是錦上添花,而是瞭解系統是否正常運作的唯一方法。
2024 年 8 月,使用 Amazon Bedrock Knowledge Bases 和 AWS CDK 建置端對端 RAG 解決方案以 CDK 應用程式部署了單次執行的設計:包括 Amazon Simple Storage Service (Amazon S3) 語料庫、Amazon OpenSearch Serverless 集合和索引、知識庫,以及資料來源;這些資源以 CDK 堆疊佈建,並由你手動安排部署次序。自文章發布以來,已有三項變化。
- Amazon Bedrock 現在提供受管理的知識庫(Type: MANAGED),由服務自行負責資料擷取、儲存、索引和檢索。文章中佈建的 OpenSearch Serverless 集合和索引,現在不再需要你建立、擴充或支付 OpenSearch Compute Units (OCUs) 費用。
- Amazon Bedrock AgentCore 提供代理式功能的另一半:Gateway 可將每個知識庫公開為模型上下文協定(MCP)工具;Runtime 可託管推理代理;AgenticRetrieveStream 則會在內部重新排序,並返回經綜合整理且附有引文的答案。代理式檢索只適用於 Managed Knowledge Base。
- 可觀測性與評估方案如今已可直接配置,而非之後才加裝。這套方案隨附兩個 Amazon CloudWatch 儀錶板,涵蓋七層遙測資料,並提供兩種評估方式:按需評估及持續評估,全部來自同一部署。
本文會以 Python 編寫的單一 AWS CDK 應用程式建構這套系統:一個代理程式可在兩個知識庫之間路由,透過 Gateway 擷取資料,並提供有根據且附有引用來源的答案,同時為每一層行為加入監測。只需執行一個命令即可部署所有元件,CDK 會推導部署次序。
如果你讀過2024 年的文章,從 Amazon S3 儲存貯體到知識庫的流程會似曾相識;其後的部分則全是新內容:不再使用向量儲存庫,檢索改採代理式流程,而應用程式配置的資源中,約有一半用來呈現代理程式的操作情況。如果你未讀過,本文內容亦完整獨立。
以下展示相關服務,以及一條問題經過這些服務的路徑:代理程式會決定是否需要檢索,以及要查閲哪個知識庫;Gateway 會將每個知識庫公開為可供呼叫的工具;Managed Knowledge Bases 負責搜尋及引用資料;循環會按問題需要重複執行。代理程式沿途的所有操作都會記錄至 Amazon CloudWatch。
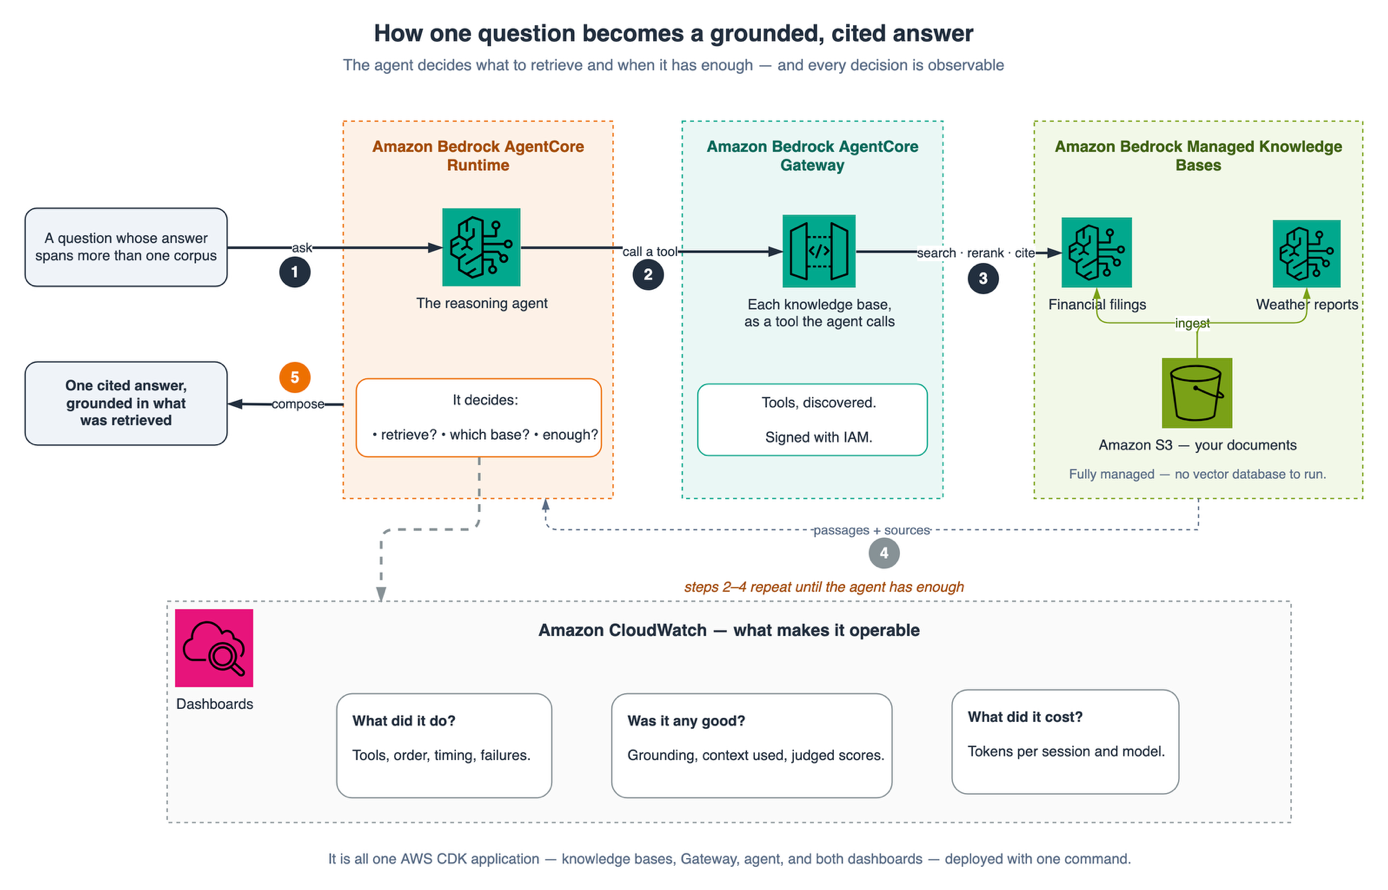
圖 1:涉及的服務,以及單一問題經過這些服務的路徑
背景
開始逐步講解前,先了解三件事會有所幫助:令檢索成為代理式檢索的特點、Managed Knowledge Base 為何是合適的基礎,以及為何應從設計之初便納入可觀測性與評估,而非日後才加裝。
由 RAG 走向企業級代理式檢索
傳統檢索增強生成(RAG)只會執行一次檢索及一次生成。企業級代理式檢索則會加入推理代理,由它決定是否需要檢索及要檢索甚麼,並可多次檢索以完善結果、選擇相關的知識庫(語義路由),然後才撰寫有根據且附有引用來源的答案。使用 Managed Knowledge Base 時,這是服務內建的功能:AgenticRetrieveStream API 會執行多輪規劃、進行檢索並傳回附有引用來源的答案,無需在原始向量搜尋之上自行建立及維護協調層。這能為複雜問題帶來更好的答案,但也令系統更複雜、更難以運作,正因如此,可觀測性與評估從一開始便已納入其中。
Managed Knowledge Base 與自行管理知識庫的比較
Amazon Bedrock 現時提供Managed Knowledge Base(類型:MANAGED):Amazon Bedrock 會為你管理資料匯入、儲存、索引及檢索,預設亦會使用服務管理的模型進行嵌入及重排序,因此無需配置、擴展或修補向量資料庫。這與客戶自行管理(DIY)知識庫不同;使用後者時,你須自行選擇及運作向量儲存庫(例如 Amazon OpenSearch Serverless)。
對這套方案而言,以下兩項差異最為重要:
| 功能 | Amazon Bedrock 管理 | 客戶自行管理(DIY) |
| 代理式檢索(AgenticRetrieveStream) |  支援 |
 不支援 |
| AgentCore Gateway 整合 | 支援 |
不支援 |
| 資料儲存區 | 自動擴展,由 Amazon Bedrock 全面管理 | 由你配置、擴展及維護 |
| 嵌入 + 重排序 | 內置託管模型,無需額外費用 | 由你設定 |
| 需要管理的基礎架構 | 無 | 向量資料庫 + 更多 |
由於只有託管知識庫提供代理式檢索及 AgentCore Gateway 連接器,因此它自然成為企業級代理式檢索的基礎。這亦代表 Amazon Bedrock 會代你管理儲存和索引,因此在此設計中,無需佈建 OpenSearch Serverless 集合或 OCU 容量。如果你想自行選擇並操作向量儲存庫,例如重用現有的 OpenSearch Serverless 集合,或滿足特定的資料駐留、調校或合規要求,客戶管理選項仍是合適之選。託管知識庫正是讓企業級代理式檢索成為可能的關鍵。
為何需要可觀測性與評估
代理式系統在正式環境中,光是返回答案並不足夠。你需要了解系統的運作情況(延遲、呼叫量、Token 用量)、檢索和答案的質素,並持續取得這些指標。本方案提供兩個 CloudWatch 儀錶板,涵蓋七層遙測資料;另有兩種評估方式(按需和持續),全部由同一個 CDK 應用程式佈建。答案依據、引文及評估層亦有助負責任地使用。附有引文的答案可追溯至來源段落,讓回應保持可供審核;忠實度和正確性評分則有助你及早發現答案偏離來源,而非等到正式環境中才察覺。
為何這個方案特別適合使用 CDK
任何基礎架構即程式碼工具都能建立這些資源。CDK 在此方案中發揮作用,有一個與這種架構直接相關的原因:四個堆疊之間有大量交叉引用。Gateway 需要兩個知識庫 ID。代理程式需要 Gateway 的 URL 和 ARN。儀錶板則需要知識庫 ID、Gateway ARN,以及代理程式執行環境 ID;共有七個值跨越堆疊邊界,每個值都是某項指標的維度或某個連接器的目標。
若以原始範本編寫,就需要一組堆疊匯出和跨堆疊查詢,並靠人手保持一致;還要有一個按正確次序部署並逐步傳遞輸出的指令碼。只要有任何名稱更改,兩者便會立即出現偏差。在 CDK 中,你只需傳入 construct,匯出項目和依賴關係邊便會由這個傳遞動作自動推導出來。2024 年的方案有三個堆疊,依賴鏈大致呈線性。當架構擴展至四個堆疊,並有七個值在堆疊間傳遞時,這種差異便不再只是風格上的分別。
方案概覽
以下展示單一問題如何從頭到尾經過整個系統。值得仔細看一遍,因為文章其餘部分會由左至右逐步講解這個流程。
下圖展示端到端的代理式檢索工作流程。用戶的問題進入 AgentCore Runtime 上的代理程式,並由它經 AgentCore Gateway 路由至兩個 AgenticRetrieveStream 工具之一;每個工具對應一個託管知識庫,分別是金融和天氣知識庫,兩者均從 Amazon S3 匯入資料。所選工具會返回一個有根據並附有引文的答案,而每個步驟的資料都會串流至 Amazon CloudWatch 和 AWS X-Ray。編號標記對應下文的流程説明。
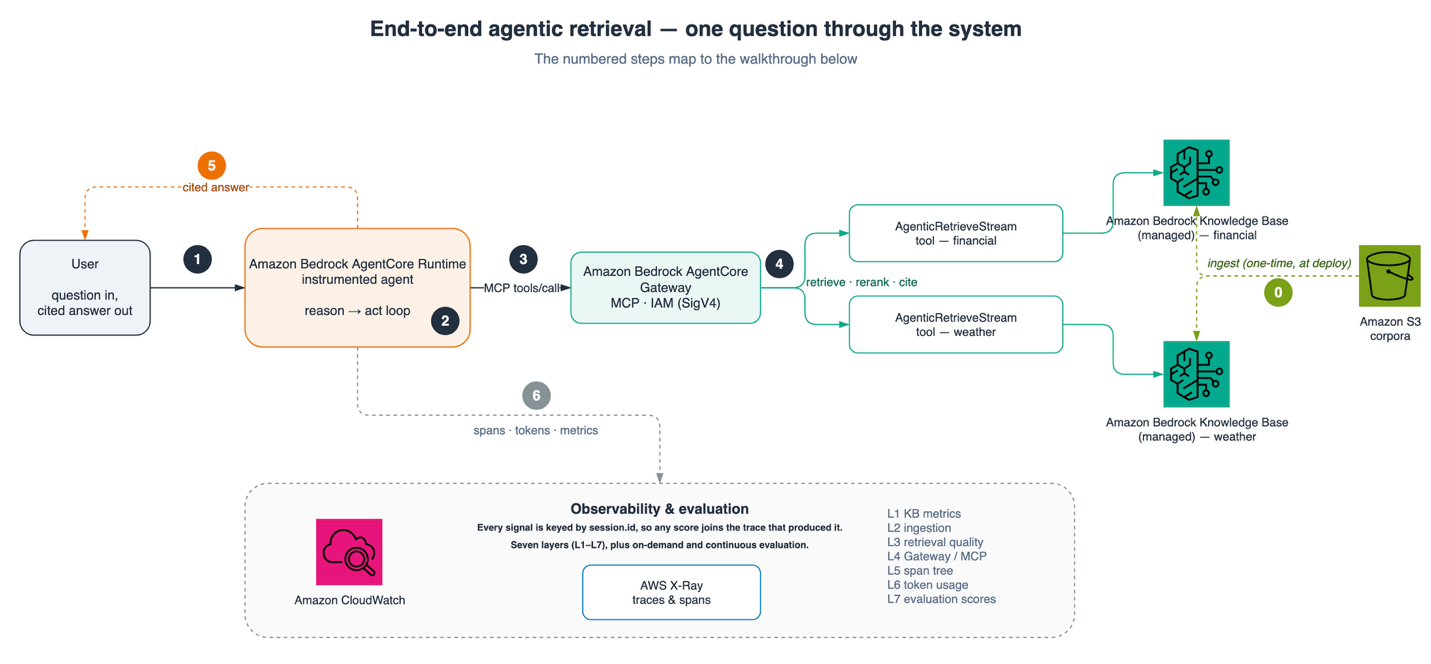
圖 2:單一問題的端到端代理式檢索工作流程
圖中的編號步驟對應以下工作流程。
步驟 0 — 部署時一次性執行。 提出任何問題之前,Amazon S3 中的每個語料集都會載入各自的 Managed Knowledge Base:Amazon Bedrock 會自動解析內容、分塊、生成嵌入向量並建立索引。這項工作只會在堆疊部署時執行一次,不屬於每個問題的處理流程,因此圖中以虛線箭頭表示,並標示為步驟 0。之後,每個問題都會依序經過步驟 1–6:
- 用戶向託管於 Amazon Bedrock AgentCore Runtime 的 Agent 提交問題。Runtime 會透過 OpenTelemetry (OTEL) spans 自動為整個推理與行動循環加入儀表化,因此係統從第一次呼叫起便具備可觀測性。
- Agent 的推理模型會規劃並選擇要查詢的知識庫。由於每個知識庫都以獨立的檢索工具形式提供,Agent 會選取主題與問題相符的工具,例如財務或天氣,而不是搜尋混合在一起的索引。
- 所選工具呼叫會透過 MCP 由 AgentCore Gateway 轉送,並由 Agent 的 IAM 任務角色授權及以 SigV4 簽署,接着呼叫該知識庫的 AgenticRetrieveStream API,查詢 Managed Knowledge Base。
- AgenticRetrieveStream 會處理知識庫內的工作:將問題拆解為子查詢,從 Amazon Bedrock 管理的資料儲存區(由 Amazon S3 中的語料集載入)反覆檢索,並整理出有根據、附有引文的答案,再透過 Gateway 以串流方式傳回。
- Agent 會檢查傳回的上下文是否足夠。如果不足,便會再次選擇路由並檢索,然後撰寫最終答案;如果足夠,便會將附有引文的答案傳回用戶。
- 整個過程中,Runtime 會將 spans、token 數量及指標傳送至 Amazon CloudWatch 和 AWS X-Ray,填入七個可觀測性層,並提供資料給按需及持續評估評分。
整個工作流程由一個 CDK app app.py 實作,並宣告四個堆疊。你無須選擇執行順序;CDK 會根據你傳入的 construct 參照推導順序:
kb_stack = KnowledgeBasesStack(app, f"{project}-kb", env=env)

gateway_stack = AgenticGatewayStack(
    app, f"{project}-gateway", env=env,
    financial_kb=kb_stack.financial_kb,  # ← the reference creates the dependency
    weather_kb=kb_stack.weather_kb,
)

agent_stack = AgentRuntimeStack(
    app, f"{project}-agent", env=env,
    gateway=gateway_stack.gateway,
)

DashboardsStack(
    app, f"{project}-dashboards", env=env,
    financial_kb=kb_stack.financial_kb,
    weather_kb=kb_stack.weather_kb,
    gateway=gateway_stack.gateway,
    agent_runtime=agent_stack.agent_runtime,
)
以上就是全部連接設定。這四個建構函式呼叫取代了匯出/匯入管理工作及部署指令碼。
| # | 堆疊 | 建立項目 | 備註 |
| 1 | -kb | S3 儲存貯體、語料集上載、兩個 Type: MANAGED 知識庫、資料來源、IAM、資料擷取 | 知識庫進入 ACTIVE 狀態,語料集完成載入 |
| 2 | -gateway | Gateway (AWS_IAM / MCP)、各知識庫的 AgenticRetrieveStream 目標 | 不需要 Cognito |
| 3 | -agent | ECR、CodeBuild、在 Runtime 上執行且已加入儀表化功能的 Strands agent、輸出的日誌/追蹤資料、線上評估 | 約 8–10 分鐘(建立映像檔) |
| 4 | -dashboards | agentic-observability + kb-observability 儀錶板 | 尚未有流量時為空 |
Agent 會執行推理與行動循環:先思考(呼叫大型語言模型 (LLM)),再決定要呼叫哪個知識庫工具,讀取 Gateway 傳回的內容,並經常再次檢索,然後撰寫附有引文的最終答案。Runtime 會自動為每個步驟加入儀表化,因此七個可觀測性層會根據實際流量逐步填入資料。
七個層級。L1 知識庫原生指標、L2 資料擷取、L3 代理式檢索品質、L4 Gateway/MCP 指標、L5 OTEL span 樹、L6 token 用量,以及 L7 評估分數。第 1、4 和 5 層會自動產生。第 3、6 和 7 層則由 driver notebook 發佈為自訂指標。
所有可調整的設定都在同一個檔案 config.py 中:
| 設定 | 説明 | 預設值 |
EnvSettings.PROJECT_NAME |
每個堆疊和資源的名稱前綴 | bmkb-obs-cdk |
EnvSettings.ACCOUNT_REGION |
部署所在的 AWS 區域 | us-west-2(或你的設定檔所指定的區域) |
KbConfig.EMBEDDING_MODEL_TYPE |
MANAGED(隨附)或 CUSTOM(自備 ARN) |
MANAGED |
AgentConfig.MODEL_ID |
Agent 的推理模型、Layer 6 的支出 | Claude Haiku 4.5 |
EvalConfig.SAMPLING_PERCENTAGE |
線上評估抽樣率,請參閲免責聲明 | 100 |
更改 PROJECT_NAME 會建立一個使用獨立名稱的完整方案副本,因此兩個部署可以在同一個帳戶中共存。驅動 Notebook 會讀取同一個常數,因此會自動配合名稱變更,無須手動同步堆疊名稱。
描述數據集
方案隨附兩個小型語料庫,存放在存放庫的 data/ 之下:
- 財務 — 合成的 Octank Financial 10-K(octank_financial_10K.pdf,約 198 KB)。
- 天氣 — 一份真實、公開提供的美國國會研究處龍捲風報告(IF12695,tornadoes_report.pdf,約 560 KB)。
 關於數據: 財務語料庫是合成的。Octank 是一間虛構公司,而 10-K 是由模型生成的樣本數據(採用 CC0 授權)。它並非 真實財務數據。天氣語料庫是真實的美國政府公有領域作品,內容是一份國會研究處報告,可在 sgp.fas.org/crs/misc/IF12695.pdf 公開取得(美國政府作品不受版權保護)。如要使用自己的數據,只需將檔案放在 data/ 之下,並調整
config.py 中的前綴,無須作其他更改。
這兩個語料庫刻意採用不同領域,讓 Agent 必須將每個問題路由至正確的知識庫,呈現語義路由的重點。由於這些是 Managed Knowledge Bases,我們不需要設定分塊、嵌入或索引:匯入時,Amazon Bedrock 會自動剖析每份 PDF、將內容分塊、使用其受管理模型建立嵌入向量,並建立索引。
我們使用兩個獨立的知識庫,並透過 Gateway 將各自作為一個檢索工具提供,而非使用一個同時存放兩個語料庫的知識庫;這是刻意的選擇。為 Agent 提供兩個具名工具,令路由成為一個可觀察的明確推理過程:span tree 會顯示它針對特定問題選擇了哪個工具,而第 3 層的檢索質素指標會按知識庫分開,因此財務和天氣領域的精確率不會混成單一數字。若用一個工具涵蓋兩個語料庫,兩者的區別便會消失;路由決策會隱藏在單一索引的排名過程中,而所有質素指標都會變成兩個無關領域的平均值。將語料庫和工具分開,才能清楚瞭解 Agent 的行為;這正是這項練習的目的。
在 CDK 中,將語料庫放入 S3 的方式是使用 BucketDeployment:
s3deploy.BucketDeployment(
    self, "FinancialCorpus",
    sources=[s3deploy.Source.asset(str(ROOT / "data" / "financial"))],
    destination_bucket=self.source_bucket,
    destination_key_prefix=KbConfig.FINANCIAL_PREFIX,
)
BucketDeployment 值得了解,正是因為另一種做法看起來很方便:若不使用它,負責觸發資料匯入的自訂資源往往會加入上傳步驟,結果同一個資源便要負責兩項互不相關的工作。在這裏,它只需負責匯入。
受管理的資料匯入會自動掃描、分塊、建立嵌入向量,並為每份文件建立索引:每個知識庫各有一份文件完成索引,失敗數為零。
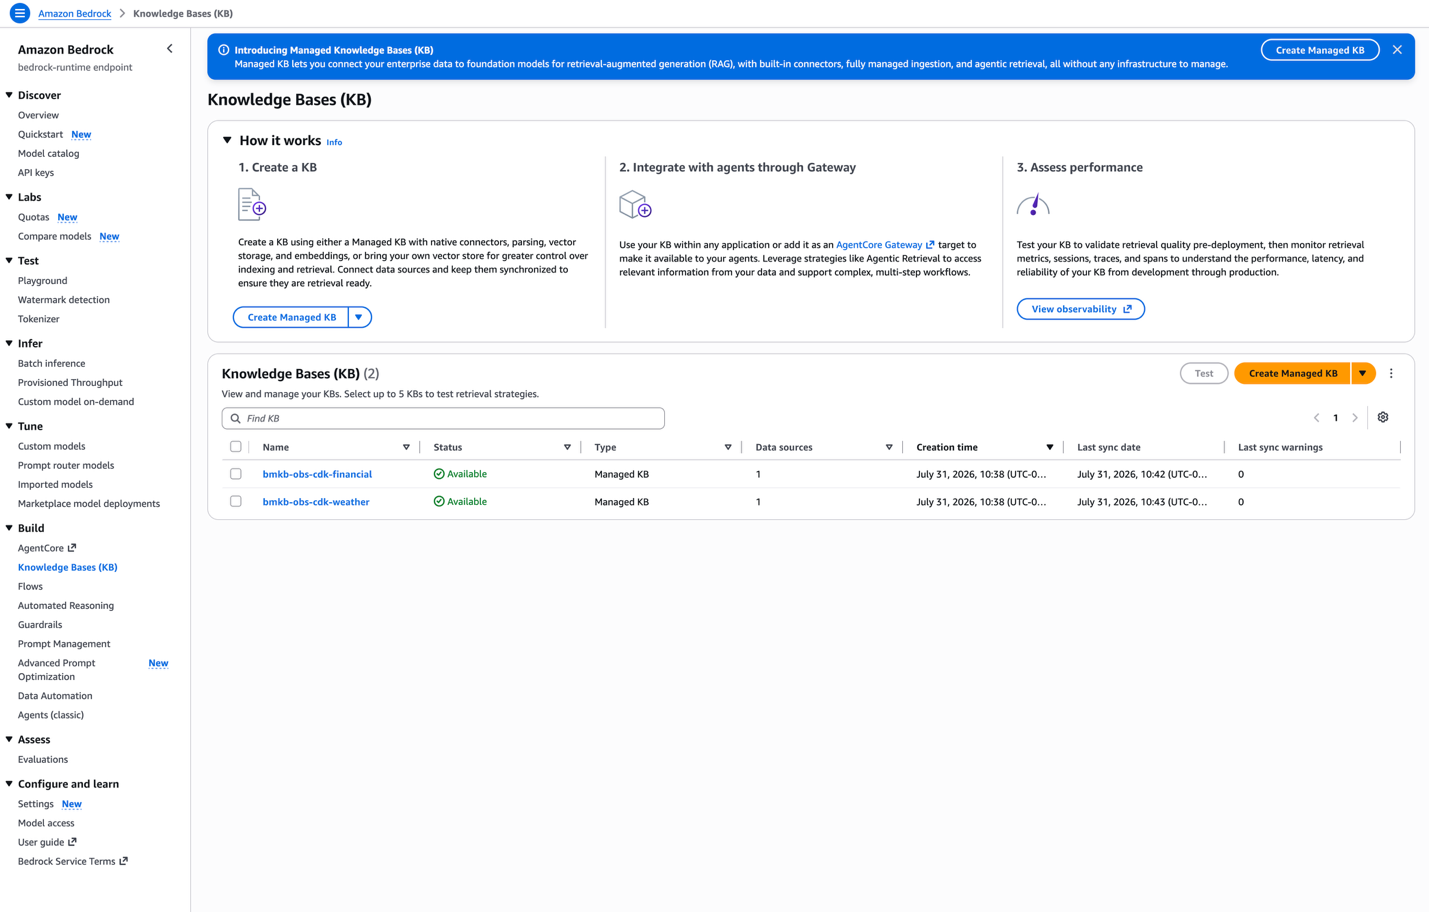
圖 3:受管理的資料匯入結果;每個知識庫各有一份文件完成索引,失敗數為零
部署方案
本節將介紹如何用一個命令部署整個方案。完成先決條件後,cdk deploy --all 會依照 CDK 推導出的相依順序佈建全部四個堆疊,並自動傳遞所有跨堆疊值。
先決條件
- 具備 Amazon Bedrock、AgentCore (Runtime + Gateway)、AWS Identity and Access Management (IAM)、CloudWatch、AWS X-Ray、Amazon Elastic Container Registry (Amazon ECR)、AWS CodeBuild、Amazon S3、AWS Lambda 及 AWS CloudFormation 權限的 AWS 帳戶。
- 帳戶中有代理程式所用的模型(預設
us.anthropic.claude-haiku-4-5-20251001-v1:0)。 - 已啟用 CloudWatch Transaction Search,讓 OTEL spans 寫入 aws/spans,供第 5 至 7 層使用。
- Node.js 18+ 和 CDK CLI(
npm install -g aws-cdk),以及 Python 3.13+。 - 已為 CDK 完成 bootstrap 的帳戶和區域(cdk bootstrap),每個帳戶/區域只需執行一次。
- 本機不需要 Docker;代理程式映像檔會由 CodeBuild 建置(ARM64)。
一個命令
要部署此方案,請複製存放庫、建立虛擬環境、安裝相依套件,然後執行 cdk deploy --all。請在終端機中執行以下命令:
git clone https://github.com/aws-samples/amazon-bedrock-samples.git
cd rag/managed-knowledge-bases/07-IaaC/managed-kb-observability-cdk/
python3 -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cdk bootstrap  # once per account/region
cdk deploy --all
首兩個命令會複製範例並進入專案目錄。接下來兩個命令會建立並啟用 Python 虛擬環境,以及安裝 CDK 應用程式的相依套件。cdk bootstrap 會為 CDK 準備帳戶和區域(每個帳戶/區域只需執行一次),而 cdk deploy --all 會部署全部四個堆疊。
帳戶和區域取自你的 AWS 設定檔(CDK_DEFAULT_ACCOUNT / CDK_DEFAULT_REGION),因此無須修改任何內容即可部署應用程式。
區域可用性:受管知識庫、代理式擷取(AgenticRetrieveStream)及 Amazon Bedrock AgentCore(Runtime 和 Gateway)並非在所有 AWS 區域均可使用。部署前,請確認目標區域提供以上所有服務,並相應設定 ACCOUNT_REGION(位於 config.py)。預設值為 us-west-2。如需查閲最新的可用性資訊,請參閲 Amazon Bedrock 和 Amazon Bedrock AgentCore 文件,以及 AWS 區域服務清單。
此版本沒有部署指令碼,這正是設計用意:cdk deploy --all 會巡覽它從 app.py 推導出的相依性圖,依序部署四個堆疊,並自動傳遞所有跨堆疊值。終端機會在每個堆疊完成時顯示其狀態:bmkb-obs-cdk-kb [1/4](預設 PROJECT_NAME),接著是 gateway [2/4]、agent [3/4],最後是 dashboards [4/4]。這個順序是推導而來,並非預先指定:它由堆疊之間的建構項目參照關係自然形成,因此新增一個使用現有輸出的第五個堆疊時,部署順序便會自動重新排列。
Stack -agent 會使用 CodeBuild 建置代理程式容器,因此此階段大約需要 8–10 分鐘。其餘三個堆疊所需時間較短。每個堆疊完成時都會顯示輸出,你可在此取得知識庫 ID、Gateway URL、執行階段 ARN,以及兩個儀錶板 URL。部署完成後,四個堆疊都已部署完成。以下螢幕截圖顯示成功執行 cdk deploy --all 後的 AWS CloudFormation 主控台。
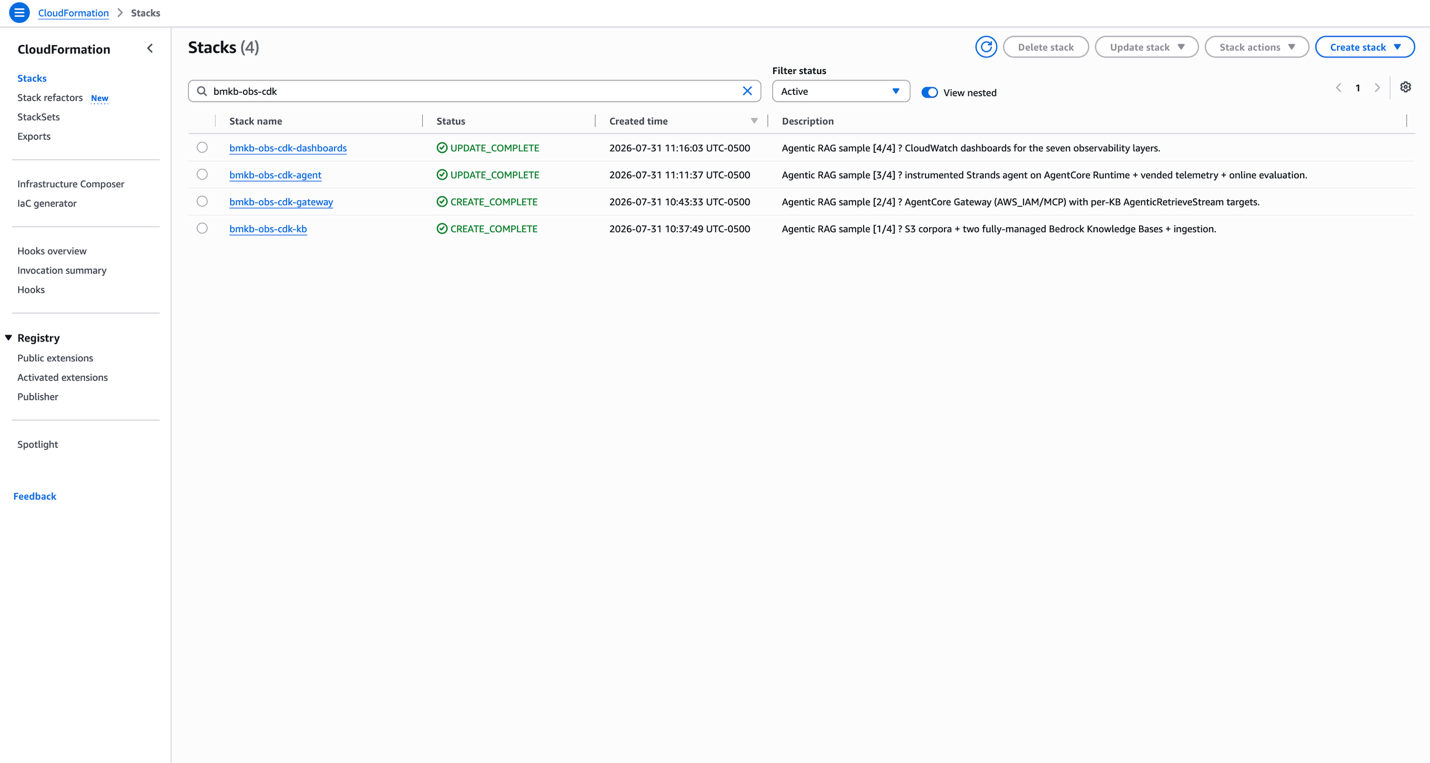
圖 4:成功部署後的 AWS CloudFormation 主控台,四個堆疊的狀態均為 CREATE_COMPLETE
在主控台中,kb、gateway、agent 和 dashboards 這四個堆疊的狀態均為 CREATE_COMPLETE。每個堆疊的描述都顯示其在推導出的相依性順序中的位置 [n/4]。
關於長時間執行資源的説明
此方案中有兩項工作所需時間遠超過 AWS Lambda 函數 15 分鐘的執行上限,無法透過簡單輪詢來處理:知識庫擷取同步,以及 CodeBuild 映像檔建置。AWS CDK Provider 架構會以 on_event / is_complete 的方式處理這些工作:一個處理常式會啟動工作,另一個則會持續接受輪詢,直至回報工作完成。
cr.Provider(
    self, "IngestSyncProvider",
    on_event_handler=on_event,        # StartIngestionJob, return the job id
    is_complete_handler=is_complete,  # GetIngestionJob, report IsComplete
    query_interval=Duration.seconds(30),
    total_timeout=Duration.minutes(30),
)
沒有任何操作會阻塞執行;回傳至 CloudFormation 的回應協定由框架負責處理,而不必在每個處理常式中手動編寫;30 分鐘的時間預算則是個屬性,不需要另行設計方案去繞過。
啟動及測試
開啟 notebooks/01-drive-and-observe.ipynb,並由上而下執行(先執行 pip install -r requirements-notebook.txt)。它會讀取堆疊輸出,然後向已部署的 Agent 傳送針對不同主題的提示詞,每個 KB 使用一個工作階段,讓你在同一處查看回答和語意路由:財務問題會根據 Octank 10-K 作答,天氣問題則根據龍捲風報告作答;兩者都會自動路由至相應的 AgenticRetrieveStream 工具。
Notebook 會從堆疊輸出中找出所有所需資料,因此不必手動貼上任何內容:
# Stack names are derived from the same PROJECT_NAME the CDK app uses, so renaming the
# project in config.py cannot leave this notebook pointing at stale stacks.
from config import EnvSettings

PROJECT = EnvSettings.PROJECT_NAME
STACKS = {suffix: f'{PROJECT}-{suffix}'
          for suffix in ('kb', 'gateway', 'agent', 'dashboards')}

def outputs(stack_name):
    s = cfn.describe_stacks(StackName=stack_name)['Stacks'][0]
    return {o['OutputKey']: o['OutputValue'] for o in s.get('Outputs', [])}
Notebook 匯入的 config.py 與應用程式所用的相同,因此兩者對堆疊名稱的理解不會有分歧。
驅動程式會透過已部署的 Agent 傳送針對各個 KB 的提示詞。財務問題會路由至財務 KB,天氣問題則會路由至天氣 KB;兩者都會提供有根據並附有引用的回答。
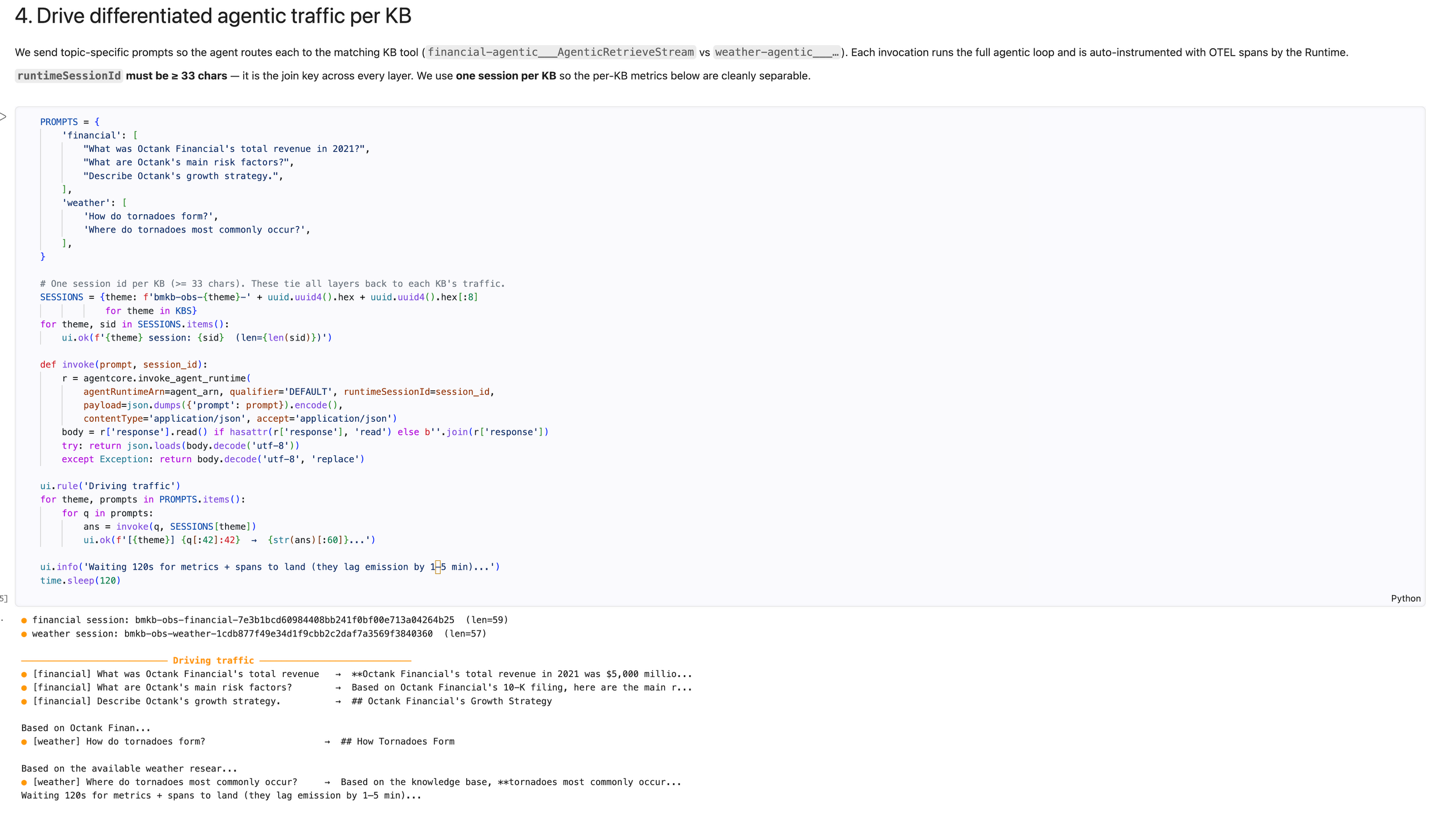
圖 5:針對各個 KB 的提示詞會路由至相應的知識庫,並各自提供有根據、附有引用的回答
Notebook 亦會根據 Agent 實際檢索及引用的內容,計算無參照的第 3 層檢索品質指標;不需要 ground truth 或額外評審模型,並會將指標發佈至 CloudWatch。
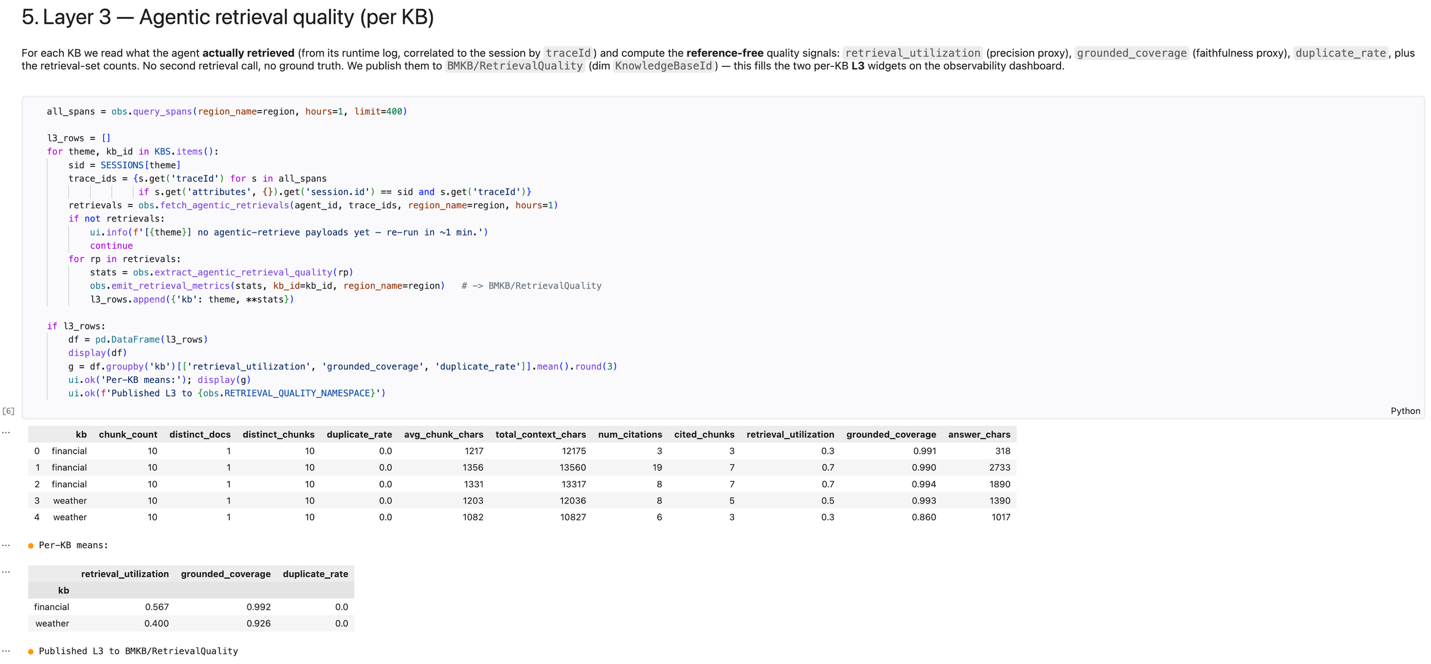
圖 6:各個知識庫的無參照第 3 層檢索品質指標
觀察:七層儀錶板
七層的資訊會在兩個儀錶板上呈現。堆疊會建立這兩個儀錶板,而送入流量後便會填入數據。以下截圖展示兩個儀錶板在 CloudWatch 主控台中的畫面。
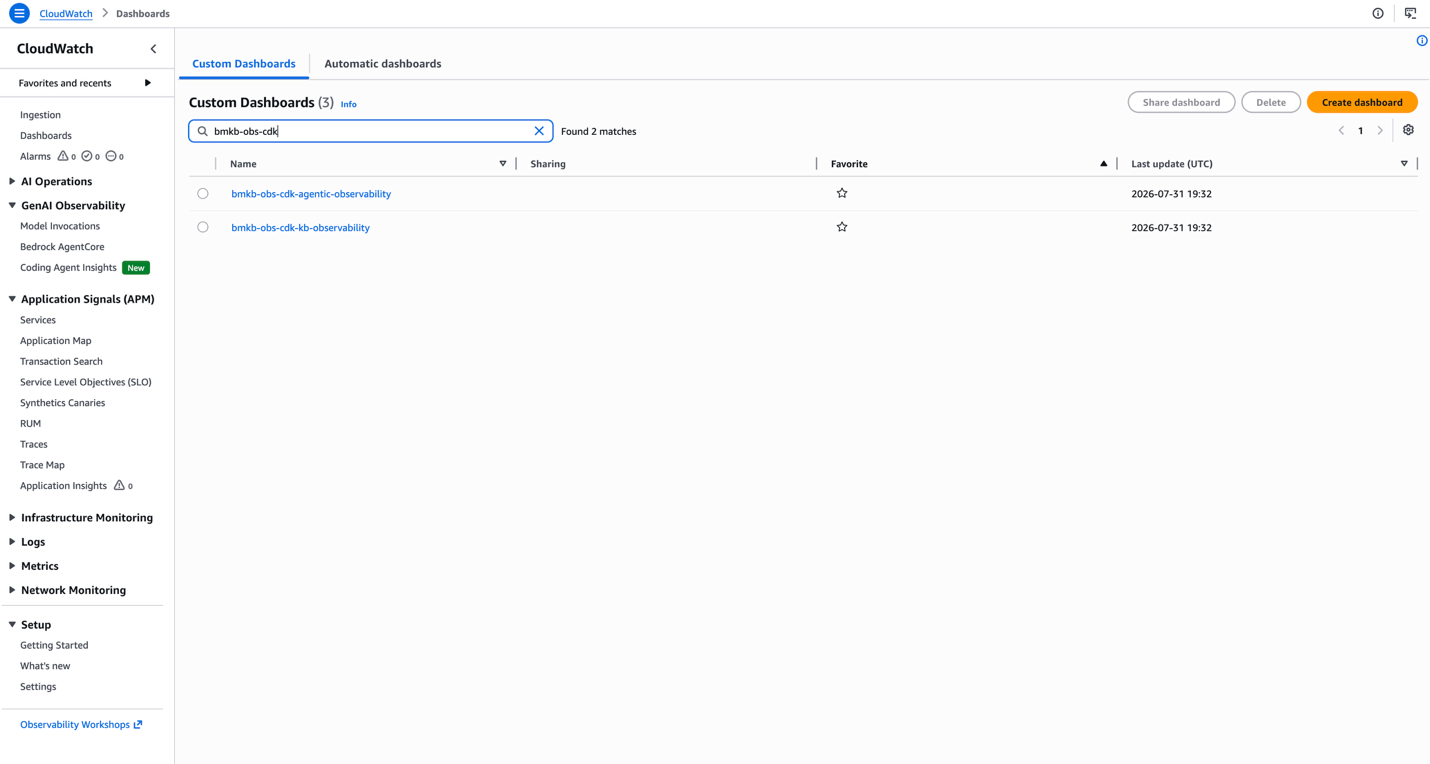
圖 7:CloudWatch 主控台中的兩個儀錶板,分別用於端對端 Agent 可觀測性及每個 KB 的可觀測性
兩個儀錶板都會顯示在 CloudWatch 主控台中:一個用於端對端 Agent 可觀測性,另一個用於每個 KB 的可觀測性(BMKB,Bedrock Managed Knowledge Base)。本節其餘部分會逐一説明各層所顯示的內容。
這個版本的儀錶板以具型別的物件建構,而非 JSON 字串。指標是 Metric,元件是 GraphWidget,而版面配置則是 Rows 清單:
cw.GraphWidget(
    title="L4 — Gateway metrics (MCP)",
    width=12, height=6, period=PERIOD, statistic="Sum",
    left=[
        self._gateway_metric("Invocations", gateway_arn, "tools/call Invocations"),
        self._gateway_metric("SystemErrors", gateway_arn, "SystemErrors"),
        self._gateway_metric("UserErrors", gateway_arn, "UserErrors"),
        self._gateway_metric("Throttles", gateway_arn, "Throttles"),
    ],
)實際好處不在於減少行數;dashboards_stack.py 長達 400 行,比功能相同的 DashboardBody JSON 還要長。好處在於,拼錯屬性名稱或使用無效的元件組合,會在 cdk synth(你的手提電腦上)約一秒內報錯。同樣的錯誤若寫在 DashboardBody 字串中,部署仍會成功,並在 AWS Management Console 顯示為故障元件;你只能查看畫面才會發現。
由於 Row 接受任何元件,文件説明便成為版面配置的一部分,而非會逐漸過時的 wiki 頁面。每個儀錶板都會在圖表之間穿插 TextWidgets:
[cw.TextWidget(width=24, height=7, markdown=self._l3_explainer())],
[
    self._quality_widget("L3 · Financial KB — agentic quality (reference-free, 0–1)", fin_id),
    self._quality_widget("L3 · Weather KB — agentic quality (reference-free, 0–1)", wx_id),
],
_l3_explainer() 會傳回一個 Markdown 表格,定義各項比率及其解讀方式。因此,説明 grounded_coverage 的元件會與繪製該指標的元件在同一次提交中一併交付;初次開啟儀錶板的讀者也不必猜測無參照指標代表甚麼。
儀錶板 A — 端到端代理式可觀測性。儀錶板首先説明各層的統計項目各不相同(對於 N 次查詢,你會看到約 N 次代理呼叫、約 2N 次檢索、約 3N 次 LLM 呼叫,以及約 5N 次 Gateway MCP 操作,讓代理式循環清晰可見),接着顯示知識庫指標(L1)、Gateway 指標及延遲(L4)、token 用量(L6);此外,由於代理使用 AgenticRetrieveStream,傳回的是經綜合整理並附有引文的答案,而非逐區塊評分,因此也會顯示內嵌定義、並按知識庫繪製的第 3 層無參照品質指標。
在儀錶板 A 上,第 3 層的無參照品質指標按知識庫分別繪製。首先是財務知識庫。以下圖表繪出其 retrieval_utilization、grounded_coverage 和 duplicate_rate。
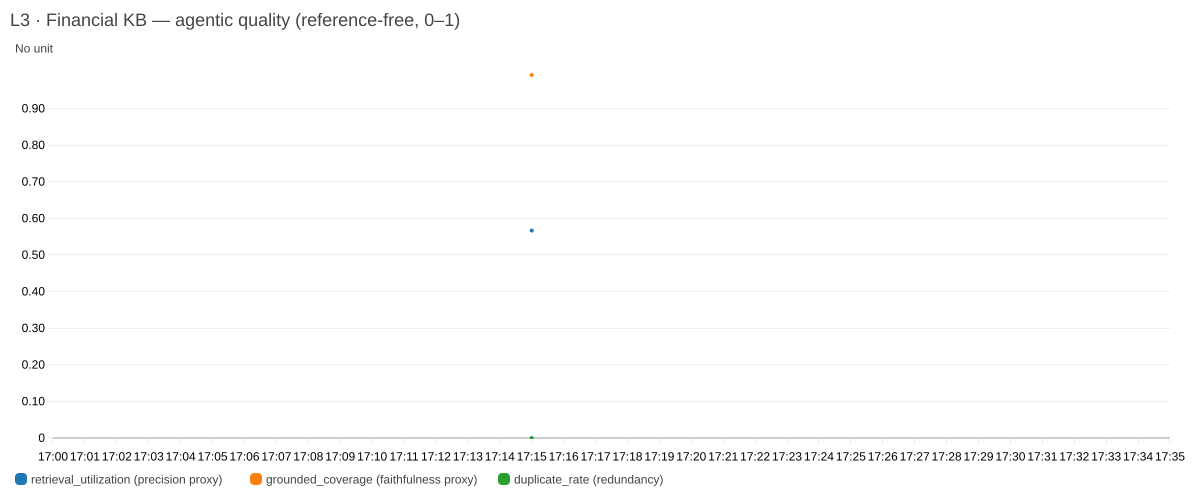
圖 8:財務知識庫第 3 層品質,繪出檢索利用率、有依據涵蓋率及重複率
天氣知識庫顯示相同的三項指標,並分開追蹤,確保兩個領域不會混為一個數字。
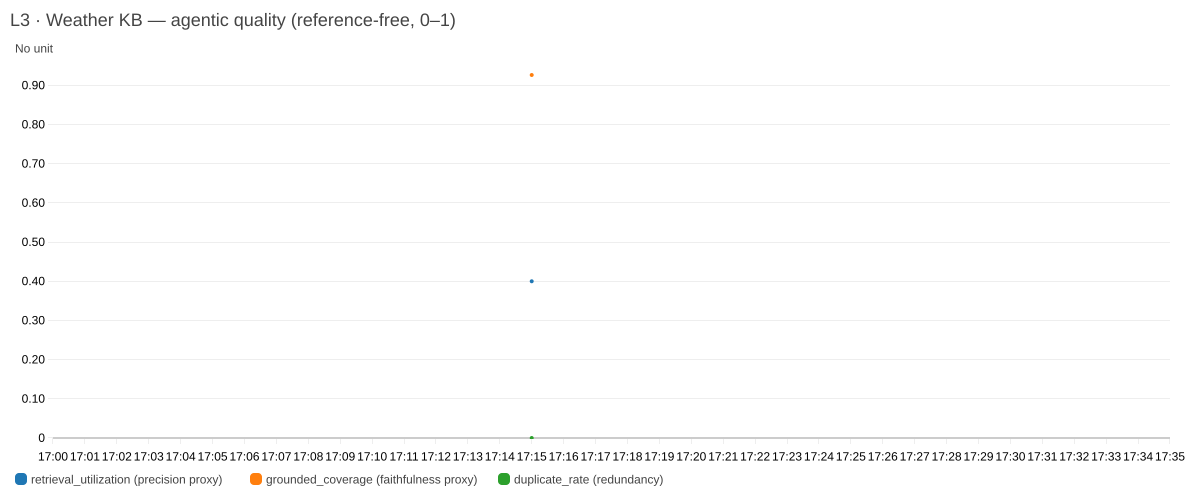
圖 9:天氣知識庫第 3 層品質,與財務知識庫分開追蹤
兩張圖表分別繪出財務知識庫(左)和天氣知識庫(右)的檢索利用率、有依據涵蓋率及重複率,讓每個知識庫的檢索品質各自呈現,而不是平均成一個數字。
儀錶板 B — 按知識庫劃分(BMKB)的可觀測性。以下營運指標同時也決定開支,並按知識庫列出:索引大小(根據 S3 來源位元組數計算)、檢索量、代理式工具呼叫次數、工作階段 token 用量,以及按模型劃分的生成 token 用量;每項指標均附有內嵌説明。
以下截圖展示儀錶板 B 的四個指標元件,這些元件在執行完成後已填入數據。第一個元件顯示各知識庫的索引大小,根據 S3 來源位元組數計算。
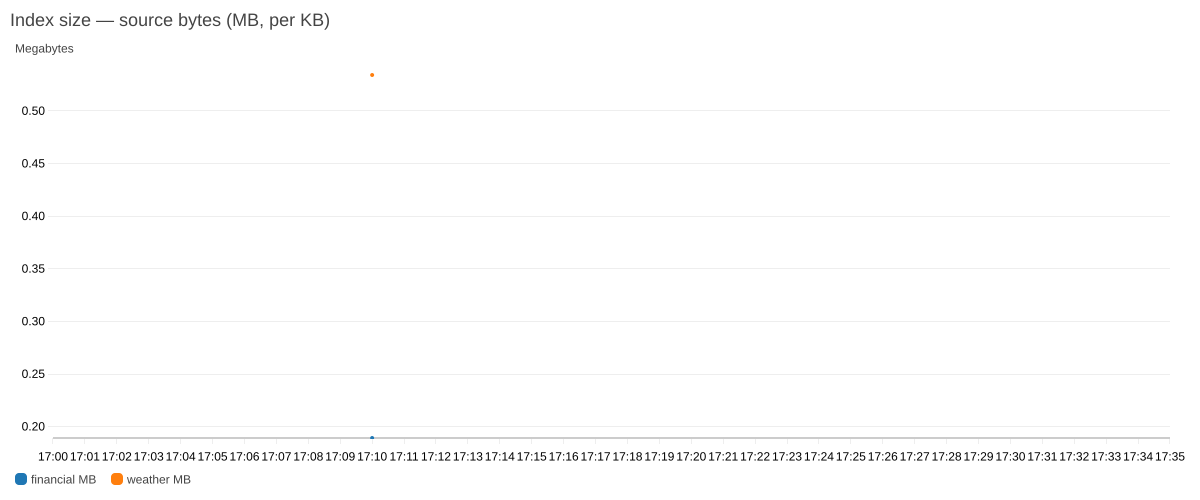
圖 10:儀錶板 B 各知識庫的索引大小,根據 Amazon S3 來源位元組數計算
第二個元件統計各知識庫的檢索呼叫次數。
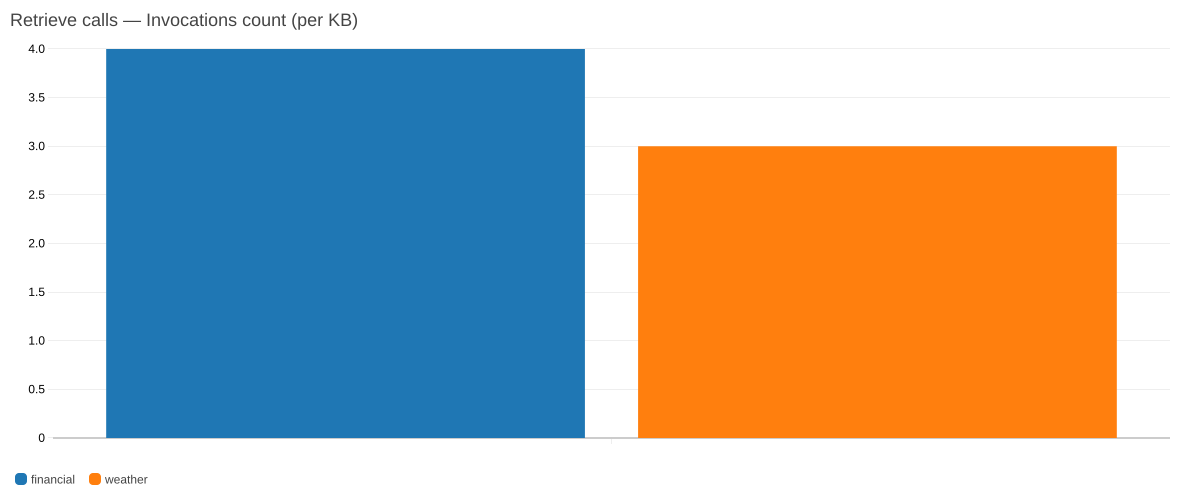
圖 11:儀錶板 B 各知識庫的檢索呼叫次數
第三個元件統計經 Gateway 發出的代理式工具呼叫次數。這項指標由兩個知識庫共用,並非分開列示。
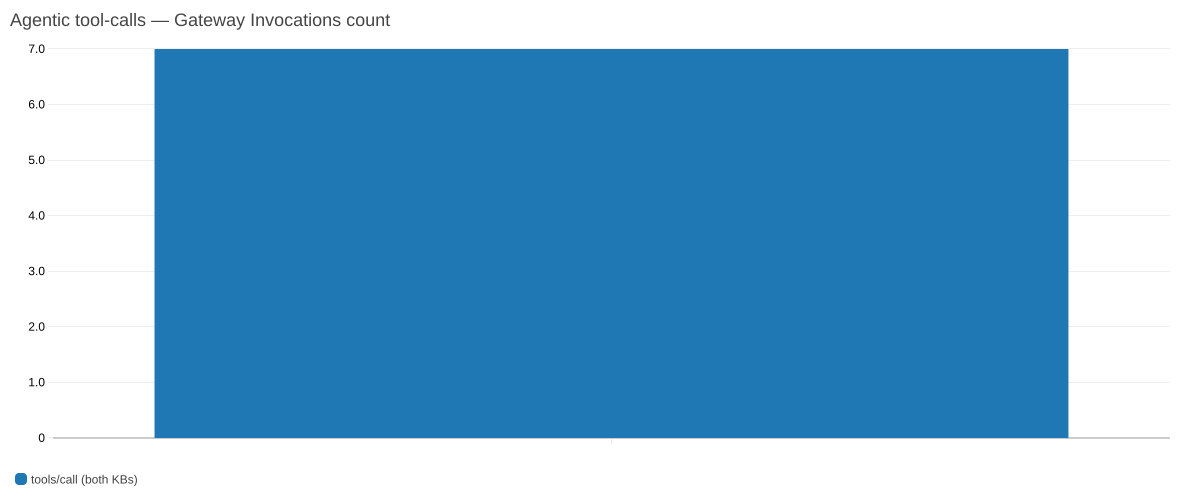
圖 12:經 AgentCore Gateway 發出的代理式工具呼叫次數,由兩個知識庫共用
第四個元件顯示各知識庫的工作階段 token 用量。
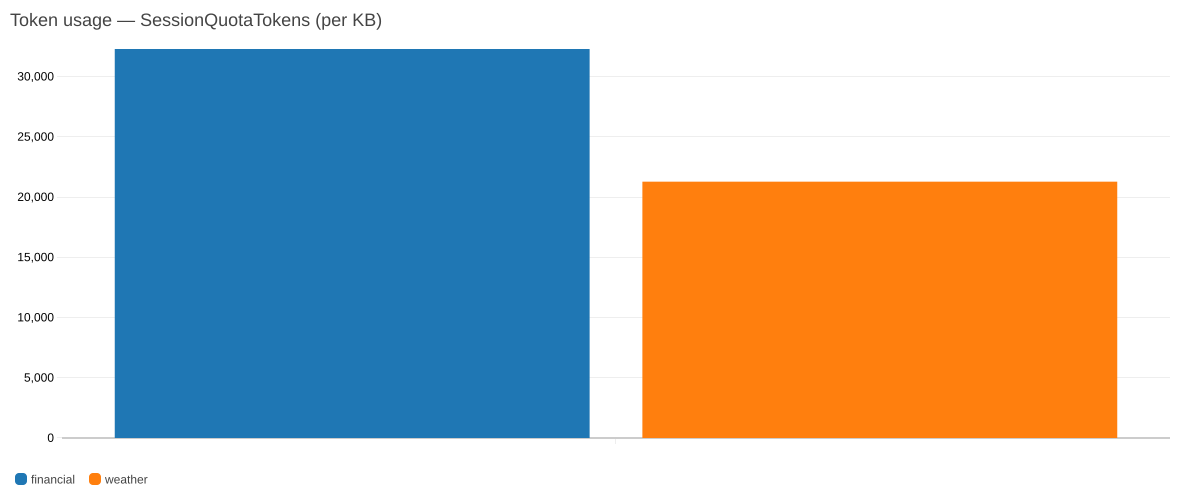
圖 13:儀錶板 B 各知識庫的工作階段 token 用量
四個元件分別顯示索引大小(根據 S3 來源位元組數計算)、檢索呼叫量、經 Gateway 發出的代理式工具呼叫次數,以及工作階段 token 用量。除了由兩個知識庫共用的 Gateway 工具呼叫次數外,其餘指標均按知識庫分開列出。
有一項維度細節值得指出,因為具型別的 API 不會替你檢查這一點:AWS/Bedrock/KnowledgeBases 命名空間要求使用帶前綴的 ID knowledge-base/<id>,而方案本身的 BMKB/* 命名空間則使用不帶前綴的 ID。對 CDK 而言,兩者都只是一串字串。
# L1 — AWS/Bedrock/KnowledgeBases wants the prefixed form.
dimensions_map={"Operation": "Retrieve", "KnowledgeBaseId": f"knowledge-base/{kb_id}"}

# BMKB/* — our own namespaces use the bare id.
dimensions_map={"KnowledgeBaseId": kb_id}
第 5 層:span 樹
第 5 層是 aws/spans 中的原始 OTEL span 樹,也是直接呈現代理式循環的層。值得仔細閲讀,因為其巢狀結構並不明顯:一次 LLM 呼叫會產生三個 span。Strands invoke_agent span 包住整個回合,內部的 chat span 包住模型呼叫,而 chat <model> span 的類型為 CLIENT,代表實際呼叫;三者都會重複相同的 gen_ai.usage.* token 屬性。
以下截圖展示 aws/spans 中的 span 樹,頂部幾行可見三個 span 的巢狀結構。
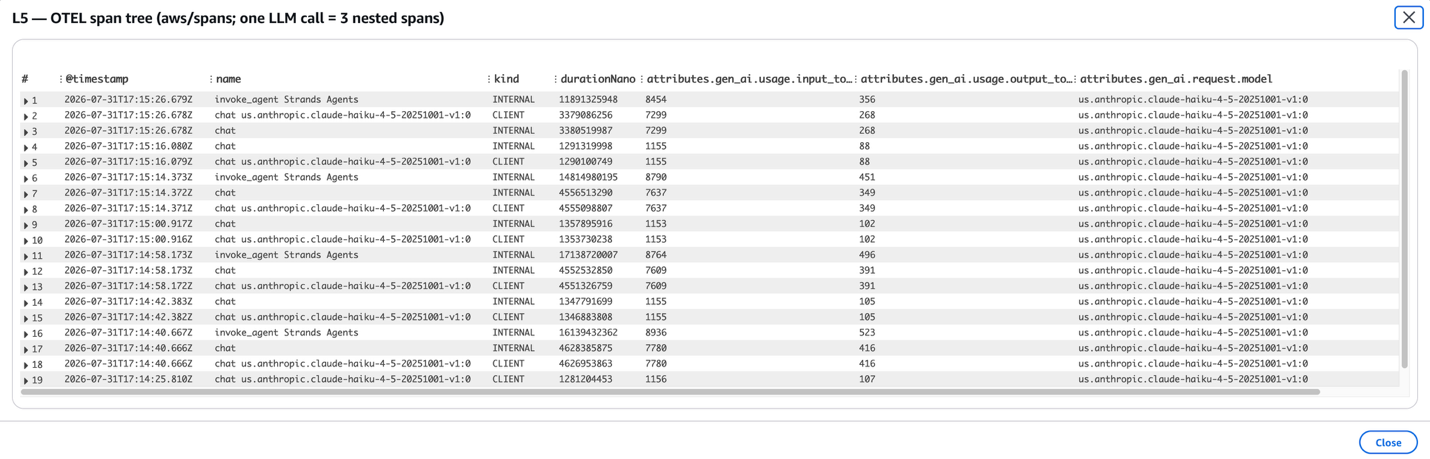
圖 14:aws/spans 中的第 5 層 span 樹,展示單次 LLM 呼叫的三個 span 巢狀結構
頂部三列依次是:invoke_agent Strands Agents 聚合項目、內部聊天 span,以及 CLIENT 聊天 span;三者報告的輸入 token 均為 7,299,輸出 token 均為 268。這是同一個 LLM 呼叫在樹狀結構的三個層級中出現,因此聚合時需要小心。
要進行聚合時,這種結構便十分重要。若要每個 LLM 呼叫只計算一次,請篩選至 CLIENT 葉節點:
fields attributes.gen_ai.request.model as model,
       attributes.gen_ai.usage.input_tokens as in_tok,
       attributes.gen_ai.usage.output_tokens as out_tok
| filter ispresent(in_tok) and kind = 'CLIENT' and name like /^chat /
| stats sum(in_tok) as input_tokens, sum(out_tok) as output_tokens,
        count(*) as llm_calls by model
若不套用這個篩選條件,同一查詢報告的 token 數和呼叫次數都會是三倍。
套用這項 CLIENT 葉節點篩選條件後,下方截圖顯示按模型劃分的生成 token 用量,每個 LLM 呼叫只計算一次。
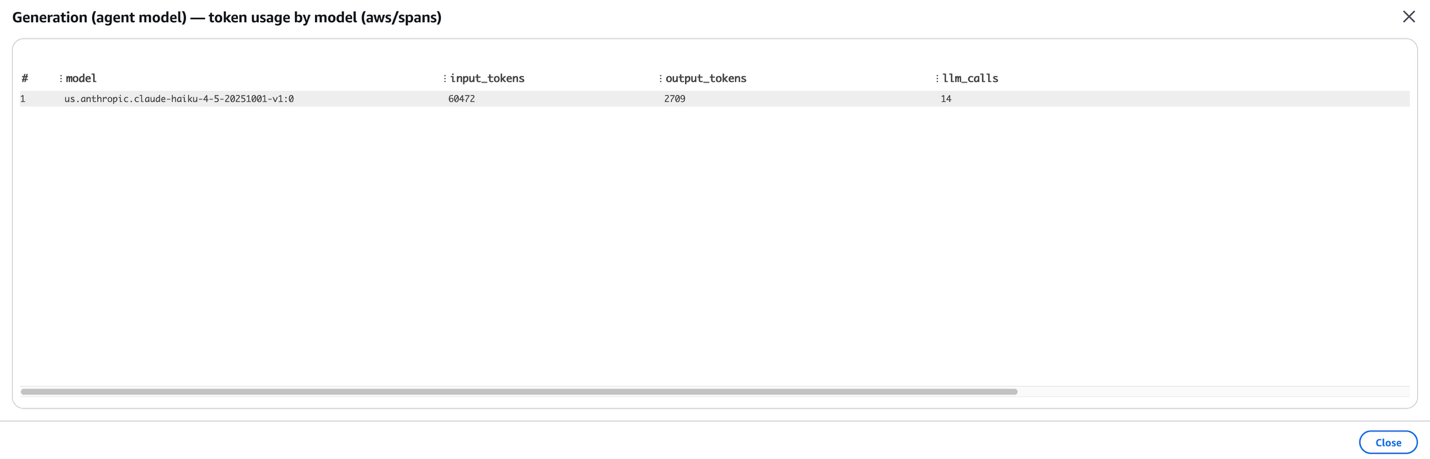
圖 15:按模型劃分的生成 token 用量,每個 LLM 呼叫只計算一次
套用篩選條件後,這次執行顯示 14 次 LLM 呼叫,總計 60,472 個輸入 token 和 2,709 個輸出 token。若不套用,同一查詢報告的呼叫次數和 token 數都會是三倍。
評估:隨需及持續
品質以兩種方式衡量,兩者均由應用程式佈建。
隨需:驅動程式筆記本會呼叫 AgentCore。這個版本沒有部署指令碼,這正是重點: (LLM-as-judge) 會針對每個工作階段的 spans 執行內置評估器 Correctness、Faithfulness 和 Tool-Selection Accuracy,並將評分發佈至 CloudWatch,評分會在 Dashboard A 上顯示為 Layer 7。
以下截圖顯示 Dashboard A 的 Layer 7:按知識庫劃分的隨需評估評分,並在同一儀錶板上顯示 Layer 5 OTEL span 資料表。
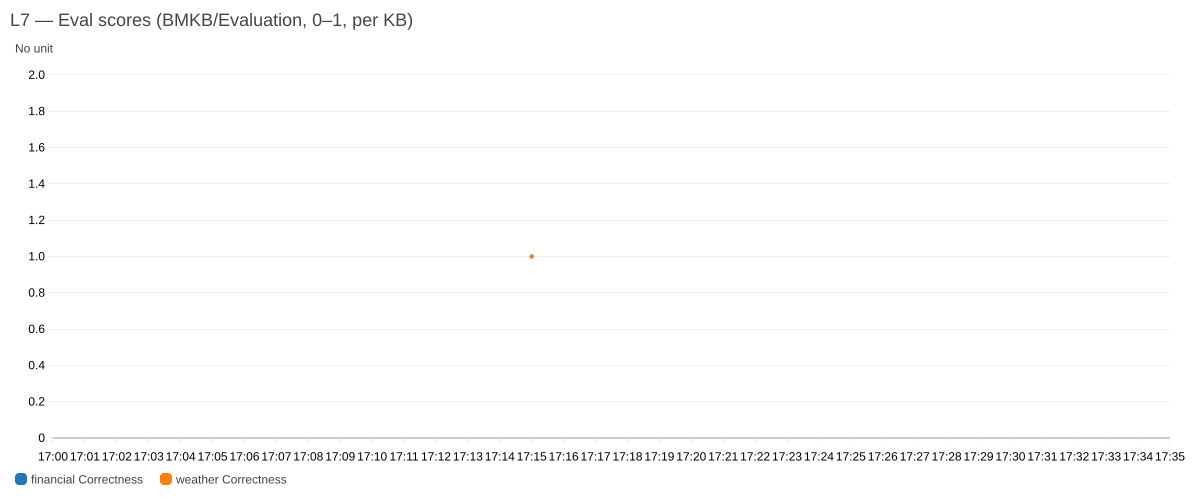
圖 16:Layer 7 按知識庫劃分的隨需評估評分,旁邊是 Layer 5 span 資料表
Layer 7 顯示按知識庫劃分的隨需評估評分,旁邊是 Layer 5 OTEL span 資料表,讓評分與產生評分的 spans 可在同一個儀錶板上對照查看。
持續(線上): 代理程式堆疊亦會佈建 AWS::BedrockAgentCore::OnlineEvaluationConfig,用於抽樣即時工作階段並自動評分,無須執行筆記本。設定本身可在 Bedrock AgentCore 主控台的「評估」→「評估」→「評估設定」 中查看。結果會寫入日誌羣組 /aws/bedrock-agentcore/evaluations/results/<config-id>,每個評分亦會以 CloudWatch 指標形式發佈至 Bedrock-AgentCore/Evaluations 命名空間,並以評估器名稱和設定 ID 為鍵,因此無須剖析日誌,也可將評分製成圖表或設定警報。
以下截圖顯示 AgentCore 主控台中的線上評估設定,路徑為「評估」→「評估」→「評估設定」。
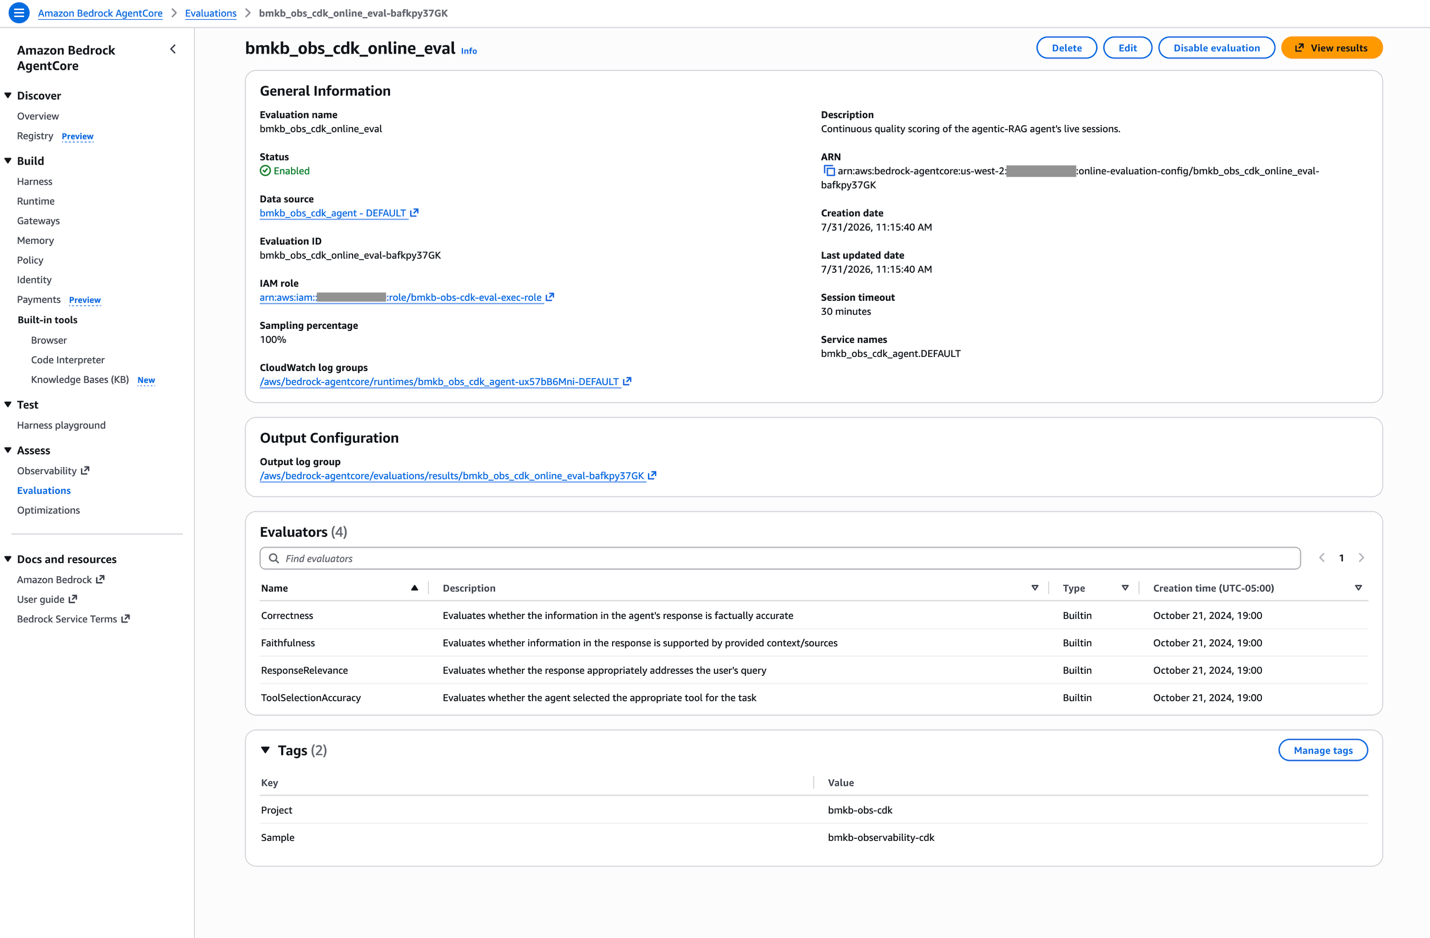
圖 17:AgentCore 主控台中的線上評估設定,包含四個內置評估器,取樣率為 100%
設定列出四個內置評估器:Tool-Selection Accuracy、Faithfulness、Correctness 和 Response Relevance;取樣率設為 100%,並顯示為 ACTIVE 及已啟用。
由於評分是一般 CloudWatch 指標,因此可像其他指標一樣繪製圖表,無須剖析日誌;同一個小工具亦可設定警報。以下截圖顯示這四個評估器的評分以一般 CloudWatch 指標形式繪製成圖表。
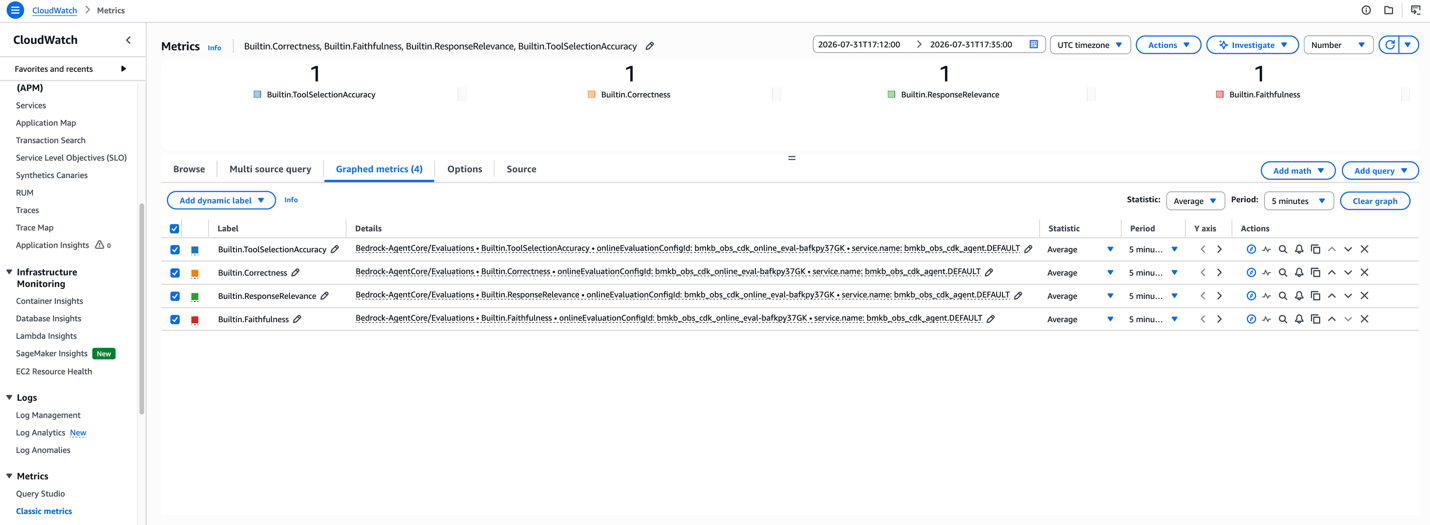
圖 18:四個持續評估器的評分以一般 CloudWatch 指標形式繪製成圖表
四個評估器的評分會以指標形式顯示在 Bedrock-AgentCore/Evaluations 命名空間中,每項指標均以評估設定 ID 和代理程式的服務名稱為鍵,因此無須剖析日誌,也可將它們製成圖表或設定警報。
線上評估結果只會在工作階段結束後出現。評分會在工作階段完成後執行,因此發送流量後,結果日誌羣組會在約一個工作階段閒置逾時(~30 分鐘)內保持空白。執行後羣組即時空白是預期情況,並非設定錯誤。每個結果事件都包含 session.id,因此可與其他所有層的資料關聯。筆記本中的按需評估流程無需等待,這就是兩種方式都列在這裏的原因。
在這次執行中,四個內置評估器的持續評估流程在正確性、忠實度、回應相關性及工具選擇準確度上均取得 1.00;每個評估器評分五筆追蹤記錄,每項結果均附有文字説明。
抽樣與成本。這個應用程式將 SAMPLING_PERCENTAGE = 100 設為 純粹用於這次網誌實驗,因此每個工作階段都會評分,結果亦會即時顯示。這並非生產環境的建議設定。線上評估會為每個抽樣工作階段調用 LLM-as-judge,因此成本會隨抽樣率及流量增加。正式部署時,請選擇符合品質監察需求及預算的抽樣百分比,並在啟用前確保設定符合機構本身的政策及成本管治要求。抽樣率由單一常數 EvalConfig.SAMPLING_PERCENTAGE 設定,位於 config.py。
清理
完成後,請移除方案以停止產生費用,因為即使堆疊閒置,已儲存的 KB 資料、ECR 中的 Agent 映像,以及仍在運作的線上評估都會產生費用。只需一個命令即可全部移除:
cdk destroy --allCDK 會自行按相反的相依次序刪除堆疊:先是 dashboards,然後是 agent、gateway,最後是 kb。這就是它為部署推導出的相同依賴圖,只是反向執行。無需維護一份必須與部署指令碼保持一致的拆除指令碼;只建模一次相依關係,是其中一項較不顯眼但相當有價值的特點。
有兩項移除行為值得留意,因為兩者都取代了手寫的清理程式碼:
self.source_bucket = s3.Bucket(
    self, "SourceBucket",
    removal_policy=RemovalPolicy.DESTROY,
    auto_delete_objects=True,  # replaces a list_object_versions delete loop
)

self.repository = ecr.Repository(
    self, "AgentImageRepo",
    removal_policy=RemovalPolicy.DESTROY,
    empty_on_delete=True,  # replaces an image-delete loop
)
兩者均已設定為方便範例清理;如有任何需要保留的資料,請將儲存貯體設定為 RemovalPolicy.RETAIN。
CDK bootstrap 堆疊(CDKToolkit)及其暫存儲存貯體不會被移除。它們是整個帳戶共用的基礎設施,其他 CDK 應用程式可能會依賴它們。
與單次方案相比,有哪些改變
本文與2024 年方案都是以 Python 編寫的 CDK 應用程式,並使用 cdk deploy 部署。編寫工具始終如一,改變的是底層架構,而大部分改動都是刪減:
| 考量項目 | 2024:單次 RAG | 本方案 |
| 向量儲存區 | 需要自行佈建及擴展 OpenSearch Serverless 集合和索引,並按 OCU 付費 | 無。類型:MANAGED,儲存及索引由 Amazon Bedrock 管理 |
| 索引生命週期 | 自訂資源會建立索引,並等待索引可供搜尋 | 無需建立任何項目 |
| 嵌入模型 | 由你選擇並授予模型存取權限 | 預設由服務管理 |
| 堆疊 | 3:KB 角色 → OpenSearch 基礎設施 → KB + 資料來源 | 4:kb → gateway → agent → dashboards |
| 檢索 | 一次 Retrieve,按向量相似度擷取 top-k 個區塊 | AgenticRetrieveStream 會在內部重新排序,並傳回整合且附有引用來源的答案 |
| 選擇知識庫 | 不適用,只有一個索引 | Agent 會根據語義在兩個知識庫之間進行路由 |
| 再次檢視語料庫 | 單次流程中無法做到 | Agent 會在回答前再次進行檢索 |
| 遙測 | 沒有佈建任何項目 | 七層、兩個儀錶板 |
| 評估 | 手動:同步、選擇模型、提出問題 | 按需及持續評估,兩者均已佈建 |
| 閒置時的最低成本 | 無論是否發出查詢,OCU 費用都會持續累積 | 僅收取儲存費用 |
這種取捨確實有兩面。單一索引回答單次問題,每次查詢的成本較低、較易推理;如果答案都在同一個語料庫內,這種做法便完全足夠。當情況並非如此時,才採用這種設計。
負責處理工作的 CDK 構造
這個應用程式主要由四個構造承擔工作,值得逐一説明,因為每個構造都取代了原本需要手動編寫的部分:
- Provider – 用於執行時間超過 AWS Lambda 函式 15 分鐘上限的自訂資源。
on_event/is_complete的拆分方式,代表不需要任何程序在輪詢迴圈中空等;而回傳給 CloudFormation 的回應協定由框架負責處理,毋須在每個處理常式內加入 vendoredurllib回呼。 - BucketDeployment – 負責上載語料庫,讓擷取資料的自訂資源只需負責擷取。
- auto_delete_objects=True 和 empty_on_delete=True 取代了手寫的
list_object_versions和刪除映像的迴圈;否則,堆疊根本無法銷毀。 - repository.grant_pull_push(project) – 一行程式碼便能授予 CodeBuild 所需的八項
ecr:*動作,並由構造確保拼寫正確。
還有 Observe 區段中的型別化儀錶板:使用 Metric / GraphWidget / Row 物件,而非 DashboardBody JSON 字串,讓無效的元件組合不再是「在主控台上顯示錯誤」,而是在 cdk synth 時便失敗。
CDK 不會改變兩件事,開始使用前值得先了解:
- 自由格式的 JSON 仍採用 camelCase。
connector_parameters和parameter_values會原樣傳遞,因此 AWS CDK 將 snake_case 轉換為 PascalCase 的規則不適用於其中。bucketName和inclusionPrefixes等鍵必須完全按照 API 的要求拼寫;否則要到資源失敗時,才會發現問題。 - 以字串型別表示的值仍然是字串。Observe 區段中
knowledge-base/<id>與裸寫的<id>之間的維度差異,型別系統無法察覺。型別化構造會檢查結構,而非語義。
兩者都不是偏好其中一種工具的理由。這些正是「型別化」所能提供的範圍;瞭解這個界線所在,便能大致掌握 CDK 為何易用而不令人意外。
結語
我們利用 Managed Amazon Bedrock Knowledge Base 和 AgentCore 建構了完整的企業級代理式檢索方案:多知識庫語義路由、推理 Agent、七層可觀測性,以及按需和持續評估,並將所有內容部署為單一 AWS CDK 應用程式。
有兩點值得記住。受管理的知識庫減少了所需的基礎設施,而非增加基礎設施:無須佈建向量儲存區、建立索引並等待索引就緒,也不會在系統閒置時持續累積 OCU 費用。正如 Amazon Bedrock 文件所述,這亦是支援代理式檢索和 AgentCore Gateway 連接器的知識庫類型。當檢索採用代理式方式後,可觀測性便不再是可選項。這個應用程式佈建的資源中,約有一半用來回答 Agent 實際做了甚麼,以及答案是否理想;對代理式系統而言,這不是額外負擔,而是令系統可運作的關鍵部分。
CDK 的編寫模式在各個交界處發揮了價值。在這個架構中,有七個值需要跨越堆疊邊界,而每個值都是構造參照,而非一組匯出/匯入設定;因此不需要部署指令碼或拆除指令碼,也毋須記住固定次序。
在此基礎上,你可以將數據來源指向自己的語料庫、將 Agent 部署在虛擬私有雲(VPC)中、按預算和政策調整線上評估的取樣率,或為路由器新增更多知識庫。如欲瞭解更多,請參閲 Amazon Bedrock 詳細資訊頁面及 Amazon Bedrock 文件。應用程式、驅動程式筆記本及自包含工具均位於隨附的 GitHub 儲存庫,你可以複製該儲存庫,並以一個命令部署自己的副本。
作者簡介

Prabhakar Chandrasekaran
Prabhakar 是 AWS Enterprise Support 的資深技術客戶經理。他樂於協助客戶在雲端建立 AI 和 ML 解決方案。他亦與企業客戶合作,提供主動指引及營運協助,協助他們提升使用 AWS 時的解決方案價值。Prabhakar 持有八項 AWS 認證及七項其他專業認證。他擁有逾 23 年專業經驗,加入 AWS 前曾在金融服務領域擔任數據工程師及項目主管。

Siddhant Sahu
Siddhant 是 AWS 的資深產品經理,負責領導 Amazon Bedrock Managed Knowledge Base 的產品開發。他專注於建立及推出基礎設施軟件服務,透過全託管的資料擷取、剖析及代理式搜尋管線,以具成本效益、準確及安全的方式處理多模態、多語言的企業數據,並運用混合搜尋、多次檢索、工具使用及嵌入技術等先進功能。他的工作讓數以千計的企業客戶及 ISV 能夠大規模建立 Agent。
來源:AWS Machine Learning Blog · aws.amazon.com