降低生成式 AI 成本:規則交給程式碼,判斷交給模型
Cut generative AI costs: Code for rules, models for judgment
AWS Machine Learning Blog提出工作流程的模型呼叫分流方法:規則交由確定性程式碼,固定選項使用受限決策呼叫,開放式任務則使用符合要求的 Amazon Bedrock 模型。
文章整理出規則、固定選項與開放式生成的分流方法,並以 AWS 元件示範如何減少不必要的模型呼叫。
生成式 AI 系統中,最能影響成本的因素,是是否需要呼叫模型。我們經常看到團隊把每項工作都交由大型語言模型(LLM)處理,包括輸入驗證、格式整理和路由。單次呼叫的成本很低,但在正式環境的規模下,這些小額成本會成為架構中最大的支出項目之一。凡是確定性規則能完成的工作,略過模型即可節省費用、降低延遲,並消除一個非確定性來源。本文會介紹如何判斷工作流程中的每個步驟是否需要模型。然後,你可以將各個選項對應至 AWS:確定性程式碼、受限制的決策呼叫,或在 Amazon Bedrock 上使用規模合適的模型。
為何不必要的模型呼叫會累積成本
這種模式通常始於原型階段。某個步驟呼叫模型奏效,於是下一個步驟也預設使用模型。這些步驟包括驗證輸入、重新整理請求主體格式,以及選擇路由。原型階段的用量不大,沒有人會注意到成本。
在正式環境的用量下,不必要的模型呼叫會帶來三方面成本:
- 支出會隨請求數量增加,即使是價值較低的步驟也一樣。
- 延遲會層層累積,因為呼叫鏈中的每次模型呼叫都會增加數百毫秒。
- 輸出可能有所不同,因為相同輸入可能得到不同答案。這會令測試更困難、審核更耗時。
每次推出新模型,都會重新引發選用哪個模型的討論。更早一步要問的問題——這個步驟到底是否需要模型——卻一直沒有人提出。
成本指引(包括 AWS Well-Architected Generative AI Lens)通常從選擇模型開始。本文會再往前一步,先問:這個步驟到底是否需要模型?
如何判斷某個步驟是否需要模型
圖 1 以流程圖呈現整個判斷流程,分為三條標示為「以程式碼執行」、「問題」和「以模型執行」的泳道。依序針對工作流程中的每個步驟回答以下三個問題,並在找到符合該步驟要求的第一個選項時停止:
- 能否透過規則檢查是否成功,例如檢查格式、結構描述、關鍵字或範圍?如果規則只能解決部分工作,快速路徑會先執行規則。
- 能否讓模型一次寫好規則,例如正規表示式或 JSON 結構描述?
- 這個步驟是否要從固定清單中選出一個答案,例如路由、類別或是/否?
如果三個問題的答案全部是否,這個步驟便屬於開放式工作,應交由規模合適的模型處理。
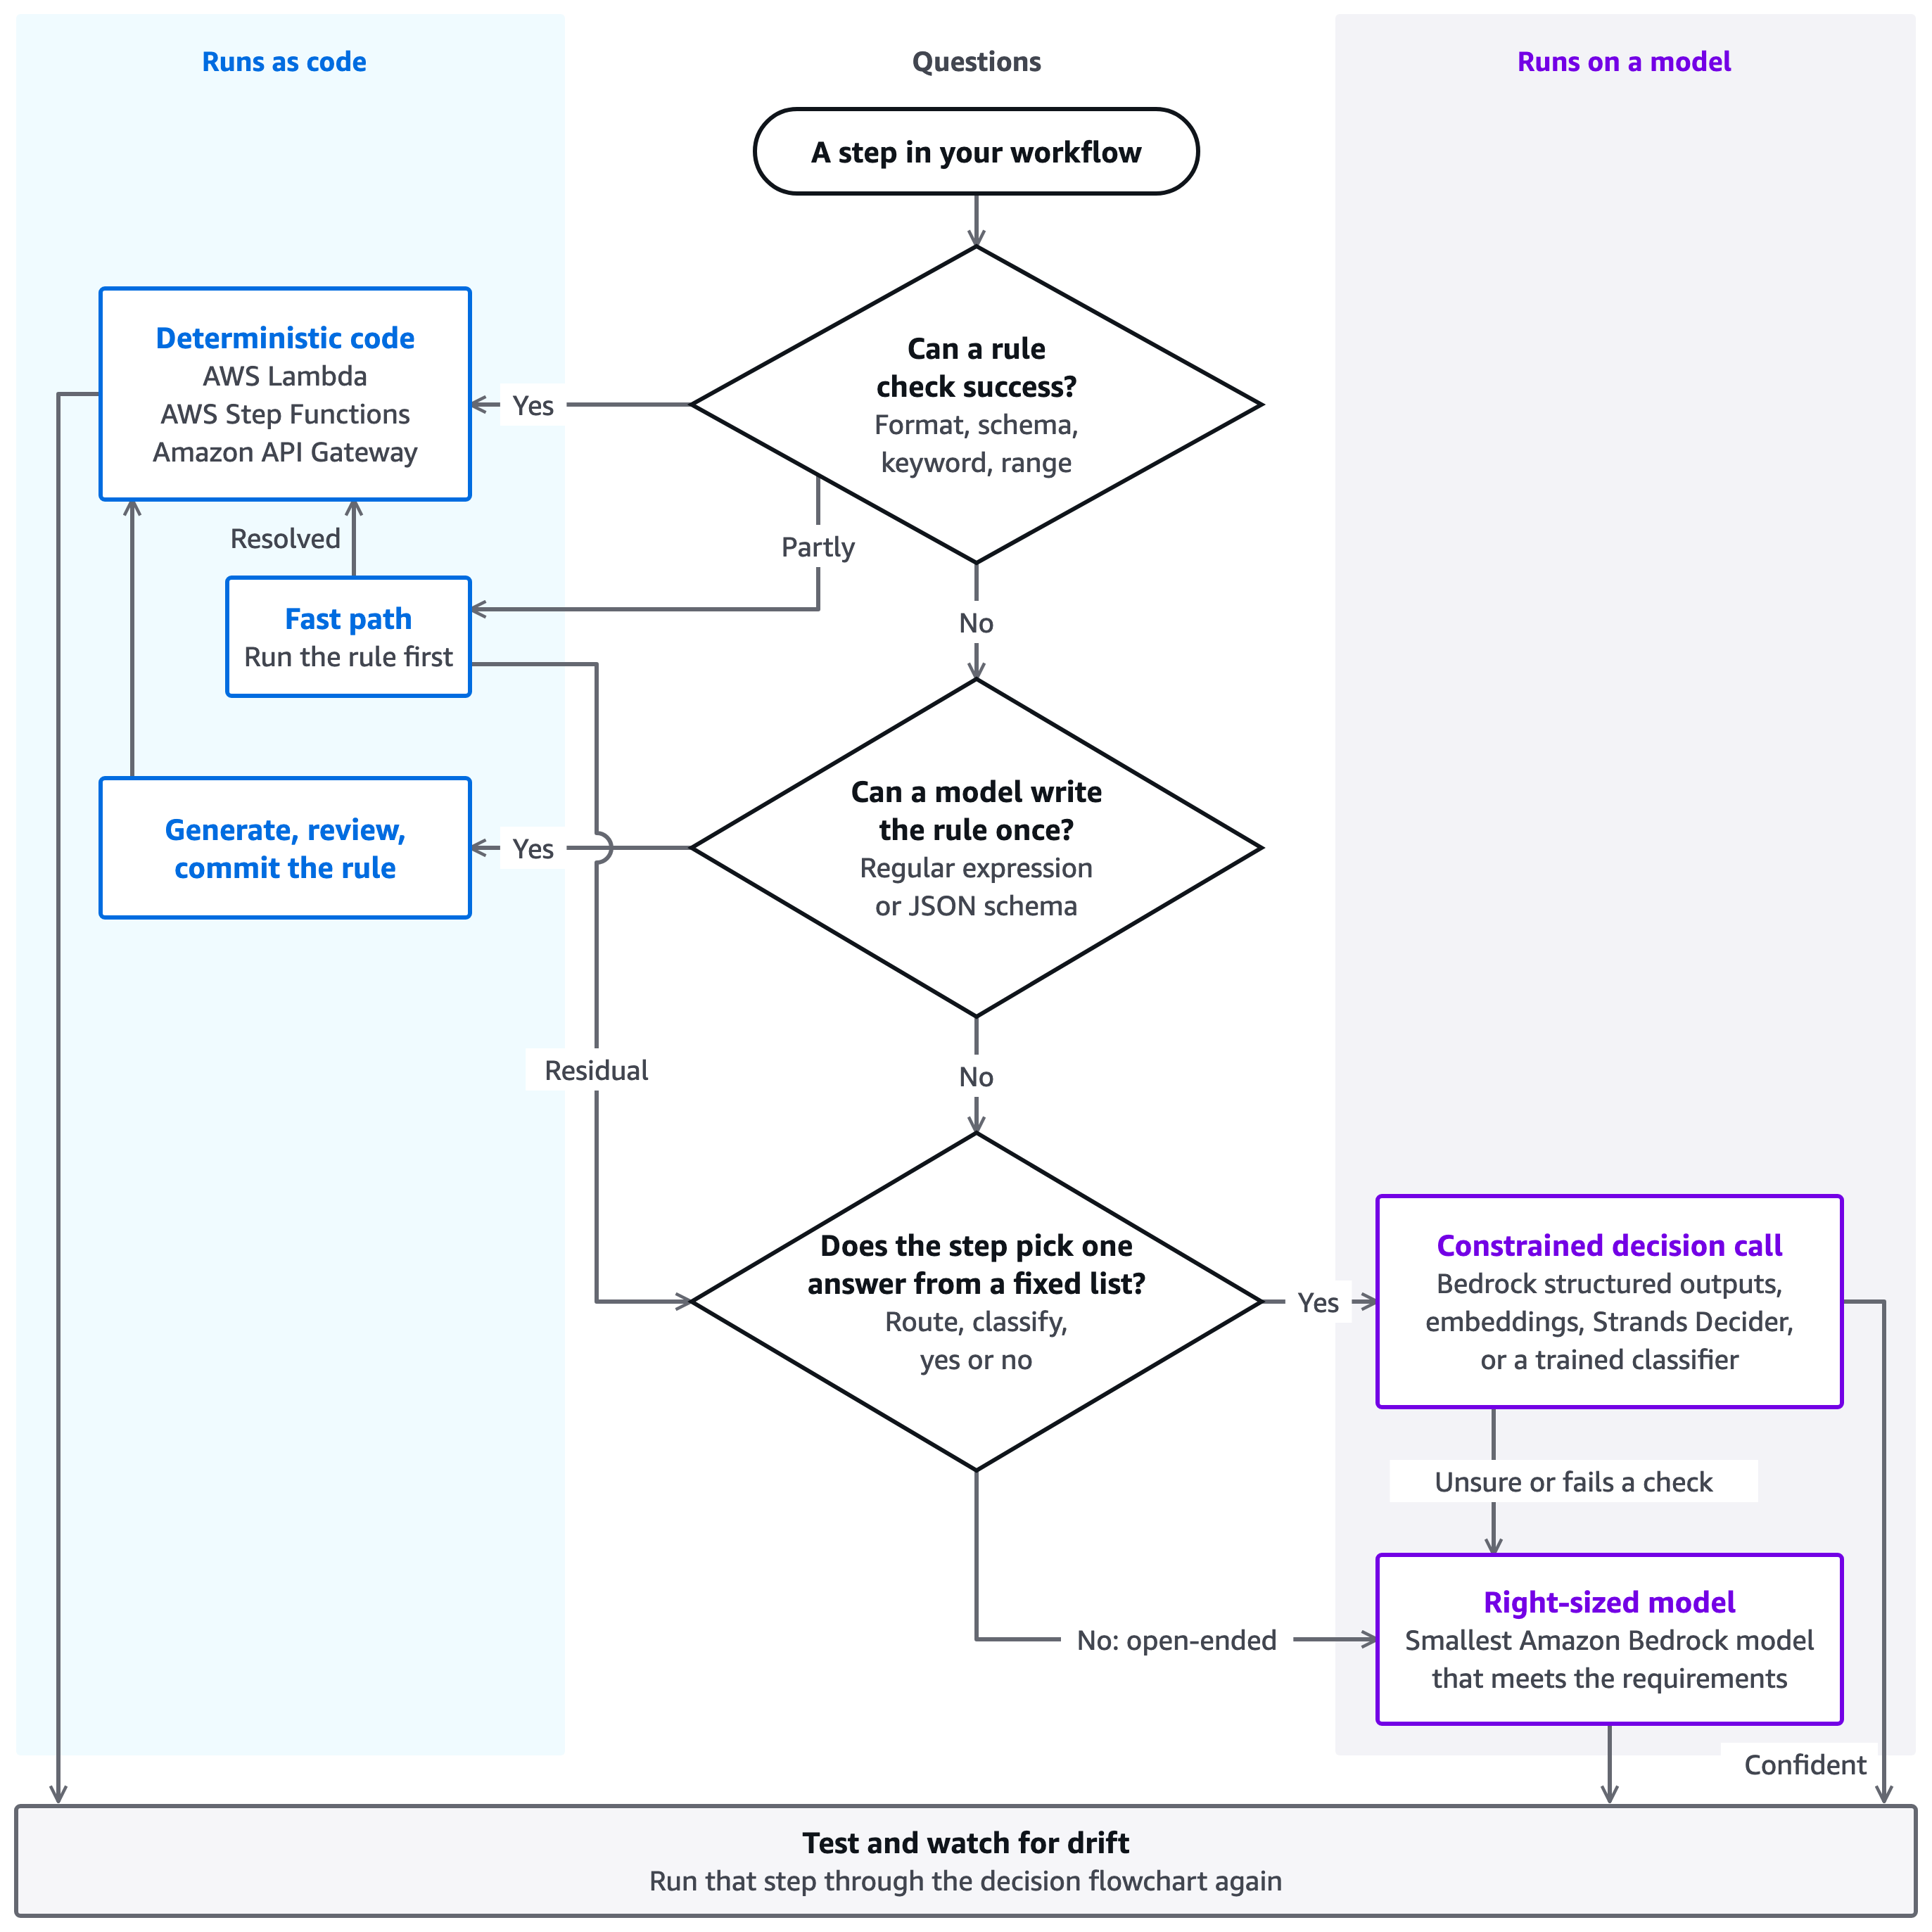
圖 1:判斷工作流程中的步驟是否需要模型,以及應使用哪種模型
以客戶支援助理為例。下表展示其中五個步驟如何依照流程圖進行判斷。
| # | 步驟 | 依流程圖判斷的路徑 | 執行位置 |
| 1 | 檢查訂單編號格式 | 可透過規則檢查。 | Amazon API Gateway REST API 請求驗證,或 AWS Lambda 函數 |
| 2 | 按意圖為訊息選擇路由 | 規則可解決其中一部分。快速路徑透過關鍵字比對處理「退款」等訊息,其餘情況則進入第三個問題。 | 使用 JSONata 的 AWS Step Functions Choice 狀態。其餘情況交由受限制的決策呼叫處理。 |
| 3 | 從承運商電郵中擷取追蹤編號 | 模型可以一次寫好規則。它會草擬正規表示式,再由你審核並提交。 | 程式碼:以已提交的模式在 AWS Lambda 中執行 |
| 4 | 為工單選擇四個支援佇列之一 | 答案來自固定清單。 | 受限制的決策呼叫。不確定的答案會升級交由規模合適的模型處理。 |
| 5 | 為客戶草擬回覆 | 這項工作屬於開放式任務。 | 大小合適的模型:符合要求的最小 Amazon Bedrock 模型 |
當任務屬於開放式、含糊不清或需要生成內容時,可以使用模型:例如總結文件、草擬回覆、從文字中提取含義。若任務有可檢查的規則,則使用確定性程式碼:例如電郵格式、結構描述、指定關鍵字或數值範圍。下表顯示,將以規則界定的任務交給模型處理,會付出哪些代價。
| 特性 | 確定性程式碼 | 模型呼叫 |
| 每次呼叫的成本 | 通常低幾個數量級 | 按 token 計費,規模擴大後成本不容忽視 |
| 延遲 | 個位數毫秒或以下 | 數百毫秒 |
| 對明確規定規則的正確性 | 完全符合所寫的規則 | 正確率高,但錯誤率並非零 |
| 可審核性 | 規則存放在源碼控制中 | 較難向審計人員解釋 |
| 隨時間變化的行為 | 在你作出更改之前保持穩定 | 當你轉用新模型版本,或某個版本停用時,行為便會改變 |
模型亦可能產生幻覺,並對相同輸入給出不同答案。將 temperature 設為 0,較不容易得到不同答案,但不能保證輸出完全相同。Amazon Bedrock 模型評估和Amazon Bedrock Guardrails有助你衡量及控制這些風險。規則沒有這兩個問題,這也是受監管工作負載偏好採用規則的原因之一。一個實用的判斷方法是:如果你能以規則撰寫驗收測試,通常也能以規則實作該步驟。如需更多資訊,請參閲 AWS Prescriptive Guidance 中的編排模型:從規則式走向原生 AI。
作出決策,而非生成內容
大多數路由及分類步驟介乎規則與開放式生成之間。規則無法判斷所有情況,但這些步驟也不需要生成文字;它們需要的是從你預先定義的固定選項清單中選出一個答案,例如前文例子中的支援佇列。使用一個只會輸出允許答案,並能在需要升級處理時發出訊號的元件。高信心答案會繼續處理,不確定的答案則會升級處理。AWS Well-Architected Agentic AI Lens 將此稱為分層、以信心程度為依據的升級處理。在 AWS 上,你可以透過以下四種方式建構:
- 小型 Amazon Bedrock 模型與結構化輸出 – 答案只可從
enum選項集合中選擇,並設有一個會觸發升級處理的「不確定」選項。這是模型本身的判斷,而非經校準的分數,因此在用來決定是否升級處理之前,請先以已標註資料進行檢驗。 - 嵌入相似度 – 使用 Amazon Bedrock 嵌入模型為輸入生成嵌入向量,並選取最相近的已標註範例。以相似度分數作為升級處理的訊號,並根據已標註資料設定其閾值。
- Strands Decider,一個採用 Apache License 2.0 的實驗性開源決策模型 – 它會從選項中作出選擇,或根據評分準則評分,並為每個答案提供經校準的信心度。其 README 指出,在短篇分類任務中,信心度為 0.9 或以上的答案,正確率約為 95%。由於此模型仍屬實驗性質,請先以自己的資料驗證這項結果,再用於正式環境。你需要自行代管,例如依照其儲存庫中的部署指南,將模型部署到Amazon SageMaker AI端點。
- 在 Amazon SageMaker AI 上訓練的分類器——只要有已標記的訓練數據,便能以低延遲和低成本返回類別機率。
以下 JSON 結構描述將結構化輸出答案限制為四個佇列及「不確定」。Amazon Bedrock 要求結構描述中的每個物件都將 additionalProperties 設為 false。
{
  "type": "object",
  "properties": {
    "queue": {
      "type": "string",
      "enum": ["billing", "technical", "account", "other", "unsure"]
    }
  },
  "required": ["queue"],
  "additionalProperties": false
}
不論選擇哪個方案,都應使用自己的已標記數據檢查其升級訊號,並據此設定任何門檻。將退款上限等授權決策寫入規則中。
確定性快速路徑模式
許多成本模式著重於模型之間的路由。快速路徑再提前一步:先執行確定性檢查,只將規則無法判定的內容傳送至模型。意圖路由便是一例。許多訊息都帶有明確無歧義的訊號,例如「退款」或「重設我的密碼」,透過關鍵字比對便可在個位數毫秒內,甚至更快地處理。如果規則能處理 95% 的請求,在計算選擇模型帶來的任何節省之前,每 20 個請求中便只有 1 個會到達模型。(僅為示例計算,並非基準測試結果。)
在 AWS 上,可利用現有的構件組合出這套方案:
- AWS Step Functions 的 Choice 狀態會在工作流程呼叫任何模型之前進行分支處理。
- AWS Lambda 可承載需要超出 Choice 狀態功能的規則,例如驗證和結構描述檢查。
- Amazon API Gateway (REST API) 的請求驗證會在執行任何運算前拒絕格式錯誤的輸入。
- 受約束的決策呼叫或 Amazon Bedrock 模型只處理剩餘部分。
以下 Choice 狀態是關鍵字快速路徑。它使用 JSONata,將退款和密碼重設訊息直接傳送至程式碼處理,其餘訊息則傳送至受約束的決策呼叫。
"KeywordFastPath": {
  "Type": "Choice",
  "QueryLanguage": "JSONata",
  "Choices": [
    {
      "Condition": "{% $contains($states.input.message, /refund/i) %}",
      "Next": "RefundFlow"
    },
    {
      "Condition": "{% $contains($states.input.message, /reset (my )?password/i) %}",
      "Next": "PasswordResetFlow"
    }
  ],
  "Default": "ConstrainedDecisionCall"
}
你也可以讓模型只撰寫一次規則,而非每次都執行模型。讓模型草擬正規表示式或 JSON 結構描述,然後審核並提交。到了執行階段,便只需按規則的速度和成本運作。審核模型撰寫的正規表示式,並使用已知有效和無效的輸入測試。避免使用例如 (a+)+ 這類巢狀量詞,因為在某些輸入下,比對速度可能會非常慢(正規表示式拒絕服務攻擊,或 ReDoS)。
當確實需要生成內容時,Amazon Bedrock 結構化輸出會將回應限制為你定義的 JSON 結構描述。回應隨後會符合該結構描述,因此你的程式碼無須自訂剖析邏輯便可剖析回應(仍須檢查內容是否正確)。數值範圍和長度限制等範圍檢查應保留在程式碼中。有關支援的模型和結構描述功能,請參閲 從模型取得經驗證的 JSON 結果。
如果規則存放在設定中,只允許使用已知的基本項目,例如正規表示式、結構描述檢查、關鍵字清單和範圍檢查。切勿執行設定檔中的任意程式碼。
當確實需要使用模型時,選用合適規模的模型
選擇符合質素下限的最低成本、最快模型。這往往不是最新或最大的模型。Generative AI Lens 在其有關以合適規模選擇模型的最佳實踐中涵蓋這一點。Amazon Bedrock 的有效成本最佳化策略則有深入探討。比較模型之前,先訂明要求:
- 質素下限:可接受的最低輸出質素,以黃金評估集衡量(附有已知正確答案標記的任務範例)。
- 成本上限:每個請求或每次成功結果所支付的最高金額。
- 延遲目標:體驗可容許的 p95 或 p99 回應時間。
- 合規限制:例如數據駐留要求等,可能會排除部分候選模型。
Amazon Bedrock 透過單一 API 提供多個模型系列及不同規模的模型,讓你按各項任務選用合適的模型,而無須更改整合方式。Amazon Bedrock Intelligent Prompt Routing 會將每項請求路由至支援模型系列中合適的模型。Amazon Bedrock Model Distillation 會將較大型模型的知識轉移至較小、成本較低的模型,以配合你的使用場景。模型供應商會以廣泛的基準測試評估新推出的前沿模型,但你的工作負載只涉及一項任務,並有其品質下限。較大型的模型可能會增加成本和延遲,卻未能改善該項任務的表現。切換模型前,請根據你的要求評估每個新推出的模型,例如在黃金評估集上的品質,以及延遲目標。
將模型選擇視為經測試的設定
Generative AI Lens 建議使用你的真實資料測試候選模型,並確保能快速更新模型。你可以進一步將這項決策視為經測試的設定:
- 為每項任務保留一組黃金評估集,當中包含已標註的基準答案,並在持續整合流程中執行評估。
- 以你的要求設定門檻。若較便宜的模型低於品質下限,應視為回歸問題。
- 透過設定旗標控制模型,以便還原模型替換。
- 採用合適的判定依據。以基準答案檢查規則。只對開放式輸出使用模型作評審的評估方式。
- 留意偏移。以影子模式抽樣,將部分由規則處理的請求送交模型;若結果不一致,便重新分類該步驟。
實際應用
將模型運算能力用於需要判斷的地方,不要用在其他地方。你可以透過以下四個步驟做到:
- 加入監測 – 將每次呼叫標記為確定性程式碼、受限決策呼叫或模型呼叫。追蹤每項成功結果的成本。
- 將規則移至程式碼 – 使用 AWS Lambda 或 AWS Step Functions 執行可由規則判定的步驟。這通常是效益最大、風險最低的改進。
- 加入受限決策呼叫 – 透過一個在不確定時會升級處理的呼叫,處理固定選項的步驟。
- 切換模型前先測試 – 在將任何新模型設為預設模型前,先使用你的黃金評估集進行測試。
結論
在本文中,你瞭解如何判斷工作流程中的某個步驟是否需要使用模型。規則應由確定性程式碼處理,固定選項則應使用受限決策呼叫。開放式工作則交由規模合適的 Amazon Bedrock 模型處理。目標是在品質下限允許的範圍內,以最低成本和延遲滿足各項要求。先問某個步驟是否需要模型,再問應該選用哪個模型。
如需更多資訊,請參閲 AWS Artificial Intelligence Blog 的以下文章:
- 使用決策模型搭配 Amazon Bedrock AgentCore Evaluations。
- 使用 Amazon Bedrock Intelligent Prompt Routing,取得成本及延遲方面的效益。
- Amazon Bedrock 上的結構化輸出:符合結構描述的 AI 回應。
- 修正評估偏差,發掘 Amazon Bedrock 上更佳的模型。
如要試用受限決策呼叫,請開啟 Amazon Bedrock 主控台,或從其 GitHub 儲存庫部署 Strands Decider。
從一個高流量工作流程開始,衡量當中有多少部分其實毋須使用模型。
關於作者

Meghan Kothari
Meghan 是客戶體驗與業務趨勢團隊的資深技術產品經理,與 AWS 領導層合作,深入研究代理式 AI 驅動的應用程式開發及現代化,探索不斷演變的趨勢。他曾任解決方案架構師及全端開發人員,這些背景讓他能從獨特的實務角度協助塑造開發者體驗。

Krishna Aswani
Krishna 是 Amazon 的資深應用科學家,擁有超過十年建構可在正式環境中運行的機器學習系統的經驗。他的工作涵蓋電腦視覺、自然語言處理、生成式建模及大型語言模型。在 Amazon,他建構代理式架構,並帶領研究結構化推理框架,讓 LLM 更可靠且更易於解讀。早年,他的研究聚焦於神經計算及生物物理學。他與牛津大學及日本 NIMS 合作,建構模擬器及測量系統,以瞭解資訊如何在腦部微管中傳播,包括量子效應在這些生物結構中可能發揮的作用。

Pranav Patankar
Pranav 是客戶體驗與業務趨勢團隊的科學與工程經理,與 AWS 領導層合作改善 AWS 的開發者體驗。他的研究聚焦於提升 LLM 和 AI Agent 的推理能力,並讓它們更值得信賴。他在數據工程、數據科學及應用研究方面的背景,讓他能從獨特的實務角度協助塑造開發者體驗。

Vineet Kamdar
Vineet 帶領一個跨職能團隊,評估雲端、代理式開發者體驗及整體客戶體驗。他負責策略評估及深入研究,影響生成式 AI、代理式開發者體驗及客戶體驗在多個領域的快速演變,包括代理式編碼助理、代理式遷移、模型訓練及推理。他擁有 18+ 年業界經驗,並具備豐富的企業級大型應用程式建構、架構設計及產品領導經驗,因此特別適合評估、衡量、影響及改善開發者體驗、代理式體驗及整體雲端客戶體驗。
來源:AWS Machine Learning Blog · aws.amazon.com