Reflection AI 發佈面向智能體編碼、可部署於 AWS 的開放權重模型 Reflection Beam
Introducing Reflection Beam: an open-weight model for agentic coding on AWS
Reflection AI 發佈開放權重模型 Reflection Beam,面向智能體編碼及維護程式碼、使用工具等長流程任務。
文章並列 SageMaker JumpStart 託管端點與 HyperPod 上的 JumpStart、SGLang、vLLM 部署選項,並説明各路徑對應的基礎設施控制程度。
Reflection AI 推出了 Beam,這是一款開放權重模型,適用於代理式編碼及長時程任務,例如維護程式碼、使用工具、解讀結果,以及完成多步驟工作流程。開放權重版本讓開發人員和研究人員能夠控制執行階段、部署環境及自訂流程。
本文會介紹 Reflection 的願景,並示範如何在 AWS 上部署 Beam。如要採用全代管方案,可從 Amazon SageMaker JumpStart 即時端點開始。如需 Kubernetes 原生的分散式 GPU 基礎設施控制能力,可搭配 JumpStart、SGLang 或 vLLM 使用Amazon SageMaker HyperPod Inference。本文亦會説明 Beam 的 501 billion 個總參數如何影響檢查點儲存、權重記憶體、分片及平行處理,而其 23 billion 個活躍參數則如何影響每個 token 的運算量。
Beam 推出時,可在 US East (N. Virginia) 和 US East (Ohio) 的 Amazon SageMaker JumpStart 使用。
Reflection 對開放智能的願景
Reflection 的使命是透過開放模型權重、已發表的研究及開源軟件,讓所有人都能使用智能。其完整 AI 技術堆疊涵蓋模型、核心軟件、生產環境基礎設施及應用程式。Beam 將這種理念帶給建構軟件工程及代理式系統的開發人員。
關於 Reflection Beam
Beam 是一款稀疏混合專家模型,適用於解決軟件問題、修改程式碼、呼叫工具,以及根據中間結果採取行動。模型共有 501 billion 個參數,其中 23 billion 個為活躍參數;Reflection 表示,其有效上下文長度為 1 million tokens。
Reflection 透過 Hugging Face,以 Apache 2.0 授權條款發布 Beam 的權重。Beam 1.0 提供 BF16、FP8 和 NVFP4 檢查點版本。這些格式的記憶體佔用量和硬件相容性各有不同。你可以使用 AWS 代管的 JumpStart 容器設定部署模型,或在 AWS 環境中透過 SGLang 或 vLLM 檢視及自訂模型。
瞭解部署架構
選擇符合控制及擴展需求的推論服務方式。
- 如要使用 AWS 代管的模型套件、端點及呼叫 API,而無需操作 Kubernetes,可選擇 SageMaker JumpStart 即時端點。
- 如要在由 Amazon Elastic Kubernetes Service (Amazon EKS) 編排的 HyperPod 叢集上使用 AWS 代管容器及模型設定,可選擇 HyperPod Inference 上的 JumpStart。
- 如需控制服務映像、執行階段參數、量化或分散式執行,可選擇 HyperPod Inference 上的 SGLang 或 vLLM。
- 部署規模須配合檢查點儲存、權重記憶體、KV 快取、上下文長度、批次處理、執行階段開銷及支援的平行處理方式。
- 先訂定預期併發量及延遲目標,再根據實測工作負載表現設定副本、快取、路由及自動擴展。
JumpStart 即時端點方案透過代管部署流程,將模型、容器及端點整合在一起。HyperPod 方案則讓你控制叢集及推論服務執行階段,從而管理分散式執行、快取、路由及擴展。
下圖展示 HyperPod 部署路徑所用的元件。Beam 可透過 SageMaker JumpStart、Hugging Face Hub,或可選用的 Amazon Simple Storage Service (Amazon S3) 鏡像取得。分散式工作節點會使用 AWS 管理的 JumpStart 容器,或自訂的 SGLang 或 vLLM 執行階段。
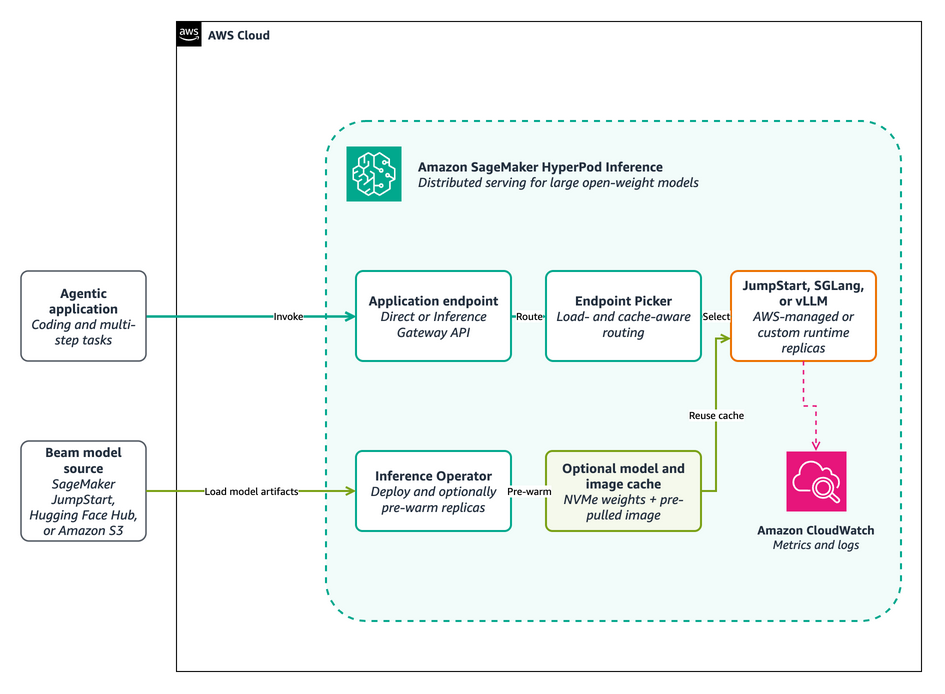
圖 1:使用 Amazon SageMaker HyperPod Inference 的分散式 Beam 部署
先決條件
你需要:
- 一個 AWS 帳戶,具備所選 SageMaker 部署路徑,以及相關 AWS Identity and Access Management (IAM)、網絡和儲存資源所需的權限。
- 透過 SageMaker JumpStart 或 Hugging Face 上其中一個 Beam 1.0 檢查點儲存庫存取 Beam。
- 接受模型條款、AWS Command Line Interface (AWS CLI),以及 Python 3.11 或更新版本。
- 支援的 Beam 配置所需的 GPU 配額和容量。
規劃並取得 GPU 容量
Beam 的總參數量為 501 billion,需要以多個 GPU 部署。BF16 所需的權重記憶體最多,因此請規劃多節點配置,確保 GPU 記憶體總量足以容納權重及執行階段開銷。使用 FP8 時,配合 NVIDIA H100 GPU 使用 ml.p5.48xlarge,或配合 H200 GPU 使用 ml.p5e.48xlarge 和 ml.p5en.48xlarge。使用 NVFP4 時,配合 NVIDIA B200 GPU 使用 ml.p6-b200.48xlarge。請確認已發布的檢查點、執行階段和並行配置均支援所選執行個體類型。
- 計算單個副本所需的權重、KV 快取和執行階段開銷記憶體,然後透過負載測試確認估算結果。
- 選擇支援所需加速運算執行個體的 AWS 區域。
- 檢查所選執行個體類型的服務配額和可用容量。有隨需容量時請使用隨需容量;如要為已排程工作作短期預留,則可使用 SageMaker training plan。
- 預留時間以進行映像檔傳輸、權重下載、分片載入和執行階段初始化。
路徑 1:開始使用 SageMaker JumpStart 即時端點
如果你希望以最直接的方式,從模型目錄建立受管理的 HTTPS 端點,請先使用 JumpStart 即時端點。此範例透過一個支援不同變體的命令,支援 BF16、FP8 和 NVFP4 模型 ID。README 和 Python 檔案是查閲支援的執行個體類型、請求結構、部署命令和清理命令的準據。
- Clone the sample repository.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - Enter the SageMaker JumpStart deployment sample directory.
cd sagemaker-genai-hosting-examples/01-models/ReflectionAI/Beam-1.0-501B-A23B-NVFP4/ - Create and activate a Python virtual environment.
python3 -m venv .venv source .venv/bin/activate - Install the sample dependency.
python -m pip install -r requirements.txt - Run the bounded deployment, invocation, and cleanup lifecycle for FP8.
python jumpstart_real_time.py \
--variant fp8 \
--endpoint-name reflection-beam-fp8-smoke
此命令會部署 FP8 端點、傳送簡短請求、列印回應,然後清理端點。使用
bf16或nvfp4選擇其他檢查點變體;省略--variant時,預設使用 NVFP4。如要讓端點持續運作,請使用 README 中的 Python 函數。
路徑 2:使用 SageMaker HyperPod Inference 部署
如需以 Kubernetes 原生方式控制分散式 GPU 基礎架構,請使用 HyperPod Inference。你可以使用 AWS 管理的 JumpStart 容器配置,或透過 SGLang 或 vLLM 部署 Beam。HyperPod Inference deployment sample README 及其配置檔案是查閲已發布的部署資訊清單、模型和映像識別碼、支援的執行階段版本及命令的準據。
開始之前,請先設定 kubectl,以存取由 EKS 編排、並配備 HyperPod Inference Operator 及所需附加元件的 HyperPod 叢集。你亦需要叢集的虛擬私有雲(VPC)、子網絡、安全羣組、存取所選 Beam 和執行階段成品的權限,以及在啟用模型快取時所需的本機 NVMe 容量。如所選儲存庫要求驗證,請使用獨立的 Hugging Face 存取權杖。
從 Hugging Face Hub 部署固定版本的 Beam,以供開發和實驗。對於正式環境部署及模型快取,請將模型檢查點複製到 Amazon S3 或 Amazon FSx。HyperPod 模型及映像快取可預先將權重載入節點本機 NVMe 儲存空間,並預先拉取服務映像。
HyperPod Inference Gateway提供與 OpenAI 相容的介面,並在多個副本之間路由請求。HyperPod Inference 亦支援受管理的分層 KV 快取及智能路由。這些功能亦是Amazon SageMaker Inference 在 2026 年推出的功能。
下一張圖進一步説明模型準備及執行階段的請求流程。啟用模型快取時,Inference Operator 會使用所選權重和服務映像,預熱符合條件的節點。在執行階段,Inference Gateway 和 Endpoint Picker 可將每個請求導向合適的 JumpStart 管理副本、SGLang 副本或 vLLM 副本。
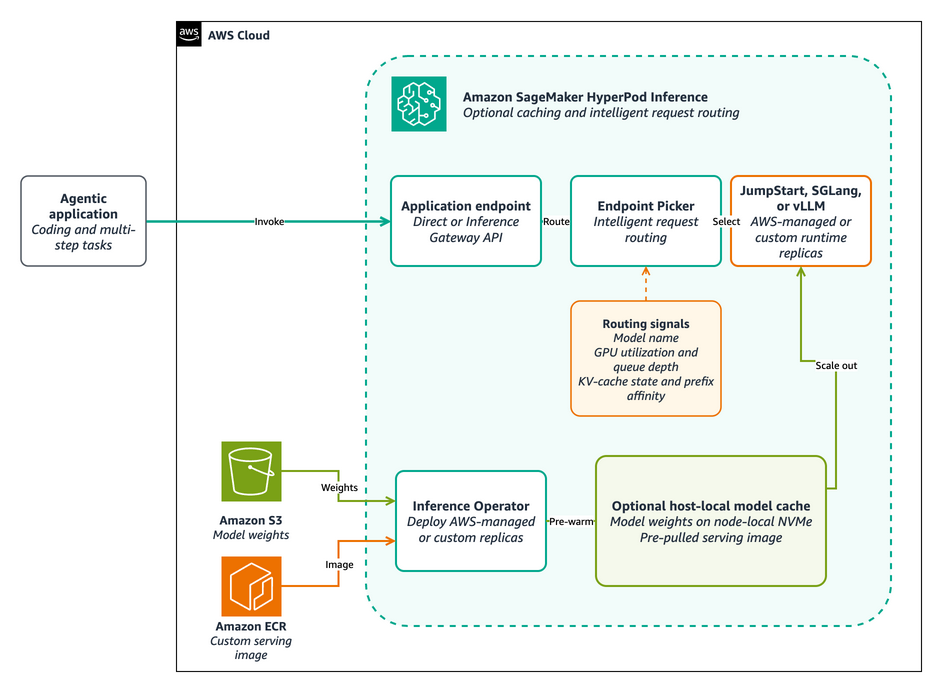
圖 2:HyperPod 模型快取及請求路由
準備部署成品
使用不可變更的輸入,以便重現部署和效能結果。
- 使用部署範例中記錄的 JumpStart 模型版本。
- 如使用自訂執行階段,請選擇 BF16、FP8 或 NVFP4 檢查點。
- 如使用自訂執行階段,請在範例的發佈設定中保留公開的 Beam commit SHA 和映像摘要。
- 只有在叢集無法拉取上游映像,或機構要求使用已核准的登錄檔時,才將已發佈的映像鏡像至私有 Amazon Elastic Container Registry (Amazon ECR) 儲存庫。
- 請勿將權杖、產生的機密資訊、私人模型 ID、登錄檔憑證,以及未公開的結果放入儲存庫。
選擇服務方式
除非工作負載需要特定的推論執行階段或設定,否則請先使用 SageMaker JumpStart。
| 服務方式 | 適用情況 | 需管理的項目 |
| SageMaker JumpStart | 你需要由 AWS 管理的容器和模型設定,並希望減少執行階段維護工作。 | 選擇 Beam 模型版本、支援的執行個體類型、端點設定及擴展政策。 |
| SGLang 或 vLLM | 你需要特定的推論執行階段或設定,例如自訂執行階段引數、剖析器、量化或平行處理。 | 固定指定支援的執行階段映像、模型版本、剖析器設定及分散式執行設定。 |
使用 SageMaker JumpStart 部署
SageMaker JumpStart 可減少容器整合工作,同時由 HyperPod 保留對叢集容量、擴展及可觀測性的控制權。
- 在 SageMaker Studio 中開啟JumpStart 模型目錄。
- 在所有公用模型下,選擇Beam。
- 選擇SageMaker HyperPod作為部署目標。
- 選擇叢集和 Kubernetes 命名空間。
- 輸入端點名稱,然後選擇部署。
- 使用已發佈的 JumpStart 請求結構描述呼叫端點前,請先確認部署狀態。
如要使用基礎架構即程式碼工作流程,請使用 HyperPod 範例中已發佈的 JumpStart 設定。設定部署前,你可以先查看reflection-beam-jumpstart.yaml manifest 範本。
- Clone the sample repository, and enter the HyperPod Beam directory.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - Create the local configuration files described in the README.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - Validate the JumpStart configuration before changing the cluster.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate jumpstart - Deploy the JumpStart configuration.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy jumpstart \
  --timeout-seconds 1800
輔助程式會產生並套用已發佈的 JumpStartModel 資源,而不會將填入的版本值寫入磁碟。
使用 SGLang 或 vLLM 部署
如果需要直接控制推理服務執行環境,請選用 SGLang 或 vLLM。設定部署前,請先查看 reflection-beam-sglang.yaml manifest 範本 或 reflection-beam-vllm.yaml manifest 範本。範例 README 仍是已發布設定值及指令的準確依據。
- Clone the sample repository.
git clone https://github.com/aws-samples/sagemaker-genai-hosting-examples.git - Enter the HyperPod Beam directory.
cd sagemaker-genai-hosting-examples/SageMakerHyperpod/reflection-beam/ - Create the local configuration files described in the README.
cp config/deployment.env.example config/deployment.env cp config/release.env.example config/release.env - Validate the selected configuration before changing the cluster.
python hyperpod_tool.py \ --config config/deployment.env \ --config config/release.env \ validate sglang - Deploy Beam, and wait for a terminal deployment state.
python hyperpod_tool.py \
  --config config/deployment.env \
  --config config/release.env \
  deploy sglang \
  --timeout-seconds 1800
如要使用 vLLM,請將
sglang替換為vllm。輔助程式會驗證所選設定,在不將已發布設定值寫入磁碟的情況下套用產生的 manifest,並在固定逾時時間內等待;如果部署失敗,則會列印診斷資訊。
呼叫 Beam
使用已發布的模型請求結構呼叫 JumpStart 端點。使用 SGLang 或 vLLM 時,請使用 HyperPod 範例中附帶的限時基本測試。
呼叫已部署的端點
- Install the sample client dependency.
python3 -m venv .venv source .venv/bin/activate python -m pip install -r requirements.txt - Run a private health check and short request with the recommended starting sampling settings.
python hyperpod_tool.py \
--config config/deployment.env \
smoke sglang \
--prompt "List three checks for a healthy model deployment." \
--temperature 1.0 \
--top-p 0.7
如要使用 vLLM 部署,請將
sglang替換為vllm。輔助程式會選取一個就緒的工作節點、開啟臨時連接埠轉送、檢查端點運作狀態、傳送請求,然後關閉連接埠轉送。
回應格式如下:
1. Confirm that the endpoint reports ready.
2. Send a short inference request.
3. Review the service logs for startup errors.
如要使用已驗證的 Inference Gateway,請按照 HyperPod 範例 README 中使用 bearer token 的程序操作。請勿將憑證放入原始碼、manifest 或命令記錄中。
量度及調校效能
- 使用預期的並行量,透過重複且具代表性的程式編寫及工具使用請求,測試每條推理服務路徑。
- 記錄 Beam 模型版本、映像檔摘要、執行個體類型、精度、上下文長度、並行度、推理服務引數、快取狀態及測試次數。
- 量度請求成功率、首個 token 的 p50 和 p95 延遲、每個輸出 token 所需時間、端到端延遲,以及整體每秒輸出 token 數。
- 根據結果調校批次大小、KV 快取配置、副本數、自動擴展,以及模型和映像檔快取。
- 更改精度或量化設定後,請重新檢查輸出品質。
清理
完成測試後,請刪除資源,以免持續產生費用。
- 如要清理 SageMaker JumpStart 即時端點,請按照 SageMaker JumpStart 部署範例 README 中的清理指示操作。
- 如要清理在 Amazon SageMaker HyperPod Inference 上使用 JumpStart、SGLang 或 vLLM 部署的資源,請按照 HyperPod Inference 部署範例 README 中的清理指示操作。
- 刪除為本指南建立的專用 HyperPod 或 Amazon EKS 叢集。
- 刪除未使用的快取權重、副本成品、負載平衡器、日誌羣組、臨時 IAM 角色及擷取的推理數據。
結語
Reflection Beam 為開發者提供一款開放權重模型,專為 Agent 式程式編寫及多步驟任務而設。若要採用完全代管的部署方式,請從 SageMaker JumpStart 即時端點開始。若需要 Kubernetes 原生基礎設施控制,但不想管理推理服務容器,請使用搭配 JumpStart 的 SageMaker HyperPod Inference;如需自訂執行環境,則可選用 SGLang 或 vLLM。
請使用 SageMaker JumpStart 部署範例 或 HyperPod Inference 部署範例,然後按照指示操作。
如要進一步瞭解 Reflection AI 及其對開放智能的願景,請瀏覽 Reflection AI,並閲讀 Introducing Beam。
資源
- Reflection Beam 檢查點版本:BF16、FP8 及 NVFP4
- SageMaker JumpStart 部署範例
- 採用 JumpStart、vLLM 及 SGLang 的 HyperPod Inference 部署範例
- 將 SageMaker JumpStart 基礎模型部署至 HyperPod Inference
- Amazon SageMaker Inference 2026 年至今推出項目回顧
作者簡介

Clement Perrot
Clement 是 Reflection AI 的創始應用 AI 團隊成員。加入 Reflection AI 前,他曾在 AWS 的生成式 AI 創新中心工作,並創立 AI 及消費者硬件初創公司,其中兩家公司已被收購。

Florent Gbelidji
Florent 是 Reflection AI 的開源工程主管及技術團隊成員。加入 Reflection AI 前,他負責 Hugging Face 與 AWS 的雲端合作,並曾任機器學習工程師,協助企業建立開源 AI 方案。

Daniel Quang
Daniel 是 AWS 前沿 AI 初創公司團隊的解決方案架構師,協助全球規模最大、最具策略重要性的生成式 AI 初創公司擴展其在 AWS 上的基礎設施。他持有加州大學爾灣分校的電腦科學博士學位,研究方向為機器學習和生物資訊學。

Hadrien Almela
Hadrien 是 AWS 初創公司團隊的資深前沿 AI 客戶經理,協助頂尖 AI 初創公司建立技術整合方案和全球市場拓展合作夥伴關係。他在初創公司領域有八年經驗。Hadrien 居於加州三藩市,喜歡潛水、衝浪,以及到異國地方旅行。

Dan Ferguson
Dan 是 AWS 的生成式 AI 資深全球專家解決方案架構師,常駐紐約。他協助客戶高效、有效且可持續地整合機器學習和生成式 AI 工作負載。

Daniel Wirjo
Daniel 是 AWS 的解決方案架構師,專注於 AI 和 SaaS 初創公司。作為前初創公司 CTO,他樂於與創辦人及工程主管合作,推動企業在 AWS 上增長和創新。工作以外,Daniel 喜歡手拿咖啡散步、欣賞大自然,以及學習新知識。

Sureshkumar Natarajan
Sureshkumar 是 Amazon Web Services 的資深技術客戶經理。他協助企業客戶加快雲端現代化進程,並是支援 AWS Transform custom 的下一代開發者體驗技術外勤社羣成員。
來源:AWS Machine Learning Blog · aws.amazon.com