在 24GB 消費級 GPU 上使用 RLHF 微調 20B 大語言模型
Fine-tuning 20B LLMs with RLHF on a 24GB consumer GPU
Hugging Face 發佈 trl 與 peft 整合,介紹以 RLHF 在 24GB 消費級 GPU 上微調 20B 大語言模型的方法。示例以 gpt-neox-20b 為基礎,結合 8-bit 載入與 PEFT 低秩適配器,並透過停用適配器讓同一模型提供參考與當前 logits。
文章拆解 8-bit 載入、PEFT 低秩適配器與共用參考模型的組合,呈現降低 RLHF 微調大型模型顯存需求的實作思路。
我們很高興正式推出 trl 與 peft 的整合,讓任何人都更容易使用強化學習微調大型語言模型(LLM)!本文會解釋,為何這是現有微調方法中一個具競爭力的選擇。
請注意,peft 是一種可應用於多種機器學習用途的通用工具,但它特別適合 RLHF,因為這種方法尤其消耗記憶體!
如果你想直接深入瞭解程式碼,請到 TRL 説明文件頁面查看範例指令碼。
引言
大型語言模型與 RLHF
大型語言模型結合 RLHF(人類回饋強化學習),似乎正成為建立 ChatGPT 等強大 AI 系統的首選方法。
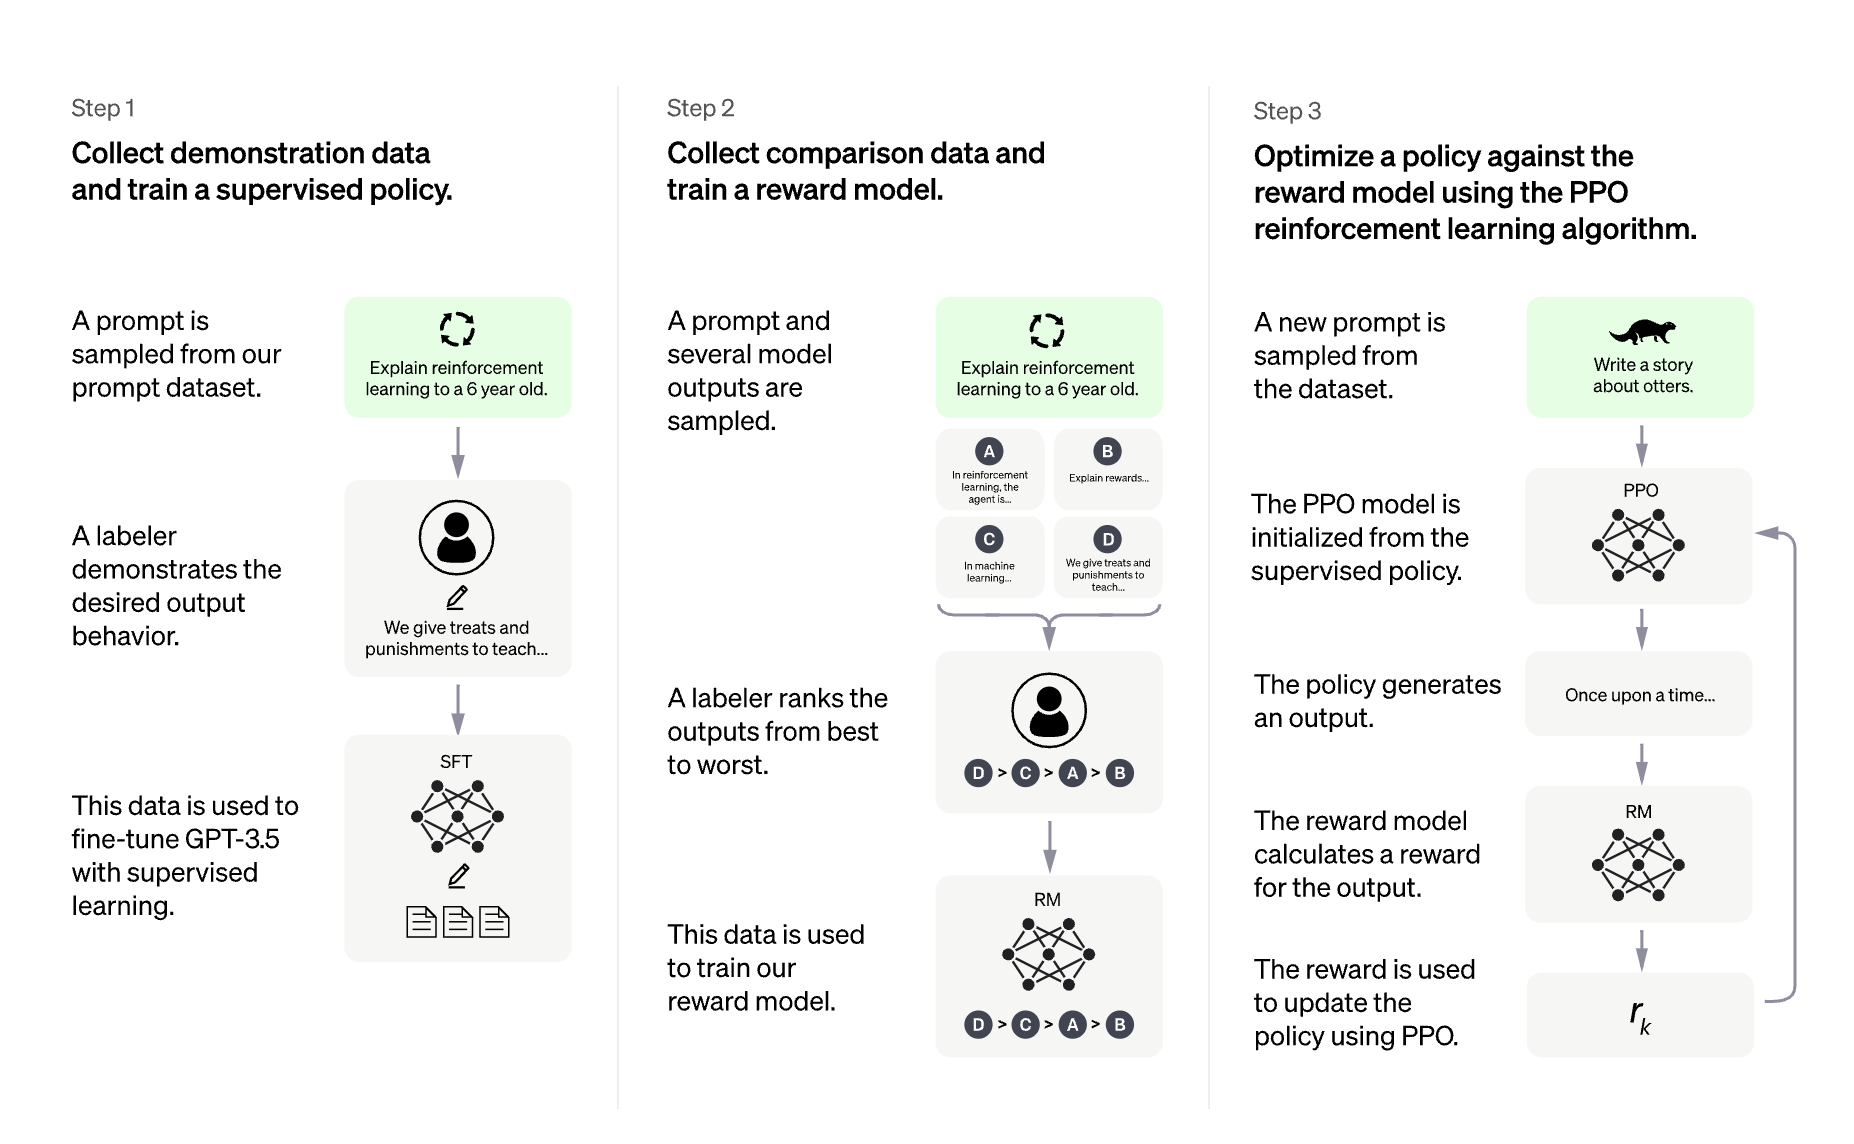
以 RLHF 訓練語言模型通常包括以下三個步驟:
1- 以特定領域資料或指令與人類示範,微調預訓練大型語言模型
2- 收集經人類標註的數據集,並訓練獎勵模型
3- 使用獎勵模型和該數據集,透過強化學習(例如 PPO)進一步微調步驟 1 中的大型語言模型
 |
|---|
| ChatGPT 訓練流程概覽,從數據收集到強化學習部分。來源:OpenAI 的 ChatGPT 網誌文章 |
在這個流程中,基礎大型語言模型的選擇相當關鍵。撰寫本文時,可開箱即用於多種任務的「最佳」開源大型語言模型,是經過指令微調的模型。值得留意的模型包括:BLOOMZ、Flan-T5、Flan-UL2 和 OPT-IML。這些模型的缺點是體積龐大。若要取得表現不俗的模型,至少要使用 10B 以上規模的模型;若以全精度在單一 GPU 上載入模型,即使完全不進行訓練,也需要高達 40GB 的 GPU 記憶體!
甚麼是 TRL?
trl 程式庫旨在令強化學習步驟更簡單、更靈活,讓任何人都可以使用強化學習,在自訂數據集和訓練設定上微調語言模型。除了眾多其他用途外,你亦可以用這套演算法微調模型,生成正面電影評論、進行受控生成,或降低模型的毒性。
使用 trl,你可以在多部裝置上分散執行其中一種最受歡迎的深度強化學習演算法 PPO,亦可以在單一裝置上執行!我們運用 Hugging Face 生態系統中的 accelerate 實現這一點,讓用戶可以把實驗擴展至相當可觀的規模。
使用強化學習微調語言模型,大致會遵循下方詳述的流程。這需要準備原始模型的 2 個副本;為避免正在訓練的模型偏離原本行為/分佈太多,每個最佳化步驟都要計算參考模型的 logits。這對最佳化過程構成嚴格限制,因為每部 GPU 裝置至少要載入兩個模型副本。模型越大,就越難在單一 GPU 上容納整套設定。
 |
|---|
| TRL 中 PPO 訓練設定概覽。 |
在 trl 中,你亦可以讓參考模型和正在訓練的模型共用層,避免建立完整副本。毒化處理範例便展示了這項功能的具體用法。
大規模訓練
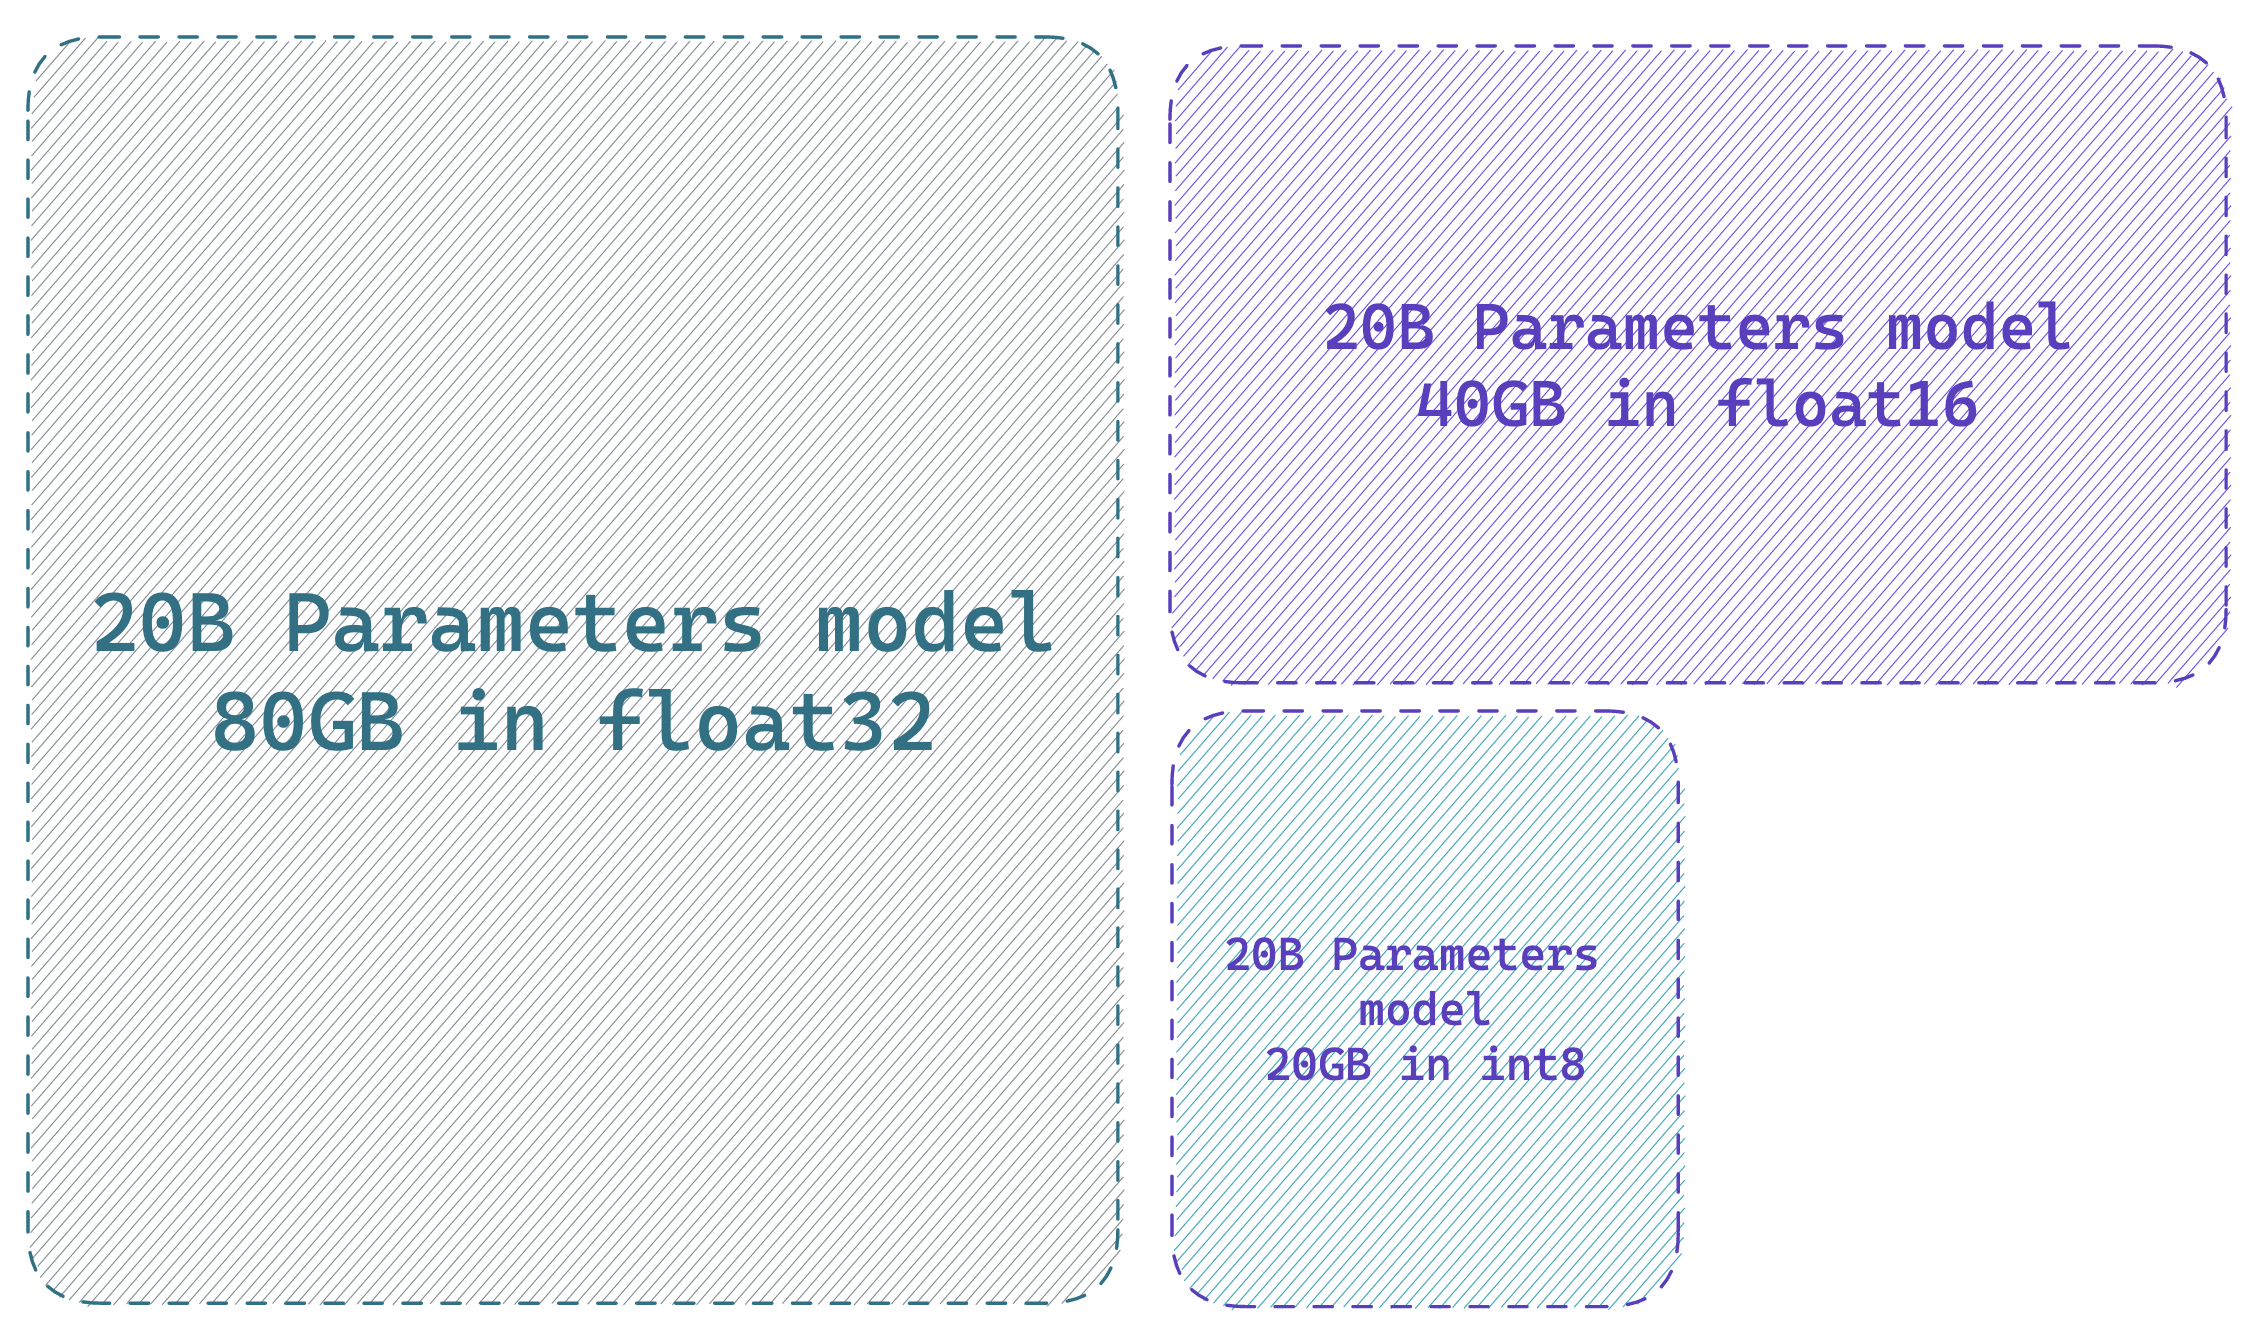
大規模訓練並不容易。第一個挑戰,是在可用的 GPU 裝置上容納模型及其最佳化器狀態。每個參數所需的 GPU 記憶體取決於其「精度」(更準確來説是 dtype)。最常見的 dtype 包括 float32(32 位元)、float16 和 bfloat16(16 位元)。近來,訓練和推論亦已支援某些「特殊」精度(但附帶特定條件和限制),例如 int8(8 位元)。簡單來説,要在 GPU 裝置載入模型,每十億個參數以 float32 精度計需要 4GB、以 float16 計需要 2GB、以 int8 計則需要 1GB。想深入瞭解這個主題,可以參閲這篇詳細介紹的網誌文章:https://huggingface.co/blog/hf-bitsandbytes-integration。
如果使用 AdamW 最佳化器,每個參數需要 8 bytes(例如模型有 1B 個參數,其完整 AdamW 最佳化器就需要 8GB GPU 記憶體;來源)。
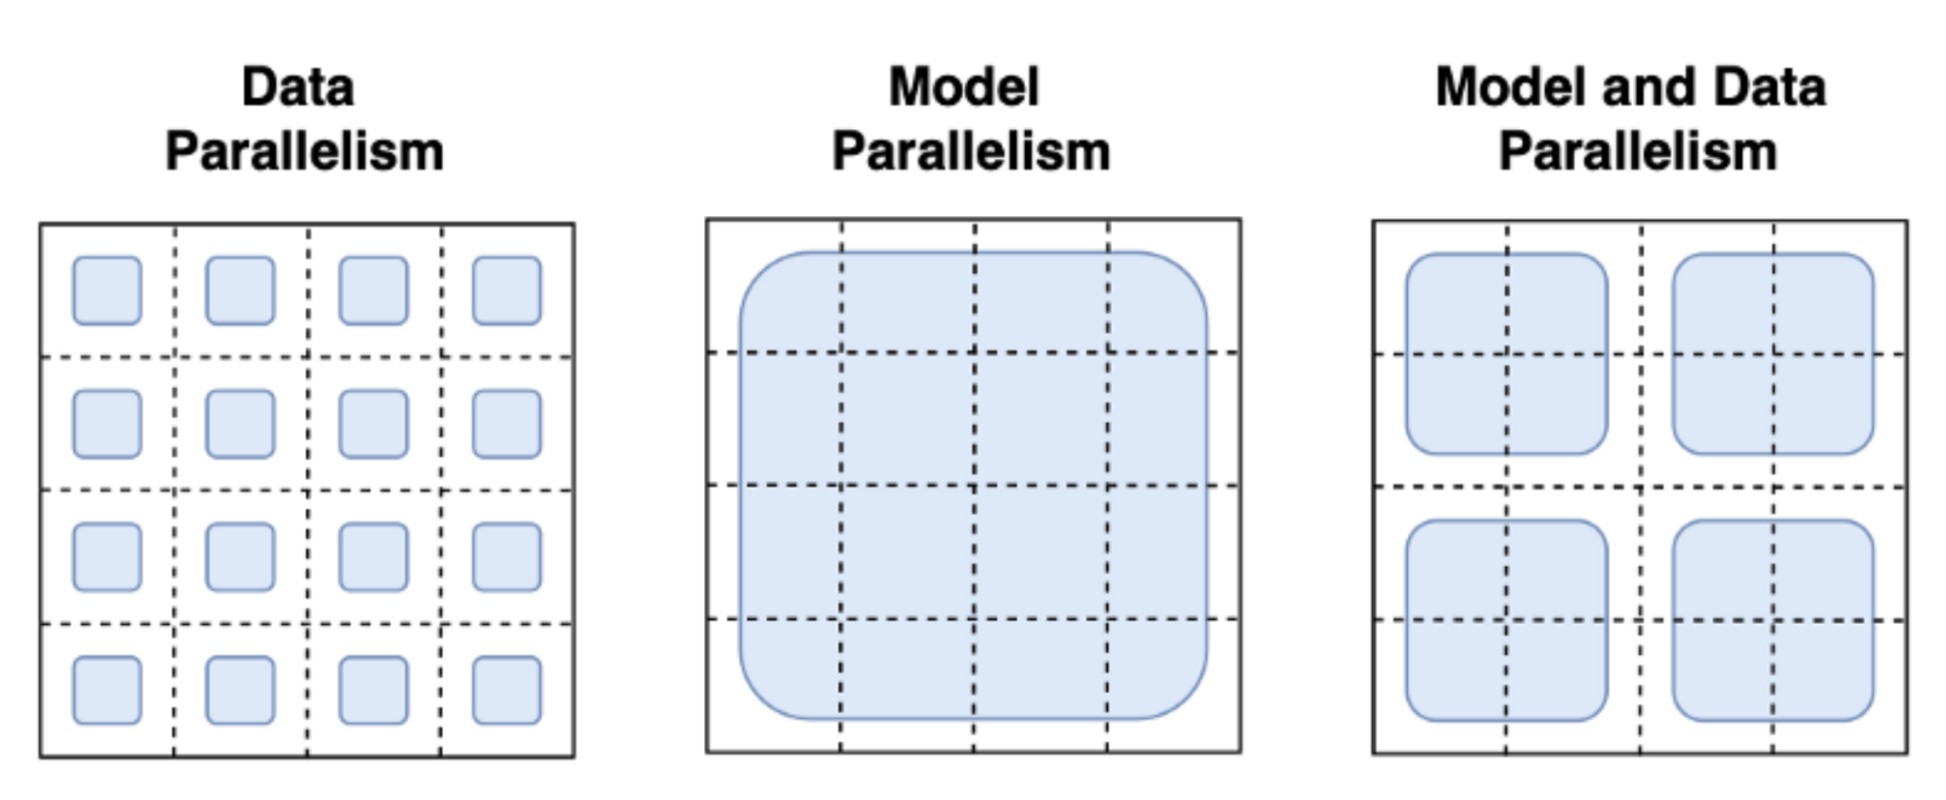
為了應對這些大規模訓練挑戰,人們採用了許多技術。最常見的範式包括流水線並行、張量並行和數據並行。
 |
|---|
| 圖片來源:這篇網誌文章 |
數據並行會在多部機器上平行託管同一個模型,並向每個模型實例輸入不同的數據批次。這是最直接的並行策略,本質上只是複製單 GPU 的情況,而且 trl 已支援這種做法。至於流水線並行和張量並行,則會把模型本身分散到多部機器:流水線並行按層拆分模型,而張量並行會把張量運算分配到多個 GPU(例如矩陣乘法)。採用這些模型並行策略時,必須把模型權重切分到多部裝置,並為各程序之間的啟動值和梯度定義通訊協定。這並非易事,或許需要採用 Megatron-DeepSpeed 或 Nemo 等框架。亦要指出,Adaptive activation checkpointing 和融合核心等其他工具,對擴展大型語言模型訓練同樣不可或缺。想進一步閲讀並行範式,可參閲此處。
因此,我們提出以下問題:單靠數據並行,我們可以做到甚麼程度?能否使用現有工具,在單一裝置上容納超大型訓練流程(包括正在訓練的模型、參考模型和最佳化器狀態)?答案似乎是可以。關鍵要素是:adapter 和 8 位元矩陣乘法!以下各節會逐一介紹:
8 位元矩陣乘法
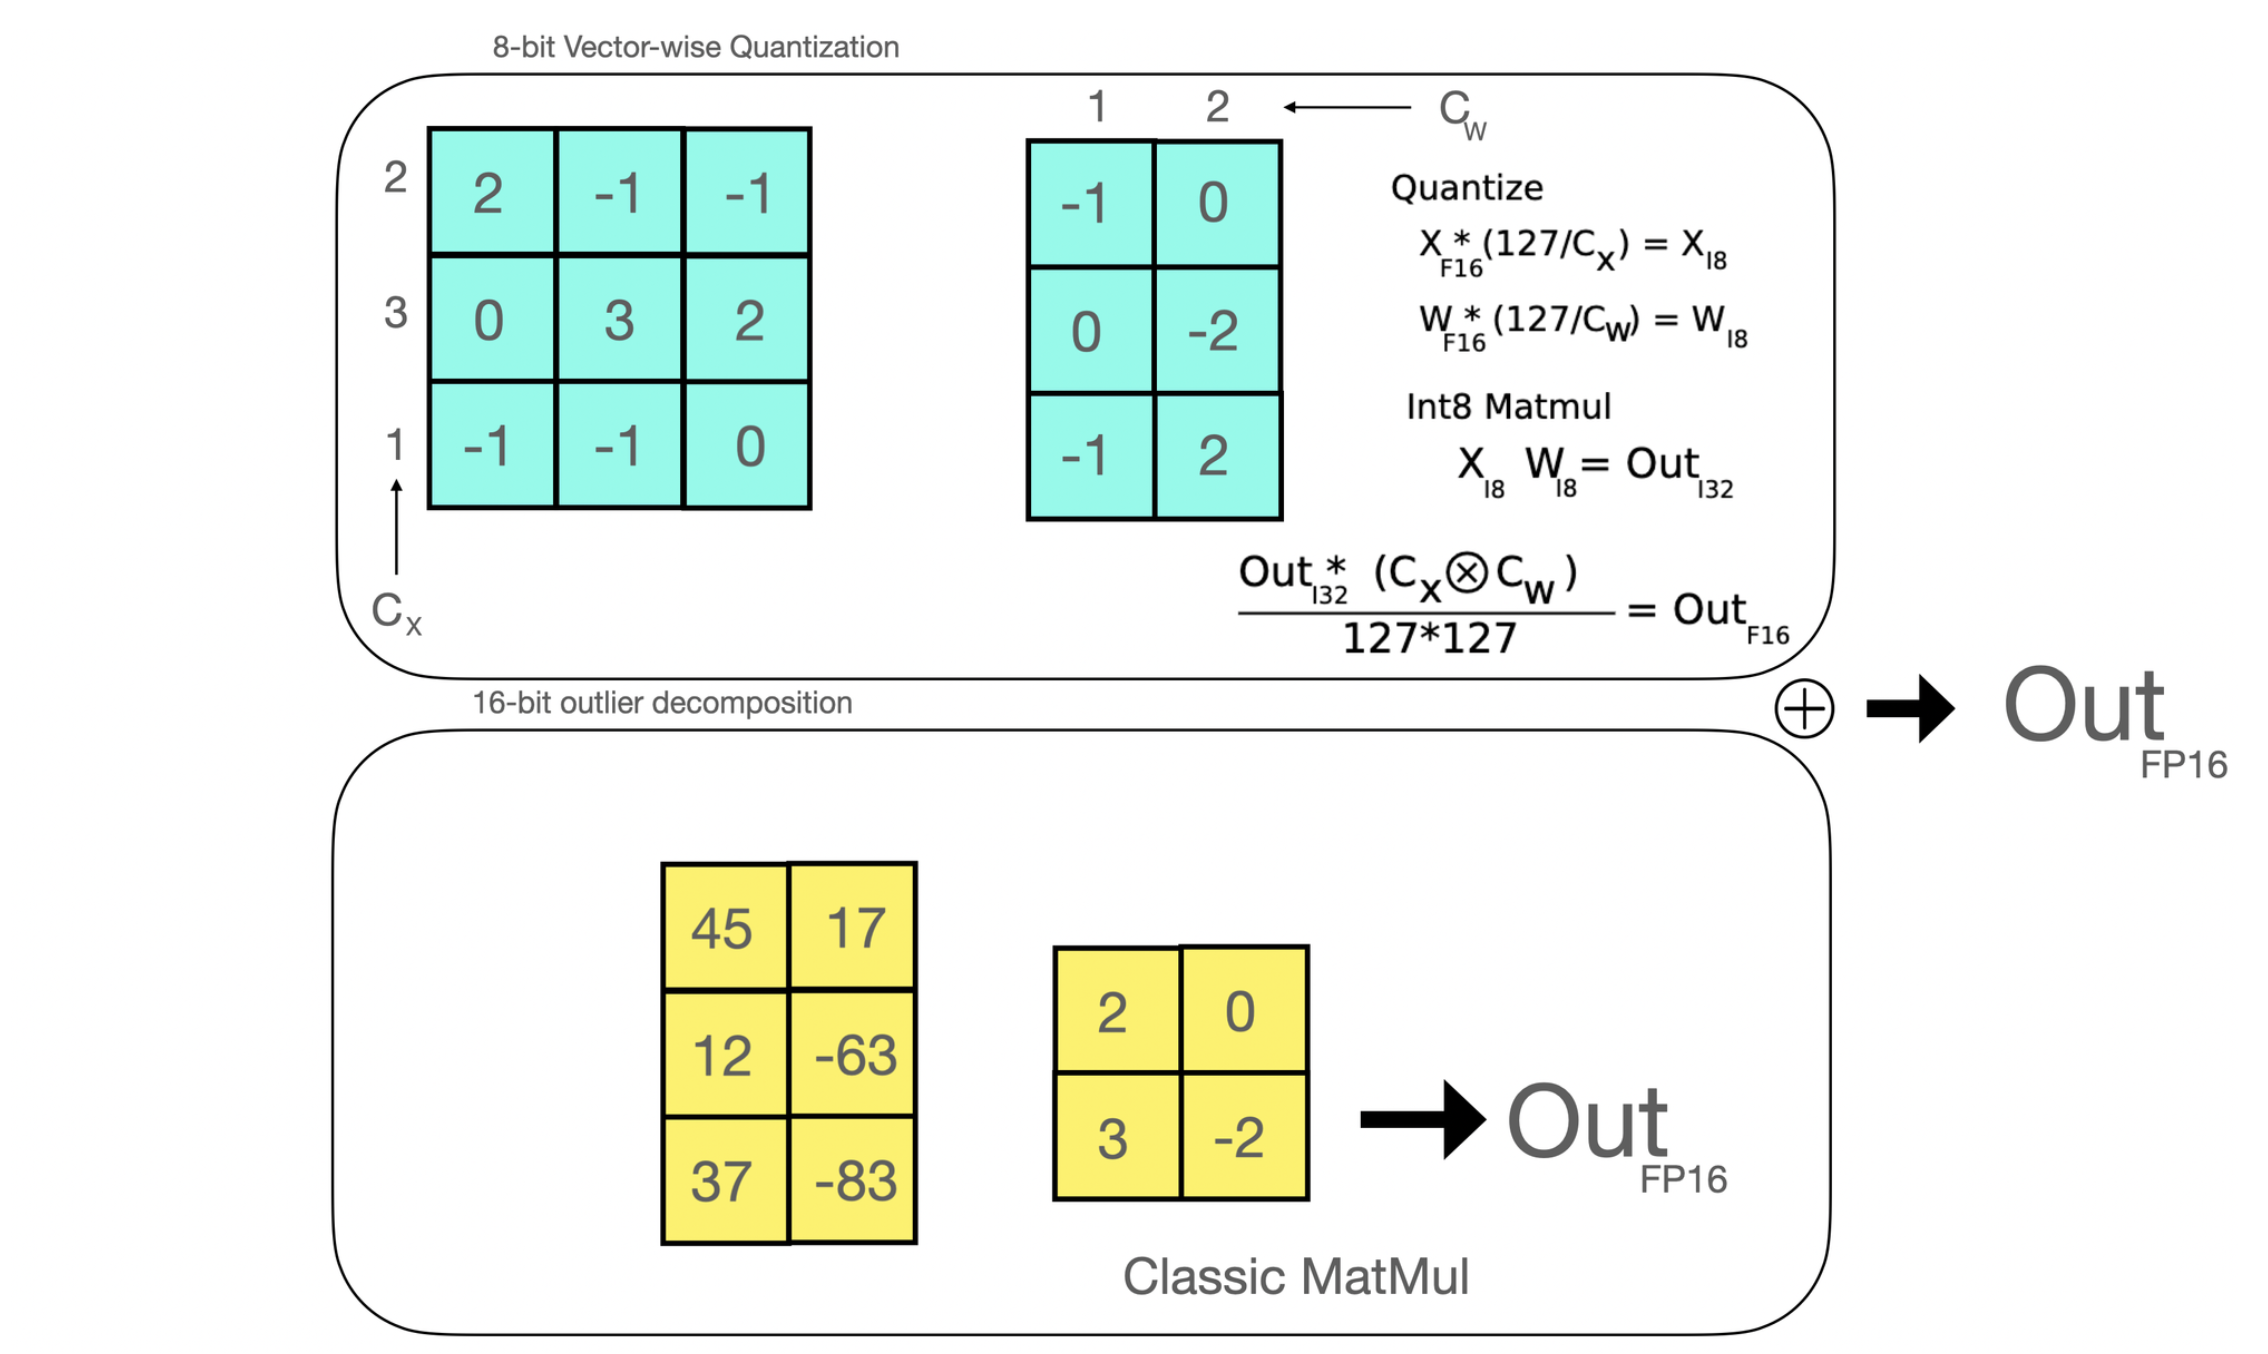
高效 8 位元矩陣乘法最初在 LLM.int8() 論文中提出,旨在解決量化大型模型時出現的效能下降問題。這種方法將線性層內部執行的矩陣乘法分成兩個階段:離羣的隱藏狀態部分以 float16 執行,而「非離羣」部分則以 int8 執行。
 |
|---|
| 高效 8 位元矩陣乘法最初在論文 LLM.int8() 中提出,旨在解決量化大型模型時出現的效能下降問題。這種方法將線性層內部執行的矩陣乘法分成兩個階段:離羣的隱藏狀態部分以 float16 執行,而「非離羣」部分則以 int8 執行。 |
簡單來説,使用 8 位元矩陣乘法,可以把全精度模型的大小縮小 4 倍(半精度模型則縮小 2 倍)。
低秩適配和 PEFT
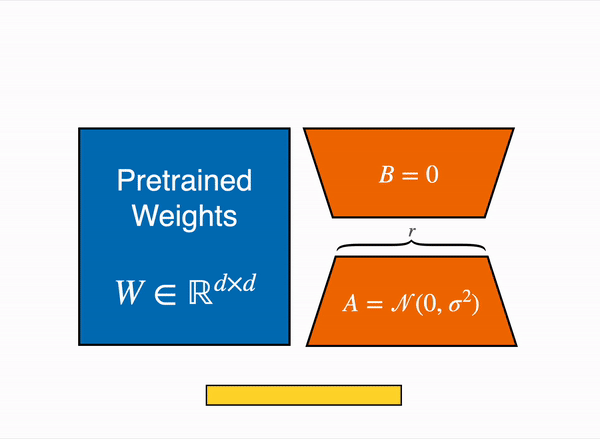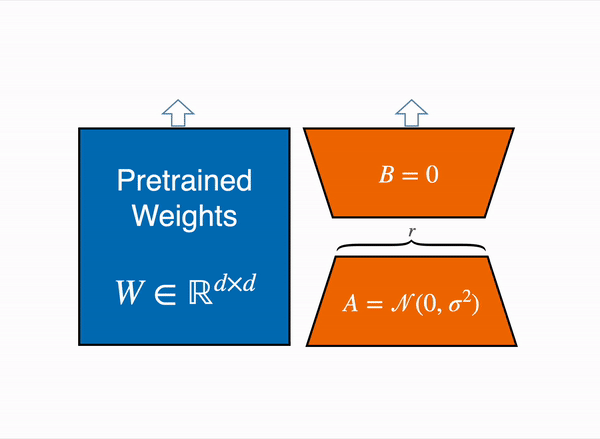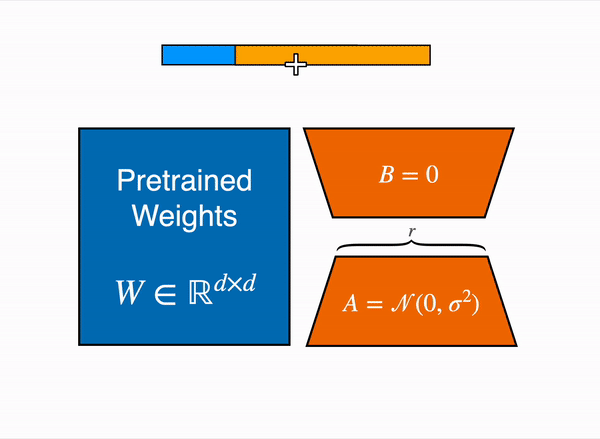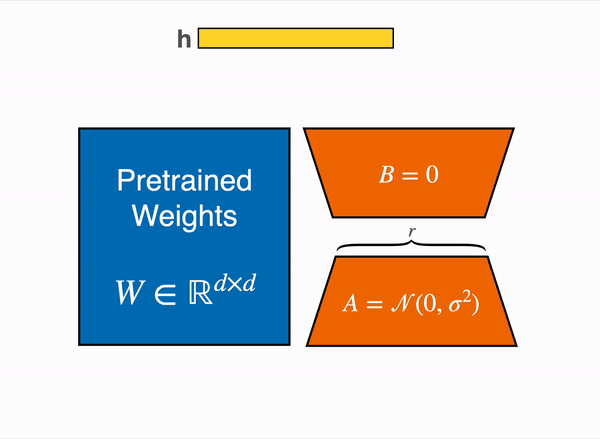
2021 年發表的一篇論文《LoRA: Low-Rank Adaption of Large Language Models》指出,可以凍結預訓練權重,並為注意力機制中的 query 和 value 層矩陣建立低秩版本,藉此微調大型語言模型。這些低秩矩陣的參數遠少於原始模型,因此能大幅減少微調所需的 GPU 記憶體。作者展示,微調低秩 adapter 的效果與微調完整預訓練模型相若。
 |
|---|
| 原本(凍結)的預訓練權重輸出啟動值(左),會由包含權重矩陣 A 和 B 的低秩 adapter 加強(右)。 |
這項技術讓微調大型語言模型只需佔用一小部分記憶體。不過,它亦有一些缺點:由於 adapter 層要額外執行矩陣乘法,前向和反向傳遞大約會慢一倍。
甚麼是 PEFT?
Parameter-Efficient Fine-Tuning(PEFT) 是 Hugging Face 推出的程式庫,旨在支援大型語言模型 adapter 層的建立和微調。peft 可與 🤗 Accelerate 無縫整合,利用 DeepSpeed 和 Big Model Inference 處理大型模型。
這個程式庫支援許多最先進的模型,並提供大量範例,包括:
- 因果語言建模
- 條件式生成
- 圖像分類
- 8 位元 int8 訓練
- Dreambooth 模型的低秩適配
- 語意分割
- 序列分類
- token 分類
這個程式庫仍在積極開發,未來數月將陸續公佈多項新功能。
使用低秩 adapter 微調 20B 參數模型
前置知識介紹完畢,接下來讓我們逐步走完整個流程,並以圖示説明如何使用以上工具,在單一 24GB GPU 上透過強化學習微調一個 20B 參數的大型語言模型!
步驟 1:以 8 位元精度載入正在訓練的模型
 |
|---|
| 以 8 位元精度載入模型,最多可節省 4 倍記憶體,相較於全精度模型 |
使用 transformers 載入大型語言模型時,一種「免費午餐」式的記憶體縮減方法,是按照 LLM.int8 中介紹的方法,以 8 位元精度載入模型。只要加入 load_in_8bit=True 旗標,再呼叫 from_pretrained 方法即可(詳情可參閲此處)。
如上一節所述,估算載入模型所需 GPU 記憶體的一個「竅門」,是按「十億個參數」計算。由於一個 byte 等於 8 bits,全精度模型每十億個參數需要 4GB(32bit = 4bytes),半精度模型每十億個參數需要 2GB,而 int8 模型每十億個參數則需要 1GB。
首先,讓我們以 8 位元精度載入正在訓練的模型。接下來看看第二步要做甚麼!
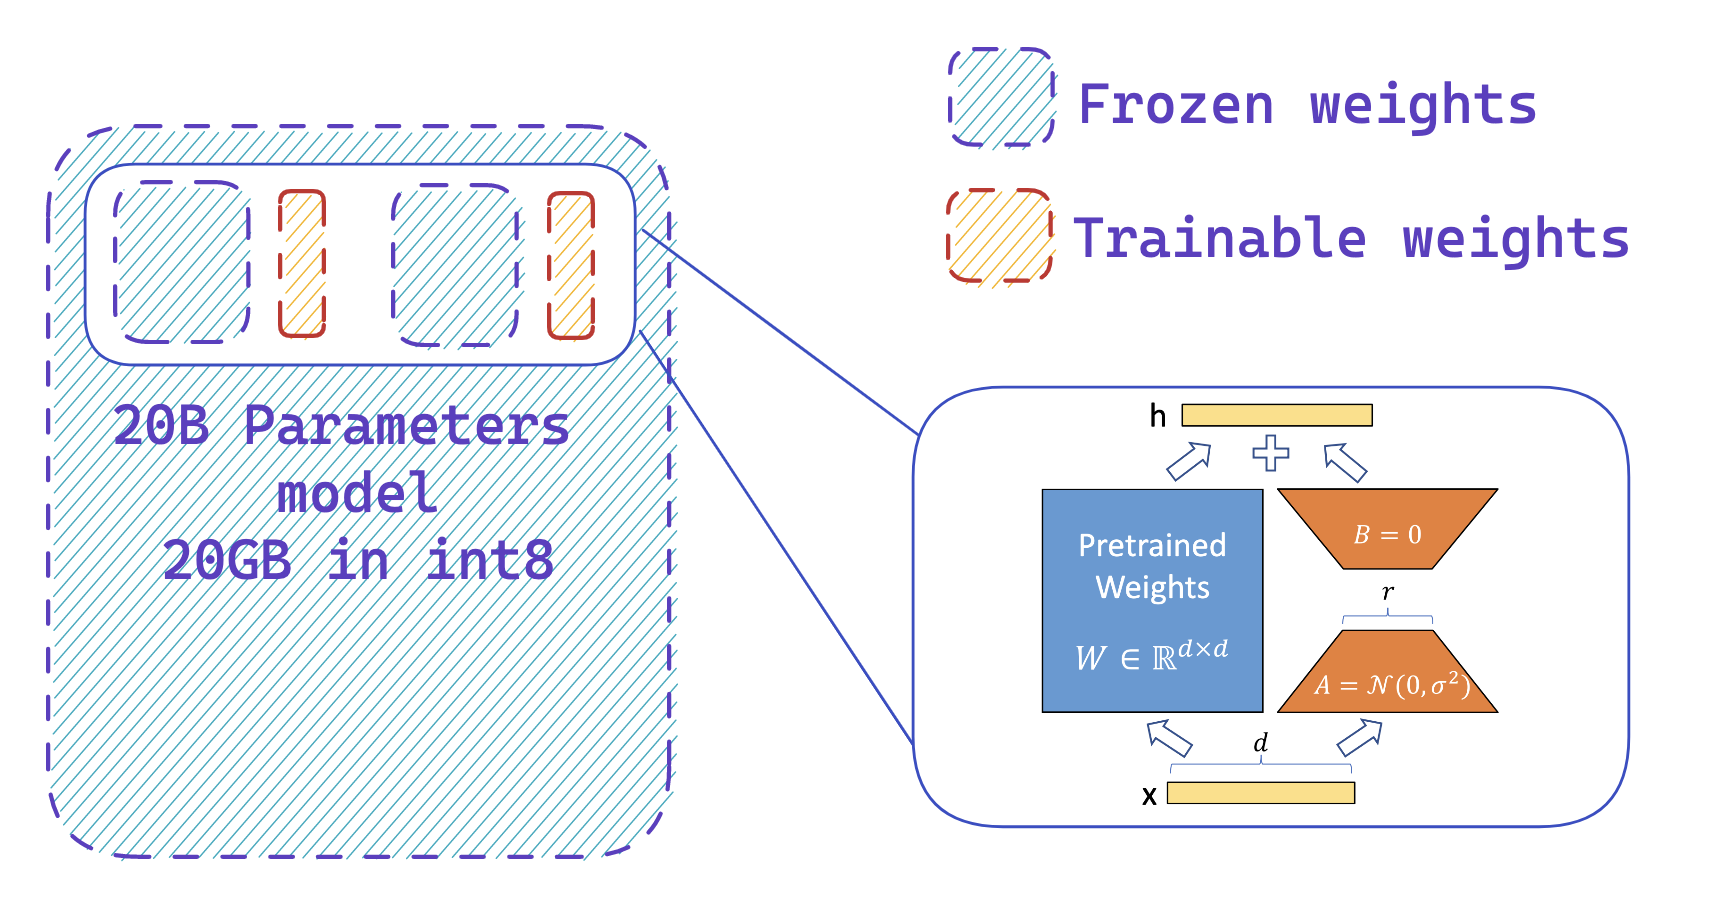
步驟 2:使用 peft 加入額外的可訓練 adapter
 |
|---|
| 你可以輕鬆地在凍結的 8 位元模型上加入 adapter;透過只訓練一小部分參數,減少最佳化器狀態所需的記憶體 |
第二步是在模型中載入 adapter,並把它們設為可訓練。這能大幅減少正在訓練的模型所需的可訓練權重數目。此步驟使用 peft 程式庫,只需幾行程式碼即可完成。訓練好 adapter 後,你亦可以輕鬆將它們推送至 Hub,以便日後使用。
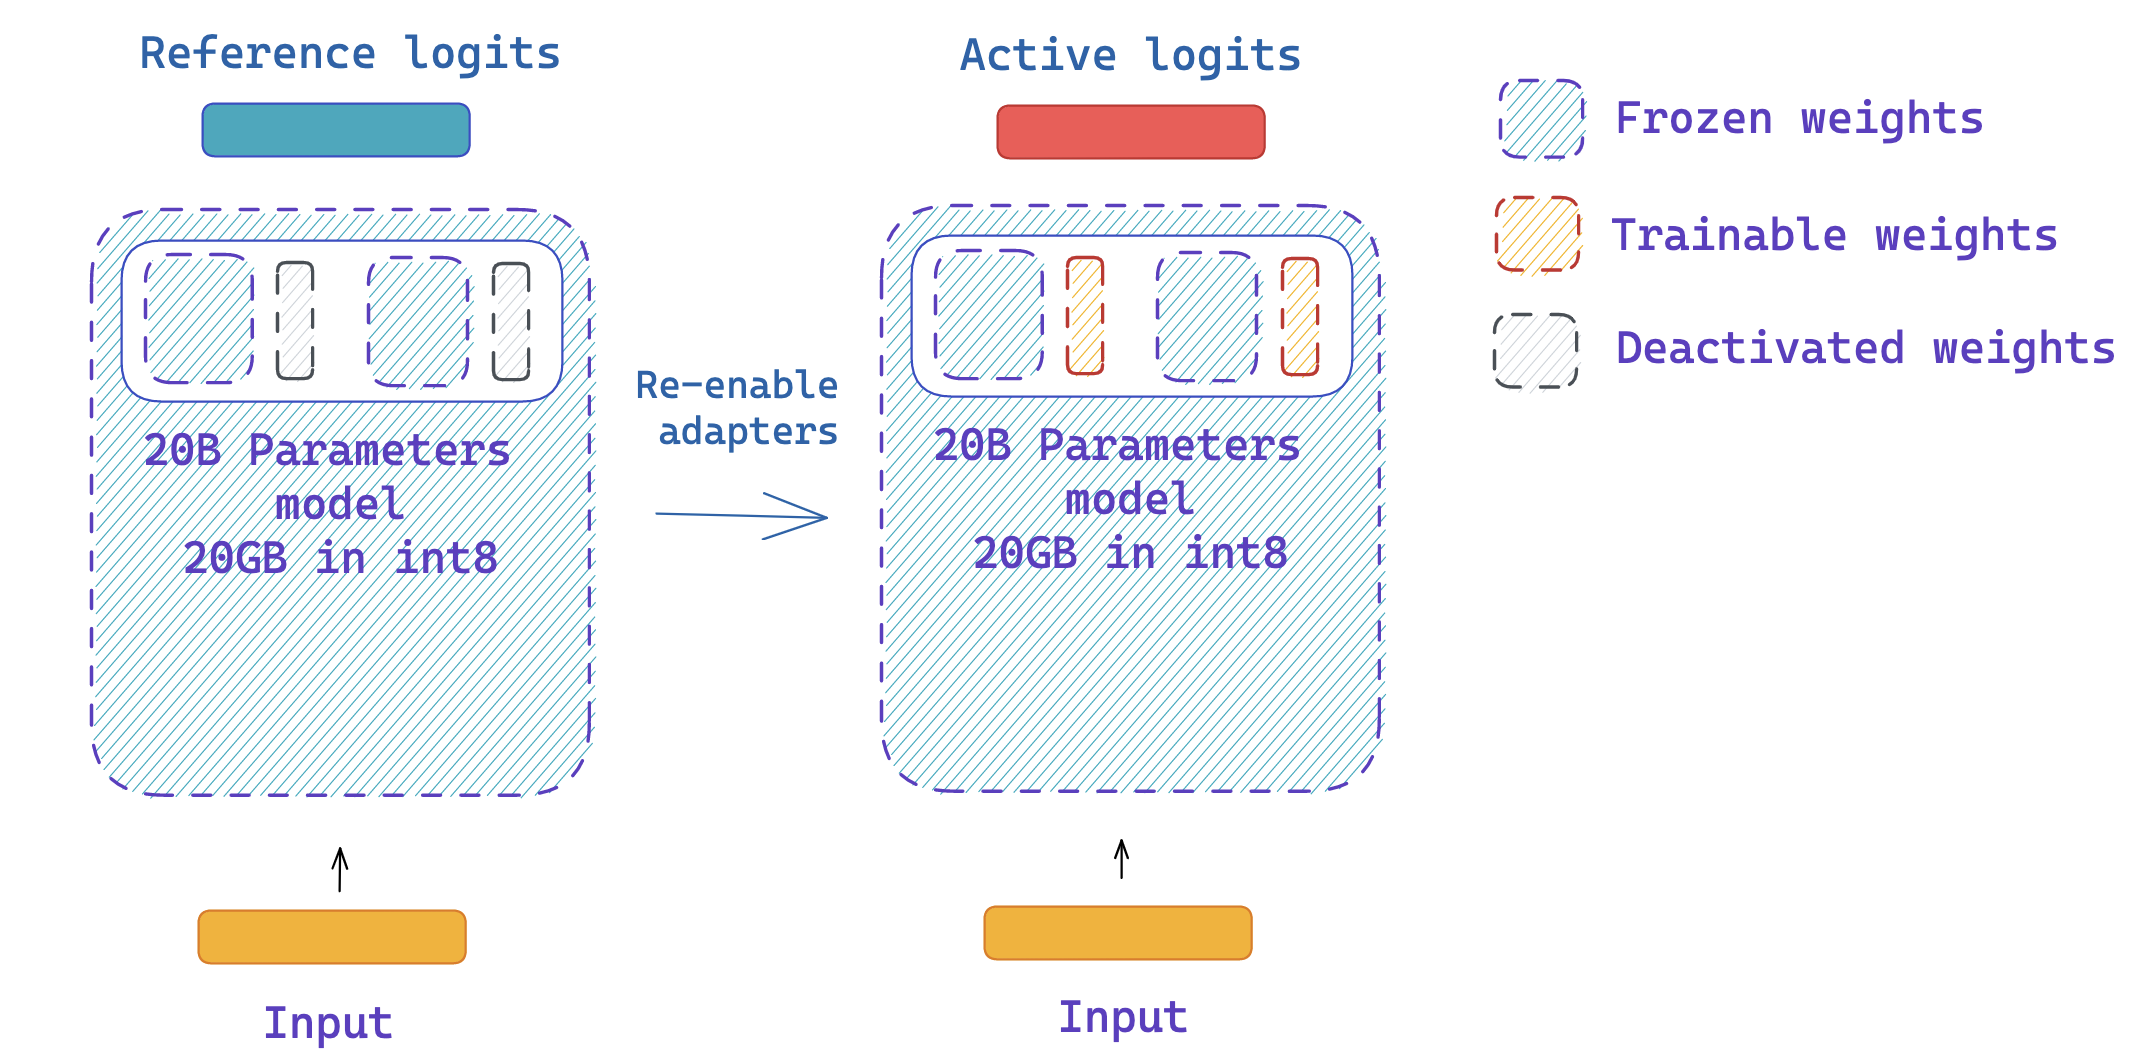
步驟 3:使用同一模型取得參考及正在訓練模型的 logits
 |
|---|
你可以透過 peft API 輕鬆停用和啟用 adapter。 |
由於可以停用 adapter,我們可以使用同一模型取得 PPO 所需的參考 logits 和正在訓練模型的 logits,無須建立兩個相同模型的副本!這是利用 peft 程式庫中的 disable_adapters context manager 實現。
訓練指令碼概覽:
接下來,我們會介紹如何使用 gpt-neox 模型,並透過 transformers、peft 和 trl 訓練一個 20B 參數模型。這個例子的最終目標,是在記憶體受限的設定下微調大型語言模型,以生成正面的電影評論。類似步驟亦可應用於對話模型等其他任務。
整個流程主要分為三個步驟和訓練指令碼:
- 指令碼 - 在凍結的 8 位元模型上微調低秩 adapter,以便在 imdb 數據集上進行文本生成。
- 指令碼 - 將 adapter 層合併至基礎模型權重,並儲存至 Hub。
- 指令碼 - 微調低秩 adapter,以生成正面評論。
我們在 24GB NVIDIA 4090 GPU 上測試了這些步驟。雖然可在 24 GB GPU 上完成整個訓練流程,但完整訓練是在 🤗 research cluster 的單一 A100 上執行。
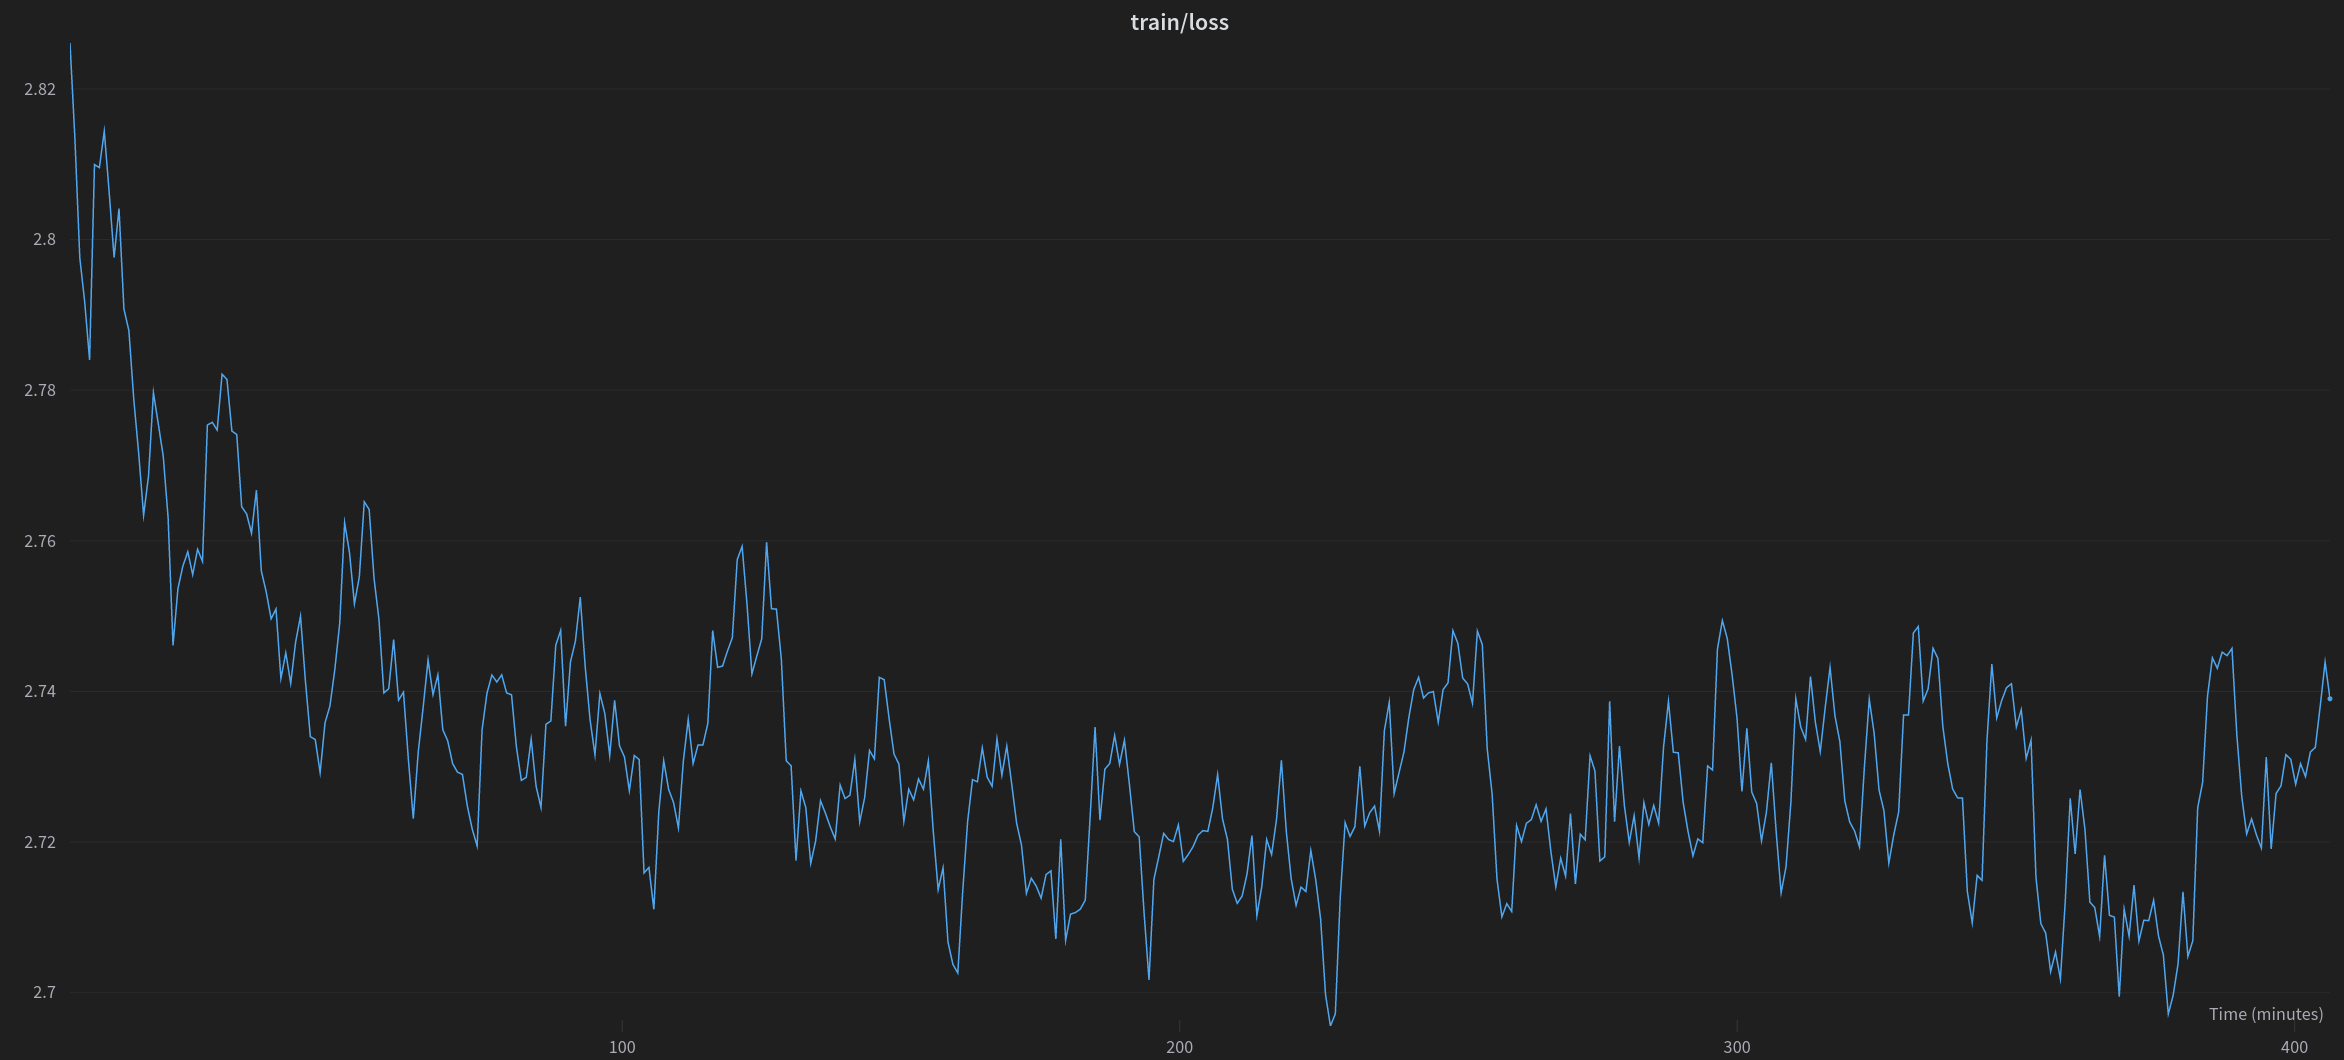
訓練流程的第一步,是在預訓練模型上進行微調。一般而言,這需要數部高階 80GB A100 GPU,因此我們選擇訓練低秩 adapter。我們採用因果語言建模設定,並使用 imdb 數據集中的例子訓練一個 epoch;該數據集包含電影評論,以及代表正面或負面情緒的標籤。
 |
|---|
| 在 imdb 數據集上以 gpt-neox-20b 模型訓練一個 epoch 的訓練損失 |
要使用 adapter 微調後的模型進一步進行強化學習微調,我們首先需要合併已調整的權重;做法是載入預訓練模型和 adapter,以 16 位元浮點格式及權重矩陣摘要載入(並套用適當的縮放)。
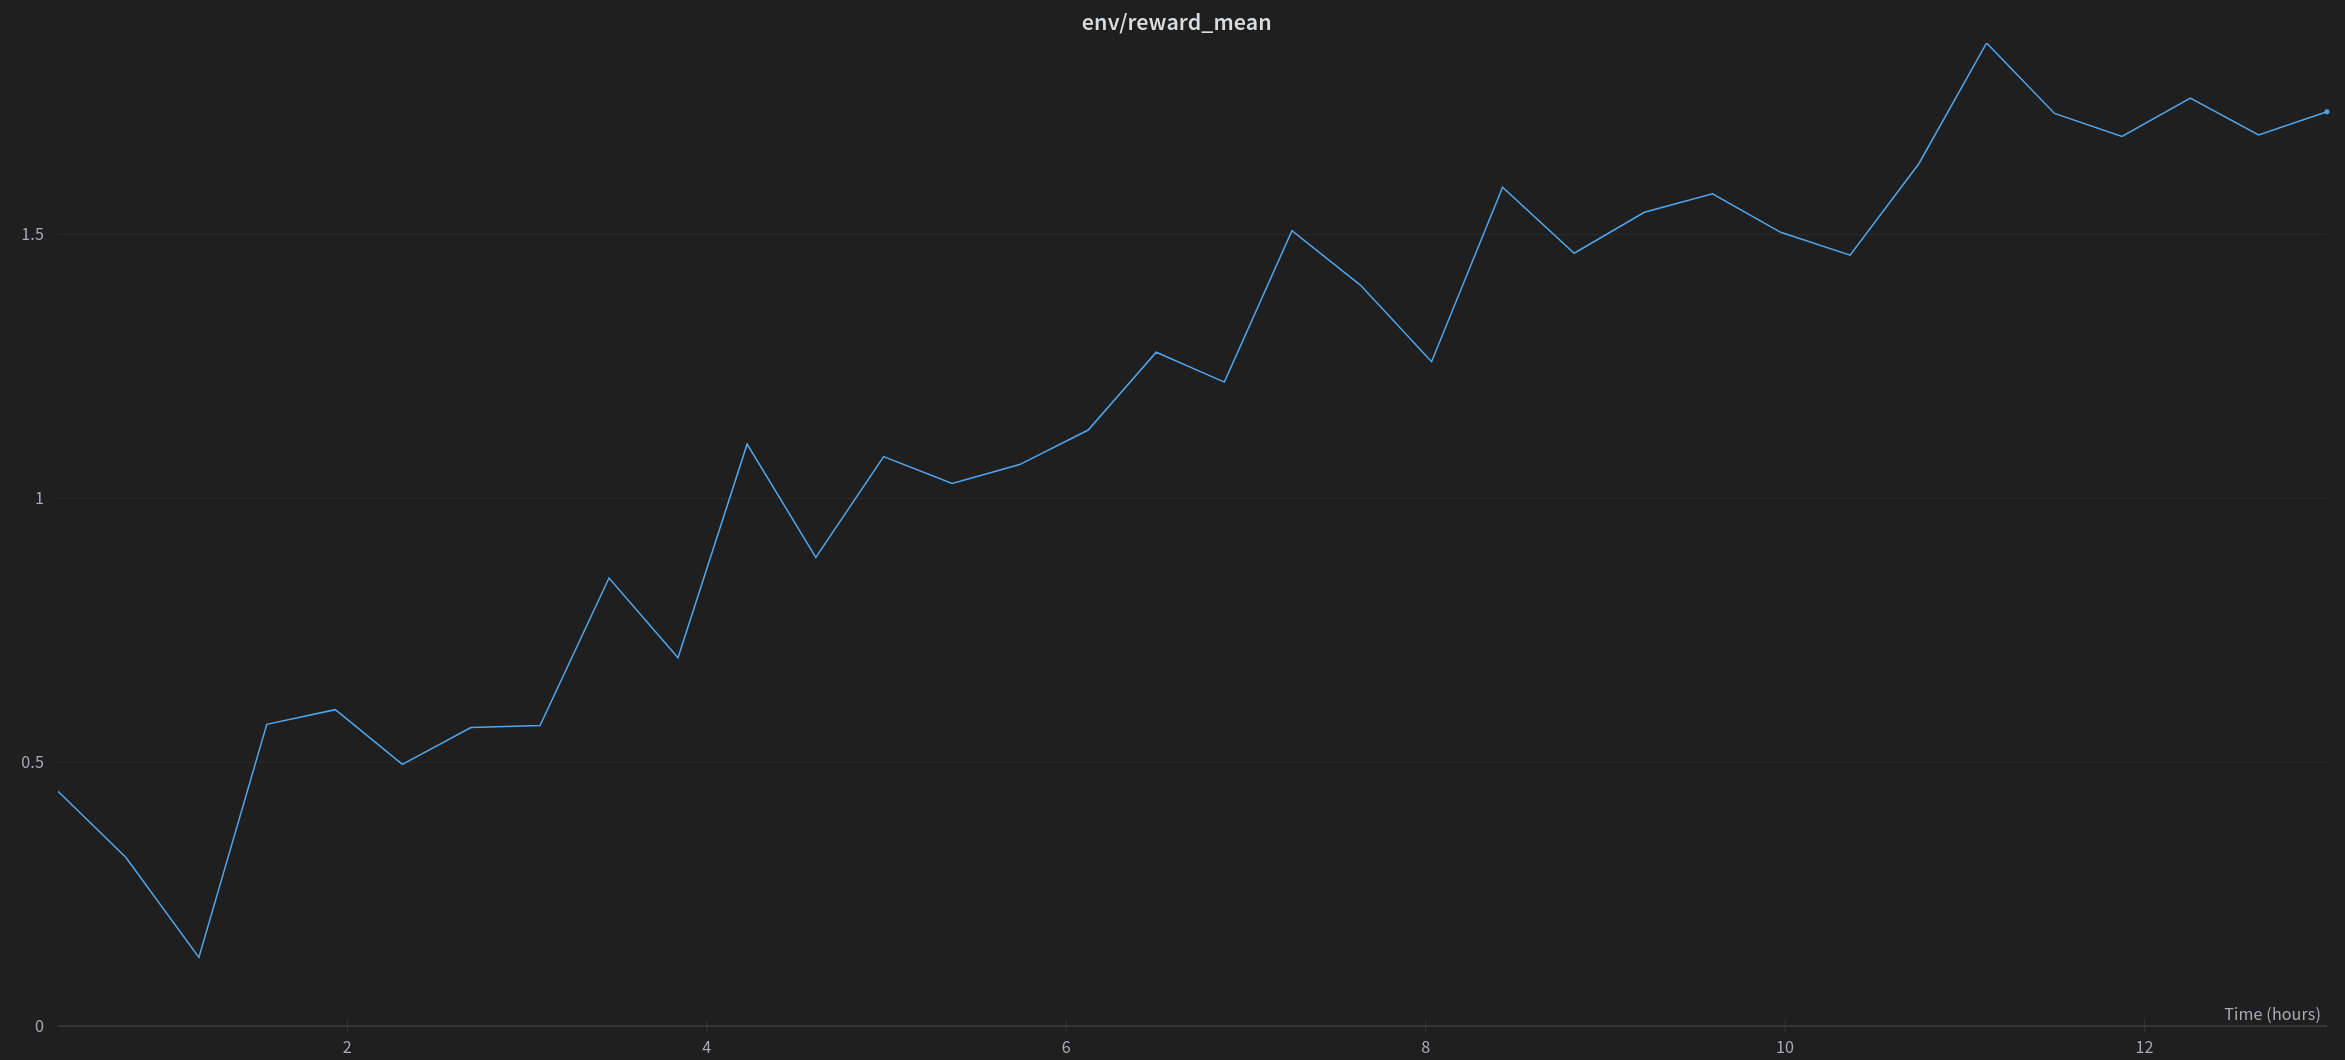
最後,我們可以在凍結的 imdb 微調模型上,再微調另一個低秩 adapter。我們使用 imdb 情緒分類器,為強化學習演算法提供獎勵。
 |
|---|
| 使用強化學習微調經 peft adapter 調整的 20B 參數模型,以生成正面電影評論時的平均獎勵。 |
這項實驗的完整 Weights and Biases 報告可在此查看,當中有更多圖表和文本生成結果。
總結
我們已在 trl 中實作新功能,讓用戶可以透過 peft 和 bitsandbytes 程式庫,以合理成本使用 RLHF 微調大型語言模型。我們展示了在 24GB 消費級 GPU 上微調 gpt-neo-x(以 bfloat16 計為 40GB!)是可行的,並預期社羣會廣泛採用這種整合,運用 RLHF 微調更大的模型並分享優質成果。
我們已找出一些值得探索的方向,讓這項整合在下一步突破更多限制
- 這種方法如何擴展至多 GPU 設定? 我們主要會探討這項整合如何隨 GPU 數目增加而擴展,以及能否直接採用數據並行,還是需要在相關程式庫中加入新功能。
- 可以運用哪些工具提升訓練速度? 我們觀察到,這項整合的主要缺點是整體訓練速度。未來我們希望探索各種可大幅加快訓練的方法。
參考資料
- 並行範式:https://huggingface.co/docs/transformers/v4.17.0/en/parallelism
transformers中的 8 位元整合:https://huggingface.co/blog/hf-bitsandbytes-integration- LLM.int8 論文:https://arxiv.org/abs/2208.07339
- Gradient checkpointing 説明:https://docs.aws.amazon.com/sagemaker/latest/dg/model-parallel-extended-features-pytorch-activation-checkpointing.html
來源:Hugging Face Blog · huggingface.co