如何使用 diffusers 訓練 ControlNet
Train your ControlNet with diffusers
Hugging Face Blog 示範使用 diffusers 為 Stable Diffusion 訓練 ControlNet,並以 FaceSynthetics 的 100K 張合成臉製作人臉姿勢條件資料。
文章以 FaceSynthetics 示範從人臉關鍵點製作 ControlNet 條件圖、整理訓練資料到配置低顯存參數的流程,可供類似訓練任務參照。
簡介
ControlNet 是一種神經網絡結構,透過加入額外條件,讓擴散模型能接受精細控制。這項技術最初見於論文《為文字生成影像擴散模型加入條件控制》;開源社羣隨即發布了 8 種條件控制 Stable Diffusion v1-5,包括姿勢估算、深度圖、Canny 邊緣、草圖,以及更多功能。
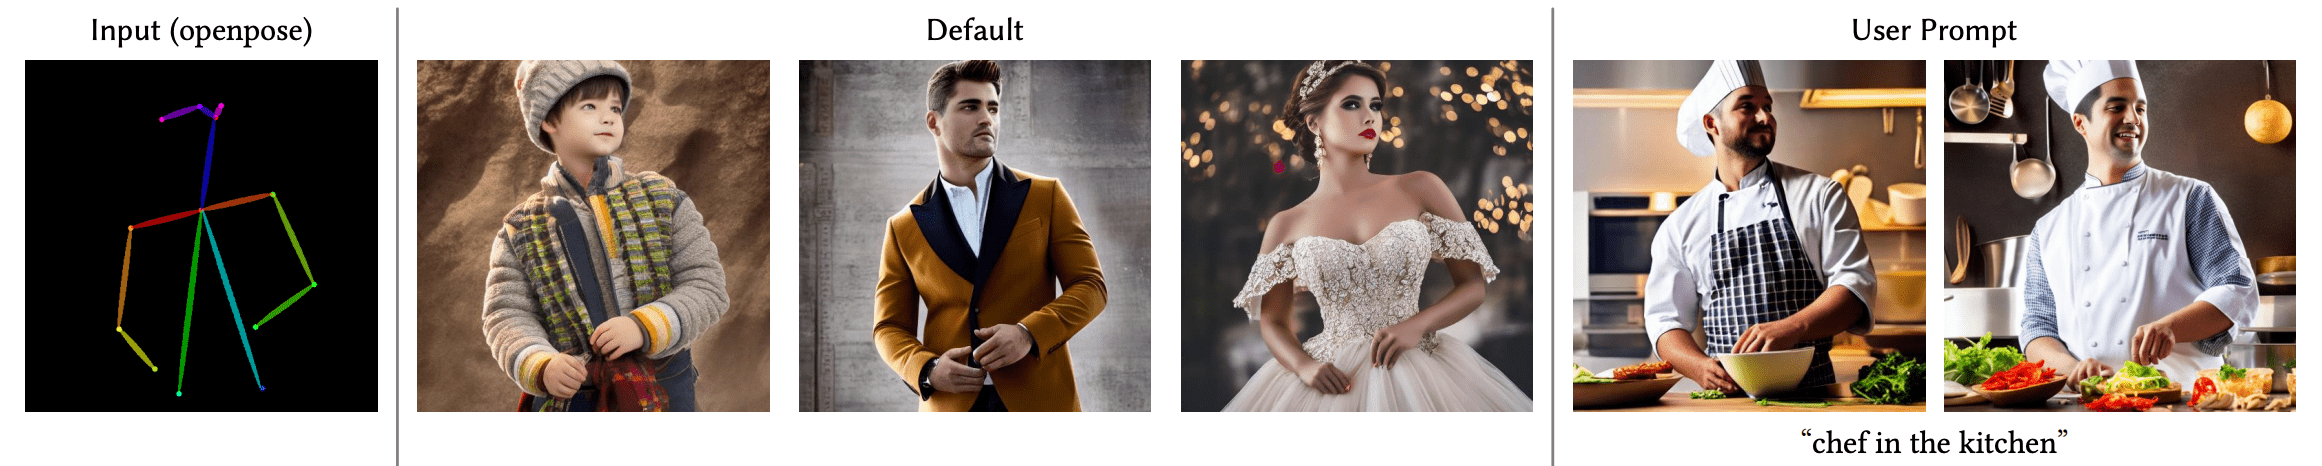
本文會逐步詳述我們如何訓練詭異人臉模型——這是一個以 3D 合成人臉為基礎的人臉姿勢模型(詭異人臉其實是意料之外的結果,留意後文了解箇中由來)。
開始訓練 Stable Diffusion ControlNet
訓練自己的 ControlNet 需要 3 個步驟:
規劃條件:ControlNet 靈活度高,可引導 Stable Diffusion 執行多種任務。預訓練模型展示了各種條件,社羣亦建立了其他方案,例如使用像素化調色盤作為條件。
建立資料集:決定條件後,就要建立資料集。你可以從零開始整理,也可以選用現有資料集的子集。訓練模型需要資料集包含三個欄位:真值
image、conditioning_image及prompt。訓練模型:準備好資料集後,就可以開始訓練。由於有diffusers 訓練指令碼協助,這是最簡單的一步。你需要一張至少有 8GB VRAM 的 GPU。
1. 規劃條件
規劃條件時,可以先思考以下兩個問題:
- 我想使用哪一類條件?
- 是否已有模型能把「一般」影像轉換成我需要的條件?
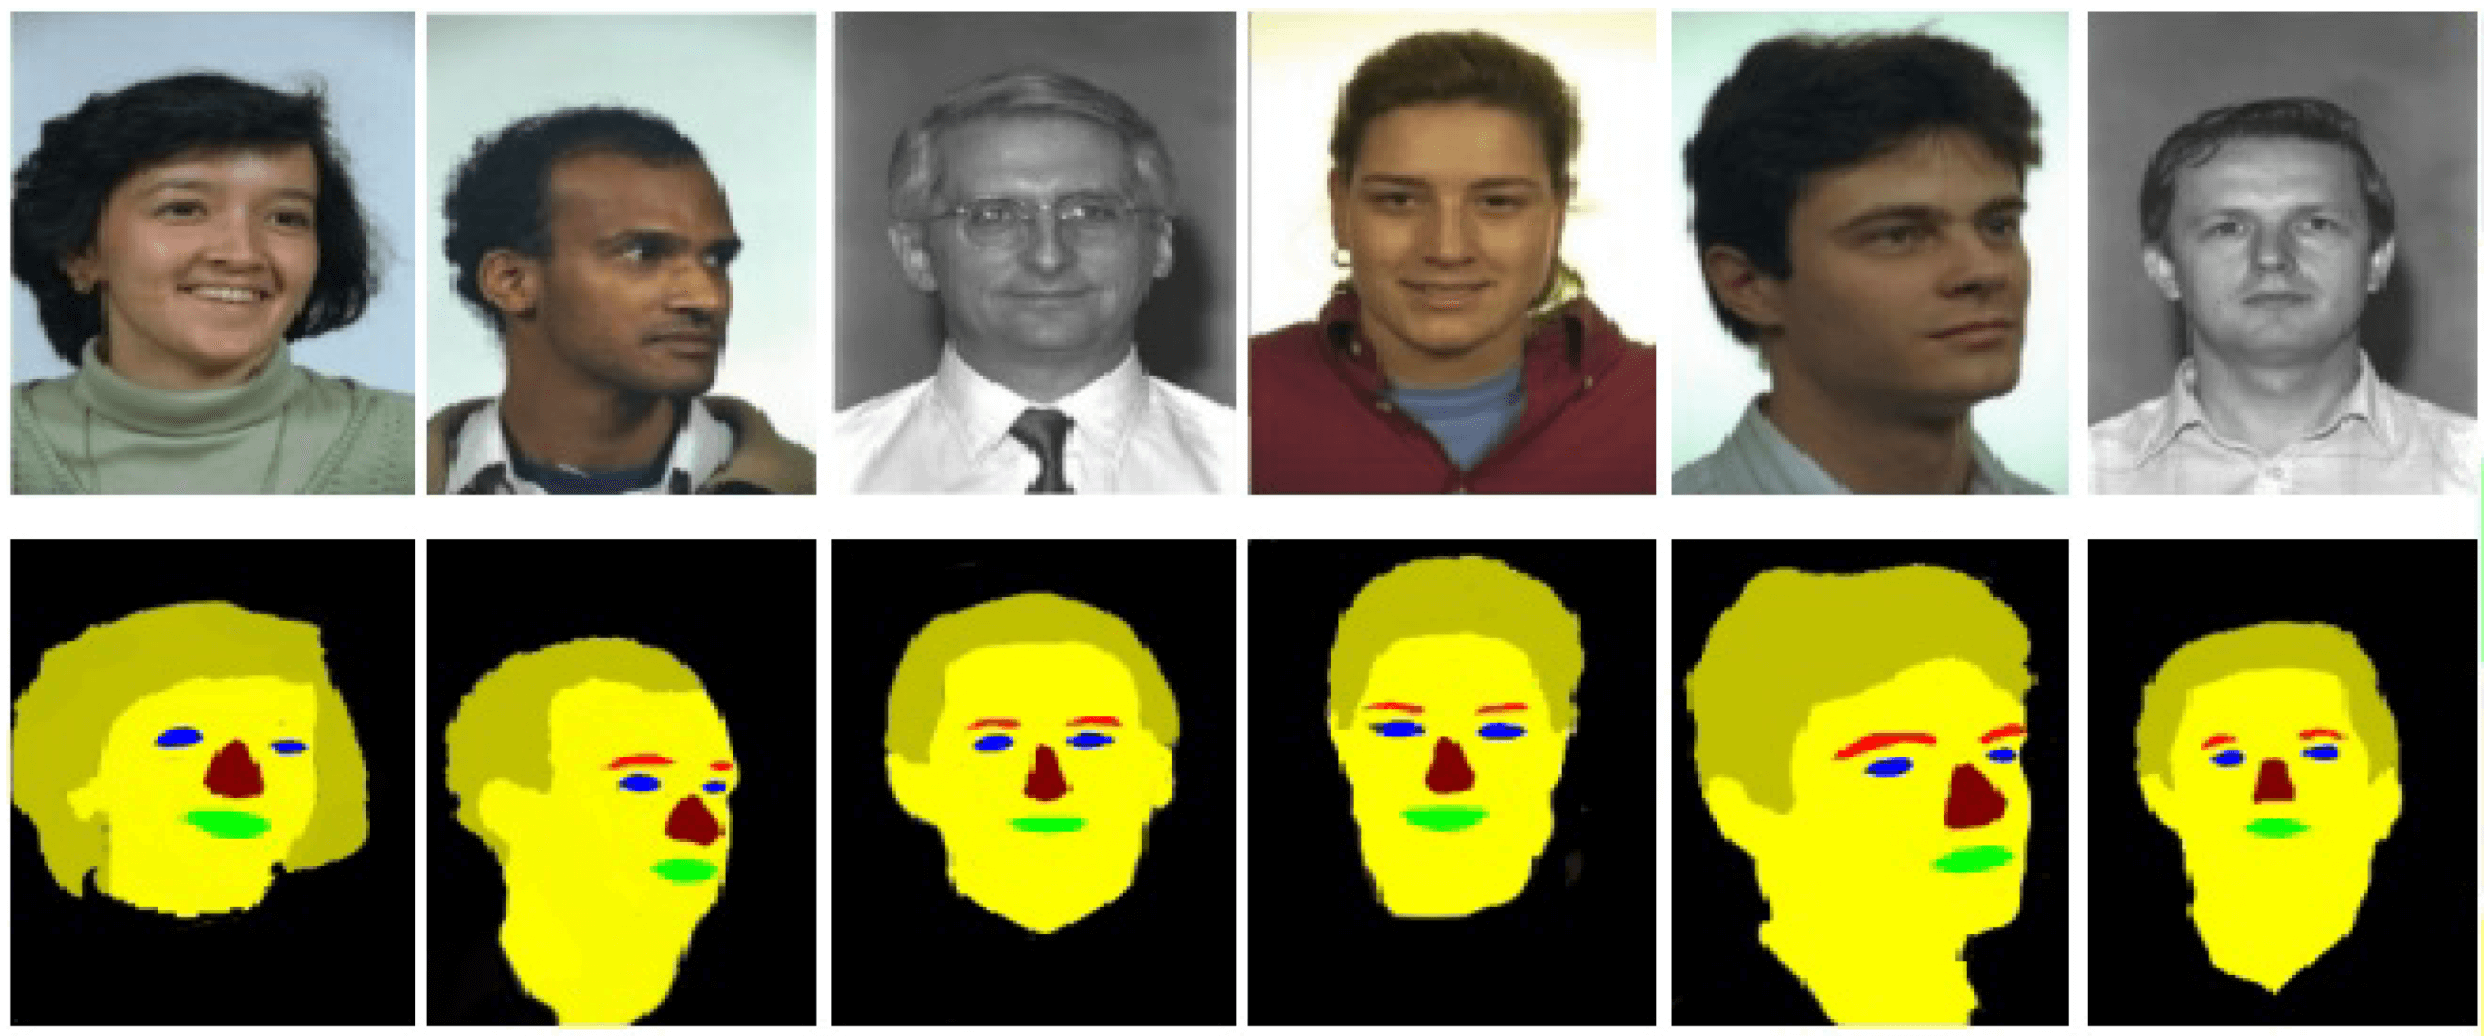
以我們的例子來説,我們考慮使用人臉地標作為條件,理由如下:1. 以一般地標作為條件的 ControlNet 效果良好。2. 人臉地標是相當普遍的技術,而且有多個模型能從一般圖片計算人臉地標。3. 引導 Stable Diffusion 遵循指定的人臉地標,或模仿自己的表情,應該會很有趣。
2. 建立資料集
好!我們決定使用人臉地標作為 Stable Diffusion 的條件。因此,準備資料集時需要:
- 真值
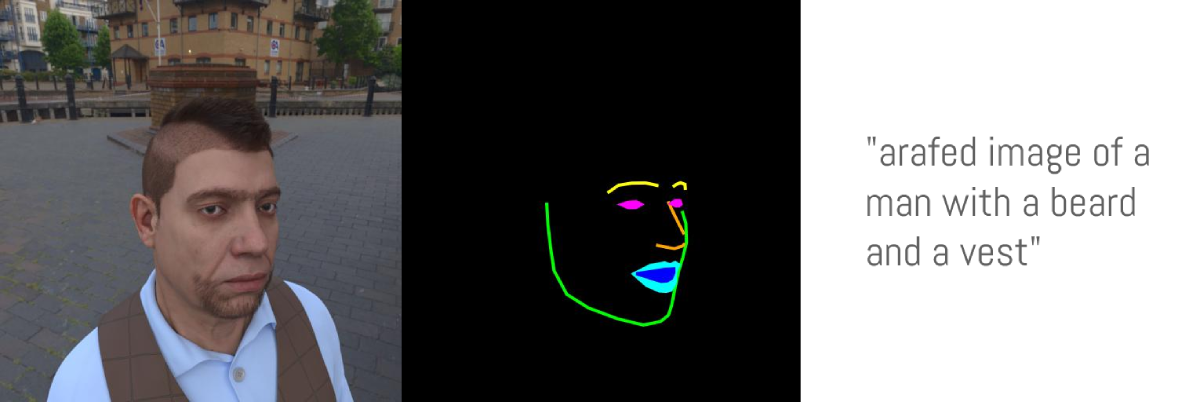
image:在這個例子中,就是人臉圖片 conditioning_image:在這個例子中,就是顯示人臉地標的圖片caption:描述所用圖片的文字説明
這個項目選用 Microsoft 的 FaceSynthetics 資料集,其中包含 100K 張合成人臉。其他研究人臉的資料集則使用真實人臉,例如 Celeb-A HQ、FFHQ——不過這次我們決定使用合成人臉。
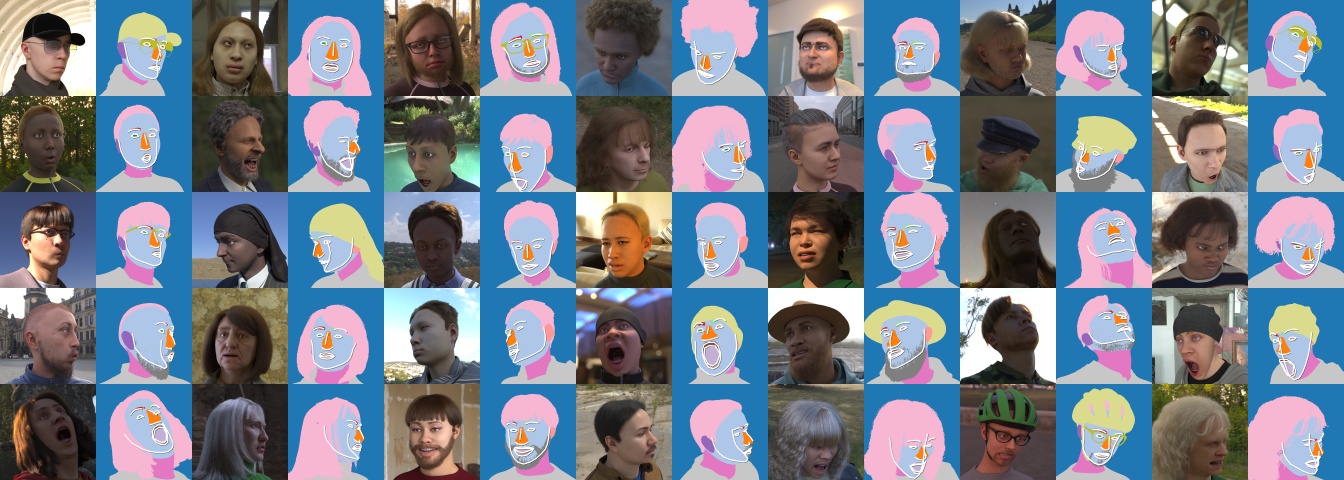
FaceSynthetics 資料集看來是個很好的起點:它包含人臉真值圖片、以 iBUG 68 點人臉地標格式標註的人臉地標,以及人臉分割圖片。
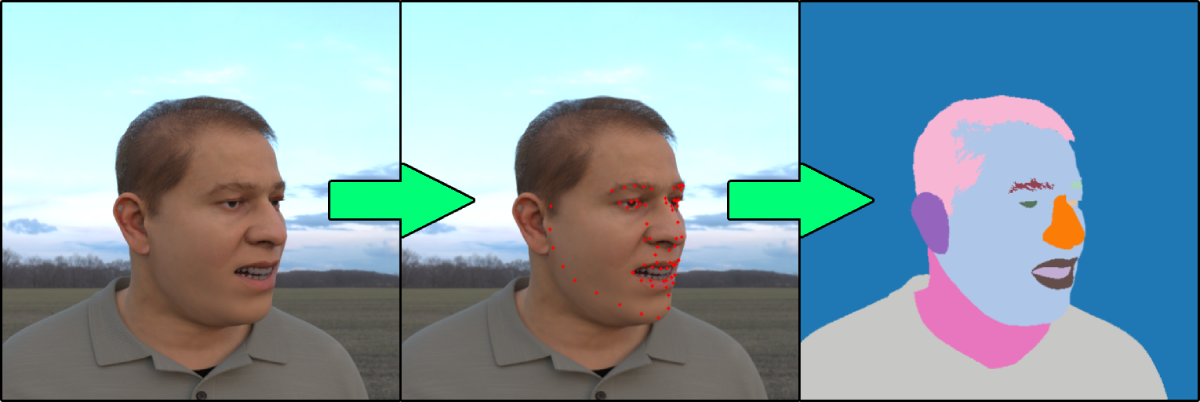
聽起來很完美,對吧?可惜並非如此。還記得「規劃條件」步驟中的第二個問題嗎?我們需要有模型能把一般圖片轉換為條件格式。結果發現,沒有已知模型能把人臉轉換成此資料集所用的已標註地標格式。
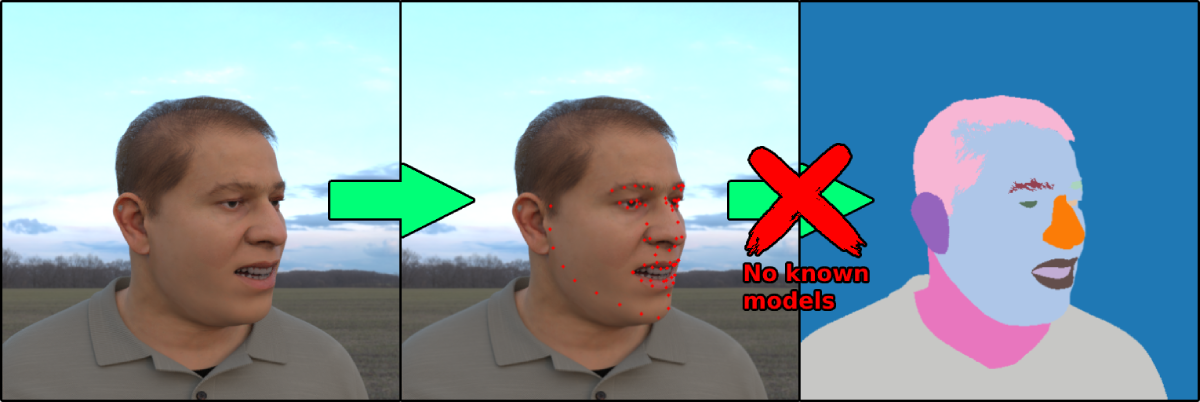
所以我們決定改用另一種做法:
- 使用資料集中人臉的真值
image(該資料集為FaceSynthetics) - 使用已知模型,把任何人臉圖片轉換為 iBUG 的 68 點人臉地標格式(我們使用了當時最先進的模型 SPIGA)
- 使用自訂程式碼,把人臉地標轉換成精美的插畫式遮罩,作為
conditioning_image使用 - 將資料儲存為 Hugging Face Dataset
你可以在此找到用來把 FaceSynthetics 資料集真值圖片轉換為插畫式遮罩,並儲存為 Hugging Face Dataset 的程式碼。
現在,資料集中已有真值 image 和 conditioning_image,還欠最後一步:為每張圖片撰寫説明。強烈建議完成這一步,但你也可以試試使用空白提示,並分享結果。由於 FaceSynthetics 資料集沒有圖片説明,我們使用 BLIP 圖片描述模型處理資料集。你可以在此處查看為所有圖片撰寫説明所用的程式碼。
這樣就完成最終資料集了!Face Synthetics SPIGA with captions 包含 FaceSynthetics 資料集 100K 張圖片的人臉真值圖片、分割結果和文字説明。現在可以開始訓練模型了!
3. 訓練模型
資料集已準備好,是時候訓練模型了!原本這應該是整個流程中最困難的部分,但有了 diffusers 訓練指令碼後,結果反而成了最簡單的一步。我們在 LambdaLabs 租用一張 A100,每小時 US$1.10。
我們的訓練體驗
我們訓練模型 3 個 epoch(即讓模型看過 100K 張圖片 3 次),批次大小為 4(每個步驟讓模型看 4 張圖片)。結果訓練過度並出現過度擬合(模型忘記了與真實人臉有點不同的概念,例如提示中的「shrek」或「a cat」會生成真人而非 Shrek 或貓,也開始忽略風格)。
只訓練 1 個 epoch(即模型「看過」100K 張圖片)後,它已能遵循姿勢,而且沒有過度擬合。因此方法有效,不過……由於我們使用 FaceSynthetics 資料集,模型最終學會生成詭異的 3D 人臉,而非寫實人臉。這也合理,因為我們使用的是合成人臉資料集,而非真實人臉;這些效果也可以用來創作有趣或迷因風格的內容。這是uncannyfaces_25K 模型。
在這個互動表格中,你可以使用下方旋鈕查看模型經歷了多少訓練步驟,以及這如何影響訓練過程。約 15K 步時,模型已開始學習姿勢;約 25K 步時則趨於成熟。此處
我們如何進行訓練
我們只需安裝相依套件:
pip install git+https://github.com/huggingface/diffusers.git transformers accelerate xformers==0.0.16 wandb
huggingface-cli login
wandb login
然後執行 train_controlnet.py 程式碼
!accelerate launch train_controlnet.py \
 --pretrained_model_name_or_path="stabilityai/stable-diffusion-2-1-base" \
 --output_dir="model_out" \
 --dataset_name=multimodalart/facesyntheticsspigacaptioned \
 --conditioning_image_column=spiga_seg \
 --image_column=image \
 --caption_column=image_caption \
 --resolution=512 \
 --learning_rate=1e-5 \
 --validation_image "./face_landmarks1.jpeg" "./face_landmarks2.jpeg" "./face_landmarks3.jpeg" \
 --validation_prompt "High-quality close-up dslr photo of man wearing a hat with trees in the background" "Girl smiling, professional dslr photograph, dark background, studio lights, high quality" "Portrait of a clown face, oil on canvas, bittersweet expression" \
 --train_batch_size=4 \
 --num_train_epochs=3 \
 --tracker_project_name="controlnet" \
 --enable_xformers_memory_efficient_attention \
 --checkpointing_steps=5000 \
 --validation_steps=5000 \
 --report_to wandb \
 --push_to_hub
我們來看看部分設定,並介紹一些最佳化技巧,讓訓練可在低至 8GB VRAM 的 GPU 上執行。
pretrained_model_name_or_path:你想使用的 Stable Diffusion 基礎模型(我們在此選用 v2-1,因為它生成人臉的效果較好)output_dir:儲存模型的目錄dataset_name:訓練所用的資料集。本例使用 Face Synthetics SPIGA with captionsconditioning_image_column:資料集中存放條件圖片的欄位名稱(本例為spiga_seg)image_column:資料集中存放真值圖片的欄位名稱(本例為image)caption_column:資料集中存放圖片説明的欄位名稱(本例為image_caption)resolution:條件圖片和真值圖片的解像度(本例為512x512)learning_rate:學習率。我們發現1e-5適用於這些例子,但你也可以試試1e-4至2e-6之間的不同數值。validation_image:供你在訓練期間快速查看效果!系統每隔指定數量的validation_steps就會生成驗證圖片,讓你瞭解訓練進度。請在此輸入任意數量條件圖片的本機路徑。validation_prompt:與驗證圖片一同執行的提示。可輸入任何能測試模型訓練效果的內容。train_batch_size:可放入 GPU 記憶體的訓練批次大小。由於我們使用 A100,因此可設為4;若你的 GPU VRAM 較少,建議將此值調低至1。num_train_epochs:每個 epoch 代表訓練集中的圖片會被模型「看見」多少次。我們曾試過 3 個 epoch,但結果發現最佳效果只需稍多於 1 個 epoch;訓練 3 個 epoch 會令模型過度擬合。checkpointing_steps:每隔x個步驟儲存中途檢查點(本例為5000)。每完成 5000 步便會儲存一個中途檢查點。validation_steps:每隔x個步驟便會執行validaton_prompt和validation_image。report_to:訓練結果的回報目的地。本例使用 Weights and Biases,並產生了這份精美報告。 不過,把train_batch_size從4降至1,可能仍不足以讓訓練在小型 GPU 上執行;以下是不同 GPU VRAM 容量可加入的其他參數:push_to_hub:將最終訓練好的模型推送至 Hugging Face Hub 的參數。
在 16GB VRAM GPU 上執行
pip install bitsandbytes

--train_batch_size=1 \
--gradient_accumulation_steps=4 \
--gradient_checkpointing \
--use_8bit_adam
批次大小設為 1,並累積 4 步梯度,其效果等同於使用我們例子中的原始批次大小 4。此外,我們亦啟用了梯度檢查點和 8-bit Adam,以進一步節省記憶體。
在 12GB VRAM GPU 上執行
--gradient_accumulation_steps=4 \
--gradient_checkpointing \
--use_8bit_adam
--set_grads_to_none
在 8GB VRAM GPU 上執行
請參閲此處的指南
4. 結語!
這次 ControlNet 訓練體驗非常有趣。我們成功訓練出能遵循真實人臉姿勢的模型;不過,由於訓練資料集的特性,模型學會生成詭異的 3D 人臉,而非真實的 3D 人臉,反而別有一番風格。
歡迎試用我們的 Hugging Face Space:
至於我們接下來的工作——若要在不使用真人人臉資料集的前提下生成人臉看來寫實,一個構想是先以 Stable Diffusion Image2Imaage 處理整個 FaceSynthetics 資料集,把具有 3D 觀感的人臉轉換為較寫實的版本,再訓練另一個 ControlNet。
敬請期待即將舉行的 ControlNet 訓練活動!請在 Twitter 關注 Hugging Face,或加入我們的 Discord 以掌握最新消息。
來源:Hugging Face Blog · huggingface.co