Octave 如何在 Amazon Bedrock 上打造安全的多租戶 AI 基礎平台
How Octave built a secure multi-tenant AI foundation on Amazon Bedrock
Octave 為 Reliance 在 Amazon Bedrock 上建立三層多租戶 AI 基礎平台,以支援受監管產業的文件搜尋與 AI 工作流程。平台採用 Cohere Embed v4,並以每租戶向量儲存、AgentCore 隔離執行環境及 Amazon Bedrock Guardrails 分層控制資料存取與內容風險。
文章拆解多租戶合規場景中的隔離、身份與內容安全取捨,並呈現如何把共用基礎設施轉化為可重用的 AI 功能底座。
在受監管行業的品質管理中,能解決問題的機構知識,幾乎總是埋藏在客戶過往的紀錄之中:去年調查過的類似缺陷、找出並修正根本原因的矯正及預防措施(CAPA),以及指出相同缺口的審核發現。這些知識散落在數十億份文件中,沒有人能跨語言及格式,按語義相似度搜尋,因此每次調查都得從頭開始。Octave Reliance 協助各機構彙集多個系統中的文件,讓他們更容易搜尋並掌握所有文件。Octave Reliance 團隊認為,解鎖這些過往紀錄,是協助客戶提升工作效率並持續符合合規要求的最大單一機會。但障礙同樣明確:投訴紀錄、審核發現和糾正措施的隔離要求是平台上最嚴格的,而這些正是 AI 必須讀取的紀錄。平台服務超過 14,000 名醫療器械、製藥及食品製造業客戶,若不慎將一名客戶的資料披露給另一名客戶,所帶來的監管後果將遠超任何 AI 帶來的效益。
Octave 業務遍及 180 個國家,服務對象包括《財富》全球 500 強中超過 60% 的企業。其雲原生品質管理系統 Reliance 為超過 650 家企業客戶提供支援,涵蓋超過 40 個應用程式,從投訴管理及 CAPA 追蹤,到審核管理及供應商品質管理。每個客戶都會產生可供 AI 推理的受監管數據。每名客戶都是獨立租戶,任何數據都不能跨越租戶界線。
面對這些情況,Reliance 團隊作出了一項不尋常的決定:首個週期不推出單一 AI 功能,而是先打造所有未來功能都會依託的基礎架構。此後,這套基礎架構已將每個使用案例的部署時間縮短 50%。如果你正要把 AI 引入數據價值高、但隔離要求不容妥協的軟件即服務(SaaS)平台,這套思路不只適用於品質管理。本文將介紹影響設計的四項張力,以及 Octave 如何在 Amazon Bedrock 上使用 Cohere Embed v4 打造三層基礎架構。接着,我們會介紹嵌入 20 億份文件的流程,以及在正式環境中驗證這套架構的 Complaint Triage Assistant。
為何要打造基礎架構,而不是推出單一功能
與 AWS 舉行的構想工作坊找出四個影響重大的使用案例:投訴摘要及分流、審核準備度監察、事故敍述生成,以及預測性品質風險評分。工作坊亦揭示了一項關鍵見解,影響了之後的一切:數十個應用程式各有不同的文件類型和工作流程。若為單一應用程式孤立地打造 AI,就意味要為下一個應用程式重新建構基礎架構。
因此,團隊反轉原定計劃:先打造橫向平台,再在平台上逐步推出垂直功能。投訴摘要及分流率先推出,在其他功能跟進前驗證整體架構。
四項設計張力
在選定任何模型之前,團隊先花時間處理四個方向各異的問題,每個問題都不可妥協。
在不冒意外披露風險的情況下提供資料。投訴記錄、CAPA、標準作業程序 (SOP) 和審核結果都屬於同一個租戶,其他租戶必須無法存取。即使 AI 查詢出錯,也不能跨越租戶邊界。向量儲存庫、檢索邏輯和生成情境都必須限定於單一租戶。
在隔離環境中執行代理。管理代理工具、資料儲存庫和模型端點的權限,必須限定於提出請求的用戶,而非共用服務角色;權限只可在執行期間生效,並須遵從該用戶的存取權限。使用靜態憑證的共用代理集區,三項要求都未能符合。
讀取不可予以信任的內容。這裡的代理會接收來自機構外部的投訴、電郵附件、掃描 PDF 和圖片。OWASP Top 10 for Large Language Model (LLM) Applications (2025) 列出直接適用的威脅:透過接收內容進行提示詞注入 (LLM01)、敏感資訊披露 (LLM02)、不當輸出處理 (LLM05),以及過度代理權 (LLM06)。在這種規模下,附件 PDF 中藏有指令並非假設情況。
無須等上一季即可嵌入 2 billion 份文件。Reliance 託管超過 2 billion 份文件,個別租戶儲存數以百萬計的 Word 檔案、PDF、掃描表格、試算表、圖片和電郵。團隊承諾在單一工作日內完成最大型租戶的上線。由於這些文件會影響監管決策,不能以品質換取吞吐量。漏掉一宗投訴會削弱用戶對整個系統的信任。
最終採用的架構
要同時平衡四方面的要求,可選方案因而大幅減少。Amazon Bedrock 以單一平台應對這些要求:透過單一 API 存取多個模型、提供 AWS 帳戶已實施的 AWS Region 資料駐留和 AWS Identity and Access Management (IAM) 治理,以及將 Guardrails 作為正式環境的內容管控,而非需要自行建置的功能。
整個基礎架構分為三層,如圖 1 所示。資料準備層使用 Amazon Bedrock 上的 Cohere Embed v4 嵌入品質文件,並將文件寫入 Amazon OpenSearch Service 上各租戶專屬的向量儲存庫。安全執行層會將用戶請求傳送至 AgentCore Gateway;這是 Amazon Bedrock AgentCore 的一項功能,會先套用驗證和政策,再將請求交予隔離的 microVM 工作階段,並由該工作階段呼叫 Amazon Bedrock 上的 Anthropic Claude 模型。內容保護層則在兩處套用 Amazon Bedrock Guardrails:輸入時進行篩選,輸出在送達處理常式前再行篩選。檢索、執行和篩選各自分開處理,確保每個階段都能獨立執行管控並提供證據。
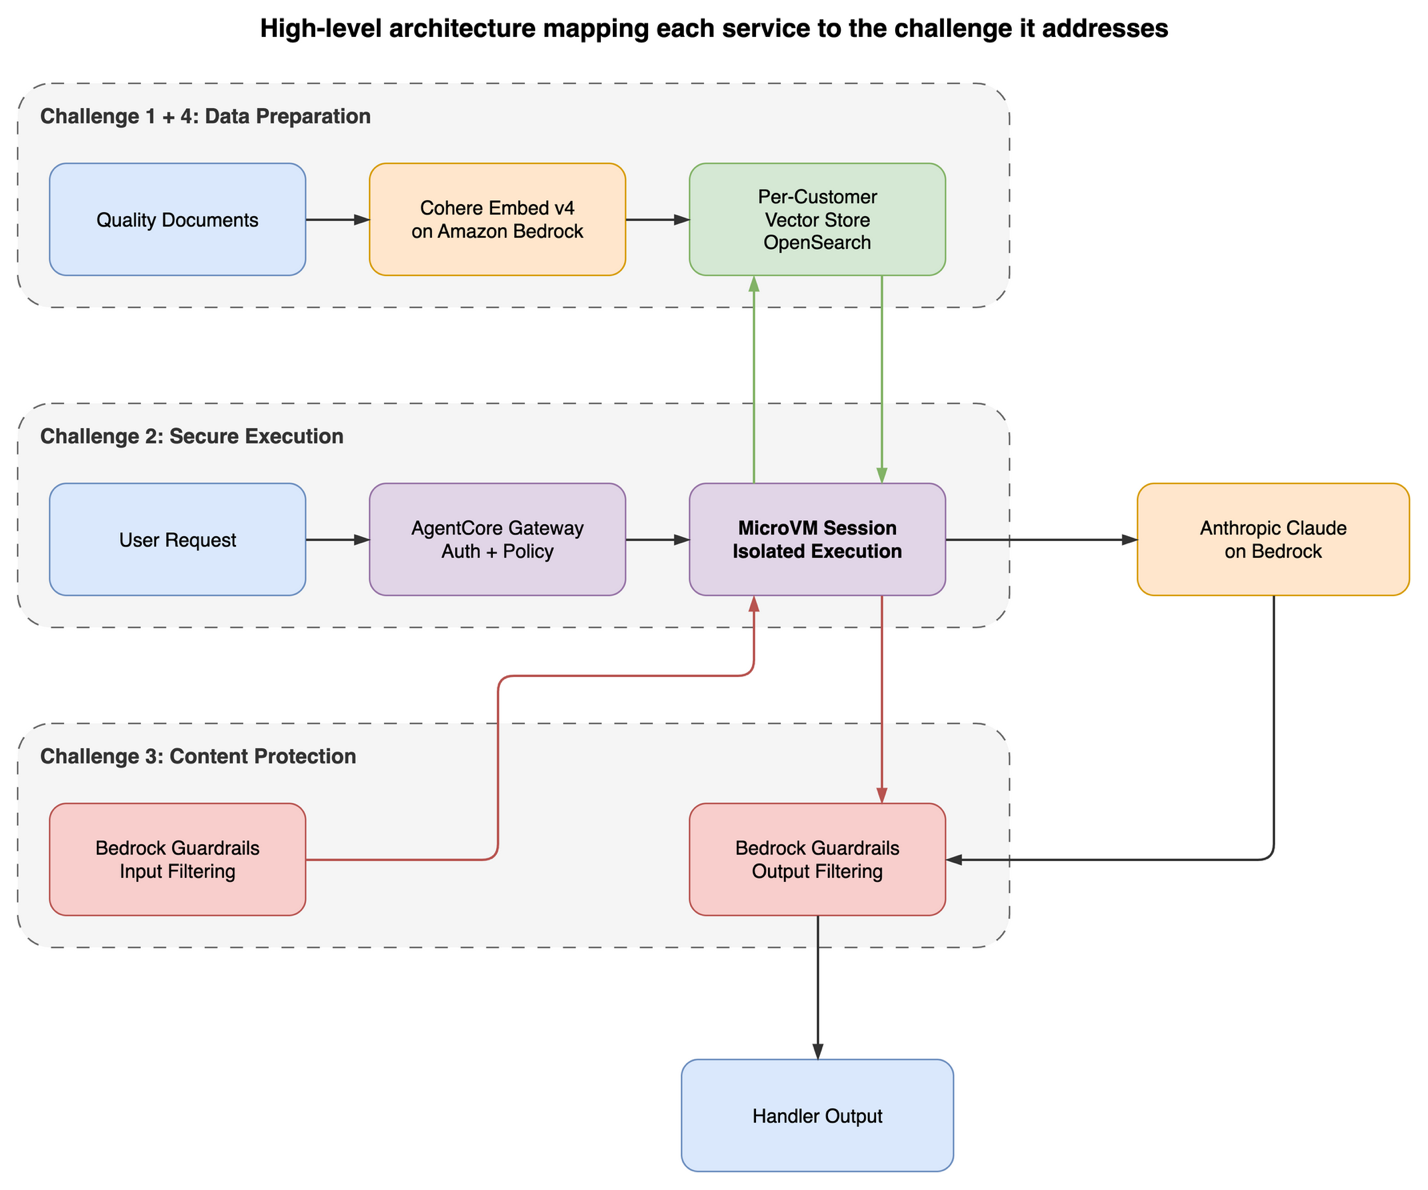
圖 1:Reliance AI 基礎架構的高層概覽
選擇如何表示資料
只有在文件可供檢索後,其他工作才有意義。這代表檢索必須準確、支援不同語言和格式,而且不能跨越租戶邊界。團隊根據自身的數據集評估嵌入模型,而非參考公開排行榜。評估的關鍵問題都與這些資料直接相關:裂開外殼的照片與描述它的段落有何關聯,以及德文投訴與英文 CAPA 如何對應。
Cohere Embed v4 在 Amazon Bedrock 上有五方面優勢,而且這些優勢彼此相關。首先要決定的是,哪些管線步驟可以省略。品質記錄除了文字,還包括有瑕疵產品的照片、掃描的檢查表格和附有註釋的圖表。Embed v4 將兩種模態置於同一向量空間。只需一次查詢,便可同時檢索到有裂痕的外殼照片,以及描述該缺陷的段落,不必為每種模態各自建立管線。原生多語言支援則在另一個維度達到同樣效果:文件可能以多種語言提交,往往同屬一個租戶的語料庫,無須預先翻譯處理。團隊因此毋須建立兩條管線,也少了兩個可能導致文件無法被檢索的環節。
另外三項考量則決定向量可存放的位置及成本。即使進行推理,客戶數據也不能離開其 AWS 區域,因此 Amazon Bedrock 在同一區域提供模型是先決條件,而非單純便利。Embed v4 支援在 US East (N. Virginia) Region (us-east-1)、Europe (Ireland) Region (eu-west-1) 及 Asia Pacific (Tokyo) Region (ap-northeast-1) 進行區域內推理,符合 Octave 三項區域合規要求。模型及功能的可用性因區域而異,亦會隨時間變化。如需查看最新支援範圍,請參閲 Amazon Bedrock User Guide 的按模型查看區域可用性。在每個區域內,Amazon OpenSearch Service 的成本會隨維度數量線性增加。因此,值得測試 Embed v4 可設定的 256–1,536 維輸出,而非直接採用預設值。以具代表性的正式環境查詢進行測試後,結果顯示 512 維可維持目標準確度,與預設的 1,536 維相比,儲存空間減少約 66%。128K token 的上下文視窗則在另一處發揮作用:每個請求可容納多個約 4K token 的區塊,資料導入吞吐量便由此而來。
在執行階段隔離租戶
較難的問題是應在哪一層強制執行租戶隔離。透過應用程式程式碼也能做到,但這代表日後每個功能團隊都必須在每條程式碼路徑上正確實作;漏掉一次檢查,就可能意外向其他租戶披露資料。團隊改為在執行階段實施隔離。AgentCore runtime(Amazon Bedrock AgentCore 的一項功能)在應用程式層以下強制執行隔離;由於它不依賴特定框架或模型,隔離方案不會限制 Complaint Triage Assistant 所選用的代理框架和模型。
每個用戶工作階段都會在專屬的 microVM 中執行,並配備獨立的 CPU、記憶體和檔案系統;工作階段結束時,microVM 會停止並清理。這種硬件層級隔離的設計,不論代理如何運作都能維持。AgentCore 會在整個執行鏈中傳遞已驗證用戶的身分:每位用戶專屬的 OAuth 權杖保管庫會驗證代理是代表該名用戶行事,而非使用共用服務身分;憑證按代理設定權限範圍,並只在工作階段期間有效。AgentCore Gateway 會在工具、操作及參數層級進行授權。自動推理功能會依據已定義規則進行形式化驗證。這套做法與 IAM 和 Amazon Simple Storage Service (Amazon S3) 政策驗證背後採用的原則相同。圖 2 展示了這種隔離如何貫穿兩個租戶。
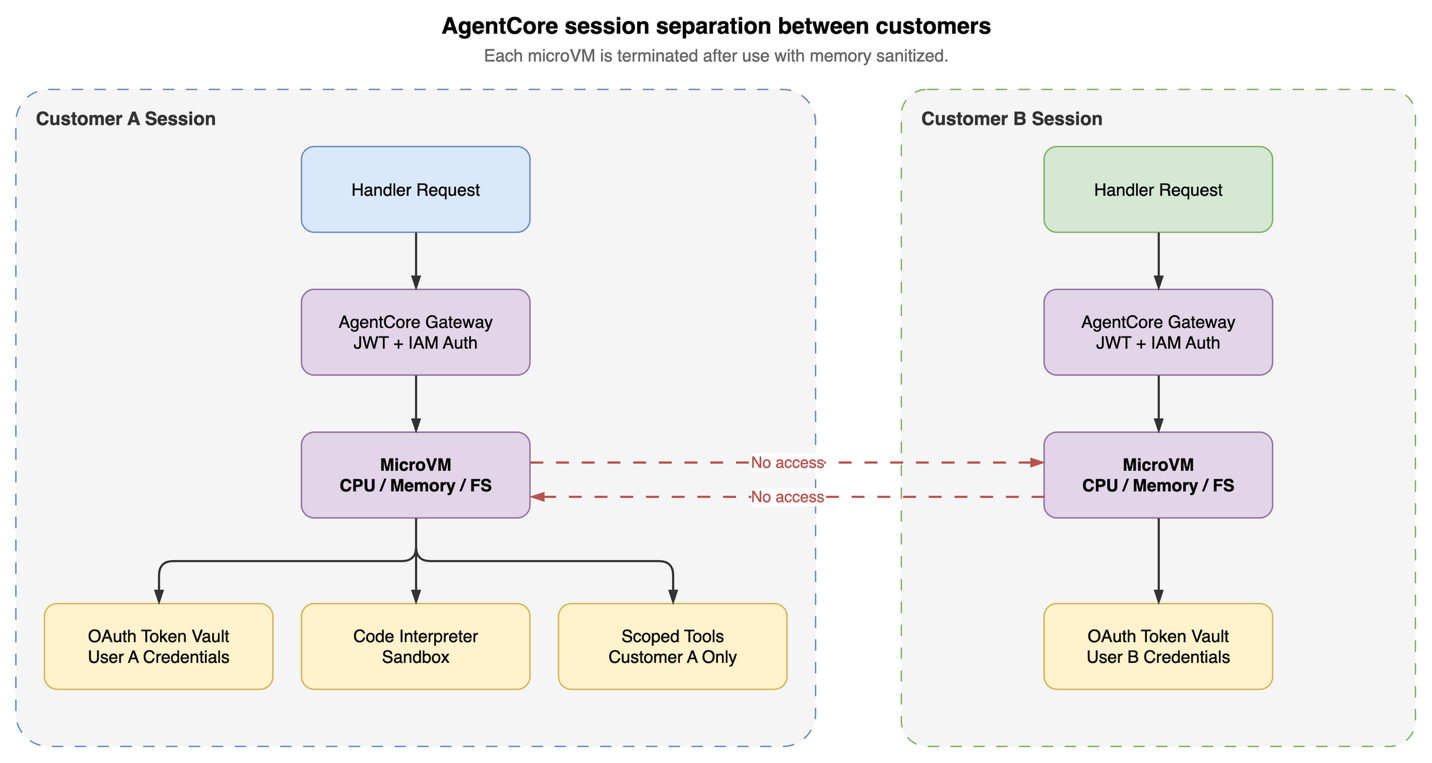
圖 2:AgentCore 如何隔離不同租戶的工作階段。每個微型虛擬機器(microVM)使用後都會停止,並清除記憶體中的資料。
因此,由租戶 A 的品質處理人員提交的投訴,只會送達 AgentCore Code Interpreter(Amazon Bedrock AgentCore 的一項功能)中租戶 A 的權杖保管庫、工具和沙盒。租戶 B 的工作階段無法連接到其中任何一項。
將載入的內容視為不可信資料
這個矛盾沒有簡單的解決方法。投訴附件是不可信的輸入,但同時也是代理程式要讀取的內容,因此不能只因內容可疑便拒絕處理。團隊最後採用了縱深防禦。
Octave 在代理程式邏輯之外,而非其內部,透過 Amazon Bedrock Guardrails 在投訴工作流程的三個環節進行檢查。ApplyGuardrail API 會在建立嵌入向量前評估從附件擷取的文字、在檢索到的文件和工具輸出進入代理程式的上下文前評估這些內容,以及在處理人員查看綜合摘要前進行評估。從附件衍生的內容會連同輸入標記一併傳遞,表明這些內容是資料而非指令。這樣才能偵測到隱藏在文件中段的提示詞注入。個人識別資料(PII)會在輸入時遮蔽。
單靠偵測並不足夠,因此底層還設有代理程式權限界限。無論代理程式被要求執行甚麼操作,AgentCore Gateway 仍會管控它可呼叫哪些工具;文件擷取則在 AgentCore Code Interpreter 沙盒中執行,不設網絡輸出,而且工作階段結束後不會保留資料。隱藏在 PDF 中的惡意負載必須突破每一層防禦,而非只突破其中一層。
成效:系統按租戶追蹤偵測和遮蔽率,因此 Octave 能以證據説明篩查結果,而非只作聲稱。
讓 20 億份文件通過處理流程
在嵌入模型之前,更棘手的問題是如何從 Word 檔案、試算表、數碼 PDF、掃描頁面、照片和電郵對話中擷取可用內容。文件可能包含多種語言,有時同一份記錄內便有多種語言。此外,處理速度必須夠快,才能將用戶加入流程的時間由一季縮短至一天。圖 3 展示了整個處理流程。
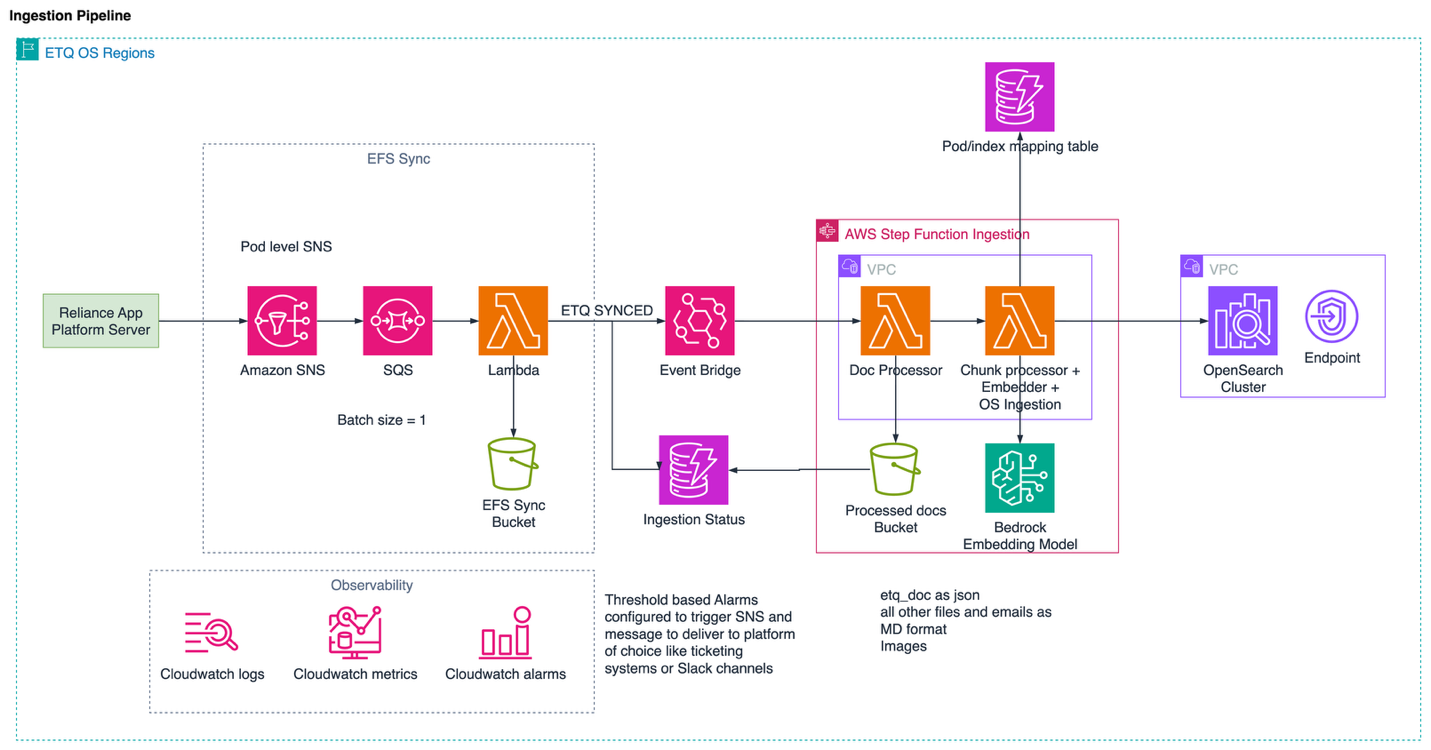
圖 3:載入流程:以事件驅動方式處理文件,從應用程式平台開始,經 Step Functions 協調,最後存入各租戶專屬的 OpenSearch 索引。
文件事件會透過 Amazon Simple Notification Service (Amazon SNS) 和 Amazon Simple Queue Service (Amazon SQS) 分流至 AWS Step Functions 狀態機。該狀態機會在專用的 Amazon Virtual Private Cloud (Amazon VPC) 內,協調多個並行執行的 AWS Lambda 執行個體進行解析、分塊和嵌入。由於系統透過將批次分流至多個執行個體來實現並行處理,而非擴展單一資源,因此無須重新設計架構,處理量便可提升。
解析流程能處理多樣的文件格式:保留 Word 檔案和試算表中的語義層級、對缺少文字圖層的掃描 PDF 執行光學字元辨識(OCR),並將內嵌圖片視為一級內容。分塊內容會附有中繼資料,包括租戶、文件類型、來源應用程式、語言和內容雜湊值。這些中繼資料用於檢索篩選和執行各租戶的命名空間限制。
吞吐量來自批次打包。將多個 4K 區塊交錯組合至單一請求,利用 Embed v4 的 128K 上下文視窗,令大型語料庫所需的 API 呼叫次數減少約一個數量級。在 Octave 於 Amazon Bedrock 進行的內部測試中,Embed v4 的處理速度達每分鐘 2,800 萬個 token。與 Cohere 的解決方案架構師調校批次大小,直至排除記憶體瓶頸後,整條管道在每個租戶工作負載下,每 24 小時可持續處理 140 萬份文件。這讓在一個工作日內完成的承諾得以實現。
投訴分流助理
醫院向醫療器械製造商報告有缺陷的注射器,相關紀錄連同電郵、損壞器械的照片及佐證文件一併送達。品質處理人員必須整理不同格式的資料,判斷過往是否曾有人報告類似個案,並找出當時如何解決。完成這些工作後,才能分配優先級,而這往往必須在以日計的申報期限內完成。
這個助理以 AWS 開源的 Strands Agents SDK 建構。SDK 以圖表組合代理式工作流程,節點代表工具調用或模型呼叫,邊則代表資料依賴關係。AgentCore runtime 執行該圖表,並按工作階段隔離;五個階段則將投訴由原始附件轉化為完整摘要報告。
首先是文件擷取。PDF、圖片、電郵附件及影片均會送入 AgentCore Code Interpreter,由它將每項資料解析為結構化中間表示。接著,Amazon Bedrock 上的 Claude 模型會為紀錄撰寫摘要;檢索查詢採用這份摘要,而非數千個 token 的原始來源。系統會以此查詢租戶的 OpenSearch 索引,搜尋 Embed v4 嵌入向量,找出相似的過往投訴及其 CAPA;AgentCore Gateway 則確保只有獲授權的命名空間可供存取。
相似度本身不足以令檢索結果獲得信任。系統會另行呼叫模型,按信心度為結果評分,並剔除用詞相似但根本原因不同的匹配項目。留下的結果會進入綜合整理階段,由 Amazon Bedrock 上的 Anthropic Claude Sonnet 編製輸出,包括關鍵事實、情緒、緊急程度指標、最相近的歷史紀錄及其結果,以及建議的分流優先級。
已完成的摘要報告會快取在 Amazon DynamoDB,並按環境設定存留時間(TTL),因此重複查看不會產生額外成本。處理人員不再需要從零開始,而是可以運用機構的累積經驗。
圖 4 展示這套引擎如何置於私有 API 邊界之後。入口網站的請求經由私有 Amazon API Gateway 和 Lambda 函式傳送至 AgentCore runtime;檢索程序透過以角色為基礎的存取權限及預先簽署的 URL 讀取文件索引,附件則保留在 Amazon S3。快取摘要和 OpenTelemetry 追蹤資料會分別送至摘要表和評估儀錶板。
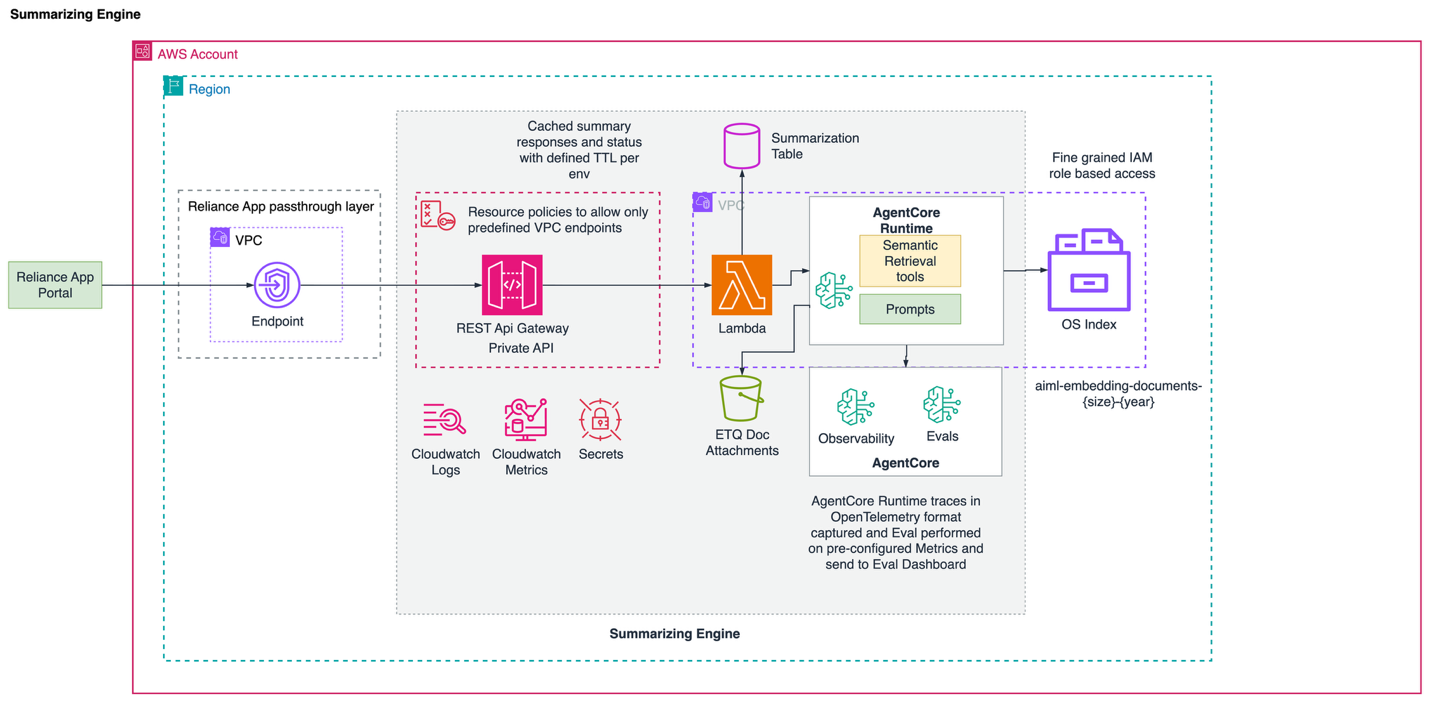
圖 4:摘要引擎:由 AgentCore 驅動的工作流程,在私有 API 邊界內處理文件擷取、檢索、推理及綜合整理,並提供回應快取和全面的可觀測性。
圖 5 將相同流程簡化為一條線,並在兩端透過 Guardrails 進行篩選。
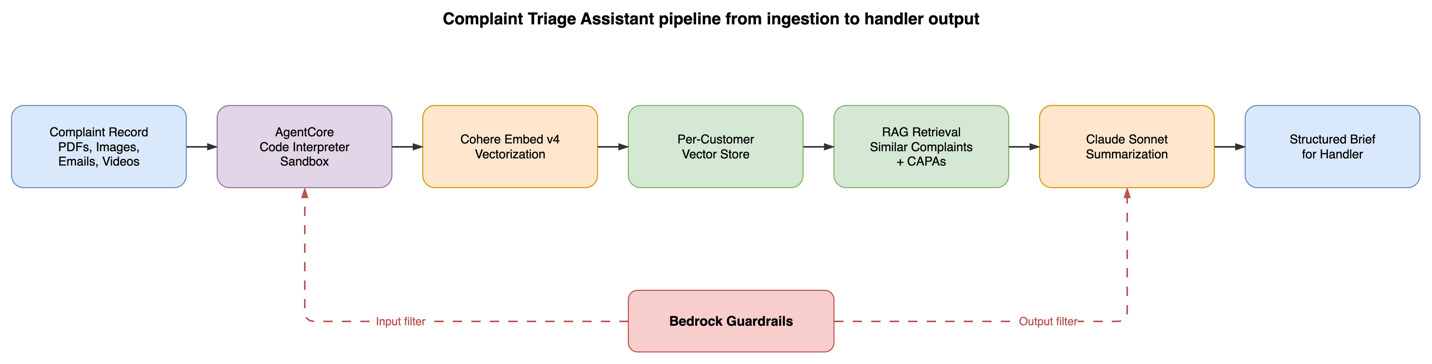
圖 5:由資料匯入至處理人員輸出的投訴分流助理管道
驗證 Agent 執行了甚麼
這裏的可觀測性不僅關乎工程團隊如何除錯,也關乎他們如何整合系統審計功能,以符合合規要求。審計人員可以追問某宗投訴為何會以這種方式分流處理,而「模型作出了決定」並不足以應對這種追問。
AgentCore 會擷取整個圖中每個節點的 OpenTelemetry 相容追蹤資料:每次模型呼叫、檢索,以及每次 AgentCore Code Interpreter 執行。數月後,Octave 仍可查明哪些檢索文件和提示詞產生了某份摘要。Amazon Bedrock 的模型呼叫日誌功能會記錄每個租戶的每項請求和回應,並以 AgentCore 傳遞的 IAM 身分界定範圍;相關成本則會歸屬至 Amazon CloudWatch 中發起請求的租戶。
在離線環境中,每當提示詞、模型或檢索參數有變更,AgentCore Evals 都會根據專家標註的真實資料重新執行工作流程,並報告摘要忠實度、檢索精確率@K,以及輸出完整度。提示詞即使讀起來更好,但檢索效果變差,也會在用戶看到之前被發現。
結果
Complaint Triage Assistant 已在正式環境中運行三個月,以下數字反映了這段期間的情況。
以往展開調查時手上沒有資料的處理人員,現在打開調查時,相關歷史資料已經整理好。Octave 衡量的每宗調查 4–6 小時,正是由流程承接的工作:跨格式擷取資料、搜尋先例,以及閲讀資料以分辨真正相似的缺陷和措辭上的巧合。
這套基礎架構亦改變了 Octave 推出新功能的速度。按 Octave 自行統計,新 AI 功能的開發週期由數月縮短至數週。圖 1 所示的三個層面是共用資料準備、安全執行和檢索。由於每項新功能都能沿用這些層面,而毋須重新建置,因此每個使用案例的部署時間縮短了 50%。語意搜尋亦因此於 Q2 上線,比原定 Q4 目標提前兩個季度。
回顧
先建立基礎架構,是團隊最常反覆斟酌的決定。當持份者希望看到 AI 功能時,要為數月的基礎架構工作辯護並不容易。後續一輪使用案例證明瞭這項決定的價值。兩個選擇是關鍵:將隔離機制置於 microVM 工作階段,並在應用程式程式碼以外傳遞身分;以及以 Octave 自身的語料庫評估嵌入模型,從而揭示了任何基準測試都無法顯示的 512 維取捨。
團隊亦劃定了一條不打算逾越的界線。助理負責呈現背景資訊和先例,品質處理人員仍然作出決定。在這個決定涉及監管責任的行業中,這條界線決定了哪些工作會自動化,哪些不會。
下一步
Octave 現正將這套基礎架構擴展至 Reliance 套件。接下來的工作包括審計準備度監察、事件敍述生成,以及預測性品質風險評分,每項工作都會建基於同一套基礎架構。
如果你的平台也面對類似的兩難:有價值的資料受嚴格隔離要求所限。Octave 的經驗顯示,這些取捨是可行的。如欲進一步瞭解這個案例背後的服務,請參閲 Amazon Bedrock、Amazon Bedrock AgentCore 文件,以及 Amazon Bedrock 上的 Cohere。相關架構指引請參閲 AWS 向量解決方案:在資料所在之處建構 Agentic AI,以及 擴展 Agentic AI:無供應商鎖定的企業模式。
作者簡介

Urvish Saraiya
Urvish 是 Octave 的工程主管,負責在 AWS 上構建工業 AI 平台。他在分散式軟件系統、數據平台和機器學習方面擁有逾 18 年經驗,在公共安全、支付和數碼營銷領域具備深厚的技術專長。Urvish 兼具出色的技術能力和以產品為本的策略思維,專注於解決能帶來商業效益的業務需求。

Manu Mishra
Manu 是 AWS 的資深解決方案架構師,在軟件業擁有逾 18 年經驗,專長包括人工智能、數據與分析,以及安全。他的專業能力涵蓋策略監督和實務技術領導,負責審視並指導內部及外部客戶的工作。你可以在 LinkedIn 上與 Manu 聯絡或追蹤他的動態。

Madhunika Reddy Mikkili
Madhunika 是 AWS 的數據與機器學習工程師。她協助企業客戶運用生成式 AI 和機器學習解決複雜的業務問題。

Payal Singh
Payal 是 Cohere 的解決方案架構師,在 DevOps、雲端、安全、SDN、數據中心架構和虛擬化等不同領域擁有逾 15 年專業經驗。她負責推動 Cohere 的合作夥伴關係,並協助客戶整合複雜的生成式 AI 解決方案。

Nate Stecz
Nate 是資深合作夥伴拓展經理,透過與 AWS 合作,協助領先的生成式 AI 模型供應商增加收入。Nate 在 Amazon Web Services 任職近 10 年。他現居 Seattle, WA,喜歡戶外活動和了解新興技術。你可以在 LinkedIn 上與 Nate 聯絡或追蹤他的動態。
來源:AWS Machine Learning Blog · aws.amazon.com