Amazon Bedrock Managed Knowledge Base 支援單次 RAG、智能體檢索及純檢索模式
Single-shot and agentic retrieval with Amazon Bedrock Managed Knowledge Base
Amazon Bedrock Managed Knowledge Base 現透過 AgenticRetrieveStream 支援單次 RAG、純檢索及智能體檢索,並可按 maxAgentIteration 設定檢索流程。
文章對照 maxAgentIteration 不同取值下的檢索與生成流程,並交代規劃輪數和模型呼叫差異,便於按問題複雜度及延遲需求選擇模式。
一名銀行營運部門員工早上開始工作時,向內部 AI 助理查詢開立商業帳戶需要哪些文件。答案是一張簡單的清單。幾小時後,同一名員工詢問獨資企業、LLC,以及有多名擁有者的合夥企業,在相關要求上有何不同。答案散見於多份政策指南。助理必須能處理這兩類問題:第一類要快速且低成本地回答,第二類則要全面深入地解答。應用程式需要按每項請求調整檢索力度的方法,而無須為簡單和複雜問題分別建立系統。
Amazon Bedrock Managed Knowledge Base 現在支援單次檢索增強生成(RAG)及僅檢索請求,可透過 AgenticRetrieveStream 使用。使用單次 RAG 時,服務會搜尋知識庫一次,並利用基礎模型(FM)根據找到的段落生成答案。使用僅檢索請求時,服務會傳回符合條件的段落,而不生成答案,讓應用程式或用戶直接處理來源文字。這些模式與現有的 Agentic 檢索並行;使用 Agentic 檢索時,服務會先規劃並執行多次搜尋,再提供答案。現在,你可以使用同一個 API 處理員工的兩類問題:用單次 RAG 查找清單,用 Agentic 檢索比較不同政策。
本文會説明新設定的運作方式,以及各種模式的適用時機。我們以一個示範用的銀行內部政策助理為例,展示單次 RAG 如何處理直接問題,以及 Agentic 檢索如何協助比較不同政策文件。我們亦會展示如何設定僅檢索請求,讓員工查看來源段落,而非接收生成的答案。
主要優點
Agentic 檢索有助助理回答需要多次搜尋的問題。基礎模型會將問題拆分成子查詢、搜尋相關知識庫,並評估搜尋結果是否足以回答原本的問題。如果發現資料有缺漏,便可在已設定的迭代上限內調整搜尋並檢索更多證據。
對應用程式開發者而言,這項功能帶來多項好處:
- 更有效支援多部分問題 – 透過有針對性的搜尋,助理可以為問題的各個部分尋找證據,而不是依賴單次搜尋涵蓋所有內容。在銀行的例子中,助理可以分別查找獨資企業和 LLC 的要求,再作比較。
- 資料不足時進行後續搜尋 –規劃器可以根據搜尋結果決定下一步搜尋內容。如果某個段落未能提供足夠背景,亦可檢索完整文件,協助填補單次檢索可能留下的資訊缺口。
- 答案附有佐證 – 啟用回答生成後,服務會整合檢索到的資訊,生成附有引用來源的答案。追蹤事件會顯示規劃和檢索步驟,方便開發者檢視答案的生成過程。
- 減少自訂協調流程的工作 –服務透過單一 API 管理規劃、檢索、評估和回答生成流程。應用程式無須自行實作迴圈來協調這些步驟。
這些 Agentic 能力對複雜問題仍然有用。對於簡單的查詢,應用程式亦需要一種無須額外規劃即可檢索並回答的方法。擴展後的 maxAgentIteration 範圍填補了這個缺口。透過一個參數,你可以為每個請求選擇以下三種模式之一:
- 僅檢索會傳回段落,但不會生成答案。
- 單次 RAG只檢索一次,然後生成答案,不設規劃輪次。
- Agentic 檢索會為複雜問題規劃並執行多次搜尋。
單次 RAG 只需呼叫基礎模型一次來生成答案,與 Agentic 檢索相比,可降低延遲和模型用量。僅檢索請求不會呼叫基礎模型。你可以按每個請求平衡速度與答案質素,無須整合第二個 API,亦無須為簡單和複雜查詢維護不同的程式碼路徑。
檢索迭代次數的計算方式
在逐一介紹新取值之前,先了解迭代次數如何計算會有幫助,因為這正是令行為可預測的關鍵。
一次迭代等於一次基礎模型呼叫。迴圈總會以一次答案生成呼叫結束。設定為 n,最多可進行 n 減 1 輪 Agentic 規劃,最後一次迭代則保留用於生成回應。每輪規劃包括一次查詢改寫及一次檢索。迭代次數越多,規劃輪數越多,處理難題的結果也越好。迭代次數越少,延遲則越低。
有一項不會 計入:推測性檢索。首輪規劃開始前先行執行的初始檢索屬於檢索,不算作迭代。它不會計入 maxAgentIteration 的上限,而且只會令請求更快。閲讀以下取值時,請留意這個分別。
新增內容
取值範圍現為 0–5。
三種模式均支援多個知識庫,包括 maxAgentIteration=0 和 1。單次檢索並不代表只限使用一個知識庫。Agentic 模式新增查詢分解、證據評估及迭代搜尋功能,而非獨佔多個知識庫的存取權。
maxAgentIteration = 1:基本 RAG(主要使用情境)
這是單次 RAG:檢索一次,然後生成一個答案。沒有 Agentic 規劃,也不會改寫查詢。API 會根據你的查詢檢索一次,並生成以這些段落為根據的回應。這就是 先檢索一次,再生成回應 的模式;此前無法透過此 API 實現。
搭配 generateResponse=true 使用,即可取得以檢索段落為根據的生成答案。如果只需要段落,請改用 maxAgentIteration=0,詳情見下一節。
如果大部分流量都是範圍明確、直接的問題,這可能是適合作為預設值的設定。
maxAgentIteration = 0:僅傳回段落,不呼叫 LLM
這會確保執行一次檢索,但不會生成任何內容,也不會呼叫基礎模型。這等同於直接呼叫 Retrieve API。因此,對於已統一使用 AgenticRetrieveStream 的呼叫端而言,這項設定尤其實用,因為他們只需更改參數,毋須切換 API。
由於不會呼叫大型語言模型(LLM),因此不會生成答案。在此取值下設定 generateResponse=true 屬無效操作,並會傳回 4xx 錯誤,因為生成答案需要呼叫 LLM。
maxAgentIteration = 2 to 5:Agentic 模式,維持不變
在代理式模式下,基礎模型會將複雜問題拆解為聚焦的子查詢,並透過多個步驟檢索證據,包括從多個知識庫檢索。它會評估檢索到的資訊;若缺少證據,亦可進一步調整搜尋。此方法可提升多部分及比較類問題的檢索準確度,尤其是單次搜尋未必能充分處理的問題。
啟用回應生成後,設定為 n 時,最多可進行 n 減 1 輪規劃,然後根據檢索到的證據生成答案。使用 2–5 範圍內數值的現有請求,行為維持不變。
選擇數值
理解方式之一:
maxAgentIteration |
可獲得的結果 | 適用情況 |
| 0 | 一次檢索,不生成答案,零次 LLM 呼叫 | 段落檢索。已將此 API 作為標準的呼叫方,並希望採用 Retrieve 式行為 |
| 1 | 一次檢索,加上一次答案生成 | 適用於直接且範圍明確問題的單次 RAG |
| 2 至 5 | 最多進行 n 減 1 輪規劃,然後生成答案 | 包含多個部分、比較、探索及跨知識庫的問題 |
數值越低,呼叫速度越快、可預測性越高。數值越高,規劃器越能針對真正複雜的問題進行拆解和調整。簡單的請求可先使用較低數值;當複雜查詢的準確度比延遲更重要時,則可提高數值。
實際應用:銀行內部政策助理
假設有一家虛構的銀行,其營運團隊使用一個內部助理,助理以知識庫為後盾,當中包括開戶程序、文件清單及政策指南。員工使用助理查找和了解銀行記錄在案的要求。以下例子説明應用程式如何為不同工作流程選擇檢索模式。這些例子並非描述客戶部署或已量度的結果。
以下圖表展示銀行助理如何為每項請求選擇檢索模式。
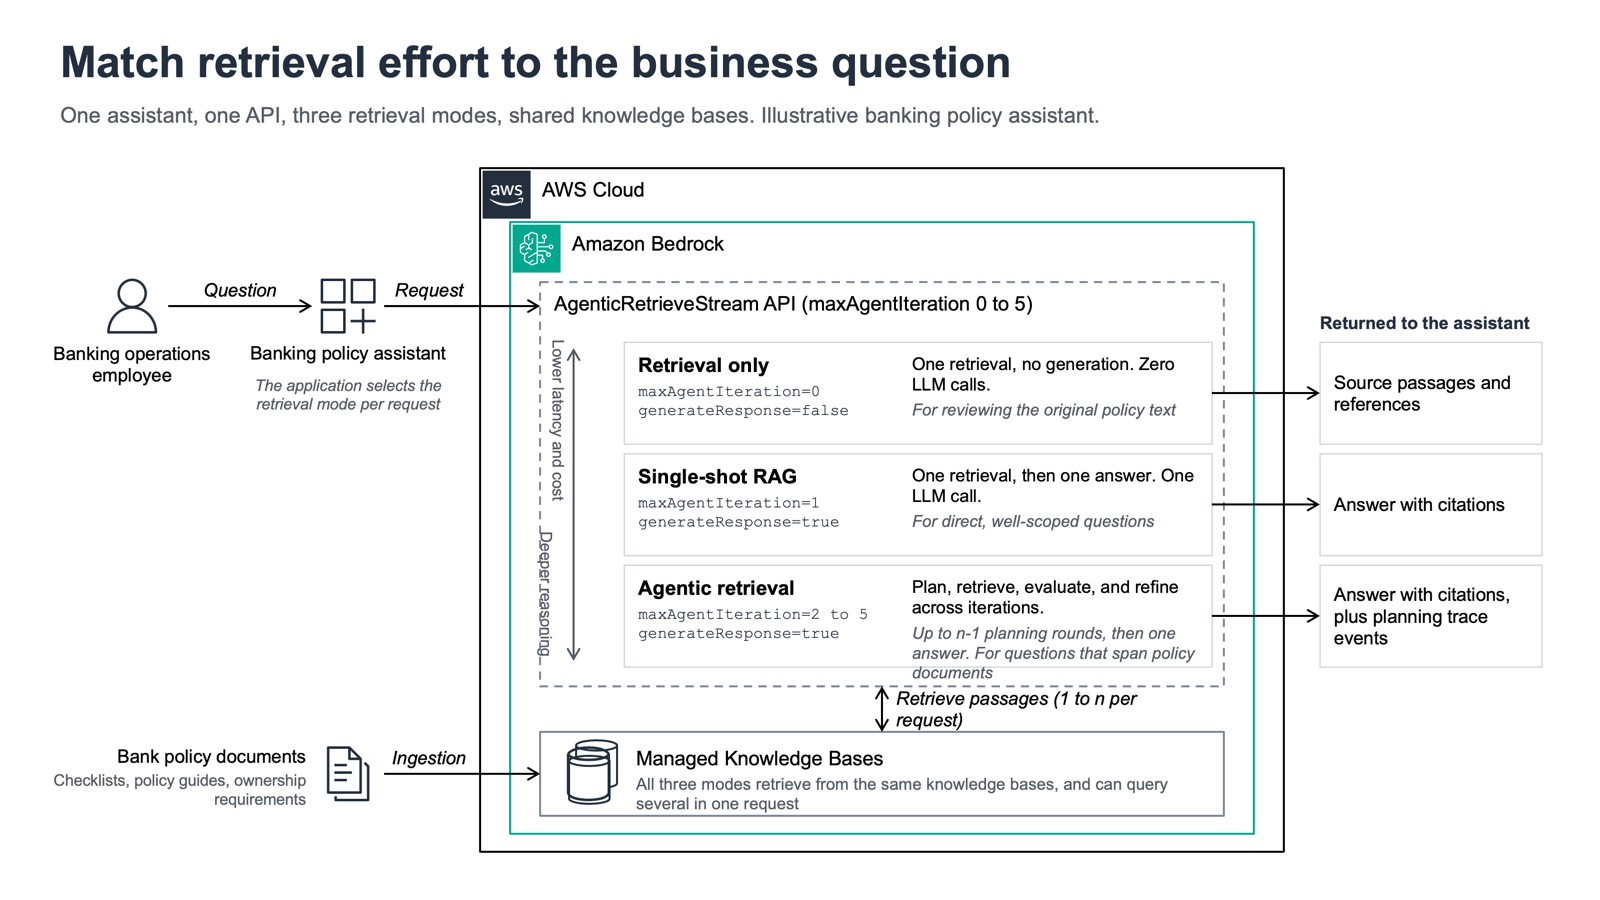
圖 1:銀行助理如何為每項請求選擇檢索模式
員工向助理提問。應用程式會選擇檢索模式,並將請求傳送至 AgenticRetrieveStream。使用單次 RAG 時,服務會搜尋知識庫一次,然後生成答案。使用代理式檢索時,服務會將問題拆分成多個部分、進行多次搜尋,然後生成附有引文的答案。使用純檢索時,服務會傳回來源段落,而不生成答案。以下各節會説明每種模式。
回答直接的文件查詢
一名員工問:「獨資經營者開立商業支票帳戶需要哪些文件?」在此例中,銀行備有一份專用清單,列明答案。應用程式會設定 maxAgentIteration=1 和 generateResponse=true,以檢索相關段落並生成回應,不進行查詢改寫或代理式規劃。
這是單次 RAG 模式:先檢索一次,再呼叫一次答案生成。當問題和支援內容的範圍已很明確時,這種做法可免去規劃步驟。
比較政策文件中的要求
另一名員工問:「獨資經營者和 LLC 的開戶要求有何不同?根據我們的政策,非居民擁有人是否需要接受額外核查,如需要,具體有哪些?」回答此問題可能需要查閲不同的程序文件和所有權核實指南。
在這個工作流程中,應用程式可以設定 maxAgentIteration=4 和 generateResponse=true,讓系統在生成答案前最多進行三輪規劃。規劃器可以把問題拆分成子查詢、檢索相關證據,並在資訊不足時調整搜尋方式。應以具代表性的問題評估合適的迭代上限,而不應假設數值越高,答案就一定越好。
顯示來源段落,但不生成答案
審核開戶程序的員工,可能需要查看相關政策原文,而不是生成摘要。應用程式設定 maxAgentIteration=0 和 generateResponse=false,以免呼叫語言模型並直接返回段落。接着,應用程式可以顯示這些段落及其來源參考資料,供員工審閲。
三種工作流程都使用 AgenticRetrieveStream。應用程式會選擇迭代上限,以及是否返回生成的答案。選擇模式屬於應用程式邏輯,這個參數不會提供自動路由功能。助理支援政策查詢和比較,但不會批准帳戶,也不會取代銀行的審核及授權流程。
解決方案概覽
以下範例展示完整的代理式請求。之後的章節會以此為基礎,改為單次 RAG 和純檢索模式。
為銀行助理選擇檢索模式
範例程式碼會使用虛構的政策文件,示範三種工作流程。
{
    "messages": [
        {
            "content": {
                "text": "How do account-opening requirements differ for sole proprietors and LLCs, and what additional checks, if any, apply to nonresident owners under our policy?"
            },
            "role": "user"
        }
    ],
    "retrievers": [
        {
            "description": "Knowledge base of account-opening procedures, documentation checklists, and policy guides",
            "configuration": {
                "knowledgeBase": {
                    "knowledgeBaseId": "KB12345678"
                }
            }
        }
    ],
    "generateResponse": true,
    "agenticRetrieveConfiguration": {
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        "maxAgentIteration": 4
    }
}
範例:單次 RAG
只需一行設定變更,就能把基本 RAG 設定由代理式呼叫改為單次呼叫。將 maxAgentIteration 設為 1,並保持答案生成功能開啟。
{
    "messages": [
        {
            "content": {
                "text": "What documents are required to open a business checking account for a sole proprietor?"
            },
            "role": "user"
        }
    ],
    "retrievers": [
        {
            "description": "Knowledge base of account-opening procedures, documentation checklists, and policy guides",
            "configuration": {
                "knowledgeBase": {
                    "knowledgeBaseId": "KB12345678"
                }
            }
        }
    ],
    "generateResponse": true,
    "agenticRetrieveConfiguration": {
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        "maxAgentIteration": 1
    }
}
串流的讀取方式與以往相同,差別在於串流內容:只會進行一次檢索並返回一個以檢索內容為依據的答案,中間不會有規劃追蹤事件。
範例:僅返回段落
如要只進行檢索而不生成答案,請將 maxAgentIteration 設為 0。此數值下必須關閉回應生成功能。
{
    "messages": [
        {
            "content": {
                "text": "Show the policy text for the business account-opening procedure."
            },
            "role": "user"
        }
    ],
    "retrievers": [
        {
            "description": "Knowledge base of account-opening procedures, documentation checklists, and policy guides",
            "configuration": {
                "knowledgeBase": {
                    "knowledgeBaseId": "KB12345678"
                }
            }
        }
    ],
    "generateResponse": false,
    "agenticRetrieveConfiguration": {
        "foundationModelType": "MANAGED",
        "rerankingModelType": "MANAGED",
        "maxAgentIteration": 0
    }
}
這會返回去重後的來源段落,不會生成答案。檢索行為與直接呼叫 Retrieve 相同,但回應格式不同:段落會在串流的 result 事件中返回,不包含 score 或 location 欄位。
結論
透過 AgenticRetrieveStream,你現在可以在 Amazon Bedrock Managed Knowledge Base 中,讓同一個助理結合單次 RAG、代理式檢索和純檢索請求。在銀行範例中,對於開戶檢查清單問題,你可以啟用答案生成並使用 maxAgentIteration=1,以不經規劃呼叫的方式生成答案。比較不同企業架構時,你可以設定 maxAgentIteration=4,讓系統在生成回應前進行更多搜尋。員工需要閲讀政策原文時,你可以設定 maxAgentIteration=0 並關閉答案生成功能,直接返回段落而不呼叫語言模型。應用程式會選擇模式,而員工仍可使用同一個助理。
如要在現有應用程式中採用新模式,請先從自有文件中選取一組具代表性的問題及預期答案。使用同一個知識庫,比較單次 RAG 與目前的代理式設定。量度回應延遲和請求成本,並檢查答案是否正確,以及是否有檢索段落支持。測試問題時,應包括答案涉及多份文件的問題,以及文件無法回答的問題,確保較快的回應不會掩蓋證據不足或缺乏依據的結論。
根據這些結果,為每個工作流程選擇符合品質要求的最低迭代上限。若額外搜尋能改善答案,便保留 Agentic 檢索;若一次檢索已足夠,便使用單次 RAG;若任務是審閲來源,則停用生成。現有要求中設定為 2–5 的值維持不變,因此你可以有選擇地引入新模式,無須重新設計整個應用程式。
如要開始使用,請參閲 AgenticRetrieveStream API 參考資料,在請求中設定 maxAgentIteration 和 generateResponse,然後根據應用程式的問題和回應時間目標評估這些設定。如欲進一步瞭解這項服務,請瀏覽 Amazon Bedrock Managed Knowledge Base 服務頁面。
關於作者

Siddhant Sahu
Siddhant 是 AWS 的高級產品經理,負責領導 Amazon Bedrock Managed Knowledge Base 的產品開發。他專注於建構和推出基礎設施軟件服務,以全代管的資料擷取、解析及 Agentic 搜尋管道處理多模態、多語言的企業資料,並透過混合搜尋、多次檢索、工具使用及嵌入技術等先進功能,提供具成本效益、準確和安全的服務。他的工作協助數以千計的企業客戶和獨立軟件供應商大規模建構 Agent。

Chinmayee Rane
Chinmayee 是 AWS 的全球生成式 AI 專家解決方案架構師,專注於協助機構透過 Amazon Bedrock AgentCore 和 Amazon Quick 實踐 Agentic AI。她與客戶及合作夥伴合作,連繫企業知識、自動化業務工作流程,並將數據轉化為可付諸行動的見解。她的工作涵蓋解決方案架構和實作技術支援,協助團隊從實驗階段邁向實際應用。她具備應用數學和機器學習背景,既有深厚的技術知識,亦清楚著眼於業務成果。工作以外,她喜歡跳莎莎舞和巴恰塔舞。

Josh DeMuth
Josh 是 AWS 的生成式 AI 解決方案架構師。他在科技業工作超過 20 年,當中包括數年從事系統整合,專注於讓不同系統協同運作。現在,他協助客戶建構生成式 AI 應用程式,讓應用程式能與客戶現有的系統和數據協同運作。

Rohan Karhadkar
Rohan 是 Amazon Web Services 的軟件開發工程師。他為 Amazon Bedrock Managed Knowledge Base 和 Amazon Quick 建構 Agentic 檢索系統。他的工作讓 AI Agent 能夠規劃多步搜尋、檢索符合權限設定的企業資料,並產生有根據且附有準確引文的答案。

Qihao Shao
Qihao 是 Amazon Web Services 的高級軟件工程師,負責 Amazon Bedrock Managed Knowledge Base 和 Amazon Quick 的 Agentic 檢索系統。
來源:AWS Machine Learning Blog · aws.amazon.com