端到端管理 Amazon Bedrock 成本:FinOps 與平台團隊操作手冊
Managing Amazon Bedrock costs end to end: A playbook for FinOps and platform teams
這份 AWS Machine Learning Blog 指南提出 Amazon Bedrock 成本管理的五階段操作模式,涵蓋歸因、請求觀測、預算管控、平台預設優化及定期檢視。
文章將 Amazon Bedrock 成本治理拆為歸因、觀測、預算管控、平台優化和定期檢視五步,並比較三種管控層級,提供團隊循序落地的框架。
生成式 AI 的成本管理,是開發應用程式的團隊與負責雲端開支的團隊共同承擔的責任。許多團隊一開始會比較各模型的 Token 費率,並要求應用程式團隊縮短提示詞。這些做法有幫助,但當用量增加時,仍未能解答財務及工程主管關心的問題:這筆開支由哪個團隊產生、用於哪項工作負載,以及是否在核準預算之內?
Agent 型工作負載令這些問題更迫切。對話式助理通常會在用戶每次發言後呼叫模型一次。Agent 工作流程則不同,例如 AI 程式碼助理會規劃修改、讀取檔案、呼叫工具並反覆執行,因此每項工作會發出多次呼叫,而且每次呼叫都會帶上較大的上下文。因此,Token 用量會隨着你賦予工作流程的自主程度,以及它所帶上的上下文大小而增加,而非隨用戶互動次數增加。由於用量取決於工作負載的設計和運作方式,生成式 AI 的成本管理是一門架構及營運管理的專業。公開的平均數值並不能代替你自己的數據:請使用 AWS Pricing Calculator 和 Amazon Bedrock pricing page 模擬費率,並參考本文第 2 步,量度工作負載的實際用量。
解決方法不是改用較便宜的模型或縮短提示詞,而是建立一套營運模式:透過可重複執行的循環,將每筆開支歸屬到負責人;確保每個請求都可觀測;在超支累積前發出預算提示並執行限制;最佳化造成大部分浪費的平台預設設定;並定期檢視整個系統。
本文會分五個步驟,介紹如何管理 Amazon Bedrock 成本:將每筆開支歸屬到負責人、確保每個請求都可觀測、透過預算及執行限制控制開支、最佳化造成大部分可避免開支的平台預設設定,以及定期檢視,將數據轉化為決策。這套方法以 AWS 基礎元件建構,你可以按需要自訂,並應用於自己的環境。本文適合兩類讀者:負責成本歸屬、內部成本分攤、預算及異常檢視的 FinOps 從業人員,以及負責日誌記錄、請求中繼資料、執行限制及路由預設設定的平台工程團隊。
一覽營運模式
五個階段,循環執行。歸屬:Amazon Bedrock 的每筆開支,都會在帳單處理流程中對應到一個身分、團隊及應用程式。觀測:每個請求都會記錄足夠的中繼資料,以説明開支由何而來。執行限制:預算必須具備實際約束力,至少要設定提示,並在風險需要時設置硬性封鎖。最佳化:透過平台預設設定(模型路由、快取、Token 限制)集中減少浪費,而不是要求每個團隊自行小心控制。營運:透過簡明的評分表及定期檢視,將數據轉化為決策。FinOps 負責第一及第五階段;平台工程負責第二至第四階段;檢視工作由雙方共同進行。這些階段經過刻意安排,各階段都建基於之前的階段。若團隊未先做好成本歸屬和可觀測性,就直接着手最佳化,只是在盲目猜測。
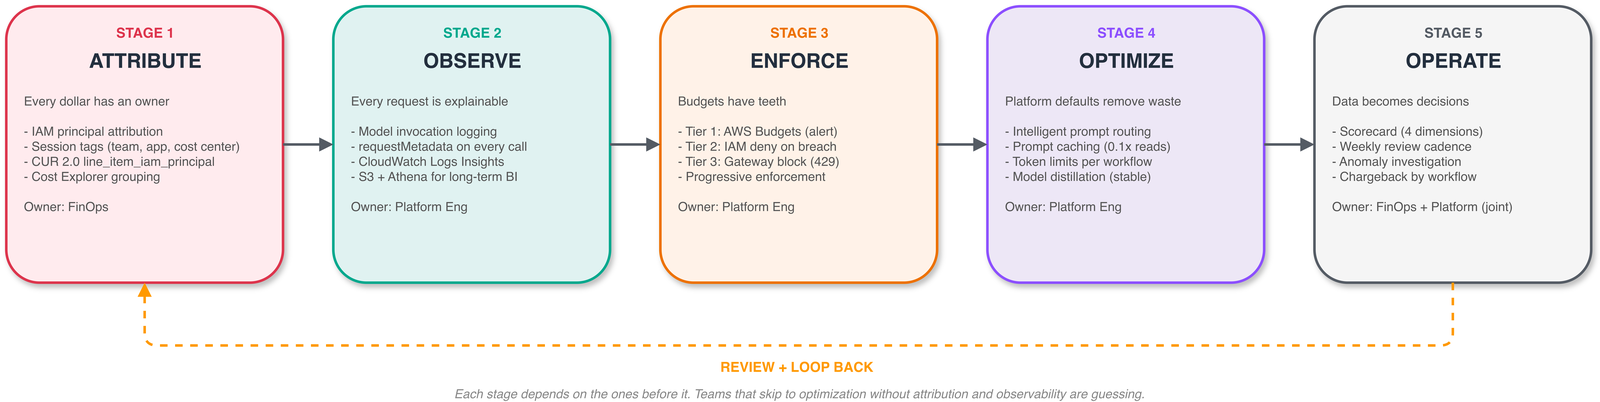
圖 1:以持續循環方式運作的五階段營運模式
階段 1:將每筆開支歸屬到負責人
無法歸因的成本便無法管理,而後續所有工作(成本轉嫁、預算、管控、異常偵測)都取決於這個階段。基礎是 Amazon Bedrock 的精細成本歸因(請參閲 Introducing granular cost attribution for Amazon Bedrock):Amazon Bedrock 會自動將所有模型的推理成本歸因至發出呼叫的 AWS Identity and Access Management (IAM) 主體,無需管理任何資源。呼叫者的 ARN 會顯示在 AWS Cost and Usage Report (CUR) 2.0 的 line_item_iam_principal 欄,涵蓋 IAM 用戶、角色、聯合身分及 API 金鑰。
設定分為四個步驟:
- 在 CUR 2.0 數據匯出中啟用 IAM 主體資料。
- 為 IAM 主體加上業務維度標籤,例如團隊、應用程式及成本中心。若使用聯合存取,請設定身分提供者,透過 OIDC 或 SAML 聲明傳遞工作階段名稱及標籤。
- 在 AWS Billing(主控台或
UpdateCostAllocationTagsStatusAPI)中,將這些標籤啟用為成本分配標籤。 - 分析這些標籤:啟用後 24–48 小時內,標籤便會以
iamPrincipal/為前綴顯示在 CUR 2.0 中(例如iamPrincipal/team),並會在 AWS Cost Explorer 的 IAM 類別下顯示,可按團隊、應用程式或成本中心篩選及分組。
這是達到發票核算級別的逐一身分歸因,無需自訂基礎設施。
共用角色問題
最值得關注的是共用角色問題,因為大多數平台都會在這個環節悄然失去歸因資訊。若大型語言模型(LLM)閘道透過單一 IAM 角色呼叫 Amazon Bedrock,每一筆費用都會歸因至該角色,完全無法按用戶查看成本。解決方法是按用戶管理工作階段。閘道會為每位用戶各自擔任一次 Amazon Bedrock 呼叫角色,將用戶身分設為角色工作階段名稱,並將用戶屬性設為工作階段標籤,然後將這些憑證快取最多一小時(每位用戶每小時呼叫一次 AWS Security Token Service (AWS STS),而非每次請求都呼叫)。
這需要兩個角色:一個閘道執行角色,具備 sts:AssumeRole 和 sts:TagSession 權限;以及閘道所擔任的 Amazon Bedrock 呼叫角色。結果是產生 line_item_iam_principal 條目,例如 assumed-role/BedrockRuntimeRole/gw-alex,每筆都帶有該用戶的標籤,讓共用閘道背後的用戶及租戶層級歸因得以恢復。
import boto3

sts = boto3.client("sts")

# One call per user; cache the returned credentials up to 1 hour
response = sts.assume_role(
    RoleArn="arn:aws:iam::123456789012:role/BedrockRuntimeRole",
    RoleSessionName="gw-alex", # the user, not the gateway
    Tags=[
        {"Key": "team", "Value": "sales-ai"},
        {"Key": "application", "Value": "renewal-agent"},
        {"Key": "costCenter", "Value": "CC-2041"}
    ]
)
應用程式推理設定檔與 Projects
Amazon Bedrock 還提供兩種歸因機制,分別適用於不同模式。應用程式推理設定檔是在 bedrock-runtime 端點上預先建立、按應用程式劃分的資源,並帶有成本分配標籤。每個 AWS 區域內,需為每個應用程式及每個模型建立一個設定檔;呼叫方會參照設定檔 ARN。這適合應用程式和模型數量較少且穩定的團隊。Projects 與工作區則適用於 bedrock-mantle 端點(Responses API、Chat Completions API)。Project 不會綁定特定模型,因此單一 project ID 可涵蓋多個模型,適合模型使用情況經常變動的團隊。你可在初始化用戶端時傳入 project ID,其標籤便會傳入 CUR 2.0 和 Cost Explorer(請參閲 Manage AI costs with Amazon Bedrock Projects)。Projects 是在 Amazon Bedrock 上為 OpenAI 相容工作負載進行歸因的途徑。
對於 bedrock-runtime 工作負載,我們建議以工作階段標籤進行 IAM 主體歸屬,作為主要方法。這種方法可配合你的身分識別系統擴展,無需預先建立資源,並涵蓋所有模型及 API 操作。如果少數穩定的業務部門需要可供發票核算的帳單分隔,且不想更改身分識別設計,應用程式推理設定檔便很合適。對於使用 Responses API 或 Chat Completions API 的 bedrock-mantle 工作負載,則可使用專案。
階段 2:讓每個請求都可觀察
CUR 會告訴你誰產生了開支;呼叫記錄則會告訴你發生了甚麼事。Amazon Bedrock 支援將請求資料、回應資料及中繼資料記錄至 Amazon CloudWatch Logs、Amazon Simple Storage Service (Amazon S3),或兩者兼用的模型呼叫記錄。使用 Amazon CloudWatch 進行快速營運查詢,並透過 S3 和 Amazon Athena 長期存取商業智能 (BI) 資料。應將記錄視為基礎設施,而非手動開關:透過程式碼配置日誌羣組或儲存貯體,設定保留及加密政策,並在環境設定期間驗證記錄是否成功傳送。如果記錄功能只在開發環境啟用,或只在一個區域啟用,使用量一旦增加,你的成本管理方案便會變得零散。
記錄亦可彌補延遲差距:CUR 的歸屬資料約有 24 小時延遲,但 CloudWatch 配合 OpenTelemetry 可建立接近即時的儀錶板,在幾分鐘內顯示每位開發人員的支出(使用 CloudWatch 和 OpenTelemetry 分析 Claude Code 用量展示了完整流程)。
使用請求中繼資料進行工作負載層級歸屬
原始記錄可回答身分層級的問題。若要回答工作負載層級的問題(例如哪些功能、工作流程或租戶產生了這些 token),每次呼叫都要加入請求中繼資料。Amazon Bedrock 會在呼叫記錄中擷取這些中繼資料,以供日後分析:
以下範例透過美國跨區域推理設定檔,在 Amazon Bedrock 上使用 Anthropic Claude Sonnet 5.5。如需完整模型清單,請參閲Amazon Bedrock 支援的基礎模型。如需各區域的可用情況,請參閲Amazon Bedrock 各 AWS 區域的模型支援情況。
response = client.converse(
    modelId="us.anthropic.claude-sonnet-5-5",
    messages=[...],
    requestMetadata={
        "application": "renewal-copilot",
        "workflow": "renewal-risk-summary",
        "tenant": "enterprise-sales",
        "agent": "renewal-agent"
    }
)
Amazon Bedrock 不會強制執行請求中繼資料;如果每個應用程式各自處理,團隊很快便會採用不一致的結構描述。平台團隊應在共用 SDK 包裝程式或閘道中集中加入強制中繼資料、統一欄位集合,並將中繼資料涵蓋率視為平台健康指標。
診斷查詢
設定好記錄和中繼資料後,CloudWatch Logs Insights 便可回答常見問題。哪些人使用最多 token:
fields @timestamp, identity.arn as caller, modelId,
input.inputTokenCount as inTokens,
output.outputTokenCount as outTokens
| stats sum(inTokens + outTokens) as totalTokens,
count(*) as calls
by caller, modelId
| sort totalTokens desc
| limit 25
將相同查詢改為按 requestMetadata.application 和 requestMetadata.workflow 分組,而非按 caller 分組,便會產生工作負載層級的排行榜:當分攤費用的討論開始時,產品和工程團隊便會向 FinOps 索取這個檢視結果。
注意:前述查詢中所示的欄位路徑僅供説明。請根據你的呼叫記錄結構描述進行核實;結構描述可能因模型、API 操作及記錄設定而異。
階段 3:執行預算管控
具備歸屬和可觀察性後,管控方式便成為架構選擇,而非空想。共有三個可行級別。合適的級別取決於你的支出增長速度、對超支的風險承受度,以及工具連接至 Amazon Bedrock 的方式。
級別 1:監察並發出警示(不封鎖)
Amazon Bedrock 會自動將主體身分寫入帳單處理流程。你可以在此基礎上設定 AWS Budgets 閾值提醒,並透過第 2 階段的 OpenTelemetry 儀錶板彌補 CUR 數據延遲 24 小時所造成的日常可視性缺口。無需部署任何元件,採用 AWS 原生帳單功能,而且不會增加推理呼叫的延遲。這適用於直接呼叫 Amazon Bedrock 的工具。這種方式無法強制即時停止支出,因此只能在問題發生後才察覺。適合剛開始採用的團隊,因為提醒加上人手介入已經足夠。兩篇建置指南介紹了相關做法:限制 Bedrock 用量並控制成本,以及 深入探討如何在 Claude Code 中使用 AWS Budgets 和 Tags 管理 Bedrock。
第 2 層:IAM 標籤強制執行(超額時拒絕)
彙總 AWS Lambda 函式會根據呼叫記錄數據,在 Amazon DynamoDB 中累計每位用戶的 token 數量和金額。當用戶超出限額時,函式會將其身分加入共用 IAM 拒絕政策(拒絕 bedrock:*),直至每月重設或管理員手動覆寫。這項強制措施完全透過 IAM 和 Amazon Bedrock 記錄執行,不會在推理路徑中加入第三方元件,而且適用於直接呼叫 Amazon Bedrock 的工具。AWS Solutions Library 中的 Claude Code 搭配 Amazon Bedrock 指南提供可部署的方案。該方案會在發出憑證時,檢查每位用戶的用量是否超出個人及團隊限額;用戶一旦超出限額,便不會獲發憑證。由於檢查依據的是用戶端發出的用量遙測資料,所得數據可能與 CUR 不同。無論採用哪種形式,強制措施都屬非同步。若透過更新 IAM 政策封鎖用戶,封鎖會在超額呼叫後數秒至數分鐘生效;若透過憑證檢查,則會在下次更新憑證時生效。整條處理流程由平台團隊負責。此層適合需要實際強制執行、可以接受延遲,而且希望避免在數據路徑中使用第三方軟件的團隊。
第 3 層:閘道強制執行(同步封鎖)
閘道位於推理數據路徑中,可同步執行預算限制,在用戶或團隊超出限額時即時回傳 HTTP 429。你可以獲得亞秒級封鎖、按用戶設定的模型允許清單、token 速率限制,以及由中央強制執行的路由規則。代價是必須部署、擴展並進行安全審查的數據路徑元件。用戶端必須設定為透過閘道傳送請求。
對於 Claude Code 和 Claude Desktop 的大規模部署,官方建議使用 Claude apps gateway for AWS。它內置於 CLI 二進制檔中,以單一無狀態容器執行,並由 PostgreSQL 支援。它開箱即提供 OIDC 身分識別、由中央管理的政策、OpenTelemetry 遙測資料、多區域 Amazon Bedrock 路由,以及按用戶/羣組/組織設定的支出上限。對於涉及多個供應商的混合模型工作負載,通用閘道仍然是合適選擇:透過 Amazon Elastic Container Service (Amazon ECS) on AWS Fargate 參考架構部署 LiteLLM,或採用 為 Amazon Bedrock 建立主動式 AI 成本管理系統(第 2 部分)中介紹的無伺服器替代方案。
選擇層級
兩項因素最為關鍵。
連線方式:如果開發人員不經代理伺服器,直接呼叫 Amazon Bedrock,便只有第 1 層和第 2 層可行。
支出速度:如果每月支出已達數百萬,現在就應建立管控機制。如果警示措施還能再維持一個季度,應先投資於第 1 和第 2 階段,待數據顯示有需要時再加入管控機制。
大多數機構應分階段推行:先從第 1 級開始觀察,然後逐步提升。三者都應視為過渡方案,而非終點:Well-Architected Agentic AI Lens 已將代理成本治理明確列為核心架構考量,而第 1 階段建立的歸因基礎,正是任何受管理管控措施的根基。
第 4 階段:最佳化預設設定
Amazon Bedrock 的大部分浪費並非源自個別用戶粗心,而是無人設定的平台預設值。影響最大的兩項措施都由平台控制。
模型路由
並非每項任務都需要前沿模型。常規程式碼補全(樣板程式碼、程式碼檢查建議、小型重構)可使用更小、更便宜的模型處理,將較高品質的模型留給複雜推理;這可透過同一模型系列中的智能提示詞路由,或在閘道設定路由規則來實現(完整流程説明請參閲 透過 Amazon Bedrock 智能提示詞路由和提示詞快取降低成本和延遲)。哪些工作流程可以改用較小模型,需要以實證判斷:從第 2 階段取得工作負載排行榜,針對排名靠前的項目,以較便宜的模型進行品質評估,再將通過評估的項目改用該模型。對於代理式編碼代理羣而言,樣板程式碼佔大部分呼叫量,因此將超過一半的呼叫交由較便宜的模型處理,是可達成的目標。
提示詞快取
提示詞快取可降低穩定且重複的前綴所帶來的成本。截至 2026 年 10 月,已公佈的 Amazon Bedrock 定價顯示,在 US East (N. Virginia) 使用 Anthropic Claude 模型時,採用 5 分鐘存留時間(TTL)的快取寫入按基本輸入費率的 1.25 倍計費(採用 1 小時 TTL 則為 2 倍)。Claude Sonnet 4.6 和 Claude Haiku 4.5 的快取讀取按基本輸入費率的 0.1 倍計費;Claude Sonnet 5.5 和 Claude Opus 5.5 則按 0.05 倍計費。請查閲定價頁面,確認你所用的模型和區域,因為這些倍數會因模型而異,也可能變更。損益平衡計算比團隊預想的更有利。採用 5 分鐘 TTL 時,重用一次已足以抵銷寫入成本;對穩定前綴進行十次呼叫,成本約為未使用快取時的五分之一(讀取費率為 0.1 倍時約為 22%,0.05 倍時約為 17%)。唯一不划算的情況,是寫入後從未再讀取:採用 5 分鐘 TTL 時會多花 25%,採用 1 小時 TTL 時成本則會加倍。因此,平台儀錶板應按工作流程追蹤快取讀取量與快取寫入量。讀取比例偏低,表示前綴實際上並不穩定(通常是因為快取點之前加入了時間戳記或工作階段 ID)。
符合條件的項目可直接從呼叫日誌中找出:
fields requestMetadata.workflow as workflow, modelId,
input.inputTokenCount as inTokens
| stats count(*) as calls,
avg(inTokens) as avgInputTokens,
sum(inTokens) as totalInputTokens
by workflow, modelId
| filter calls > 50 and avgInputTokens > 2000
| sort totalInputTokens desc
| limit 25注意:前述查詢中的欄位路徑僅供參考。請根據你的呼叫日誌結構描述加以確認;該結構描述可能因模型、API 操作和日誌設定而異。
應用程式層級最佳化
第三類節省成本的方法(改用即時檢索而非塞入大量上下文、精簡長對話、將穩定且高流量的工作流程蒸餾至較小模型)屬於應用程式團隊的職責,而非平台團隊。平台的工作是讓這些節省一目瞭然:公佈各工作流程的 token 用量排行榜,為每個模型和工作流程設定 token 上限,並讓負責高成本工作流程的團隊清楚瞭解其成本狀況。
第 5 階段:運作循環
首四個階段會產生數據。這個階段則把數據轉化為決策。平台團隊會持續運作健康狀況儀錶板,監察四項指標:
- 模型組合:呼叫了哪些模型,以及呼叫頻率,這是衡量路由紀律的直接指標。
- 請求失敗率:錯誤、節流和逾時。每次重試都會增加延遲;如果用戶端逾時,但服務端仍完成請求,費用可能會計算兩次:一次是已放棄的呼叫,另一次是重試。
- 快取效能:第 4 階段的讀取與寫入比例。
- 中繼資料覆蓋率:具備完整中繼資料的正式環境呼叫所佔百分比。每個未涵蓋的呼叫都是歸因盲點,會在不知不覺間令其他所有數據的準確度下降。
當某項指標出現偏差時,補救方法是更改政策(路由規則、Token 限制、中繼資料強制要求),而不是發電郵提醒團隊小心處理。
成本循環
FinOps 會使用相同數據運行成本循環。歸因清晰後,異常偵測便會成為調查流程,而不再引發全員恐慌:已標記團隊或應用程式的開支突然上升時,只需查閲第 2 階段的排行榜,而不必召開緊急應變會議。成本分攤則根據 CUR 按團隊和應用程式分組進行。
評分卡
以下門檻是起始參考值,而非硬性規定。採用為政策前,請根據自己的資源羣組數據和定價級別進行調整。
| 維度 | 指標 | 綠色 | 黃色 | 紅色 |
| 單位經濟效益 | 每項成功成果的成本 | ≤ 預算 | 預算的 1–1.5 倍 | > 預算的 1.5 倍 |
| 每位開發人員的成本 | 每位開發人員每日開支 | <$100 | $100–$300 | >$300 |
| 模型路由 | 呼叫成本效益較高模型的百分比 | >50% | 30–50% | <30% |
| 快取效率 | 快取讀取命中率 | >60% | 30–60% | <30% |
綠色代表工作負載在其經濟效益範圍內運作。黃色代表路由或快取紀律正在鬆懈。紅色代表開支集中於高階模型或未經快取的內容;第 3 和第 4 階段的管控措施就是補救方法。請按固定週期檢視這份評分卡(高變動資源羣組每週一次,其他則每兩週一次),並將其視為 FinOps 與平台團隊共同作出決策的依據。
總結
本文介紹瞭如何建立五階段營運模式,將 Amazon Bedrock 開支從失控狀態轉變為全面管治:
- 歸因:使用 IAM 主體標籤、工作階段標籤和 CUR 2.0,將每筆開支歸屬至負責人。
- 觀察:透過模型調用記錄和已標記的請求中繼資料,觀察每項請求。
- 執行管控:按風險選擇預算管控層級:僅監察、超出預算時由 IAM 拒絕,或由同步閘道封鎖。
- 最佳化:透過智能提示詞路由和提示詞快取,最佳化平台預設設定,集中消除浪費。
- 營運:建立評分卡和定期檢視機制,將遙測數據轉化為政策決策。
留意這份評分表的第一行:每項成功成果的成本,而非每次呼叫的成本。這項區別正是本操作指南的交接點。這裏介紹的方法能讓 Amazon Bedrock 的支出清晰可見、可歸屬、設有上限且有效率,但即使工作流程效率極高,也未必值得執行。要判斷是否值得,就要將 Agent 與其取代的人工作業流程作比較並進行衡量;這屬於產品和分析工作,而非 FinOps 的範疇。成本平台所提供的是基礎:清晰的成本歸屬資料和按工作流程劃分的成本數據,正是成果衡量所需的輸入資料。
建置這五個階段後,你便能從頭到尾回答:誰用了這筆支出、原因是甚麼,以及支出是否受到控制。這就是管理 Amazon Bedrock 成本的意義,也是每月檢視帳單與建立營運模式之間的分別。
如要開始,請部署Claude Code 搭配 Amazon Bedrock 的指引參考架構,涵蓋第 1–3 階段,然後參考成本歸屬最佳實務文件設定標籤策略。
作者簡介

Aswath Ram A Srinivasan
Aswath 是 Amazon Bedrock 的高級專家解決方案架構師,專注於核心模型、功能,以及成本優化和成本歸屬。他協助 ISV 和策略性客戶解決使用 Amazon Bedrock 時遇到的挑戰。他與企業團隊合作,負責設計推理架構,在效能、成本和營運簡易性之間取得平衡,並以負責任的方式推進工作。閒暇時,他是一名攝影師,也喜歡閲讀神經符號 AI 和負責任 AI 相關的科學期刊論文。

Aamna Najmi
Aamna 是生成式 AI 高級專家解決方案架構師,專注於 Anthropic 模型,以及在 Amazon Bedrock 上大規模實現生成式 AI 系統的營運化與管治。她協助 ISV 解決挑戰、擁抱創新,並透過 Amazon Bedrock 開拓新的商機。閒暇時,她會實踐自己對烹飪實驗和探索新地方的熱愛。

Ajit Mahareddy
Ajit 是經驗豐富的產品及市場推廣(GTM)領導者,在產品管理、工程和市場推廣方面擁有超過 20 年經驗。在現職之前,Ajit 曾在 Uber、Turing 和 eHealth 等知名科技公司領導產品管理工作,負責打造 AI/ML 產品。他熱衷於推動生成式 AI 技術發展,並以生成式 AI 帶來實際影響。

Benedict Augustine
Benedict 是一位不利的產品 GTM 領導者,一直與使用 Amazon Bedrock 的頂級 ISV 合作。
來源:AWS Machine Learning Blog · aws.amazon.com