Amazon SageMaker AI 推出跨區域推理路由功能
Keep inference running through regional capacity shortfalls with cross-Region inference routing in Amazon SageMaker AI
Amazon SageMaker AI 推出跨區域推理路由,讓應用程式透過單一入口呼叫多個 AWS 區域及帳戶內的既有端點和推理元件。路由器優先使用本區域目的地,在目的地無法可靠服務時將新請求轉往其他目的地,並在恢復後逐步切回。
文章拆解路由器如何按目的地健康狀態跨區分流並逐步回切,並交代重試條件、流量上限及部署限制,呈現功能的韌性設計邊界。
在多個 AWS 區域提供模型服務,是實現高可用性推理的成熟模式:當某個區域的 GPU 容量不足時,請求便會轉送至另一個區域。這種模式説來簡單,實際操作卻不容易。直到現在,如果你透過 Amazon SageMaker AI 託管端點提供模型服務,跨區域路由仍須自行建置。
今天,我們推出 Amazon SageMaker AI 的跨區域推理路由。這項功能使用一種名為推理路由器的新資源,讓你的應用程式透過單一呼叫路徑,連接你已在一個或多個 AWS 區域及 AWS 帳戶中執行的端點和推理元件。你只需註冊提供模型服務的目的地,應用程式便會呼叫路由器,而非指定某個端點。只要本地目的地運作正常,路由器便會將請求留在所在區域;若本地目的地無法可靠地提供服務,便會把新請求轉送至另一個已註冊的目的地,並在故障復原後逐步恢復流量。
本文將説明跨區域推理路由如何決定每個請求的執行位置,並以同一模型部署在兩個區域為例,介紹監控、限制及費用。如要了解服務多個模型的跨帳戶部署,請參閲 Salesforce 如何透過 Amazon SageMaker AI 的跨區域推理路由,推進全球規模的模型服務。
當某個區域的容量不足時
SageMaker AI 端點會在單一 AWS 區域及帳戶中執行。當自動調整規模無法新增端點所需類型的執行個體時,即使另一個區域中同一模型仍有剩餘容量,請求也會遭到限流或逾時。要使用該區域的容量,你的應用程式必須偵測端點是否運作不暢、判斷哪些錯誤可以安全重試而不會重複執行模型、在故障復原後將流量切回而不造成反覆切換,並管理對其他帳戶中端點的存取權限。這些程式碼位於每個請求的關鍵路徑上,而每個跨區域提供模型服務的團隊都要維護自己的版本。
跨區域推理路由的運作方式
跨區域推理路由建基於幾個核心概念:
- 由你決定模型可在哪些位置執行 – 對於每個模型,你可以選擇路由器可能使用的端點和推理元件。
- 由 SageMaker AI 決定哪個目的地處理每個請求 – 路由器會優先使用所在區域,只有在本地目的地無法可靠地提供服務時,才會把新請求轉送至另一個目的地。
- 你的端點維持不變 – 你可像現在一樣部署端點,使用相同的模型、設定、執行個體集區及自動調整規模。直接呼叫
InvokeEndpoint仍然有效,而路由器會像InvokeEndpoint一樣,原樣傳遞InferenceId和CustomAttributes。 - 你可以查看每項決策 – 每個即時回應都會告知你哪個目的地處理了請求,以及原因。
以下幾個術語用來描述各個部分:
- 推理路由器 – 你帳戶中的區域級 SageMaker AI 資源,應用程式會呼叫此資源。
- 路由目標 – 路由器上某個邏輯模型的名稱,例如
fraud-model。一個路由器可包含多個路由目標,各目標會獨立進行故障轉移。 - 目的地 – 在路由目標下註冊的即時端點、推理元件或非同步端點,並以完整的 Amazon 資源名稱 (ARN) 識別,讓路由器得知其區域和帳戶。路由目標可包含即時目的地(可混合來自不同區域和帳戶的端點及推理元件),或只包含非同步端點。
- 本地目的地 – 位於路由器所在區域的目的地;只要狀況正常,便會優先使用。
- 路由原因 – 隨每個即時回應傳回的值,用來説明請求被路由至何處及原因。
你建立路由器的區域就是其本地區域。如要優先使用其他區域,請在該區域建立路由器。路由器不會建立容量、擴展端點、部署模型,亦不會複製模型構件和容器映像。每個目的地都必須已在其所在區域運作。
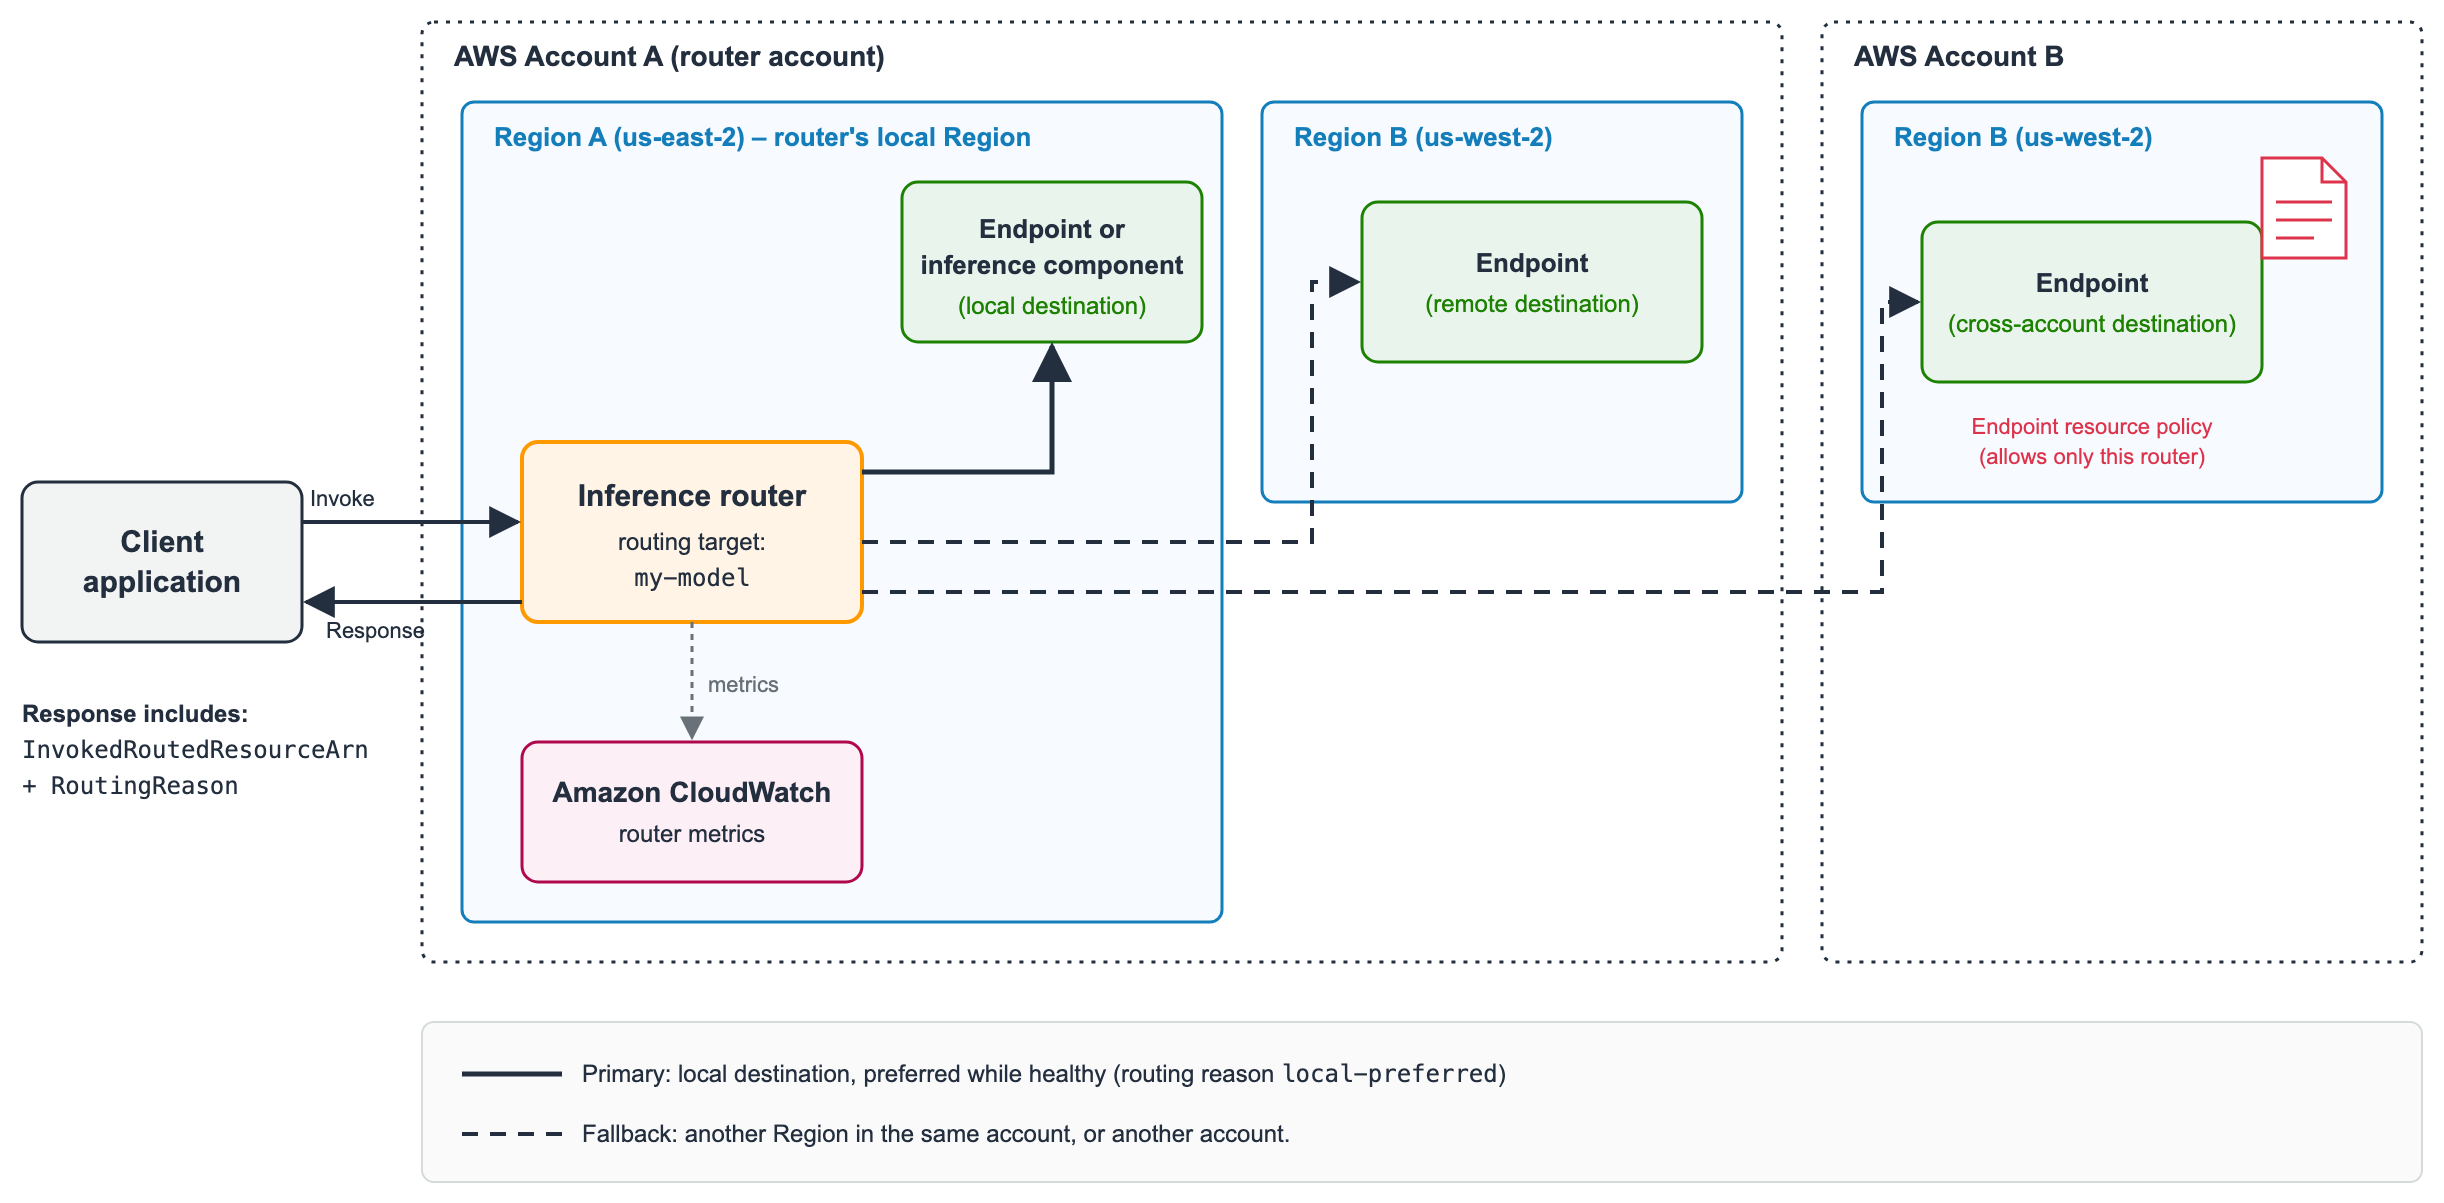
圖 1:每個請求都會傳送至狀況正常的目的地,路由器會優先選擇位於自身區域的目的地
路由決策的方式
路由器只會考慮已在路由目標註冊,而且獲授權可呼叫的目的地。在這些目的地之中,路由器會優先選擇位於自身區域的目的地;如果有多個本地目的地狀況正常,則會平均分配請求。只有在本地目的地無法可靠地處理請求時,請求才會離開該區域。為了判斷這一點,SageMaker AI 會根據每個目的地近期處理的請求,計算其健康分數;這些請求均在目的地所在區域內量度。伺服器錯誤 (5xx)、節流和逾時都會降低分數。SageMaker AI 平台造成的錯誤(例如健康檢查失敗)對分數的影響最大。由請求本身造成的錯誤(例如輸入無效)不會降低分數,因為相同請求在任何區域都會失敗。模型延遲不會納入計算,因此只要端點持續成功回應,就會繼續接收流量。執行個體啟動失敗,或端點執行中的執行個體數少於自動調整目標等訊號,會令路由器更快作出反應,但只有在目的地開始出現請求失敗後才會如此。
路由器會評估每個目的地的健康狀況,並在 Amazon CloudWatch 上以三種狀態之一發布結果。healthy目的地會正常處理請求。overloaded目的地仍會處理請求,但路由器會將部分流量轉移。degraded目的地正發生故障或無法處理請求,因此路由器會將大部分流量轉移,並保留少量流量以偵測是否恢復。

圖 2:各目的地健康狀態如何改變路由器傳送給它的流量
SageMaker AI 會管理故障轉移的門檻和時間安排,因此你無須調整任何門檻。如果遠端目的地的健康資訊過時,路由器會將流量留在自身區域,因此監察資料出現空檔不會自行觸發流量轉移。
流量何時轉移,以及何時返回
請求失敗得越多,轉移的流量就越多,因此目的地不必先完全故障。錯誤持續發生後,流量約在一分鐘內開始轉移;流量較少的目的地則可能需要更長時間。離開本地區域的流量會按健康狀況比例,分配至狀況正常的遠端目的地。你不能設定權重或後備次序。目的地恢復後,流量會在數分鐘內逐步返回,速度比轉移時慢。進行中的請求不會被中斷。
當某個目的地未有執行模型便無法處理即時請求時,路由器會將該請求改送至另一個目的地,並重試一次。這包括限流、503 錯誤、模型尚未就緒、因跨區域流量上限而遭拒,或目的地拒絕存取等情況。路由器絕不會重試逾時、500 錯誤或模型錯誤。
對於非同步請求,路由器會逐一嘗試每個符合資格的目的地,並優先嘗試本地目的地,直至其中一個接受請求。
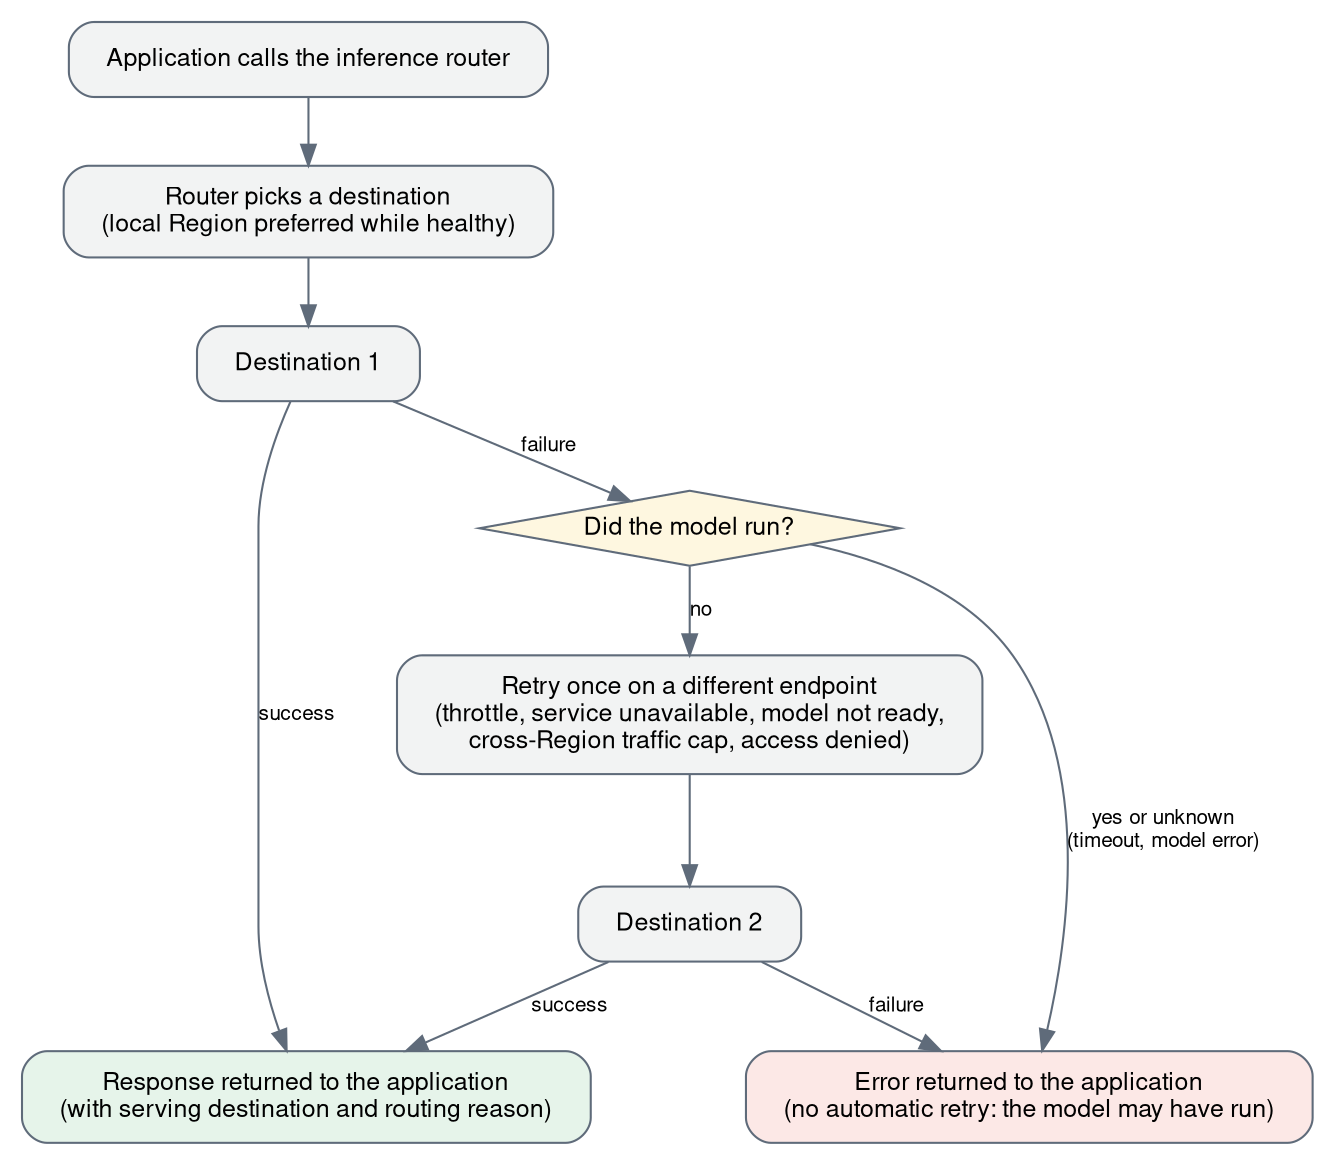
圖 3:只有在模型未有執行時,路由器才會將即時請求改送至另一個目的地並重試一次
圖 4 顯示我們其中一項測試中,使用測試模型的請求由哪些位置處理。
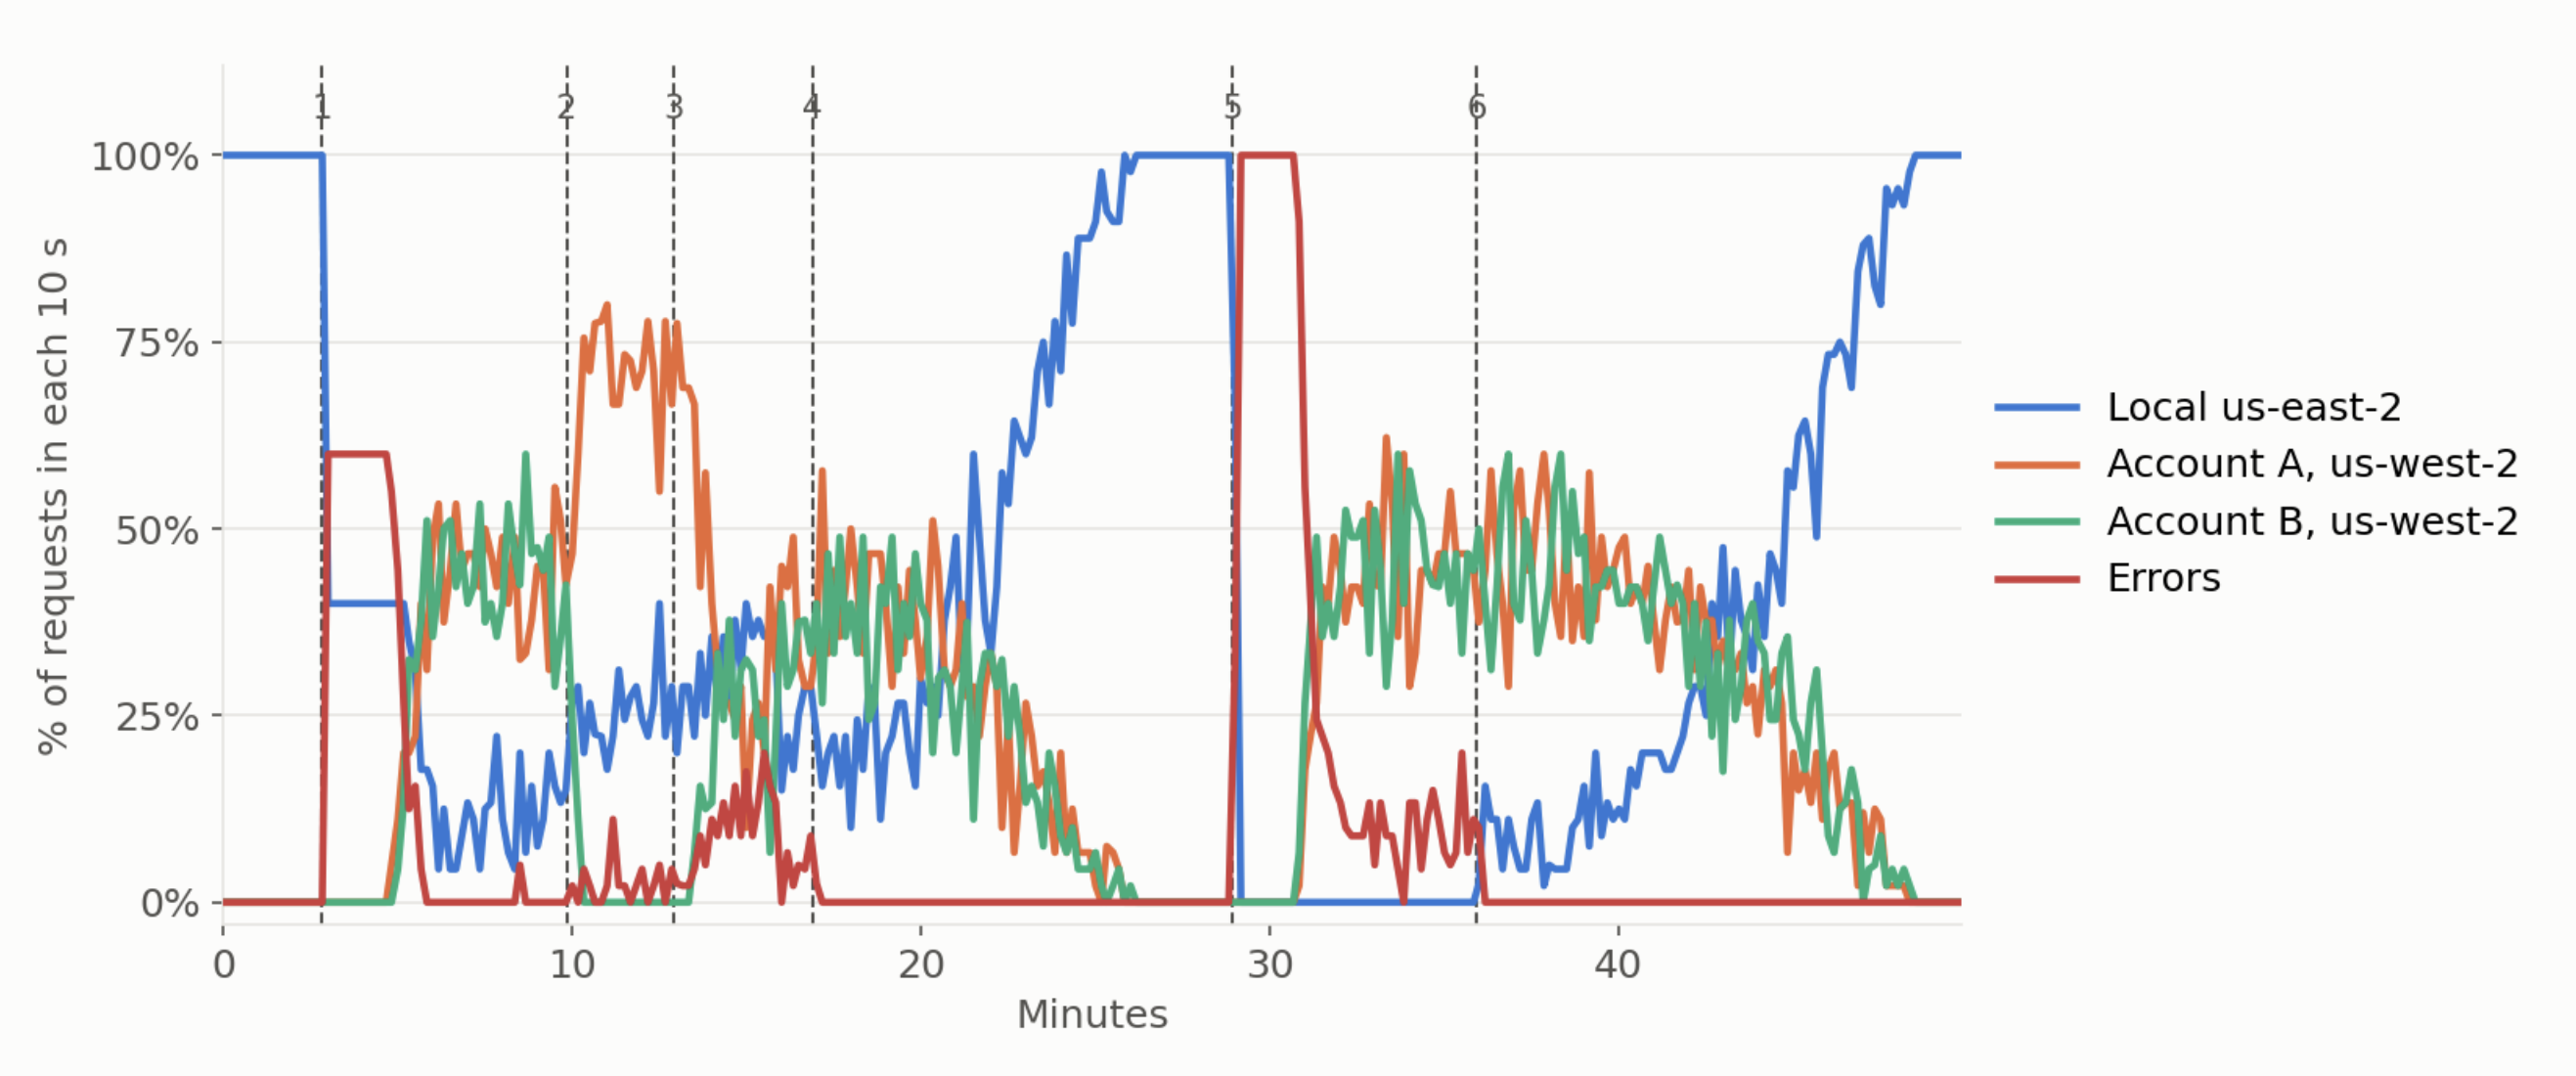
圖 4:本地端點超載、另一個帳戶中的目的地失去並重新取得存取權,以及本地端點恢復期間,請求由何處處理
可路由的項目
以下用例展示在 Amazon SageMaker AI 中使用跨區域推理路由的常見方式。
- 在某個區域 GPU 容量不足時維持服務。 在流量高峯期間,若 US East (Ohio) 的 G 系列執行個體類型容量不足,令請求開始遭到限流,路由器便會將新請求轉送至 US West (Oregon) 中使用相同模型的端點,由自動擴展機制吸收超出的流量;待 US East (Ohio) 恢復後,再逐步將流量轉回。
- 跨不同 AWS 帳戶所擁有的端點進行路由。 若中央平台帳戶擁有路由器,而其他帳戶擁有端點,每個端點擁有者都會授予一個指定名稱的路由器存取權,而請求只會透過該路由器到達這些端點。我們會在下方的清單後説明設定方法。
- 透過一個路由器提供多個模型。 建立一個路由器,並為每個模型建立一個路由目標;每個路由目標都列出該模型的目的地,並在每項請求中傳入路由目標名稱。每個模型都會獨立切換至備用目的地。
- 將路由器置於自有閘道之後。 如果你營運 API 或模型閘道,可以將其 SageMaker AI 整合設定為指向路由器,讓 SageMaker AI 為 SageMaker 託管的模型選擇區域,而閘道則決定何時改用其他供應商。例如,請參閲Salesforce 的文章。
- 路由非同步請求。 路由器所屬帳戶或其他帳戶中的非同步端點,都可以作為目的地。應用程式將路由目標名稱和 Amazon Simple Storage Service (Amazon S3) 輸入位置傳送至
InvokeInferenceRouterAsync,並取得InferenceId、輸出位置和失敗位置,與使用InvokeEndpointAsync時一樣。 - 避免接收端點受其他區域的溢出流量影響。 對於即時端點,你可以設定可選的跨區域流量上限,限制來自其他區域的請求只能使用端點部分容量,讓端點的本地呼叫端使用其餘容量。我們會在本節稍後説明詳情。
如果目的地與路由器分屬不同帳戶,兩個帳戶都必須允許每項請求。在端點一方,擁有者會附加資源型政策,允許路由器帳戶呼叫端點;而 sagemaker:SourceInferenceRouterArn 條件索引鍵則會限制存取權只授予一個指定名稱的路由器。以下政策只允許帳戶 444455556666 中的 my-router 呼叫端點。政策的第二個陳述式沒有路由器條件,並允許路由器帳戶讀取端點狀態。若沒有該陳述式,目的地的狀態便會顯示為未知。
{
  "Version": "2012-10-17",
  "Statement": [
    {
      "Sid": "AllowOneRouter",
      "Effect": "Allow",
      "Principal": {"AWS": "arn:aws:iam::444455556666:root"},
      "Action": ["sagemaker:InvokeEndpoint", "sagemaker:InvokeEndpointAsync"],
      "Resource": "arn:aws:sagemaker:us-west-2:111122223333:endpoint/my-endpoint",
      "Condition": {"ArnEquals": {
        "sagemaker:SourceInferenceRouterArn": "arn:aws:sagemaker:us-east-2:444455556666:inference-router/my-router"}}
    },
    {
      "Sid": "AllowStatusVisibility",
      "Effect": "Allow",
      "Principal": {"AWS": "arn:aws:iam::444455556666:root"},
      "Action": "sagemaker:DescribeEndpoint",
      "Resource": "arn:aws:sagemaker:us-west-2:111122223333:endpoint/my-endpoint"
    }
  ]
}
在路由器帳戶中,呼叫者需要在路由器上有 sagemaker:InvokeInferenceRouter(或 sagemaker:InvokeInferenceRouterAsync),並在每個目的地上有 sagemaker:InvokeEndpoint(或 sagemaker:InvokeEndpointAsync),因為路由器會代替呼叫者呼叫每個目的地。路由器絕不會讓呼叫者存取他們無法直接呼叫的端點。若要讓 DescribeInferenceRouter 回報每個目的地的狀態,呼叫者亦需要在端點上有 sagemaker:DescribeEndpoint,並在推理元件上有 sagemaker:DescribeInferenceComponent。其他帳戶中的應用程式會透過在路由器帳戶中承擔角色來呼叫路由器。逐步操作説明請參閲 Salesforce 如何透過 Amazon SageMaker AI 跨區域推理路由,推進全球規模的模型服務 及 跨帳戶目的地使用者指南。
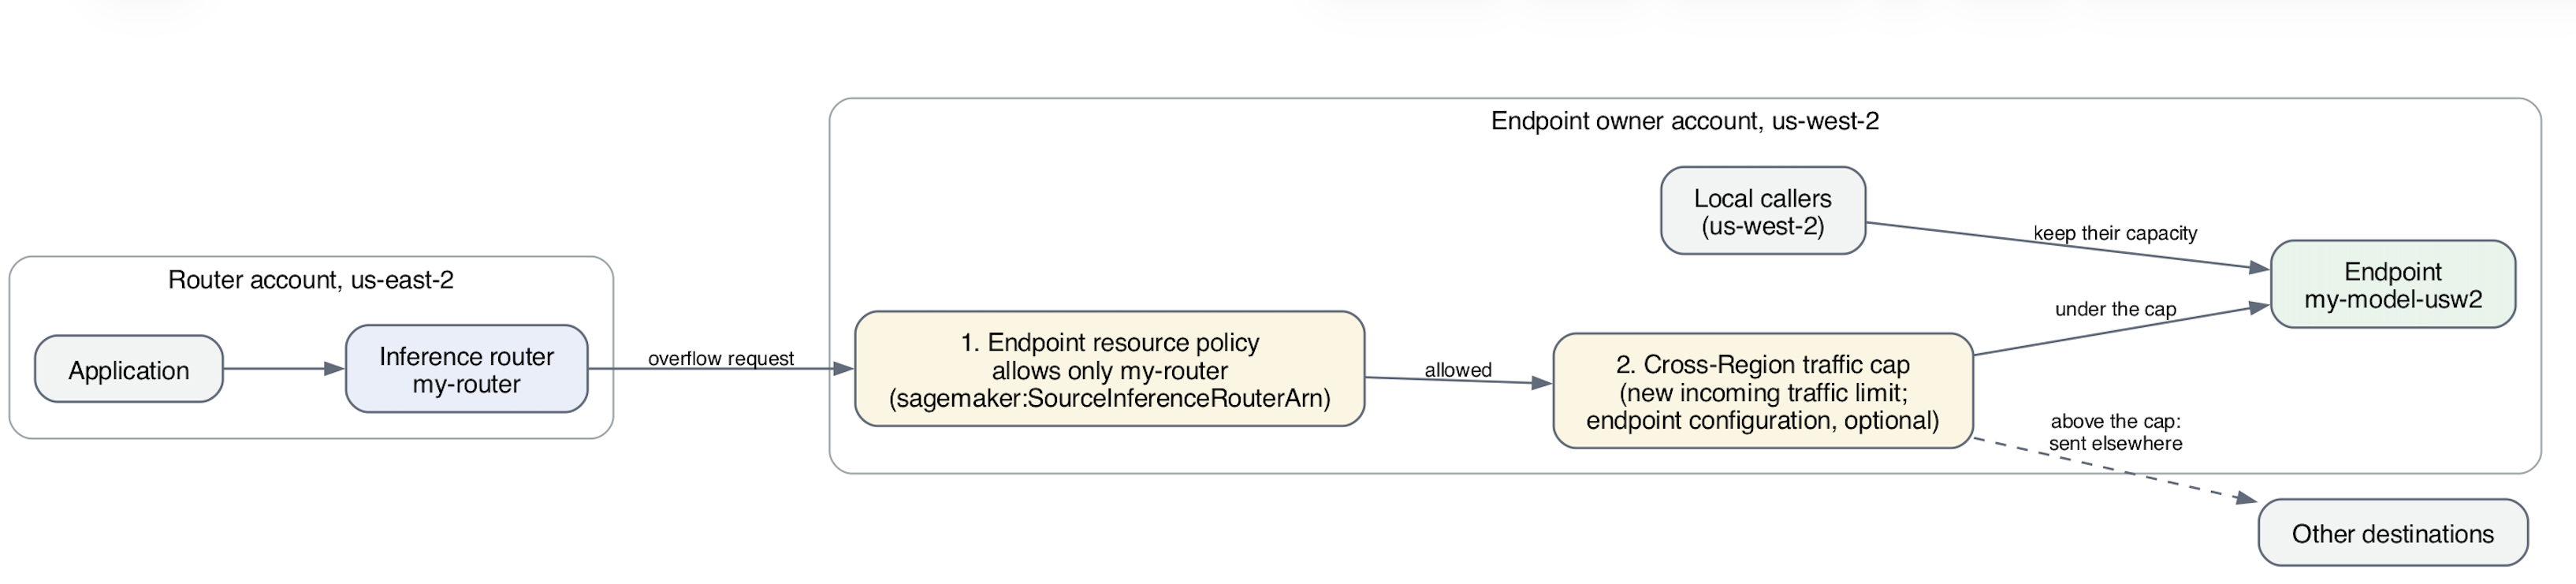
圖 5:端點擁有者保留的控制措施:允許一個具名路由器的端點政策,以及可選的跨區域流量上限
以跨區域流量上限保護接收端點
當路由器將請求從容量不足的區域轉移時,這些請求會送到已為其所在區域的呼叫者提供服務的端點。根據預設,接收端點會接受任意數量的跨區域流量,因此大量溢出流量可能令端點受到限流。設定跨區域流量上限後,端點擁有者便可決定其他區域最多能使用多少端點容量。
你可以在 CreateEndpointConfig 中使用 CrossRegionTrafficConfig 設定上限,並須提供兩個值。MaxInvocationsPerSecondPerInstance 是單一執行個體每秒可處理的呼叫次數,你可以使用模型、執行個體類型及典型承載資料進行負載測試,以量度這個數值。MaxCrossRegionPercentPerEndpoint 是其他區域可使用的容量比例。SageMaker AI 會將每個執行個體的處理速率乘以運行中的執行個體數目,再套用該百分比,因此上限會隨自動擴展而變動。例如,每個執行個體每秒處理 50 次呼叫、上限設為 20%,且有 4 個執行個體運行時,端點每秒最多可接受來自其他區域的 40 個請求。自動擴展新增 2 個執行個體後,上限會提高至每秒 60 個請求。
sm = boto3.client("sagemaker", region_name="us-west-2")
sm.create_endpoint_config(
    EndpointConfigName="my-model-config-us-west-2",
    ProductionVariants=[...],  # your existing variants, unchanged
    CrossRegionTrafficConfig={
        "MaxInvocationsPerSecondPerInstance": 50,
        "MaxCrossRegionPercentPerEndpoint": 20,
    },
)
只有來自其他區域的請求才會計入上限。來自端點所在區域的請求,包括直接 InvokeEndpoint 呼叫,以及來自同一區域路由器的呼叫,都不會因此受到限流。當跨區域請求超出上限時,端點會在模型執行前拒絕超出的請求,而路由器會將每個請求改送至另一個目的地重試一次。如果沒有其他目的地能處理請求,你的應用程式便會收到限流錯誤。
此上限適用於即時端點,而端點上的所有推理元件共用此上限。若端點承載推理元件,請以一個執行個體及平常使用的推理元件和承載資料組合進行負載測試,以量度 MaxInvocationsPerSecondPerInstance;若該組合或承載資料有所變更,請再次測試。若不設定 CrossRegionTrafficConfig,端點便會接受任意數量的跨區域流量。
開始使用:在兩個區域部署一個模型
在此例中,我們在同一帳戶的美國東部(俄亥俄州)和美國西部(俄勒岡州),使用 vLLM 容器將 Qwen3-4B 部署為推理元件。由於推理路由器不支援回應串流,應用程式會傳送非串流請求,而且每個請求必須在約一分鐘內完成(與 InvokeEndpoint 的限制相同),因此我們會在美國東部(俄亥俄州)建立路由器,並設定一個列出以下兩個目的地的路由目標:
sm = boto3.client("sagemaker", region_name="us-east-2")
rt = boto3.client("sagemaker-inference-router-runtime", region_name="us-east-2")

sm.create_inference_router(
    InferenceRouterName="my-router",
    RoutingTargets=[{
        "Name": "my-model",
        "Destinations": [
            {"ResourceArn": "arn:aws:sagemaker:us-east-2:111122223333:inference-component/ic-us-east-2"},
            {"ResourceArn": "arn:aws:sagemaker:us-west-2:111122223333:inference-component/ic-us-west-2"},
        ],
    }],
)
執行 DescribeInferenceRouter,並確認每個目的地的 RoutingStatus 都是 Routable,然後才傳送流量。
應用程式會以路由目標名稱及原本會傳送至 InvokeEndpoint 的相同承載資料呼叫路由器,並從回應中讀取提供服務的目的地及路由原因:
resp = rt.invoke_inference_router(
    InferenceRouterName="my-router",
    RoutingTargetName="my-model",
    ContentType="application/json",
    Body=json.dumps({"messages": [{"role": "user", "content": "Who are you?"}]}),
)
print("Served by:", resp["InvokedRoutedResourceArn"])
print("Reason:   ", resp["RoutingReason"])
我們觀察到的情況
| 步驟 | RoutingStatus 位於 DescribeInferenceRouter(us-east-2 / us-west-2) |
服務方 | 路由原因 |
| 兩個推理元件均在執行 | Routable / Routable |
us-east-2 | local-preferred |
| us-east-2 推理元件已移除 | Unroutable / Routable |
us-west-2 | only-healthy |
| us-east-2 推理元件已還原 | Routable / Routable |
us-west-2 | only-healthy |
| 流量已返回 us-east-2 | Routable / Routable |
us-east-2 | local-preferred |
當推理元件運作時,流量留在 US East (Ohio);移除元件後,流量轉至 US West (Oregon),應用程式無須作任何變更;還原元件後,流量便返回原處。
此範例的完整筆記本可在 GitHub 取得。
提示:將執行個體集區與跨區域推理路由搭配使用。使用具備容量感知功能的執行個體集區時,SageMaker AI 在建立執行個體和擴展期間,可在同一區域使用其他執行個體類型。當本地端點整體無法處理請求時,路由器會將新請求轉至另一個區域。詳情請參閲容量感知推理:SageMaker AI 端點的自動執行個體備援。
查看每個請求的路由目的地
推理路由器提供兩種路由檢視方式:每個即時回應中的記錄,以及 CloudWatch 中的指標。
每個請求的路由記錄
每個即時回應都會在 InvokedRoutedResourceArn 中包含處理該請求的目的地 ARN,並在 RoutingReason 中包含路由原因。路由原因包括以下其中一項:
local-preferred– 由路由器所在區域內健康的目的地處理。capacity-available– 由有可用容量的目的地處理。failover– 由無法可靠提供服務的目的地轉移。only-healthy– 由唯一符合資格且健康的目的地處理。
我們建議將這兩個值與應用程式本身的請求記錄一併記錄。
非同步回應不會包含處理請求的目的地。CloudWatch 中的路由器指標會顯示非同步請求的路由目的地。
CloudWatch 中的路由器指標
路由器會在其自身的帳戶和區域,將 OpenTelemetry 指標發佈至 CloudWatch,並以路由器、路由目標及目的地作為標籤:
aws.sagemaker.inference_router.invocations– 每個目的地的請求數;失敗時會附上error.type標籤(invocation_4xx、invocation_5xx或invocation_model_error)。aws.sagemaker.inference_router.destination.duration– 在目的地所花的時間,包括模型處理時間。aws.sagemaker.inference_router.overhead.duration– 路由器自身的處理時間,以及往返另一個區域的網絡時間。aws.sagemaker.inference_router.destination.status– 每個目的地的狀態為healthy、overloaded或degraded。
為不健康的目的地及所有錯誤類型的整體錯誤率設定警示。請參閲使用 Amazon CloudWatch 和 AWS CloudTrail 監控推理路由器。
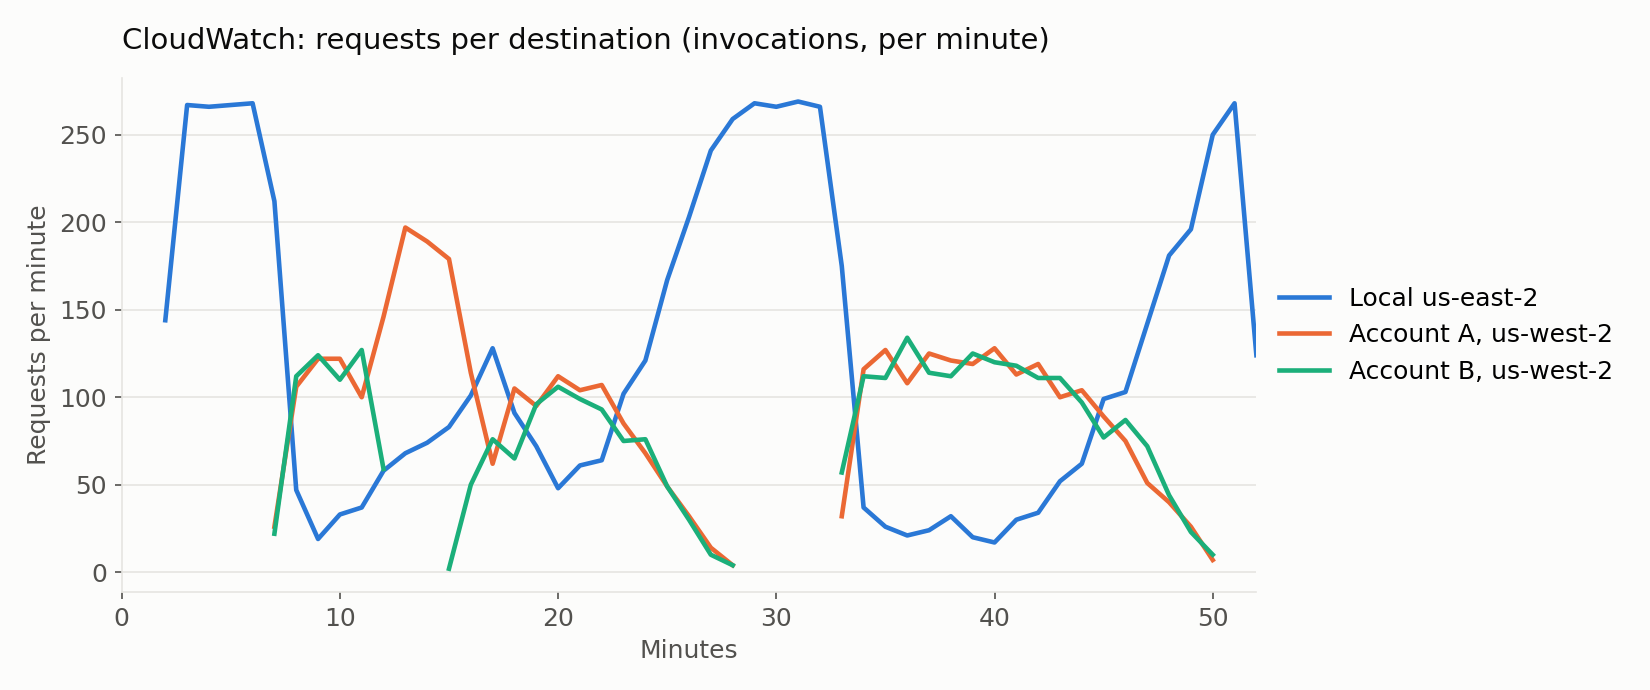
圖 6:圖 4 所示測試期間,路由器 CloudWatch invocations 指標所記錄的每個目的地請求數
每個目的地端點會繼續在其自身的帳戶和區域發佈現有的 SageMaker AI 指標。如要在同一處查看這些指標,請使用 CloudWatch 跨帳戶可觀測性,以及跨帳戶、跨區域儀錶板。
AWS CloudTrail 會將路由器的 API 呼叫(create、update、delete、describe 和 list)記錄為管理事件,並將路由器呼叫記錄為資料事件。你可以像為其他 SageMaker AI 資料事件一樣,在追蹤中啟用資料事件。
規劃部署
使用推理路由器進行設計時,請留意以下事項:
- 將路由器部署在大部分流量來源所在的區域。路由器一律優先選用位於自身區域的目的地。
- 為每個區域設定容量,以應付自身流量及預期承接的溢出流量。預設情況下,接收端點可接受任何數量的跨區域流量,因此請設定自動擴展,並為預期的溢出流量預留容量。若要保障端點的本地呼叫方,可設定跨區域流量上限,詳情請參閲使用跨區域流量上限保障接收端點。如果所有遠端目的地都達到上限,超出各上限總和的請求便會收到節流錯誤。
- 維持低成本的備用區域。你可以在另一個區域註冊推理元件並維持低成本,但要規劃好如何為其提供容量。遠端推理元件若沒有任何副本,在故障切換期間只會收到少量流量,而這些請求在配置副本前都會失敗。請至少維持一個副本運作,或為副本設定自動擴展,並確認備用區域能在你依賴它之前擴展容量。
- 規劃入口點的復原能力。路由器屬於區域性資源,因此若其所在區域受影響,對它的呼叫便會失敗。請在兩個區域建立路由器,並在客戶端切換使用的路由器。
- 只註冊資料可能會在其中處理的目的地。請求可能會在路由器所在區域,或任何已註冊目的地所在的區域處理。若資料必須留在特定地區,請使用不同的路由器,例如一個處理美國資料,另一個處理歐盟資料。你有責任設定路由器,確保符合資料駐留及合規要求。
- 適度控制自行重試的次數。節流錯誤表示所有目的地都正忙碌,而服務不可用錯誤則表示沒有目的地能接收請求。大約一分鐘後出現的服務不可用錯誤,表示請求已逾時,而模型可能已經執行,因此不要自動重試。
- 從路由器移除已刪除的目的地。流量會避開已刪除的端點,但路由器不會自行移除目的地。
- 透過私有方式呼叫路由器。虛擬私有雲(VPC)中的應用程式可透過介面 VPC 端點(AWS PrivateLink)呼叫路由器;此方式支援 IPv4(不支援 IPv6/雙堆疊)。
另請注意以下限制:
- 不支援回應串流。
- 若目的地在大約一分鐘內沒有回應,即時請求便會因服務不可用錯誤而失敗。
- 每個路由器最多可容納 20 個路由目標,每個路由目標最多可容納 10 個目的地,即時負載上限為 6 MB。如需瞭解預設配額(例如每個帳戶的路由器數量及請求速率),以及如何申請提高配額,請參閲Amazon SageMaker AI 文件中的 Service Quotas。
結論
Amazon SageMaker AI 的跨區域推理路由功能,為應用程式提供一個呼叫途徑,連接你已在多個 AWS 區域及 AWS 帳戶中執行的端點和推理元件。路由器會優先使用自身所在區域;目的地無法可靠地提供服務時,會轉移新請求;目的地恢復後,則會逐步將流量導回,並顯示每個請求在哪裏執行及原因。你的端點、模型、容器和自動擴展政策均無須更改。
跨區域推理路由功能自今日起在大部分商業 AWS 區域(me-south-1 和 me-central-1 除外)正式推出,適用於即時及非同步推理。
在 Amazon SageMaker AI,跨區域推理路由不會收取額外費用。無論請求是直接送達 Amazon SageMaker AI 端點和推理元件,還是經由推理路由器送達,你都只需按 SageMaker AI 標準價格,支付為請求提供服務的端點和推理元件費用。推理路由器會在其帳戶的 Amazon CloudWatch 發佈指標,你須按 CloudWatch 標準費率,支付這些指標及你執行的任何查詢的費用。詳情請參閲 Amazon SageMaker AI 定價。
如要開始使用,請參閲關於跨區域推理路由的 Amazon SageMaker AI 文件,並在 GitHub 查看範例筆記本。
關於作者

Dmitry Soldatkin
Dmitry 是 AWS Amazon SageMaker AI 推理專家解決方案架構部門的全球負責人。他協助客戶設計、建置及優化生成式 AI 和機器學習解決方案,專注於推理效能優化、深度學習,以及在企業內擴展 ML。在過往職務中,他曾在金融服務、保險及電訊公司帶領團隊。

Apoorva Chandra
Apoorva 是 Amazon SageMaker AI 推理團隊的產品經理,專注於端點體驗和託管體驗。她與在正式環境部署生成式 AI 模型的客戶合作,讓客戶更容易取得加速運算、更具成本效益地執行工作,並更容易預測其運作情況。工作以外,Apoorva 喜歡遠足、探索咖啡店,以及與朋友相聚。

Deepti Ragha
Deepti 是 Amazon SageMaker AI 團隊的高級軟件開發工程師,專門負責 ML 推理基礎設施和模型託管優化。她開發的功能可提升部署效能和可用性、降低推理成本,並讓各種規模的機構都能使用 ML。工作以外,她喜歡旅行、遠足和園藝。

Felipe Lopez
Felipe 是 AWS 的首席 AI/ML 專家解決方案架構師。加入 AWS 之前,Felipe 曾在 GE Digital 和 SLB 工作,專注於工業應用的建模和優化產品。

Barkha Saxena
Barkha 是 Amazon SageMaker AI 推理團隊的軟件開發工程師,專門負責 ML 推理基礎設施和模型服務優化。她的工作涵蓋高效的多適配器推理,可透過單一端點服務數百個經微調的 LoRA 適配器;亦涵蓋雙向串流,支援語音 Agent 等低延遲即時應用。工作以外,她喜歡乒乓球、繪畫和玩拼圖。
來源:AWS Machine Learning Blog · aws.amazon.com