Hugging Face 推出 Evaluation on the Hub,支援免寫程式評估模型
Announcing Evaluation on the Hub
Hugging Face 推出由 AutoTrain 驅動的 Evaluation on the Hub,讓使用者無需編寫程式,即可用任意資料集與指標評估 Hub 上的模型。評估結果會提交至模型卡的 Hub pull request,平台亦提供排行榜,方便比較模型在不同資料集切分與指標上的表現。
它讓使用者可在 Hub 選擇模型、資料集和指標,免寫程式完成評估;結果回寫模型卡,排行榜便於比較表現及重用評估設定。
簡介:今天我們推出 Hub 上的模型評估,這項由 AutoTrain 驅動的新工具,讓你毋須編寫任何程式碼,就能在 Hub 上以任何資料集評估任何模型!
AI 的進展令人驚嘆,甚至有人開始認真討論 AI 模型在某些任務上是否可能比人類更出色。不過,這種進展並非各方面都一樣:數十年前的機器學習研究者看到現代硬件和演算法、我們如今可用的龐大資料和運算資源,可能會覺得不可思議;但評估這些模型的方法至今大致沒有改變。
毫不誇張地説,現代 AI 正面臨評估危機。如今要妥善評估,往往要用多項指標測試多個模型,並使用多個資料集,過程卻不必要地繁瑣。若我們重視可重現性,問題尤其明顯,因為自行報告的結果可能受無意的錯誤、細微的實作差異,甚至更嚴重的問題影響。
我們相信,只要社羣建立更好的最佳實務並設法消除障礙,就能改善評估。過去幾個月,我們一直努力開發Hub 上的模型評估:按一下按鈕,就能用任何指標在任何資料集上評估任何模型。為了起步,我們已在幾個重要資料集上評估數百個模型,並利用 Hub 新推出的Pull Request 功能,在大量模型卡開啟 PR,展示經驗證的表現。評估結果會直接寫入模型卡中繼資料,並遵循適用於 Hub 所有模型的格式。可以看看 DistilBERT 的模型卡,瞭解實際效果!
在 Hub 上
Hub 上的模型評估帶來許多有趣的應用場景:無論是需要決定部署哪個模型的數據科學家或行政人員、要在新資料集上重現論文結果的學者,還是希望更瞭解部署風險的倫理學家,都能受惠。若要選出最初的三個主要使用場景,就是以下這些:
為你的任務找出最佳模型
假設你清楚知道自己的任務,並想找出最合適的模型。你可以查看能代表該任務的資料集排行榜,當中彙整了所有結果。很好!如果你感興趣的新模型尚未列入該資料集的排行榜呢?只要直接在 Hub 上為它執行評估即可。
在全新資料集上評估模型
假如你有一個剛建立的全新資料集,想用它測試基準模型,又可以怎樣做?你可將資料集上載至 Hub,然後按需要評估任意數量的模型,完全毋須編寫程式碼。更重要的是,你可以確定這些模型在你的資料集上的評估方式,與它們在其他資料集上的方式完全一致。
在多個相關資料集上評估你的模型
又或者你有一個以 SQuAD 訓練的全新問答模型?可以用來評估的問答資料集有數百個 :scream: 你可挑選感興趣的資料集,直接從 Hub 評估模型。
生態系統
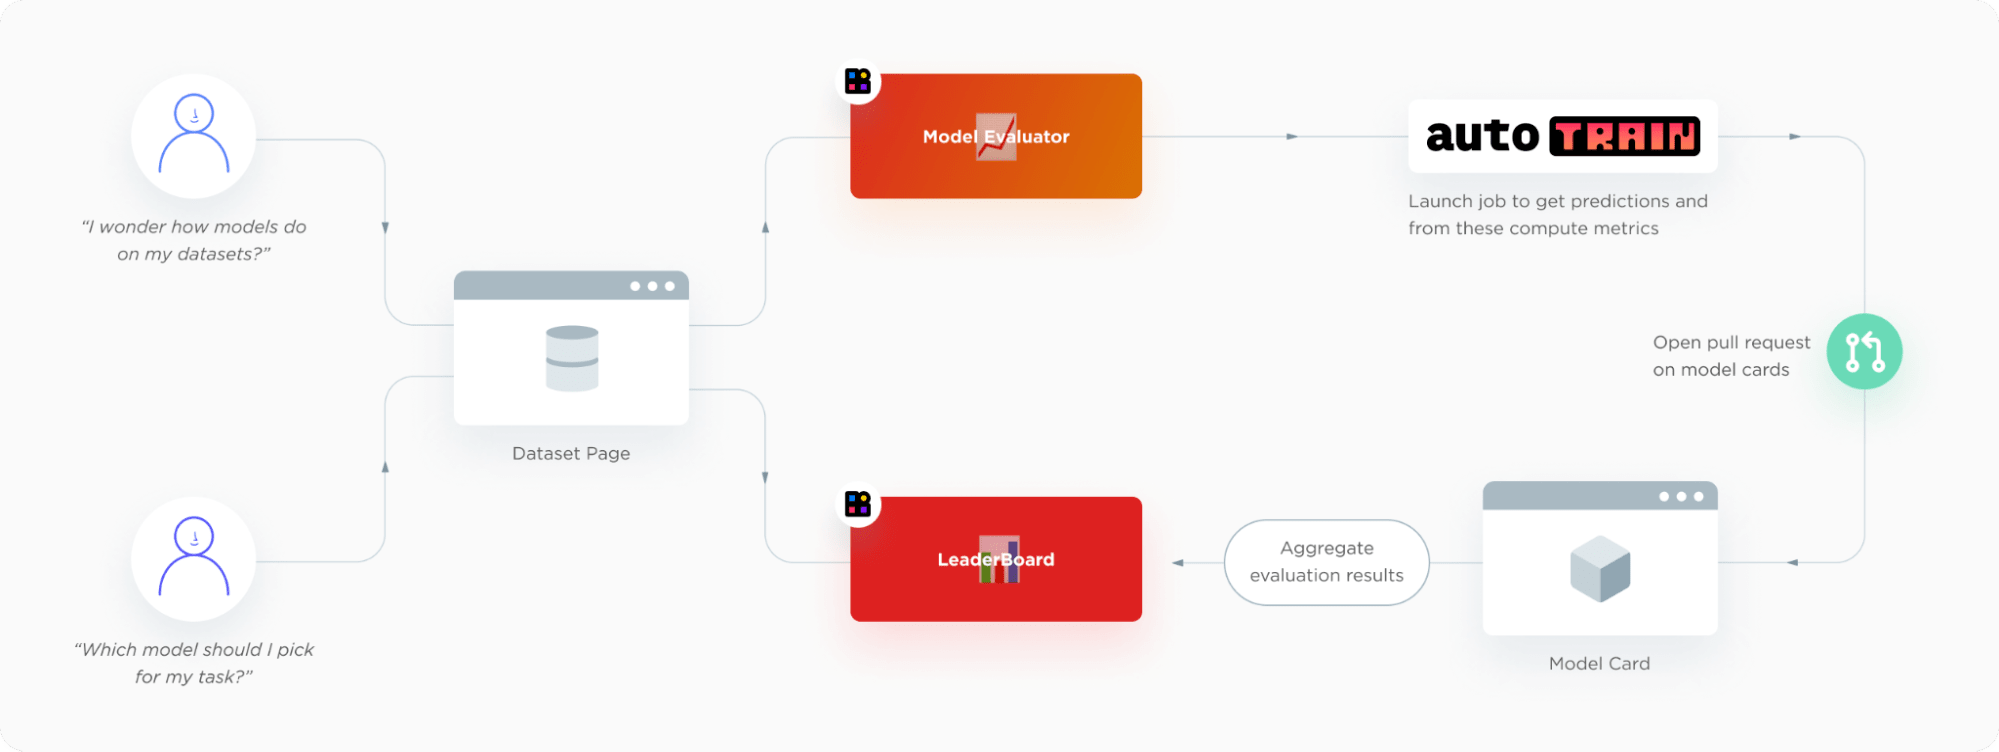
Hub 上的模型評估旨在讓你更輕鬆,但背後其實有許多運作細節。我們最欣賞它的一點,是它能如此自然地融入現有 Hugging Face 生態系統,幾乎是順理成章。用戶從資料集頁面開始,可在那裏啟動評估或查看排行榜。模型評估提交介面和排行榜都是一般的 Hugging Face Spaces。評估後端由 AutoTrain 驅動,會為指定模型在 Hub 上開啟一個模型卡 PR。
DogFood:分辨狗、鬆餅和炸雞
實際上會是怎樣?讓我們看看一個例子。假設你的工作是分辨狗、鬆餅和炸雞(也就是所謂的 dogfooding!)。
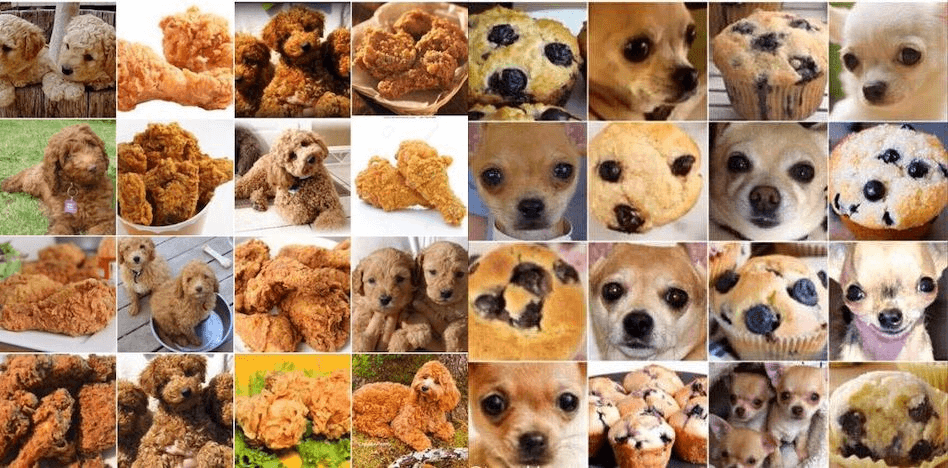
如上圖所示,要解決這個問題,你需要:
- 包含狗、鬆餅和炸雞圖片的資料集
- 以這些圖片訓練的圖像分類器
幸好,你的數據科學團隊已將資料集上載到 Hugging Face Hub,並用它訓練了幾個不同模型。現在只需選出最佳模型;我們用 Hub 上的模型評估看看它們在測試集上的表現吧!
設定評估工作
首先前往 model-evaluator Space,選擇要用來評估模型的資料集。對於我們的狗和食物圖片資料集,你會看到類似下圖的畫面:

Hub 上不少資料集都包含中繼資料,指定評估應如何設定(例如可參考 acronym_identification)。有了這些資料,只需按一下便可評估模型;不過這裏會示範如何手動設定評估。
按下進階設定按鈕後,便會顯示各項可選設定:
- 任務、資料集和資料分割設定
- 將資料集欄位對應至標準格式
- 選擇評估指標
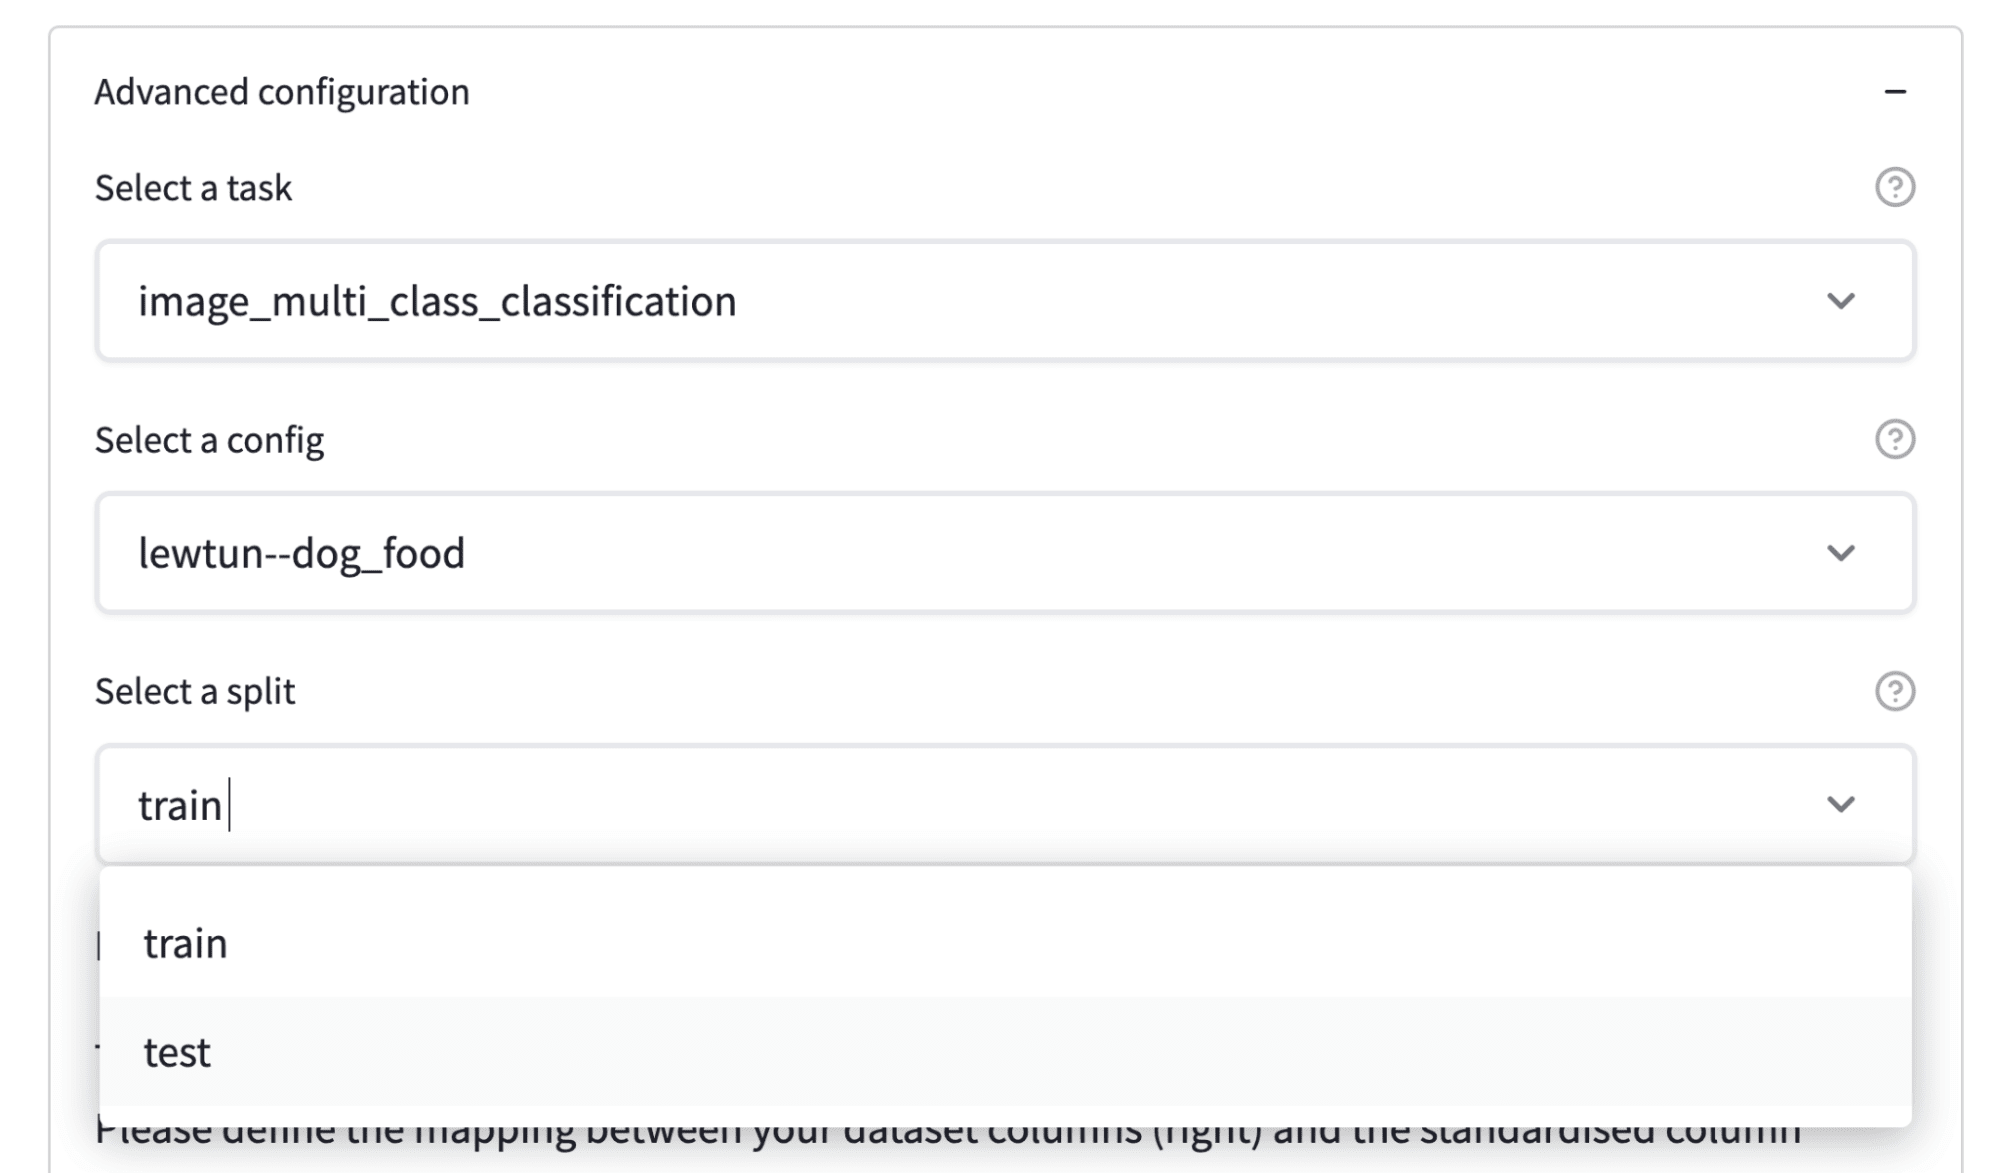
如下圖所示,設定要評估的任務、資料集和資料分割十分簡單:
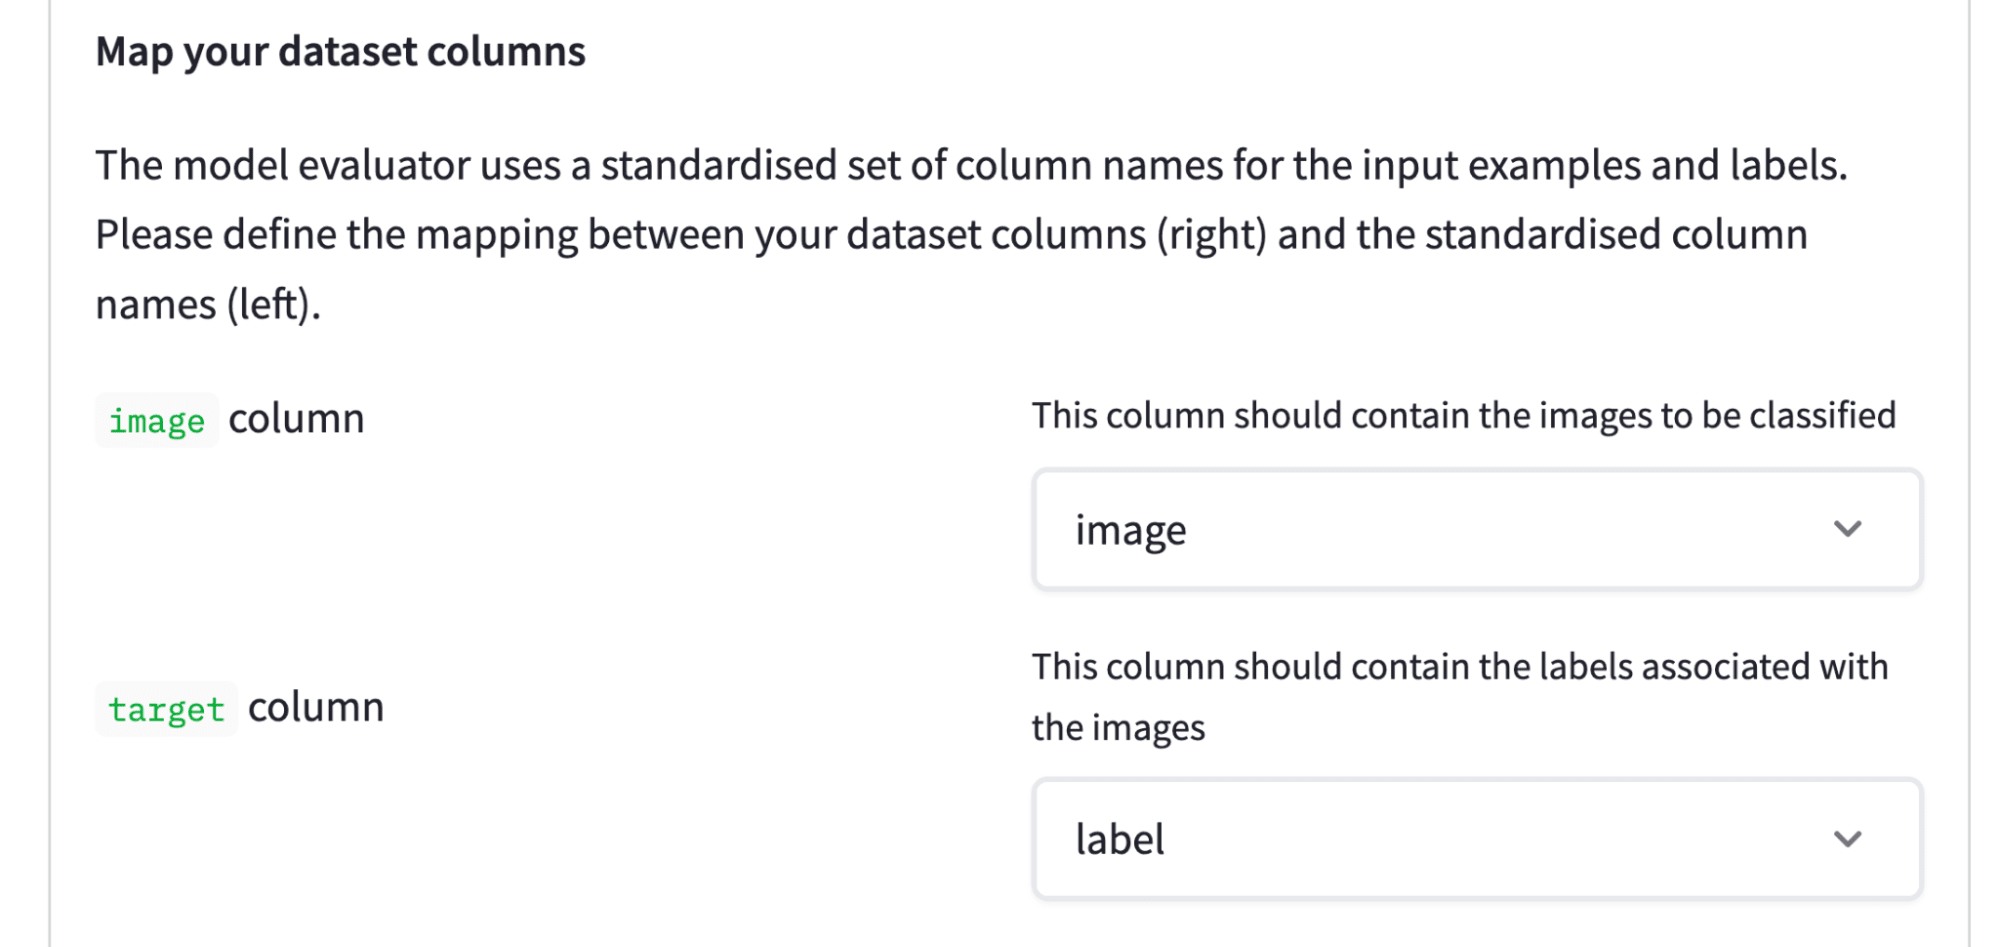
下一步是指定哪些資料集欄位包含圖片,哪些欄位包含標籤:
設定好任務和資料集後,最後一步(可選)是選擇評估指標。每項任務都有一組預設指標。例如,下圖顯示系統會自動計算 F1 分數、準確率等指標。為了增加一點變化,我們也會計算 Matthew 相關係數,以平衡方式衡量分類器表現:
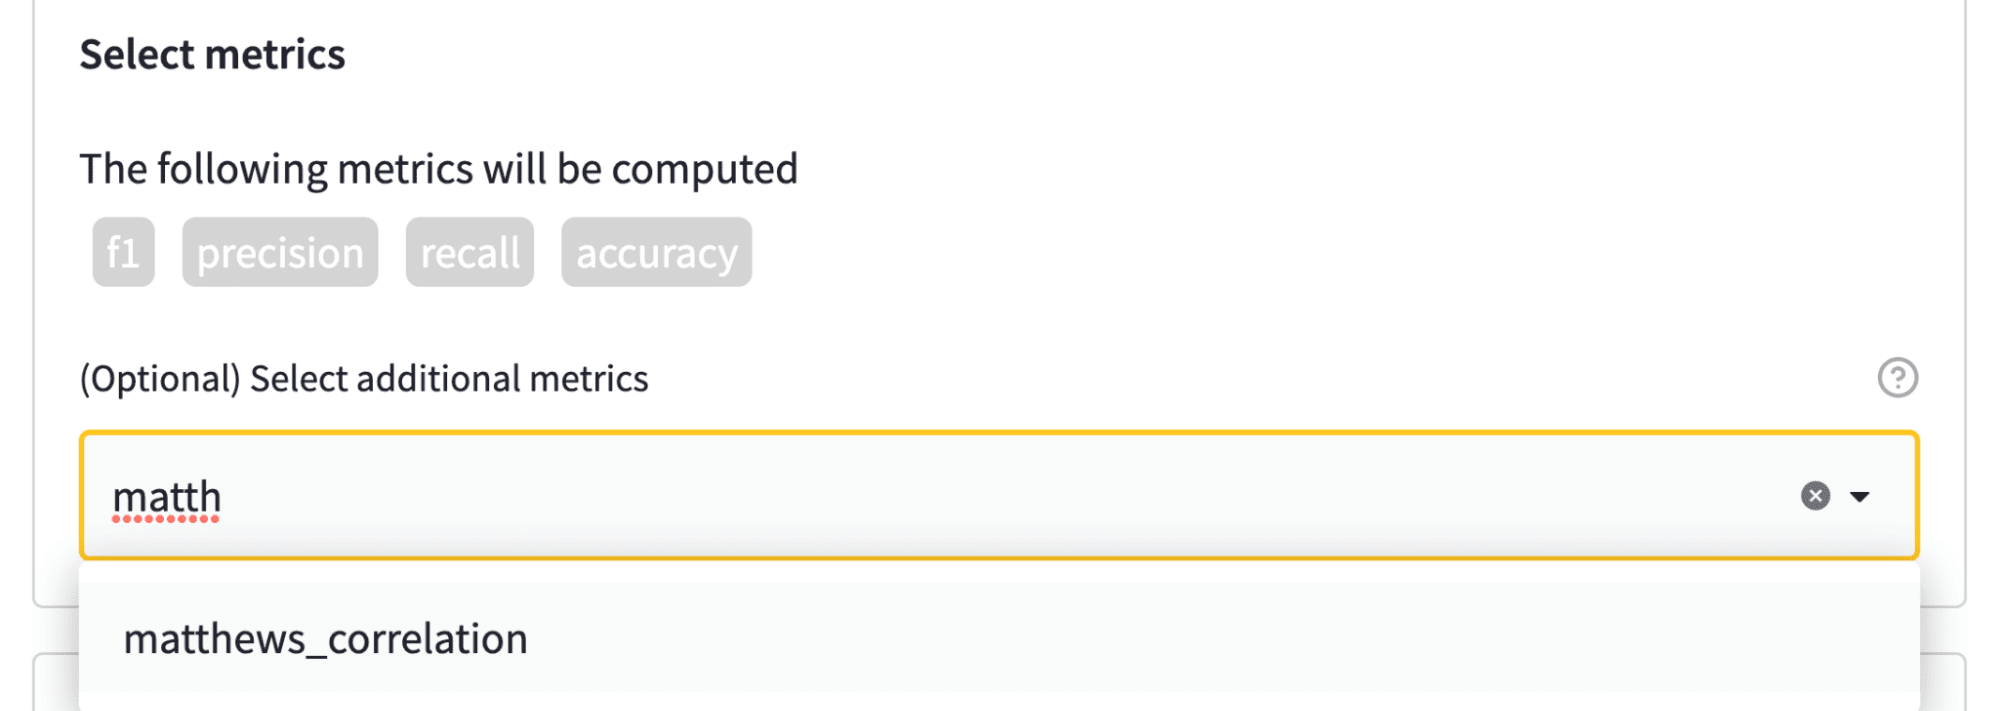
設定評估工作就是這麼簡單!現在只要挑選要評估的模型,來看看吧。
選擇要評估的模型
Hub 上的模型評估透過模型卡中繼資料中的標籤,連結資料集與模型。這個例子有三個模型可選,我們就全部選上吧!
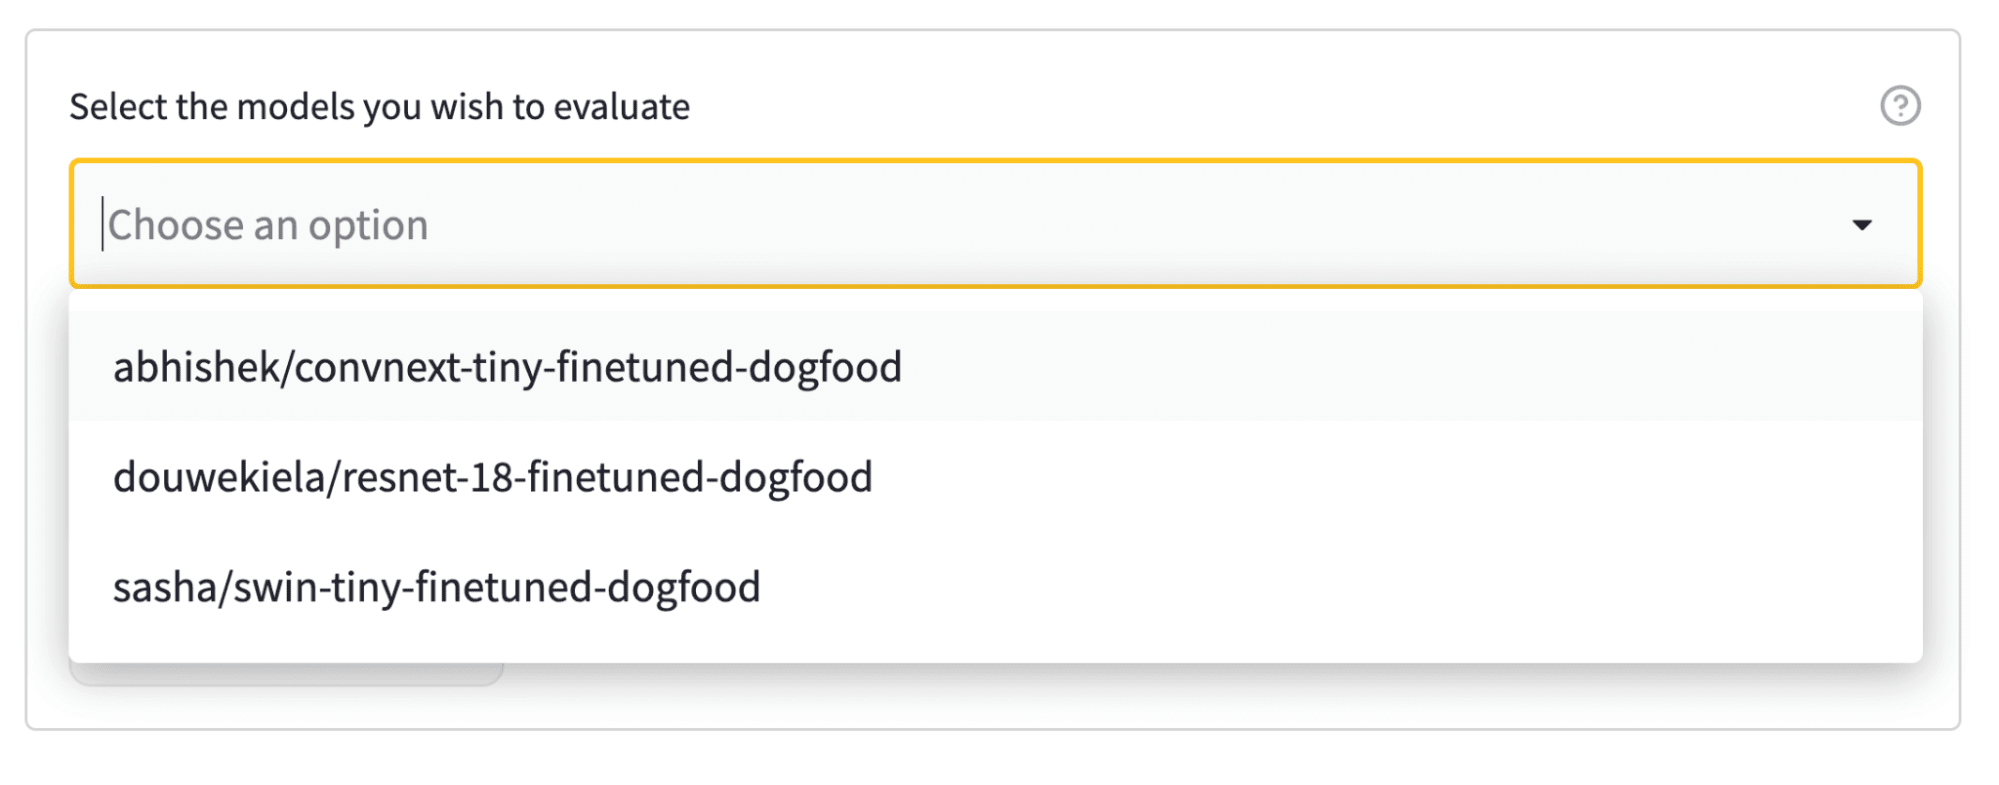
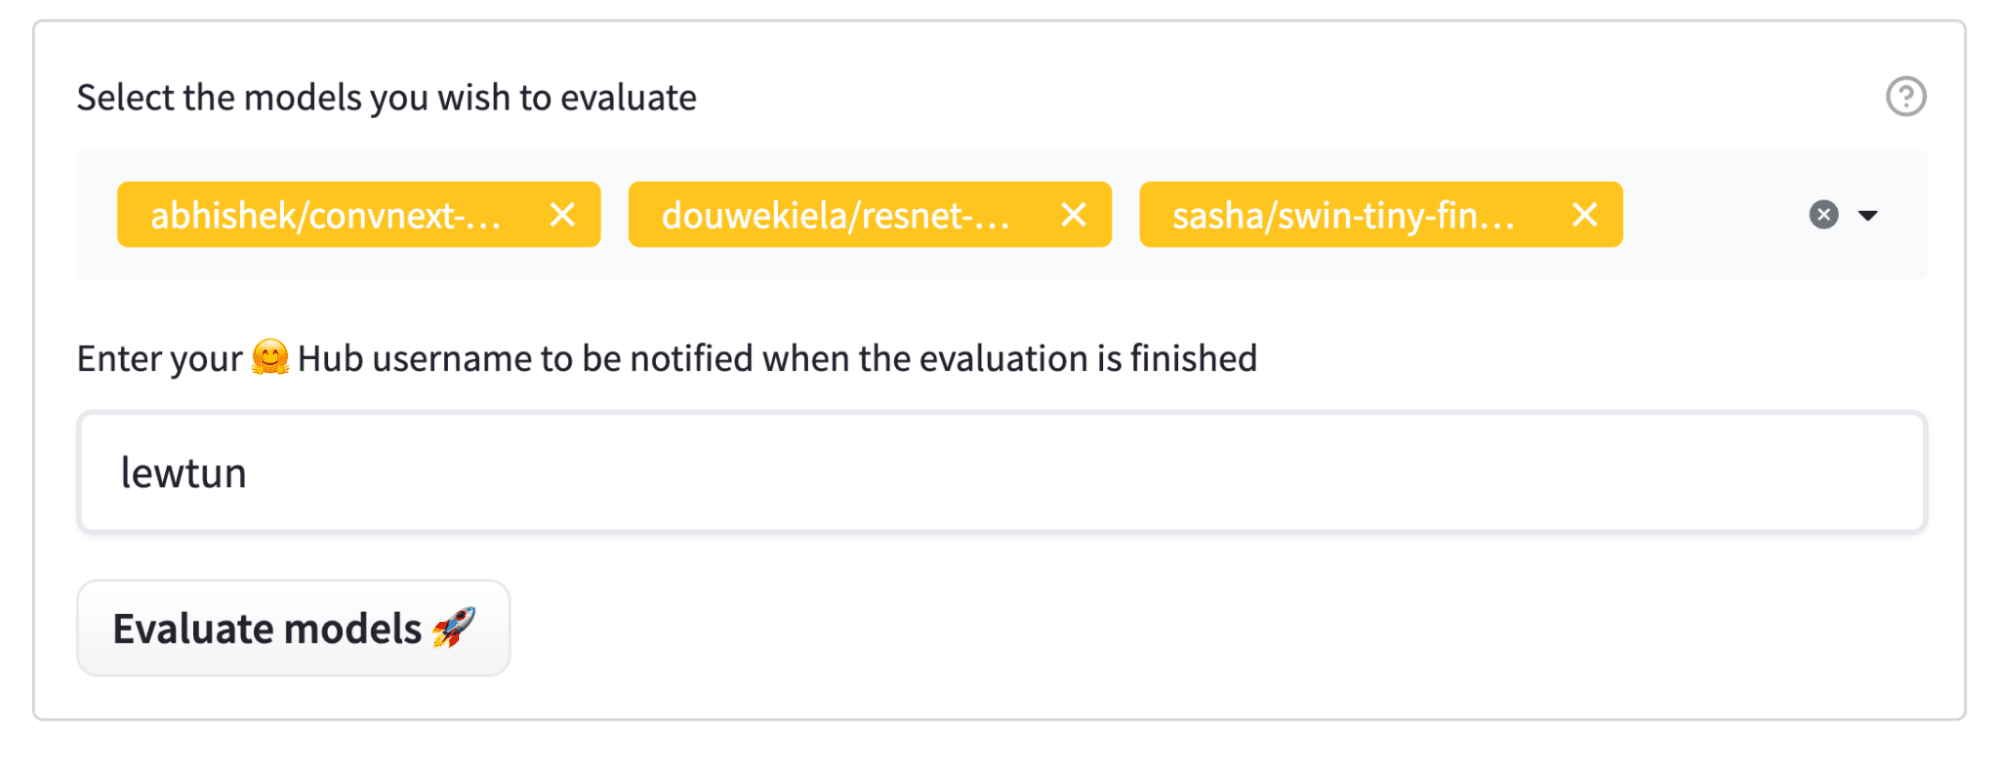
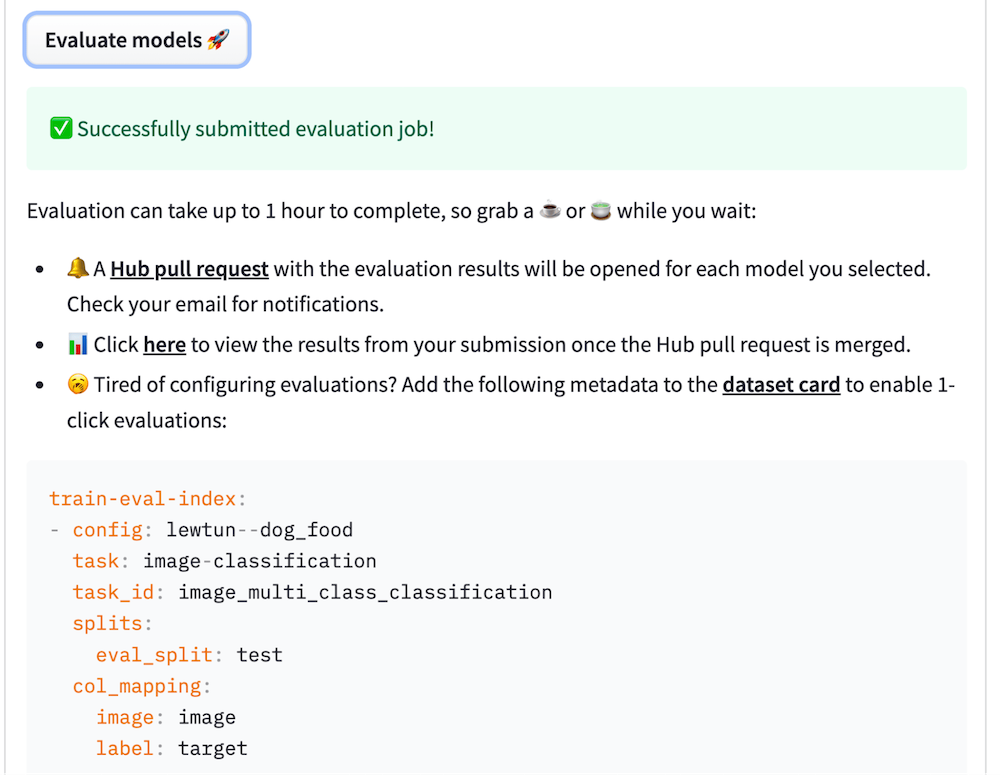
選好模型後,只需輸入你的 Hugging Face Hub 用戶名稱(評估完成時會收到通知),然後按一下顯眼的評估模型按鈕:
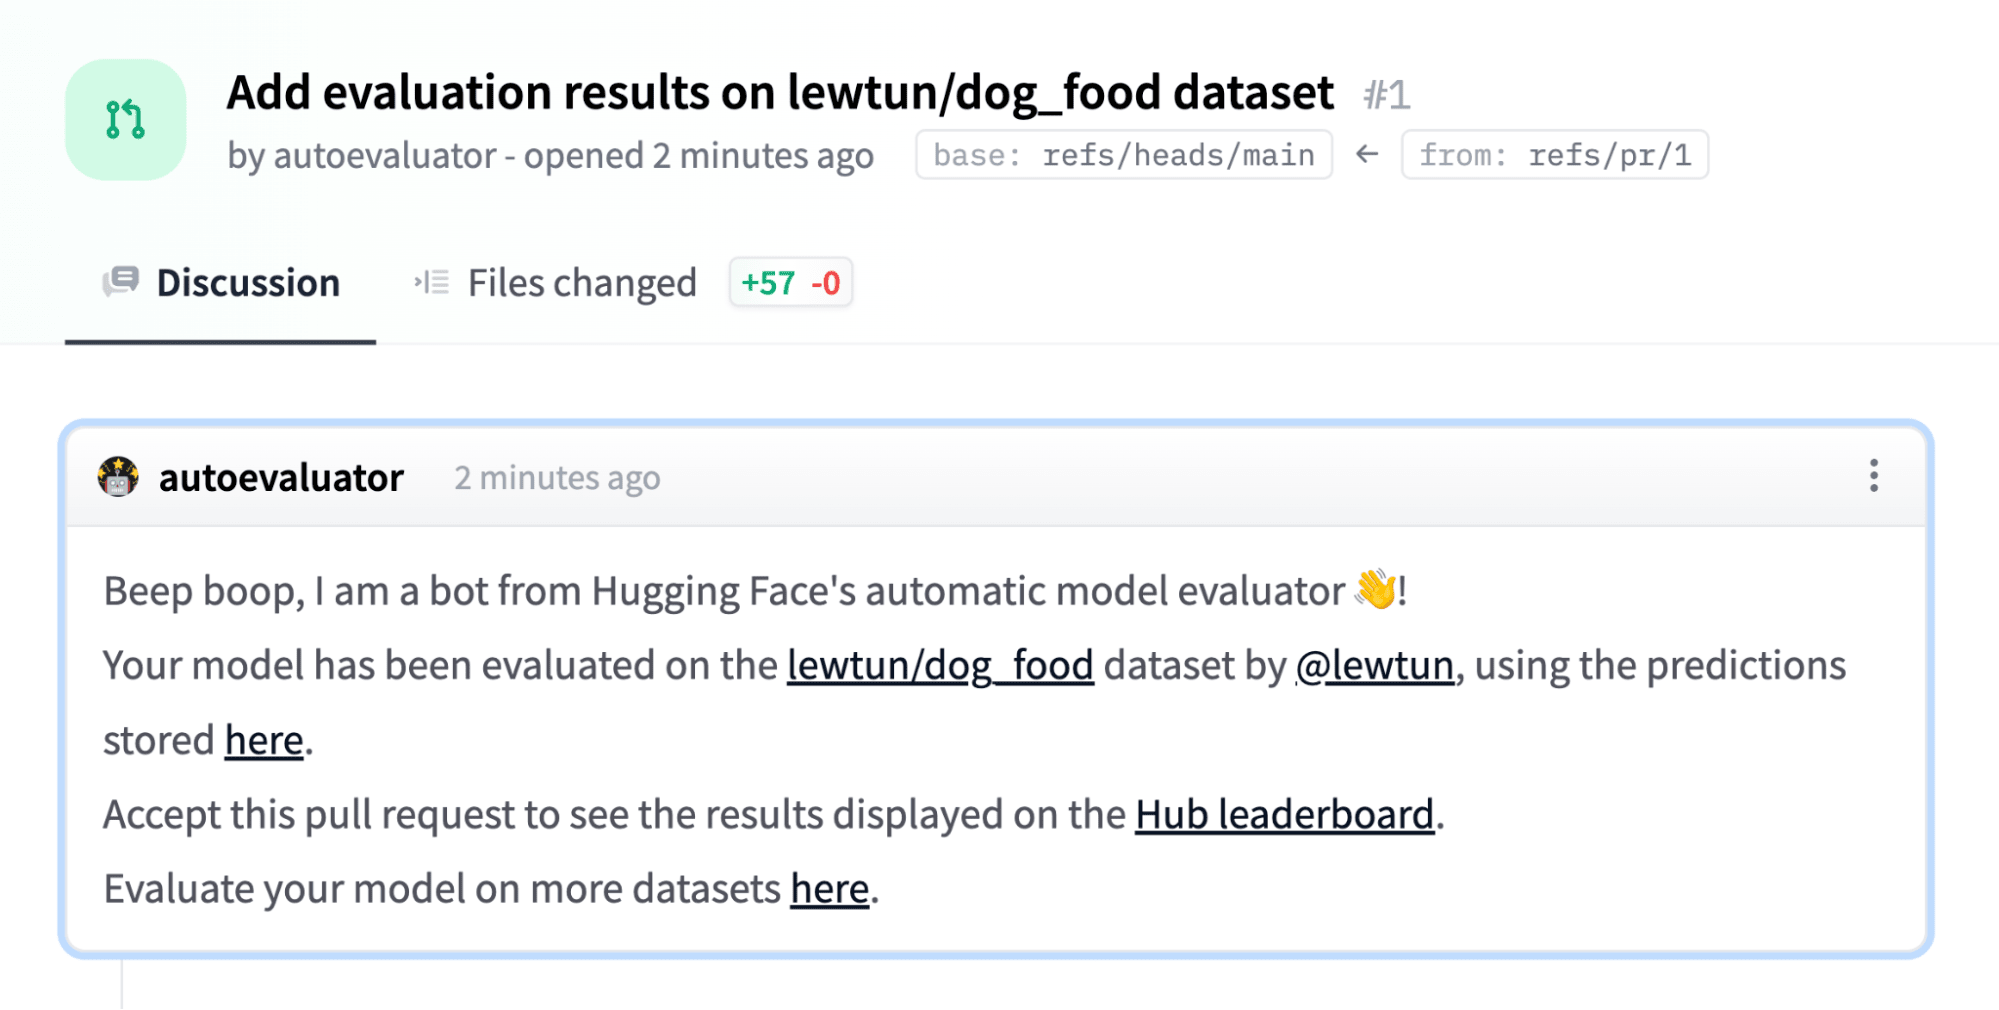
提交工作後,系統會自動評估模型,並在 Hub 上開啟 Pull Request,附上評估結果:
你亦可將評估中繼資料複製並貼到資料集卡,這樣你和社羣下次便可省去手動設定!
查看排行榜
為方便比較模型,Hub 上的模型評估亦提供排行榜,讓你查看哪些模型在不同資料分割和指標上的表現最佳:
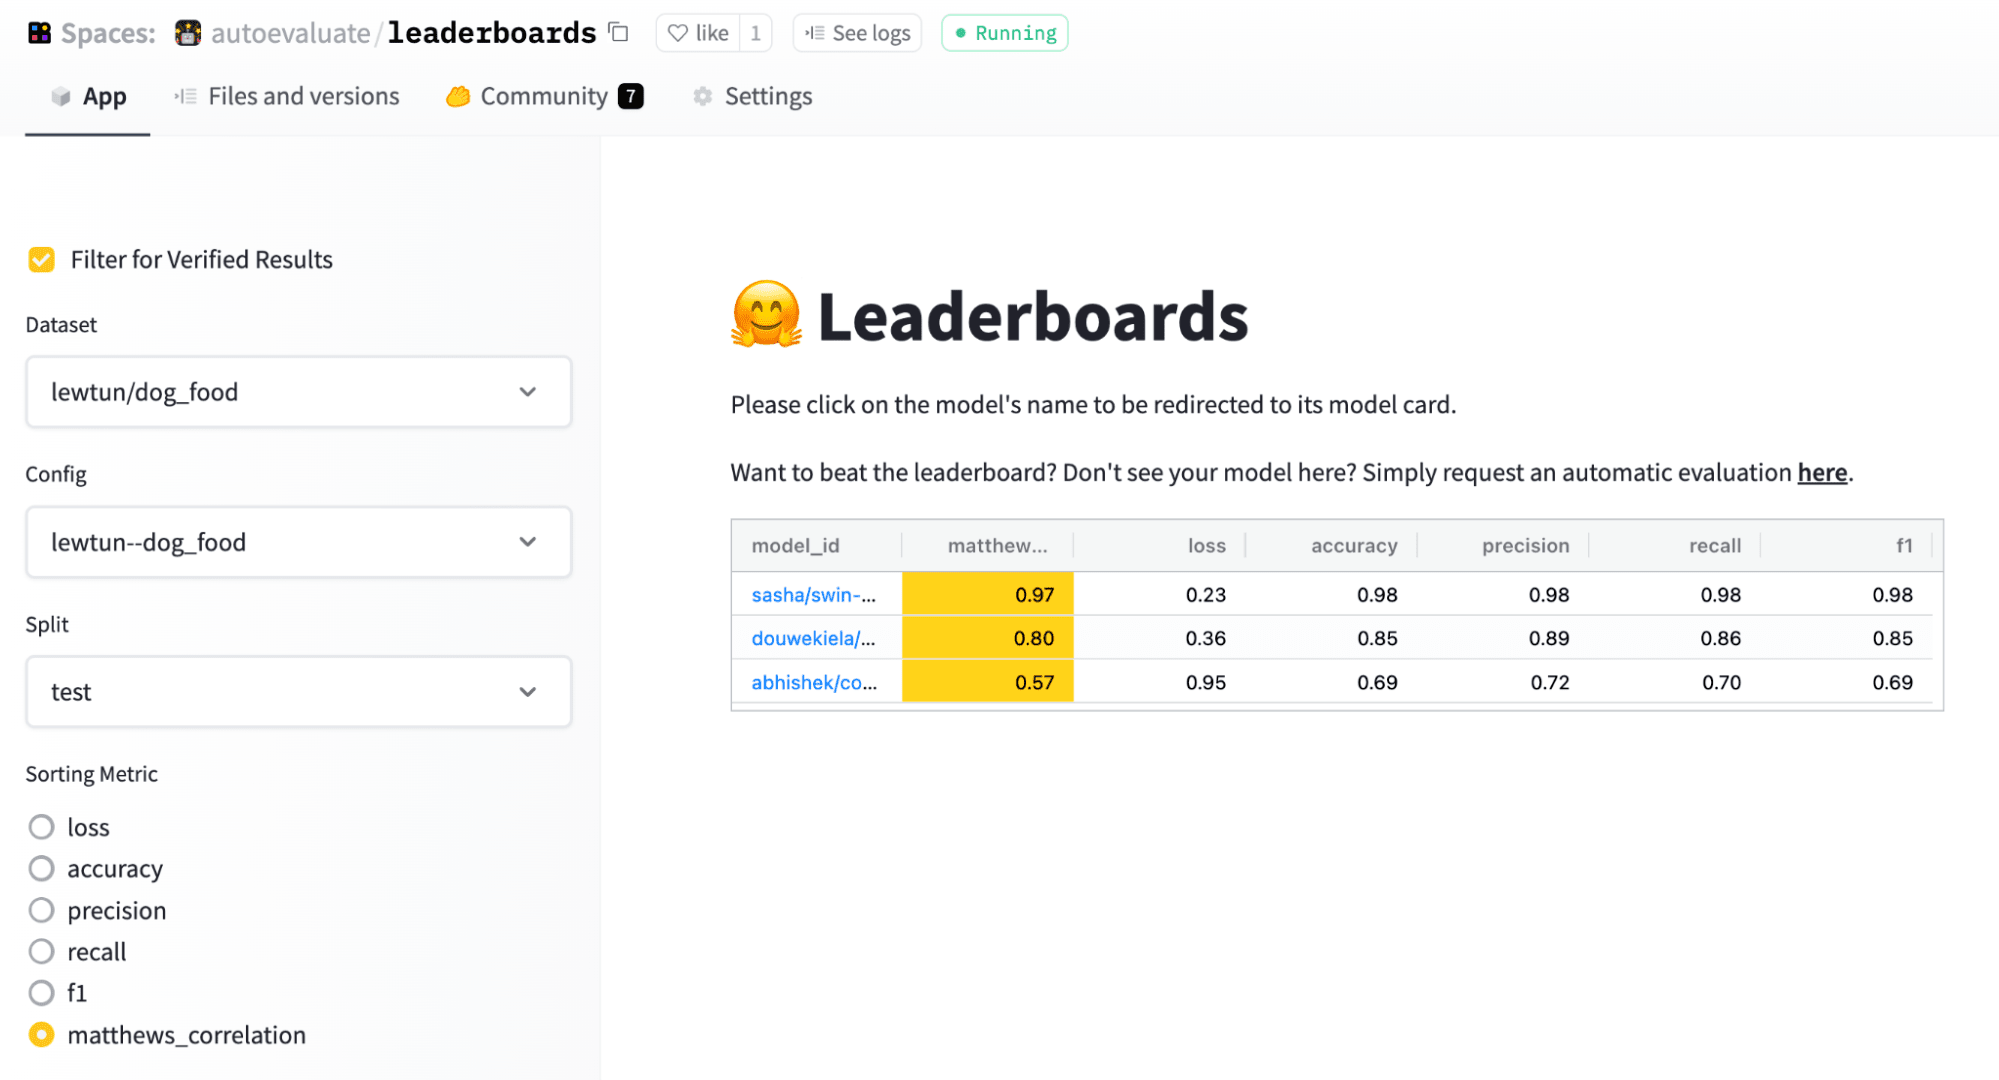
看來 Swin Transformer 脱穎而出,排名第一!
親自試試!
如果你想評估自己選擇的模型,不妨透過以下熱門資料集試用 Hub 上的模型評估:
- 用於文字分類的 Emotion
- 用於命名實體識別的 MasakhaNER
- 用於文字摘要的 SAMSum
更宏觀的視角
自機器學習問世以來,我們一直透過某種方式計算模型在留出測試集上的準確率來評估模型,並假設測試集與訓練資料獨立且同分佈。在現代 AI 的發展壓力下,這種模式如今開始出現嚴重問題。
基準測試正逐漸飽和:機器在某些測試集上的表現超越人類的速度,幾乎比我們設計新測試集還快。然而,眾所周知,AI 系統十分脆弱,容易受到嚴重惡意偏見影響,甚至會把偏見放大。可重現性不足,開放性則被視為次要考慮。人們聚焦排行榜之際,部署模型時的實際考量,例如效率和公平性,往往被輕輕帶過。數據在模型開發中極其重要的角色,至今仍未獲足夠重視。此外,預訓練和以提示為本的情境內學習,已模糊了「分佈內」原本代表甚麼。機器學習界正逐步追上這些問題,我們希望透過工作推動領域向前發展。
下一步
幾星期前,我們推出 Hugging Face Evaluate 程式庫,旨在降低採用機器學習評估最佳實務的門檻。我們亦一直提供 RAFT 和 GEM 等基準測試,詳見 RAFT 及 GEM。Hub 上的模型評估是我們邁向未來的重要一步,讓模型能以更全面的方式,沿多個評估面向接受評估,而且過程可信並可保證重現。敬請期待更多新功能,包括更多任務,以及全新改良的資料測量工具!
我們很期待看看社羣會如何運用這項工具!如果你想幫忙,歡迎按需要在盡可能多的資料集上評估模型。也請一如既往,多多提供意見,可前往社羣討論區或論壇!
來源:Hugging Face Blog · huggingface.co