Amazon Bedrock AgentCore Evaluations 智能體評估指南:內建、DeepEval 與 AutoEval 評估器的使用方法
The agent evaluation playbook: Built-in, DeepEval, and AutoEval on Amazon Bedrock AgentCore Evaluations
AWS 介紹如何在 Amazon Bedrock AgentCore Evaluations 中,運用內建、DeepEval 與 AutoEval 評估器評估生產環境中的智能體表現。文章建議先定義業務成功條件,再拆解成可觀察行為,按 trace 或 session 層級選擇評估器。AgentCore 支援按需、線上及批次評估,三種模式使用相同評估器 ID,從開發測試切換至線上評估只需更改設定。
文章示範由業務結果拆解可觀察行為,再選擇 trace 或 session 評估器,並説明如何按需求組合內建、DeepEval 與 AutoEval 指標。
將 Agent 部署至正式環境後,最難回答的問題之一,就是它是否真的發揮作用?關鍵不在於它能否運行,而在於它能否大規模滿足業務需求。許多團隊都會告訴你,他們其實看不清楚 Agent 的表現。他們會抽查輸出、監察延遲,並在有機會時收集用戶意見。這些做法都無法告訴你 Agent 是否完成了用戶的任務、在長時間對話中能否保持切題、是否洩露個人身份識別資料(PII),又或是否悄悄略過了原定流程中的一半步驟。
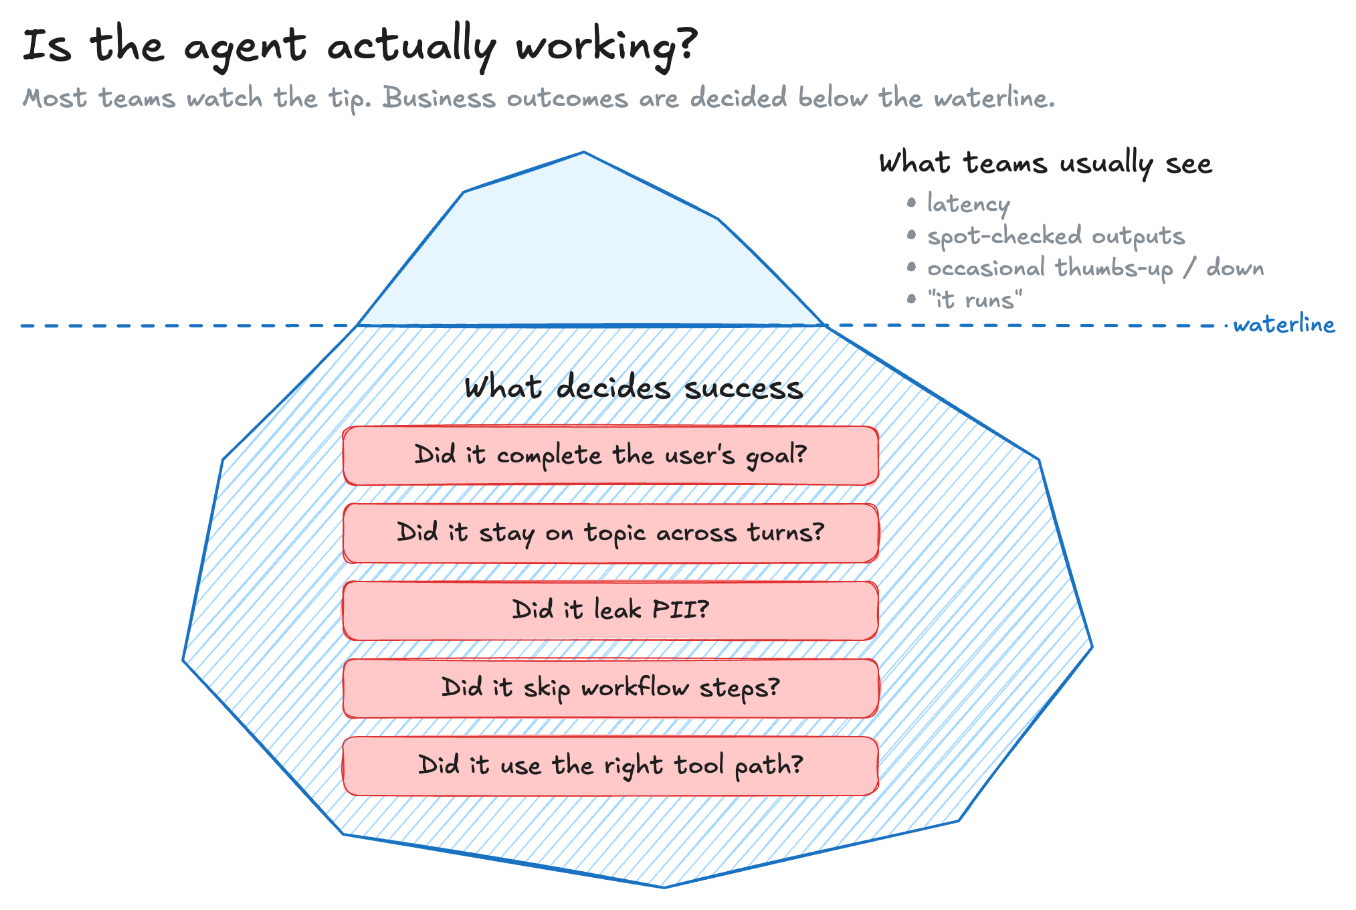
圖 1:團隊通常監察表面指標,但業務成果取決於水面之下的 Agent 行為
Agent 評估正是為瞭解決這個問題。難處在於,某項指標得分良好,可能會掩蓋另一項指標上的失敗。客戶支援 Agent 可以解決每一宗工單,卻仍可能在回覆中洩露個人資料。在這種情況下,即使 Agent 的完成率很高,它仍然未能勝任。要做好評估,就要按每個 Agent 的需要,在適當的細緻程度衡量重要行為。
本文將示範如何在 Amazon Bedrock AgentCore 上實踐。我們會直接使用 AgentCore Evaluations 中內置的評估器,以及 DeepEval 和 AutoEval 評估器。
從業務成果出發,而非指標名稱
最常見的錯誤,是先看指標清單,再挑選聽起來合適的名稱。「有幫助聽起來不錯,所以我們就用它。」最後雖然能運行並產生數字,卻幾乎沒有提供有用的洞見。指標只符合名稱,並未反映 Agent 成功的真正定義。
相反,應從以下三個步驟着手。
- 以業務角度定義成功。對客戶支援 Agent 而言,成功可能代表首次聯絡解決率;對研究 Agent 而言,可能代表提供完整、來源可靠,並完全以檢索到的文件為依據的答案;對內容審核助理而言,則代表標記所有應該標記的內容,而且只標記應該標記的內容。
- 把成果拆解為可觀察的行為。能達到首次聯絡解決率的客戶支援 Agent,通常會完成用戶提出的目標;如問題需要澄清,便在多輪對話中保持連貫;確保回覆符合合規要求;並正確呼叫建立工單或查詢訂單等後端工具。
- 按適當層級,為每種行為配對評估器。Trace 層級的指標涵蓋每輪對話或每次工具呼叫的行為;Session 層級的指標則涵蓋只有檢視整段對話才有意義的成果。
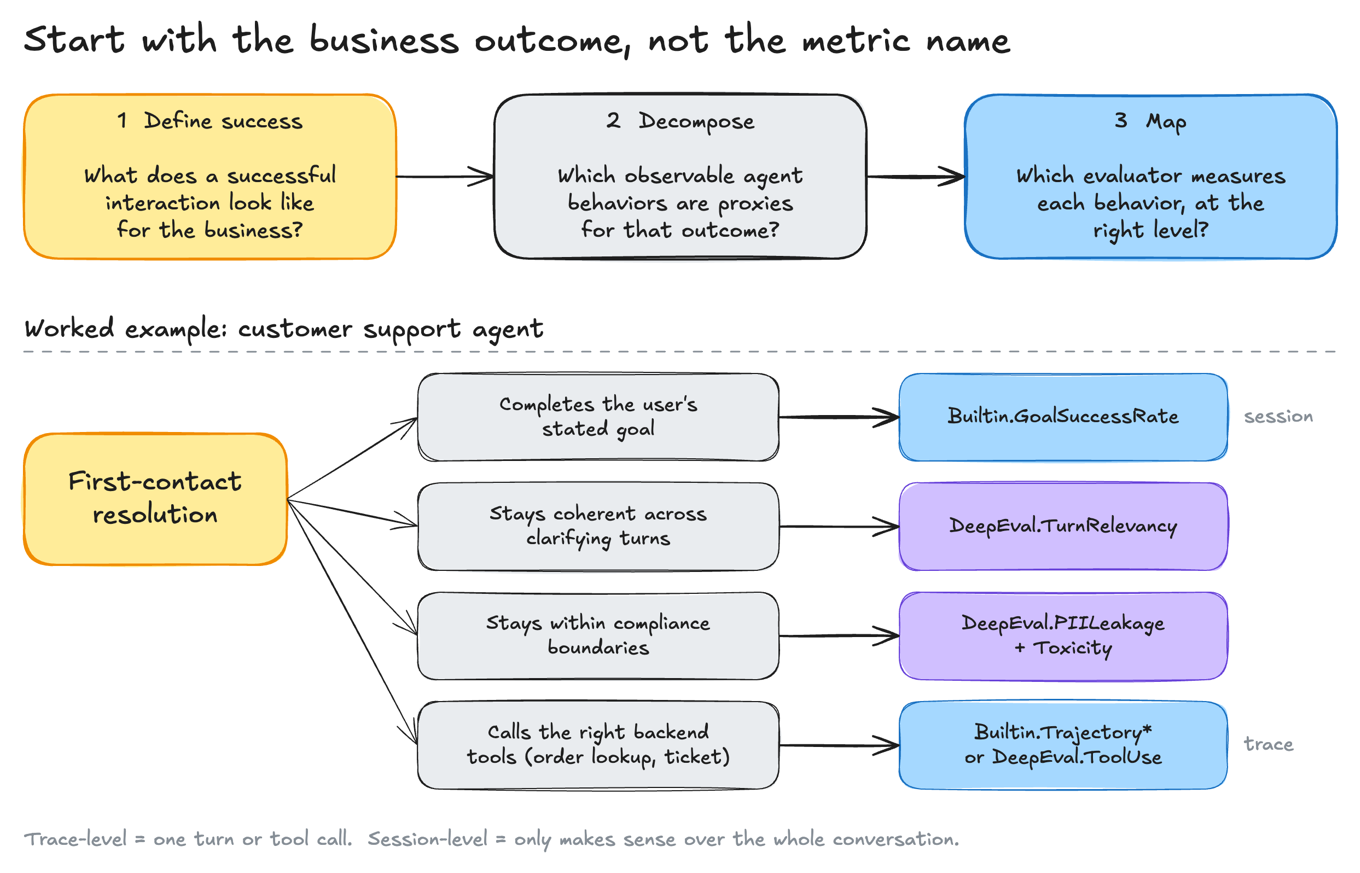
圖 2:把業務成果轉化為可觀察的行為,再配對至 Trace 或 Session 層級的特定評估器
這套三步流程是令評估發揮作用的思考框架。本文其餘部分將介紹 AgentCore 提供哪些功能,助你實踐這套流程。
評估器目錄
AgentCore 提供種類廣泛的評估器,來自三個來源:
- 內置評估器由 AWS 編寫並經品質測試。你只需以其 ID 參照(
Builtin.GoalSuccessRate、Builtin.Helpfulness,以及另外 13 個),其餘事項均由服務處理。這些評估器經過可靠性基準測試,並涵蓋常見範疇,因此是最直接的起點。 - 第三方託管評估器來自DeepEval和AutoEval,這兩個成熟的開源評估程式庫。以託管模式使用時,AgentCore 會代管程式碼、選擇評判模型,並使用自身資源執行推理,方式與內置評估器完全相同。如果團隊已在開發過程中使用其中一個程式庫,便可在正式環境中執行相同的評估指標,無須另設評估服務。
- 自訂評估器以內置或第三方評估器為基礎,讓你可以換用自己的模型,並修改提示詞或評分準則。
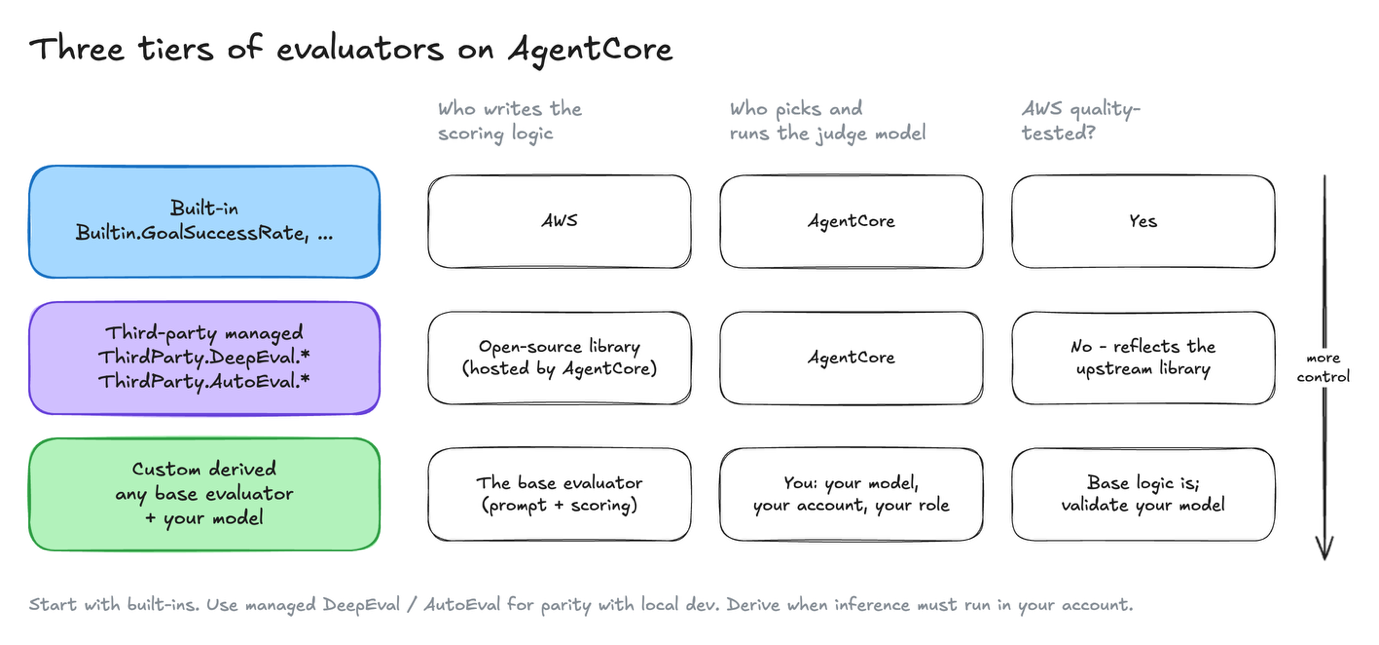
圖 3:三個評估器層級在 AWS 品質保證與逐步提高對執行推理的模型及帳戶的控制權之間取捨
建立後,自訂衍生評估器的用法與其他評估器完全相同。
評估器全貌
AgentCore 提供種類繁多的評估器,讓你很少需要從零開始。在撰寫自訂評判器之前,先檢查目錄中是否已有評估器,可用來衡量你關注的行為。下圖展示完整的評估器全貌。
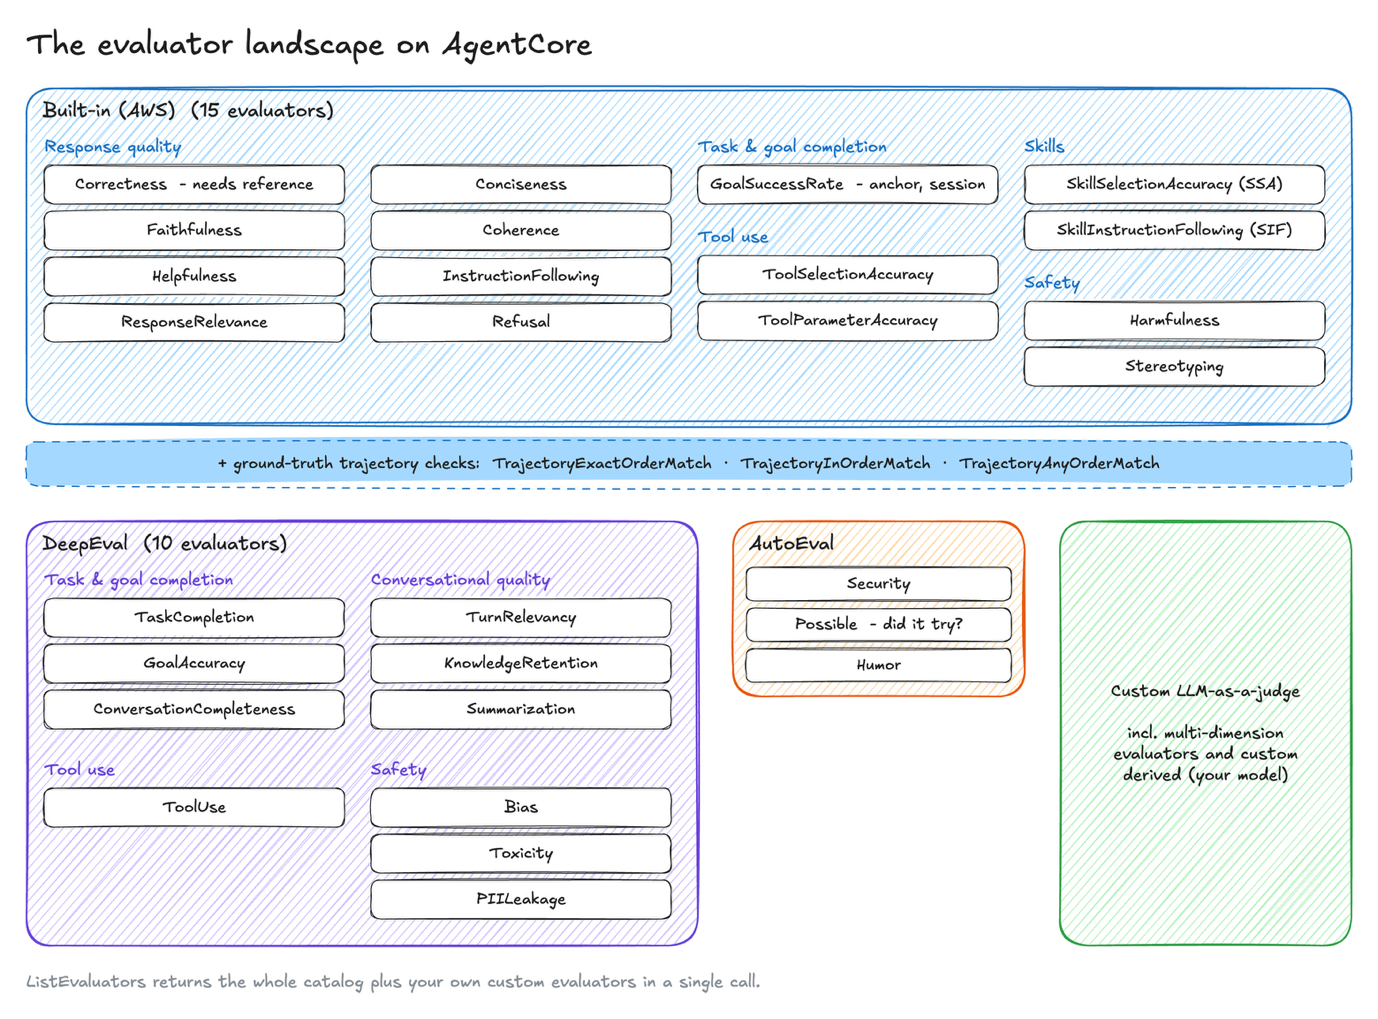
圖 4:AgentCore 上完整的評估器全貌,涵蓋內置、DeepEval、AutoEval 和自訂來源
AWS 內置評估器分為五組:
- 回應品質用於評估答案是否準確、有根據且表達完整:
Correctness、Faithfulness、Helpfulness、ResponseRelevance、Conciseness、Coherence、InstructionFollowing和Refusal。 - 任務和目標完成度包括
GoalSuccessRate,它會檢視整個工作階段,判斷用戶的目標是否達成。 - 工具使用包括
ToolSelectionAccuracy和ToolParameterAccuracy,用來檢查代理是否選對工具,以及是否傳入正確的引數。 - 技能包括
SkillSelectionAccuracy和SkillInstructionFollowing,適用於載入技能的代理:是否調用了正確的技能,以及是否遵循其步驟? - 安全性包括
Harmfulness和Stereotyping。
此外,還有三項以真實答案為基準的軌跡檢查:TrajectoryExactOrderMatch、TrajectoryInOrderMatch和TrajectoryAnyOrderMatch。它們會比較代理實際使用的工具路徑與預期路徑。當代理如何達成目標與產出結果同樣重要時,便可使用這些檢查。
DeepEval提供四組託管開源評估指標:
- 任務和目標完成度:
TaskCompletion、GoalAccuracy和ConversationCompleteness。 - 對話品質:
TurnRelevancy、KnowledgeRetention和Summarization。 - 工具使用:
ToolUse。 - 安全性:
Bias、Toxicity和PIILeakage。
這些評估指標對多輪對話代理尤其有用。ConversationCompleteness會找出只回答最新訊息,卻悄悄遺漏較早要求的代理。KnowledgeRetention則會找出忘記用戶在三輪對話前提過的內容的代理。
AutoEval提供更專門的評估信號:
Security會標示惡意輸出,例如試圖注入指令或揭露系統提示詞。Possible會找出過度謹慎、錯誤地宣稱有效任務無法完成的代理。Humor適用於面向消費者的代理;在這類產品中,個性也是產品的一部分。
自訂評估器。如果目錄中沒有合適的評估器,你可以編寫自訂的 LLM 評判器。
每個評估器的確切定義、評分尺度和輸入要求,均載於AgentCore 説明文件的提示詞範本庫中。當中包括評估器使用的評判提示詞、執行時所採用的追蹤記錄或工作階段層級,以及是否需要參考答案或預期軌跡。你可以呼叫ListEvaluators API,一次取得完整目錄和自己的自訂評估器。
多維度評估器
目前為止,每個評估器都會為每條執行軌跡或工作階段回傳一個分數。當你只衡量一種行為時,這種做法行得通。但在結果映射的第 2 步中,每個評估器很少只對應一種行為。客服回覆必須解決問題、遵守退款及資料政策,並保持專業。若由一個評審衡量這三項,最後只會得到一個數字,無法看出是哪項準則影響了分數。
多維度評估器是一種自訂的 LLM 評審,包含多個維度,而非單一評分尺度。每個維度都有自己的名稱、指示,以及數值或類別量表。評審只需讀取一次執行軌跡,便會在同一次呼叫中為所有維度評分。AgentCore 會為每個維度回傳一項結果。
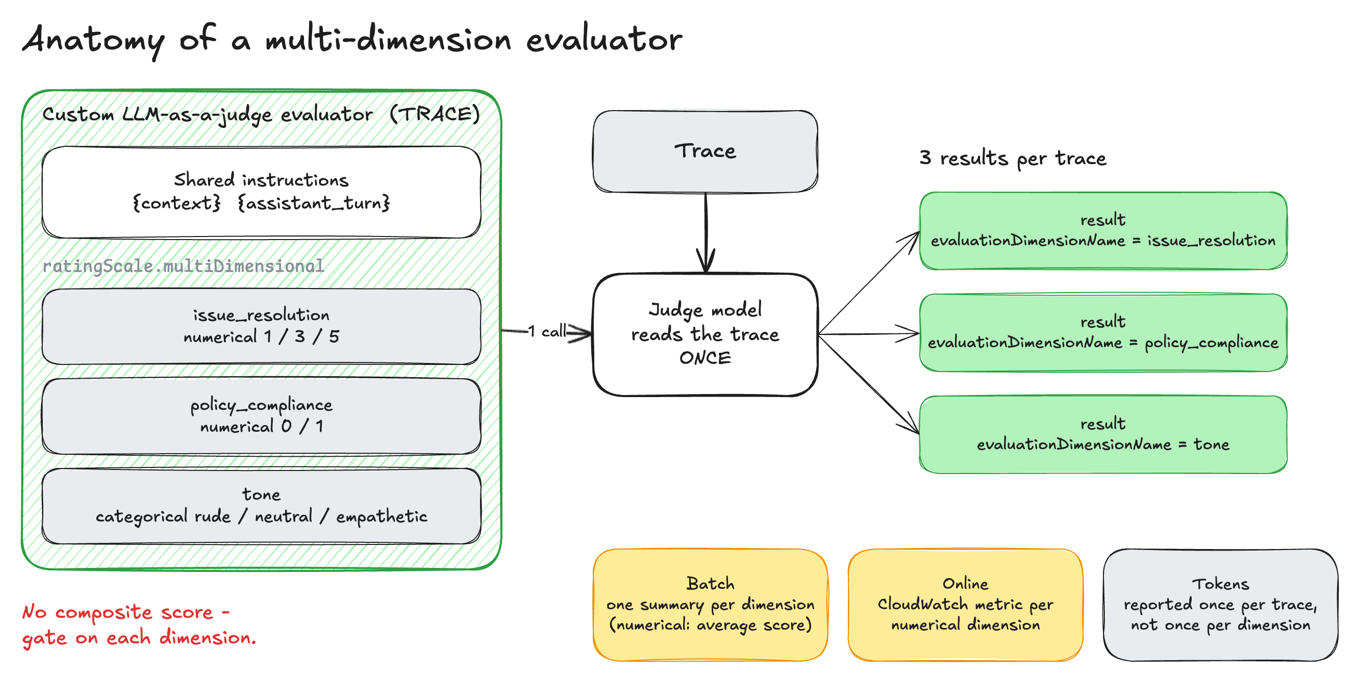
圖 5:多維度評估器透過一次評審呼叫為多個維度評分,並為每個維度回傳一項結果,不提供綜合分數
當不同成功準則可以各自失敗時,請使用多維度評估器,例如答案準確但不合規,或問題已解決但語氣粗魯。這種做法亦要求每項準則都能根據相同證據作出判定,讓一次評審呼叫取代多個幾乎相同、反覆讀取同一執行軌跡的評估器。分開為各項準則評分後,你便可以逐項設定門檻。若某次發佈改善了語氣,卻令政策合規性倒退,就不應通過;單一的綜合分數則可能掩蓋這種情況。
若已有成熟的內置或第三方指標涵蓋相關準則,請讓它們使用獨立評估器,例如 Builtin.Correctness 或 ThirdParty.DeepEval.PIILeakage。若準則需要不同的評估層級或評審模型,也應分開處理,因為同一評估器內的維度會共用相同層級和模型。部分準則若需要標準答案,例如 {expected_response} 或 {assertions},亦應分開處理。將不需要參考答案的準則放在獨立評估器中,便仍可用它評估即時流量。
按 Agent 類型分類的評估器組合
以下每組評估器都會先採用兩至三個最符合業務成果的評估器。若你發現這組評估器未能捕捉某種失敗情況,再加入其他評估器。標示為「需要標準答案」的評估器只會在批次評估中執行,因為即時流量沒有參考答案或預期路徑。
| 客戶支援 | 多步驟研究 | 專業領域內容(醫療、法律、金融) | |
| 業務成果 | 在一次工作階段內解決問題,且不造成後續風險 | 透過明確的工作流程,提供完整且有充分來源支持的答案 | 在相關領域提供正確、公正、安全的答案 |
| 主要風險 | 遺漏請求,或回覆不安全、不合規 | 透過錯誤的工具路徑得出正確答案,或在長時間工作階段中遺失上下文 | 答案錯誤。答錯比不回答更糟。 |
| 先採用 |
|
|
|
| 有需要時加入 |
|
|
|
| 衍生評估器 | 可選 | 若推理作業必須留在你的帳戶內,則用於執行軌跡及技能指標 | 幾乎總是需要,確保每次評審呼叫都符合你的數據治理要求 |
執行評估:三種模式
AgentCore 支援三種評估模式。
隨選評估可提供最快的回饋。在開發或除錯期間,直接將工作階段傳送至 client.evaluate()。系統中的所有評估器(包括第三方評估器)都可在此模式下運作。
import boto3

client = boto3.client('bedrock-agentcore')

response = client.evaluate(
    evaluatorId="ThirdParty.DeepEval.TaskCompletion",
    evaluationInput={"sessionSpans": session_span_logs}
)

for result in response["evaluationResults"]:
    print(f"Value: {result.get('value')}")
    print(f"Explanation: {result.get('explanation', '')}")
線上評估會連接至即時 Agent 執行環境,並按設定的比率抽樣實際流量,作為生產環境的健康狀況指標。你可以在同一個線上評估設定中自由混用內置及第三方評估器。
批次評估會針對固定的一組工作階段執行指定的評估器組合:這就是你在發布前用於回歸測試的黃金數據集。你可以藉此確認提示詞變更或模型升級後,在你關注的各個維度上仍能維持品質。
三種模式使用相同的評估器 ID。由按需開發測試切換至正式環境線上評估,只需更改設定,無須重寫程式碼。
整合運用
愈來愈多時,難處在於選擇哪些評估器。先挑選最能反映你是否達成業務目標的兩三種行為,並優先衡量這些行為。發現目前的評估器組合未能識別某項失誤時,再新增評估器。
如要查看完整目錄,請呼叫 ListEvaluators API。它會在同一個回應中列出內置、DeepEval 和 AutoEval 評估器,以及你帳戶中的任何自訂評估器。選擇前,先回答兩個問題:「這個 Agent 怎樣才算成功?」以及「追蹤記錄中的哪種行為能顯示它已成功?」
作者簡介

Bharathi Srinivasan
Bharathi 是 AWS 可信任 AI 領域的技術市場推廣專家,協助機構將前沿 AI 概念安全地應用於真實世界的正式環境。她熱衷於 AI 可靠性及開發者支援,經常發表有關 LLM 評估、可靠性和安全性的研究及程式碼範例。閒暇時,她喜歡探索山間小徑、為野外探險作準備,以及欣賞韓劇。

Neha Thakur
Neha 是 AWS 解決方案架構師,既是涵蓋 AWS 各類服務的通才,也是 AI/ML 專家。她與英國一些規模最大的銀行和金融科技公司合作,利用 AWS AI/ML 服務協助解決複雜的業務挑戰。她對 AI 可解釋性抱有濃厚熱忱,並致力令人工智能更透明、易於解釋和值得信賴。

Visakh Madathil
Visakh 是 AWS 解決方案架構師,與客戶及內部團隊合作,致力提升正式環境中 AI 系統的可理解性、可信度及安全性。他有關 AI 安全與可靠性的研究曾於機器學習會議上發表。工作以外,他喜歡音樂、觀鳥和運動。

Manoj Selvakumar
Manoj 是 AWS AI 專家解決方案架構師,協助初創公司及企業在 Amazon Bedrock 上建構並擴展 AI 應用程式和 Agent。他的工作涵蓋模型推理、Agent harness 和 Agent 評估,研究模型與 Agent 在真實世界要求下的行為,以及如何令它們在大規模運作時保持可靠。他與 AWS 服務團隊合作,將這些來自正式環境的洞見轉化為產品發展方向及服務改進。
來源:AWS Machine Learning Blog · aws.amazon.com