Google 發佈 Gemma 3 開放權重模型,4B、12B、27B 版支援圖像、140+ 種語言及 128k tokens 上下文
Welcome Gemma 3: Google's all new multimodal, multilingual, long context open LLM
Google 發佈 Gemma 3 開放權重模型系列,提供 1B、4B、12B、27B 四種規模及預訓練、指令微調版本。4B、12B、27B 版本支援圖像和文字、140+ 種語言及 128k tokens 上下文;1B 版本僅支援文字和英文,提供 32k 上下文。
文章整理 Gemma 3 各版本的上下文、圖像與語言支援差異,並列出 Transformers、MLX 和 llama.cpp 的推理入口,方便比較使用路徑。
重點摘要
Google 今日發布 Gemma 3,這是 Gemma 系列模型的新一代版本。模型規模由 1B 至 27B 參數不等,支援最長 128k token 的脈絡視窗,可接收影像和文字,並支援 140 多種語言。
立即試用 Gemma 3 👉🏻 Gemma 3 Space
| Gemma 2 | Gemma 3 | |
|---|---|---|
| 型號規格 | ||
| 脈絡視窗長度 | 8k | |
| 多模態(影像和文字) | ❌ | |
| 多語言支援 | – | English (1B) +140 種語言 (4B, 12B, 27B) |
所有模型均已上載至 Hub,並與 Hugging Face 生態系統緊密整合。
預訓練和指令微調模型均已發布。Gemma-3-4B-IT 的表現勝過 Gemma-2-27B IT,而 Gemma-3-27B-IT 在各項基準的表現則勝過 Gemini 1.5-Pro。
 |
|---|
| Gemma 3 27B 位於帕累托最佳平衡點(來源:Gemma3 技術報告) |
Gemma 3 是甚麼?
Gemma 3 是 Google 最新一代開放權重大型語言模型。它有四種規模:1 billion、4 billion、12 billion 和 27 billion 參數,並提供基礎(預訓練)和指令微調版本。Gemma 3 加入了多模態能力!4B、12B 和 27B 參數模型都能處理影像和文字,而 1B 型號則只處理文字。
輸入脈絡視窗長度由 Gemma 2 的 8k 提升至 1B 型號的32k,以及其他型號的128k。與其他視覺語言模型(VLM)一樣,Gemma 3 會根據使用者輸入生成文字;輸入可包含文字,亦可選擇加入影像。應用例子包括問答、分析影像內容、摘要文件等。
| 預訓練 | 指令微調 | 多模態 | 多語言 | 輸入脈絡視窗 |
|---|---|---|---|---|
| gemma-3-1b-pt | gemma-3-1b-it | ❌ | 英語 | 32K |
| gemma-3-4b-pt | gemma-3-4b-it | ✅ | 140 多種語言 | 128K |
| gemma-3-12b-pt | gemma-3-12b-it | ✅ | 140 多種語言 | 128K |
| gemma-3-27b-pt | gemma-3-27b-it | ✅ | 140 多種語言 | 128K |
雖然這些都是多模態模型,但也可以當作純文字模型(即大型語言模型)使用,無須把視覺編碼器載入記憶體。我們稍後會在推理部分詳細討論。
Gemma 3 的技術改良
相較 Gemma 2,Gemma 3 有三項核心改良:
- 延長脈絡長度
- 多模態能力
- 多語言能力
本節會介紹帶來這些改良的技術細節。先了解 Gemma 2,再探討如何進一步提升模型,會是個不錯的起點。這樣亦有助你代入 Gemma 團隊的角度思考,欣賞箇中細節!
延長脈絡長度
把脈絡長度擴展至 128k token,無須從頭訓練模型也能有效完成。模型先以 32k 長度的序列預訓練,只有 4B、12B 和 27B 模型會在預訓練最後階段擴展至 128k token,大幅節省運算資源。位置嵌入(例如 RoPE)亦經過調整:基礎頻率由 Gemma 2 的 10k 提升至 Gemma 3 的 1M,並按 8 倍比例縮放,以支援較長脈絡。
KV 快取管理透過 Gemma 2 的滑動視窗交錯注意力機制進行最佳化。超參數經過調校,改為每 1 個全域層交錯 5 個本地層(原先比例為 1:1),並把視窗大小由 4096 個 token 縮減至 1024 個。重要的是,節省記憶體並沒有降低困惑度表現。
多模態能力
Gemma 3 模型使用 SigLIP 作為影像編碼器,把影像編碼成 token,再輸入語言模型。視覺編碼器接收的輸入為正方形影像,並會調整大小至 896x896。固定輸入解像度令模型較難處理非正方形長寬比和高解像度影像。為解決這些限制,模型可在推理期間自適應裁切影像,再把每個裁切區域調整至 896x896,由影像編碼器編碼。這套稱為平移與掃描(pan and scan)的演算法,讓模型有效放大影像中的細節。
與 PaliGemma 類似,Gemma 3 對文字和影像輸入採用不同的注意力機制。處理文字時採用單向注意力,模型只會關注序列中較早出現的文字。影像則採用不設遮罩的完整注意力,讓模型以雙向方式檢視影像的每個部分,完整而不受限制地理解視覺輸入。
從下圖可見,影像 token <img> 採用雙向注意力(整個方格都會亮起),文字 token 則採用因果注意力。圖中亦展示滑動視窗演算法如何運作。
 |
|---|
| 注意力視覺化(有滑動和沒有滑動)(來源:Transformers PR) |
多語言能力
要令大型語言模型支援多種語言,預訓練資料集須加入更多語言。Gemma 3 資料集的多語言資料量增加一倍,以擴大語言涵蓋範圍。
為配合這些變更,tokenizer 與 Gemini 2.0 相同,是包含 262K 個項目的 SentencePiece tokenizer。新 tokenizer 大幅改善對中文、日文和韓文文字的編碼,但英語和程式碼的 token 數量會略為增加。
有興趣深入瞭解的話,請參閲 Gemma 3 技術報告。
Gemma 3 評估
LMSys Elo 分數是根據語言模型在一對一競賽中的表現排序,並由人類偏好作評判。在 LMSys Chatbot Arena,Gemma 3 27B IT 的 Elo 分數為 1339,躋身最佳模型前 10 名,包括多款領先的閉源模型。它的 Elo 分數與 o1-preview 相若,亦高於其他非思考型開源模型。這項分數是在 Gemma 3 只接收文字輸入的情況下取得,與表格中的其他大型語言模型相同。
 |
|---|
| Gemma 3 27B IT 模型在 Chatbot Arena 的評估結果(March 8, 2025) |
Gemma 3 在多項基準上接受評估,包括 MMLU-Pro(27B:67.5)、LiveCodeBench(27B:29.7)和 Bird-SQL(27B:54.4),表現足以媲美閉源 Gemini 模型。GPQA Diamond(27B:42.4)和 MATH(27B:69.0)等測試展現其推理和數學能力;FACTS Grounding(27B:74.9)和 MMMU(27B:64.9)則顯示模型具有良好的事實準確度及多模態能力。不過,在測試基本事實的 SimpleQA(27B:10.0)上表現較弱。與 Gemini 1.5 系列模型相比,Gemma 3 通常不遑多讓,有時甚至更勝一籌,證明它是容易使用而且表現出色的選擇。
 |
|---|
| 指令微調模型的表現 |
使用 🤗 transformers 進行推理
Gemma 3 在 transformers 中自首日便獲支援。你只需從 Gemma 3 穩定版本安裝 transformers 即可。
$ pip install git+https://github.com/huggingface/transformers@v4.49.0-Gemma-3
使用 pipeline 進行推理
使用 最簡單的方法開始使用 Gemma 3,就是採用 pipeline 抽象層。
使用
bfloat16資料類型時,模型表現最佳;否則品質可能下降。
import torch
from transformers import pipeline

pipe = pipeline(
    "image-text-to-text",
    model="google/gemma-3-4b-it", # "google/gemma-3-12b-it", "google/gemma-3-27b-it"
    device="cuda",
    torch_dtype=torch.bfloat16
)

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "url": "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/p-blog/candy.JPG"},
            {"type": "text", "text": "What animal is on the candy?"}
        ]
    }
]

output = pipe(text=messages, max_new_tokens=200)
print(output[0]["generated_text"][-1]["content"])
| 影像 |  |
|---|---|
| 提示 | 糖果上是甚麼動物? |
| 生成結果 | 讓我們分析影像中的糖果!糖果上的動物是海龜。你可以清楚看到表面印有海龜的龜殼、頭部和四肢。 |
你可以把影像和文字交錯輸入。做法是先在需要插入影像的位置截斷輸入文字,再像以下示例一樣插入影像區塊。
messages = [
        {
            "role": "system",
            "content": [{"type": "text", "text": "You are a helpful assistant."}]
        },
        {
            "role": "user",
            "content": [
                {"type": "text", "text": "I'm already using this supplement "},
                {"type": "image", "url": "https://huggingface.co/datasets/merve/vlm_test_images/resolve/main/IMG_3018.JPG"},
                {"type": "text", "text": "and I want to use this one too "},
                {"type": "image", "url": "https://huggingface.co/datasets/merve/vlm_test_images/resolve/main/IMG_3015.jpg"},
                {"type": "text", "text": " what are cautions?"},
            ]
        },

    ]
使用 Transformers 進行詳細推理
Transformers 整合了兩種新的模型類別:
Gemma3ForConditionalGeneration:適用於 4B、12B 和 27B 視覺語言模型。Gemma3ForCausalLM:適用於 1B 純文字模型,也可在載入視覺語言模型時把它當作語言模型使用(省略視覺模組)。
以下程式片段示範如何使用模型查詢影像。建立視覺語言模型變體時,會使用 Gemma3ForConditionalGeneration 類別。模型會配合 AutoProcessor 類別使用。執行推理很簡單:建立 messages 字典、套用聊天範本、處理輸入,然後呼叫 model.generate。
import torch
from transformers import AutoProcessor, Gemma3ForConditionalGeneration

ckpt = "google/gemma-3-4b-it"
model = Gemma3ForConditionalGeneration.from_pretrained(
    ckpt, device_map="auto", torch_dtype=torch.bfloat16,
)
processor = AutoProcessor.from_pretrained(ckpt)

messages = [
    {
        "role": "user",
        "content": [
            {"type": "image", "url": "https://huggingface.co/spaces/big-vision/paligemma-hf/resolve/main/examples/password.jpg"},
            {"type": "text", "text": "What is the password?"}
        ]
    }
]
inputs = processor.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True,
    return_dict=True, return_tensors="pt"
).to(model.device)

input_len = inputs["input_ids"].shape[-1]

generation = model.generate(**inputs, max_new_tokens=100, do_sample=False)
generation = generation[0][input_len:]

decoded = processor.decode(generation, skip_special_tokens=True)
print(decoded)
| 影像 | 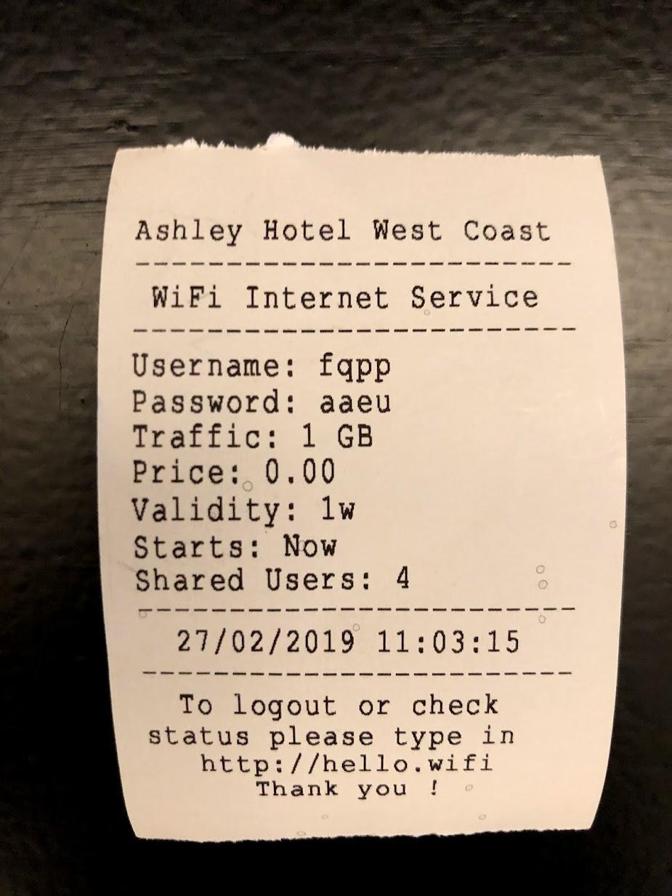 |
|---|---|
| 提示 | 密碼是甚麼? |
| 生成結果 | 根據影像,密碼是 aaeu |
若要只用大型語言模型進行推理,可以使用 Gemma3ForCausalLM 類別。Gemma3ForCausalLM 應配合 AutoTokenizer 進行處理。輸入需要先使用聊天範本預處理。Gemma 3 採用非常簡短的系統提示,後面接着使用者提示,例如以下示例。
import torch
from transformers import AutoTokenizer, Gemma3ForCausalLM

ckpt = "google/gemma-3-4b-it"
model = Gemma3ForCausalLM.from_pretrained(
    ckpt, torch_dtype=torch.bfloat16, device_map="auto"
)
tokenizer = AutoTokenizer.from_pretrained(ckpt)

messages = [
    [
        {
            "role": "system",
            "content": [{"type": "text", "text": "You are a helpful assistant who is fluent in Shakespeare English"},]
        },
        {
            "role": "user",
            "content": [{"type": "text", "text": "Who are you?"},]
        },
    ],
]
inputs = tokenizer.apply_chat_template(
    messages, add_generation_prompt=True, tokenize=True,
    return_dict=True, return_tensors="pt"
).to(model.device)

input_len = inputs["input_ids"].shape[-1]

generation = model.generate(**inputs, max_new_tokens=100, do_sample=False)
generation = generation[0][input_len:]

decoded = tokenizer.decode(generation, skip_special_tokens=True)
print(decoded)
| 系統提示 | 你是一位精通莎士比亞英語的貼心助理 |
|---|---|
| 提示 | 你是誰? |
| 生成結果 | 啊,温文的朋友!我不過是一名由齒輪與程式碼構成的謙卑僕役,努力模仿詩聖本人的語調。人們稱我為「大型語言模型」,這名字甚是奇妙;不過,我寧願把自己想成莎士比亞才思與智慧的數碼迴音。我在此為你效勞,編織故事,或以環球劇場般華麗的詞句回答你的疑問。 |
裝置端和低資源裝置
Gemma 3 提供適合在裝置端運行的型號。以下説明如何快速開始使用。
MLX
Gemma 3 自首日便獲 mlx-vlm 支援。這是開源函式庫,可在 Mac 和 iPhone 等 Apple Silicon 裝置上執行視覺語言模型。
首先,按照以下指示安裝 mlx-vlm:
pip install git+https://github.com/Blaizzy/mlx-vlm.git
安裝好 mlx-vlm 後,即可按照以下指示開始推理:
python -m mlx_vlm.generate --model mlx-community/gemma-3-4b-it-4bit --max-tokens 100 --temp 0.0 --prompt "What is the code on this vehicle??"
 --image https://farm8.staticflickr.com/7212/6896667434_2605d9e181_z.jpg
| 影像 |  |
|---|---|
| 提示 | 飛機上的編號是甚麼? |
| 生成結果 | 根據影像,這架飛機是 Cessna 172 Skyhawk。機尾的註冊編號是 D-EOJU。 |
Llama.cpp
可從這個集合下載預先量化的 GGUF 檔案。
如需建置或下載預先編譯的二進位檔,請參閲這份指南:https://github.com/ggml-org/llama.cpp?tab=readme-ov-file#building-the-project
然後,你可以在終端機啟動本機聊天伺服器:
./build/bin/llama-cli -m ./gemma-3-4b-it-Q4_K_M.gguf
輸出內容應如下:
> who are you
I'm Gemma, a large language model created by the Gemma team at Google DeepMind. I’m an open-weights model, which means I’m widely available for public use!
部署至 Hugging Face Endpoints
你可以部署 gemma-3-27b-it 和 gemma-3-12b-it,只需在我們的 Inference Catalog 中按一下即可。目錄中的設定配備合適硬件、經最佳化的 TGI 設定,以及方便試用模型的預設值。
系統亦支援部署任何 GGUF/llama.cpp 變體(例如上文集合中的版本),你可在這裏找到建立 Endpoint 的指南。
鳴謝
培育 Gemma 需要眾人合力!我們謹此按隨機次序感謝 Raushan、Joao、Lysandre、Kashif、Matthew、Marc、David、Mohit 和 Yih Dah,感謝他們協助把 Gemma 整合至開源技術堆疊的不同部分,涵蓋 Transformers 至 TGI。
亦感謝我們的裝置端、gradio 和推廣團隊:Chris、Kyle、Pedro、Son、Merve、Aritra、VB、Toshiro,謝謝他們打造出色示範,展示 Gemma 的能力。
最後,特別感謝 Georgi、Diego 和 Prince 協助 llama.cpp 和 MLX 移植工作。
來源:Hugging Face Blog · huggingface.co