Deep Insight 如何解決多智能體系統的 5 項生產環境挑戰
5 production challenges in multi-agent systems and how Deep Insight solved them
AWS Solutions Architecture 團隊以 Deep Insight 説明如何應對多智能體系統投入生產環境的 5 項挑戰,涵蓋執行流程、模型選擇、程式碼安全及監控。
文章把多智能體生產部署拆成協作流程、模型分工、程式碼隔離和營運監控等層面,並交代各項設計採用的元件與取捨。
建立多代理系統現在相當簡單。要將它投入生產環境,真正的挑戰才剛開始。多虧開源框架和雲端服務,你只需幾天便能設定一個 Agent。呼叫幾次工具、寫下幾行提示詞,就能做出看似令人印象深刻的東西。但團隊一旦嘗試從試點階段邁向實際業務應用,就會遇上熟悉的瓶頸。如果你曾嘗試將 Agent 投入生產環境,以下這些挫折想必不會陌生:
為甚麼 Agent 不遵循我們的業務邏輯、跳過驗證步驟,或無法處理邊界情況?
你調整提示詞、加入更多範例、更換模型,但同樣的問題依然反覆出現。這是因為 Agent 不會按照固定的指示次序行事,而是根據上下文自行判斷。單靠指示並不足夠。你需要設計 Agent 如何思考、何時進行驗證,以及出錯時如何處理。正因如此,不能只做提示詞工程,還必須設計 Agent 的整套認知架構和執行流程,這已變得至關重要。
為了直接應對這些挑戰,AWS Solutions Architecture 團隊打造了Deep Insight,一個生產級多代理系統。在這個系列的三篇文章中,我們會分享團隊親自建構 Deep Insight 的心得,並介紹如何在實際生產環境中應用 Anthropic 提出的上下文工程技術(多代理架構、結構化筆記、人在迴路等)。我們亦會透過程式碼介紹過程中遇到的取捨,以及在 AWS 上部署和運行這個 Agent 所獲得的營運心得。
系列文章概覽
- 第 1 部分:多代理系統面對的 5 個生產環境挑戰,以及 Deep Insight 如何應對。
- 第 2 部分:超越上下文視窗:上下文工程技術,以及 Deep Insight 如何應用這些技術。
- 第 3 部分:Harness engineering 實踐:將 Deep Insight 從開發環境推進至生產環境。
本文是三篇系列文章的第 1 部分,介紹任何生產級多代理系統都必須解決的五項核心挑戰,並説明堆疊中的各層如何應對這些挑戰,涵蓋Strands Agents SDK、Amazon Bedrock、Amazon Bedrock AgentCore、Application Load Balancer和AWS Fargate。第 2 和第 3 部分會介紹上下文工程和生產環境部署。
認識 Deep Insight
Deep Insight 是一個多代理系統,能將複雜的數據分析轉化為自動化洞見。只要提供 CSV 檔案和自然語言提示詞,由專門 Agent 組成的階層(協調員、規劃員、監督員、程式編寫員、驗證員、報告員和追蹤員)便會協作分析。這些 Agent 會一同載入數據、進行分析、產生圖表、驗證計算結果,並製作附有資料來源引用的專業報告(.docx)。
我們稍後會詳細探討其架構。首先,看看它如何運作。在示範中,我們會提供虛構食品公司 Yummy Food 的廣告數據(yummy-food-market.csv)和欄位定義檔案(column_definitions.json),並輸入以下提示詞:從銷售和市場推廣角度分析這些資料,產生圖表和洞見,並製作 .docx 報告。Deep Insight 會產生分析計劃,交由用戶審批;獲批後,便會執行分析。
| 內容 | |
| 輸入 | CSV 數據檔案(yummy-food-market.csv)+ 欄位定義檔案(column_definitions.json) |
| 提示詞範例 | “請從銷售及市場營銷角度分析這些資料,生成圖表和洞見,並製作 .docx 報告。” |
| 輸出 | DOCX 報告(兩個版本:一個附有引註,另一個不附引註),以及圖表圖像(PNG) |
以下的 Deep Insight 網頁示範影片展示完整工作流程,從上載資料、檢視分析計劃,到即時串流和下載完成的報告。
如何試用?
Deep Insight 已在 GitHub 上開放原始碼,提供完整的設定指南,並提供三種部署選項,涵蓋由開發到正式環境。
第一種是自行託管版本,透過 CLI 在本機運行。此版本專為快速反覆測試而設,可完整存取每個代理、提示詞和工作流程的程式碼。約 10 分鐘即可完成設定,因此非常適合開發用途。(YouTube 上提供自行託管版本的示範影片。)
第二種是網頁版,提供瀏覽器介面,讓用戶上載資料、檢視分析計劃(Human-in-the-Loop,或 HITL)及下載報告,整個過程無須編寫程式碼,非開發人員也能使用。(前面的示範影片展示了網頁版的操作。)
第三種是受管理的 AgentCore 版本,這是一種正式環境部署選項,由 Amazon Bedrock AgentCore 提供支援。Amazon Bedrock AgentCore 是一個平台,可使用任何框架或模型,大規模建置、連接及最佳化代理。此版本會將代理部署至 AgentCore runtime;這是 Amazon Bedrock AgentCore 的一項功能。系統完全在私有虛擬私有雲(VPC)內運行,自訂 Code Interpreter 則獨立託管於 AWS Fargate 上,而代理會在各用戶彼此隔離的環境中並行運行。如果你需要工作階段隔離和私有 VPC 部署,這個版本便是合適之選。第 3 部分會詳細介紹其部署及運作方式。
三種版本共用相同的多代理架構,因此在開發環境中驗證過的代理可直接部署至正式環境,無須修改。
解決方案概覽
建置正式環境的多代理系統,不只是寫好提示詞便足夠。你需要合適的技術堆疊和基礎設施,以處理代理如何協作、如何推理、如何部署、在哪裏安全地執行程式碼,以及如何監察系統的運作狀況。Deep Insight 針對這五個關鍵範疇提供解決方案。由於代理會生成程式碼和報告內容,我們也會在解決方案詳情 2 中介紹正式環境所需的負責任 AI 控制措施。
| 挑戰 | 技術 | 方法 |
| “如何控制多個代理之間的執行流程?” | Strands Agents SDK | 使用 Strands 的 Graph 模式,定義代理之間的執行次序,並實作人在迴圈(human-in-the-loop)分支處理。使用 Strands 的 Agents as Tools 模式,讓 Supervisor 可按需要將專門代理(Coder、Validator、Reporter、Tracker)作為工具呼叫。 |
| “每個代理應使用哪個大型語言模型(LLM)?” | Amazon Bedrock | 為各個角色選擇合適的 Claude 模型:基本路由使用 Haiku,規劃使用 Opus,執行使用 Sonnet。 |
| “如何在正式環境中可靠地運行已完成的代理?” | Amazon Bedrock AgentCore | 提供監察、工作階段隔離及私有 VPC 部署的受管理執行環境。 |
| “如何降低執行 AI 生成程式碼所帶來的安全風險?” | AWS Fargate + Application Load Balancer (ALB) | 透過自訂 Code Interpreter,使用每個工作階段專屬的臨時沙盒容器,隔離執行程式碼。 |
| “如何監察和管理系統?” | Amazon DynamoDB + Amazon Simple Notification Service (Amazon SNS) + Amazon Cognito | 管理儀錶板及故障警示系統。 |
以下架構圖(圖 1)展示了整體概況。綠色方框代表 Strands Agents 多代理架構,可應對上表中的挑戰 1 和 2。我們會在接下來的「方案詳情 1:多代理系統設計」一節深入介紹。圖中其餘基礎設施元件則可應對挑戰 3、4 和 5,我們會在「方案詳情 2:正式環境部署及營運」一節逐一説明。
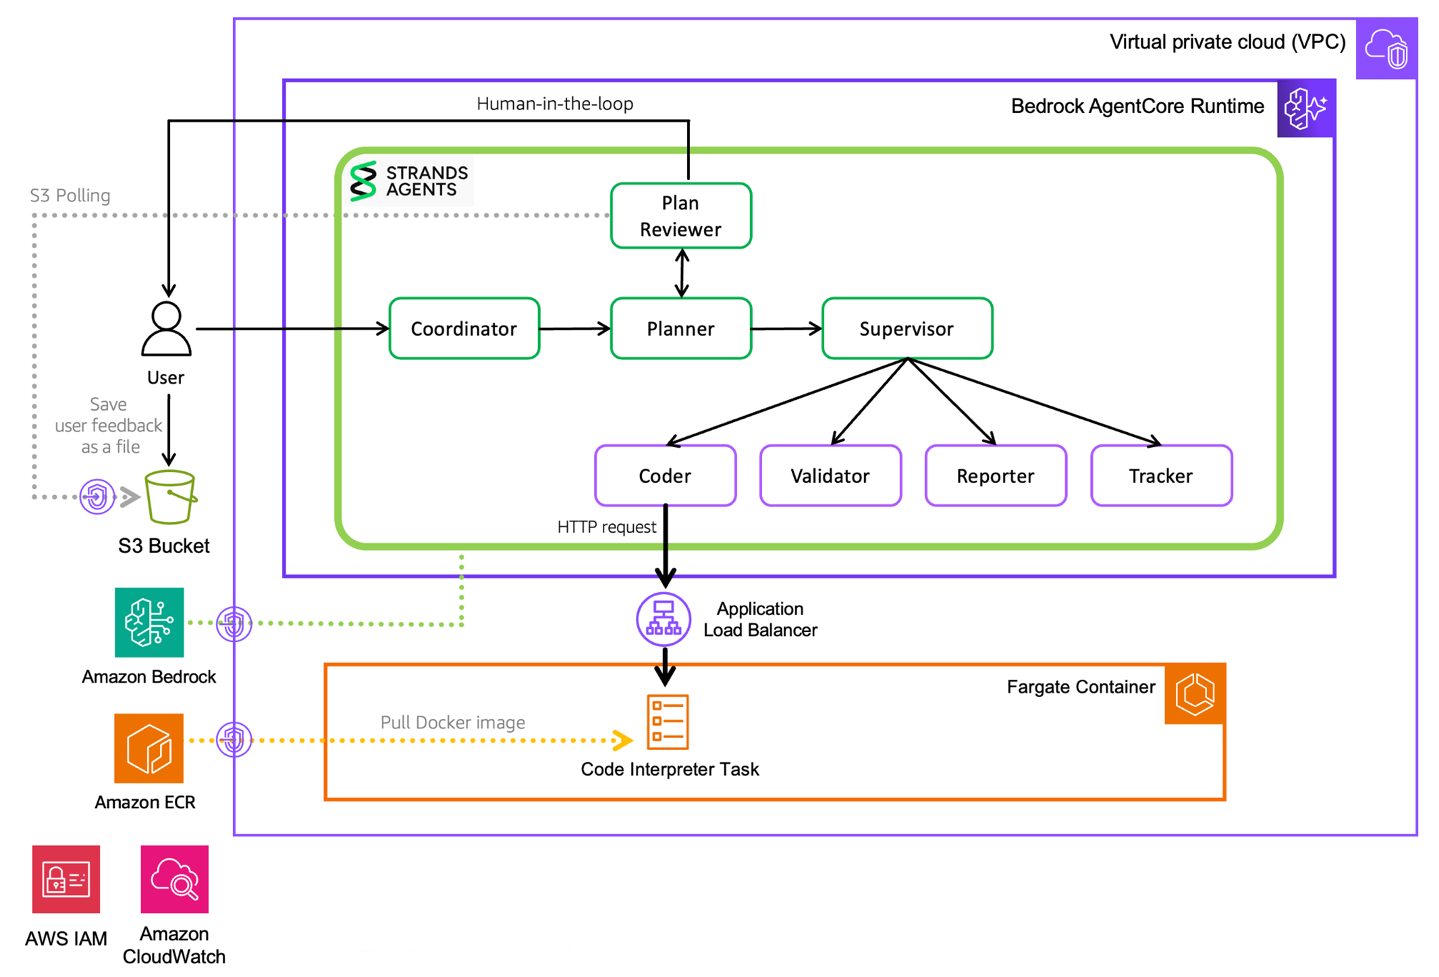
圖 1:方案架構
方案詳情 1:多代理系統設計
Deep Insight 採用多代理架構,由八個代理協作,產出一份高質素的成果。每個代理都在自己的獨立上下文中工作,只執行專門負責的任務,並只傳遞經壓縮的結果。
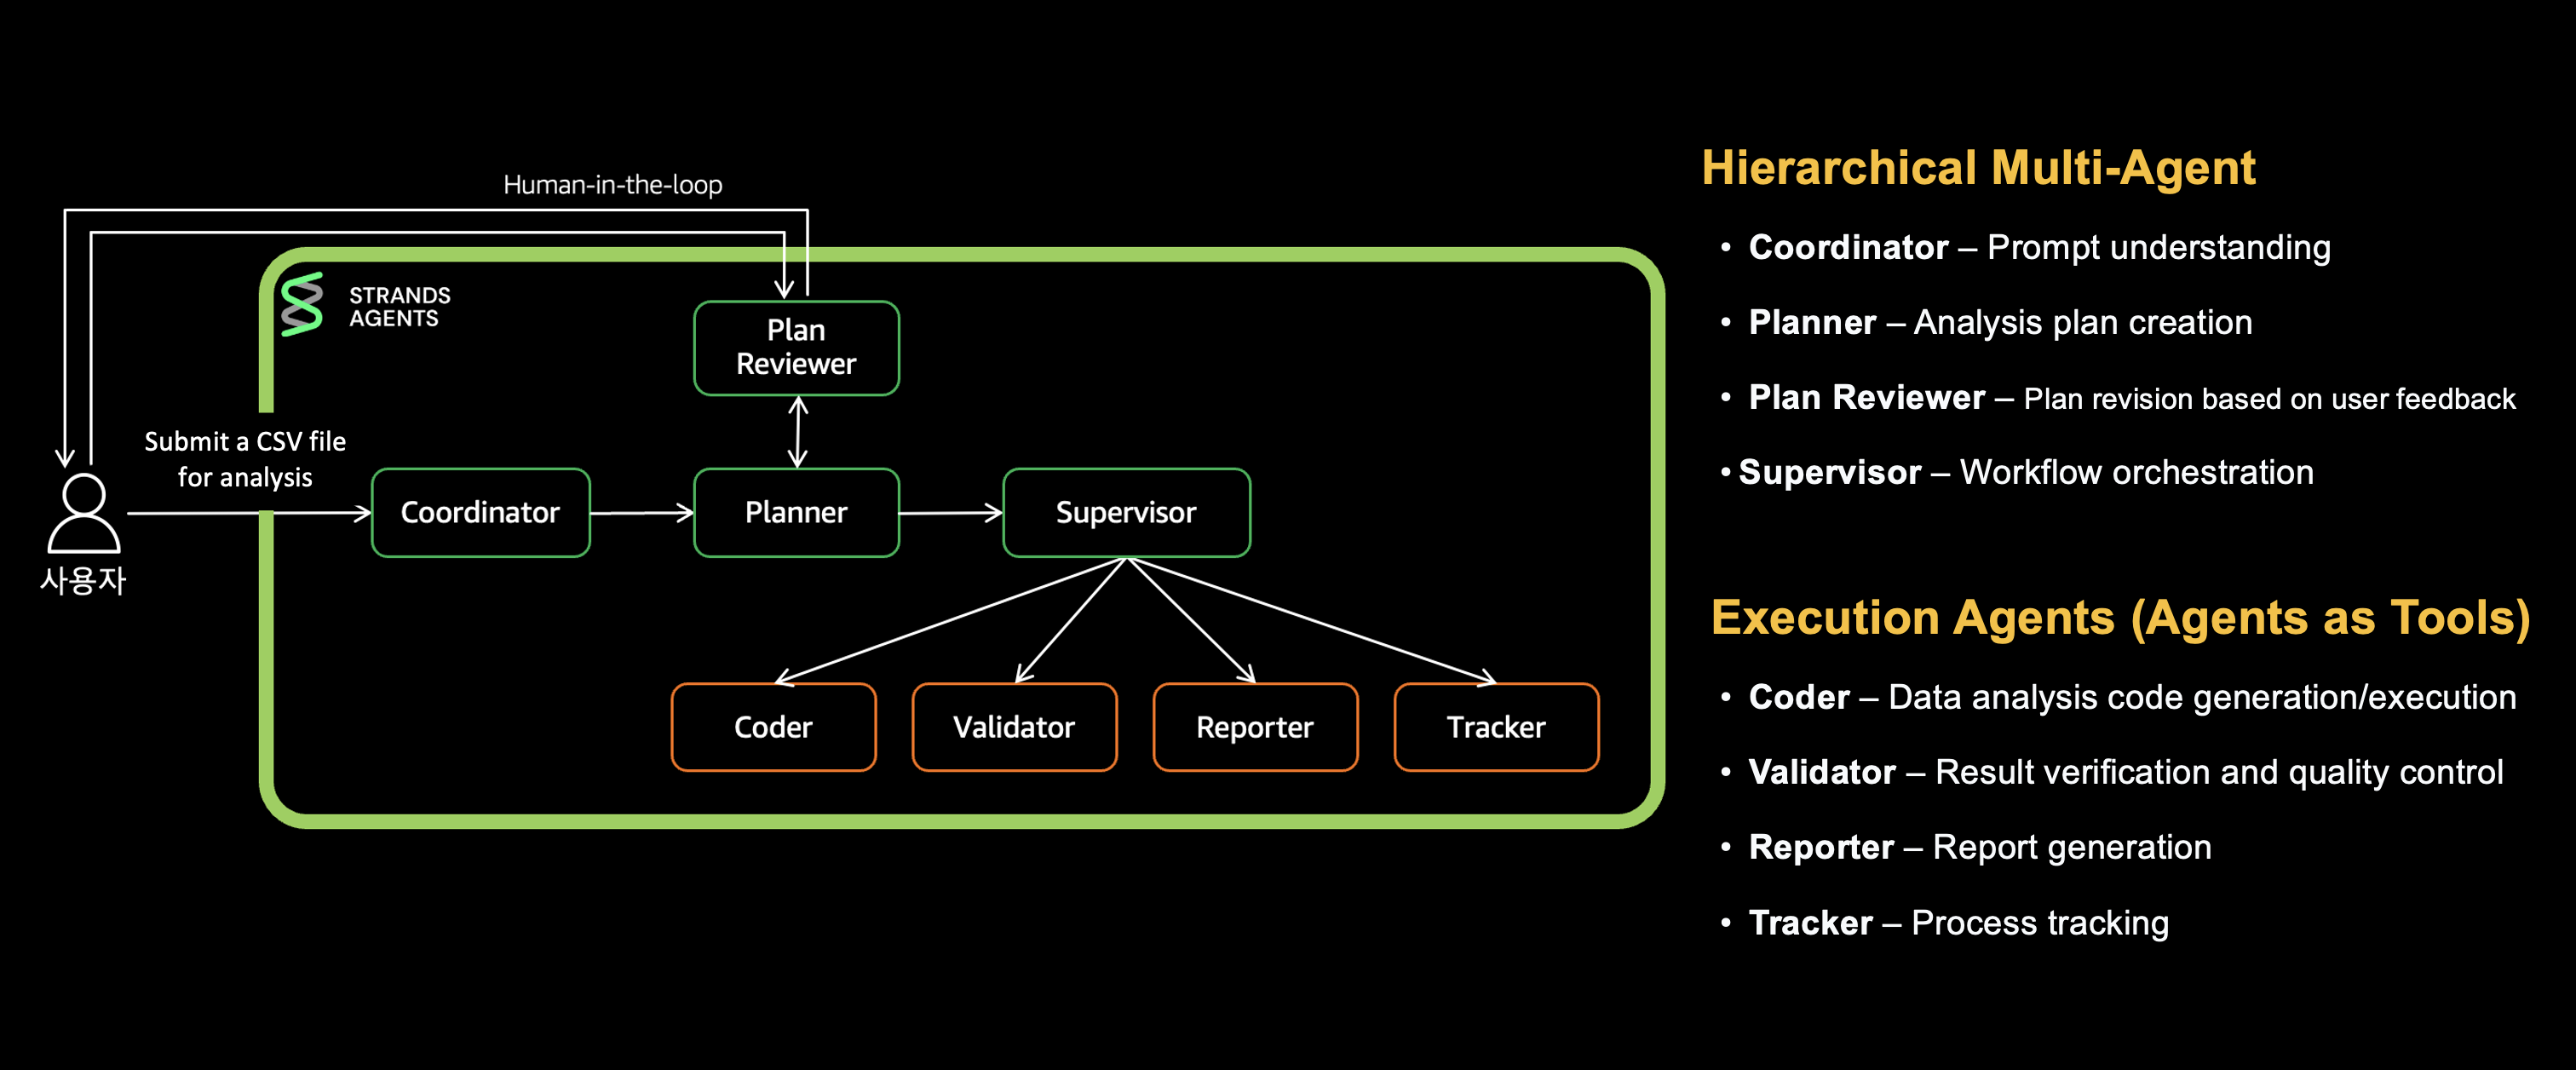
圖 2:多代理架構
Coordinator 負責路由用戶請求,Planner 將任務拆分為個別步驟,Plan Reviewer 收集用戶意見,而 Supervisor 則根據計劃呼叫合適的專門代理。Coder 編寫及執行數據分析程式碼,Validator 核實計算結果,Reporter 產生最終報告,而 Tracker 則追蹤進度。我們會分三個層次説明:
- [第 1 層] Coordinator → Planner → Plan Reviewer:分析請求並制定執行計劃。
- [第 2 層] Supervisor:協調專門代理。
- [第 3 層] Coder、Validator、Reporter、Tracker:執行專門任務。
我們結合 Strands Agents SDK 中的兩種關鍵模式,控制這些代理之間的執行流程。首先,Graph 模式以有向圖定義代理的執行次序和流程。請求依次經過 Coordinator、Planner、Plan Reviewer,然後到達 Supervisor;如收到修改要求,則會透過條件分支返回 Planner。根據條件決定下一步,令 HITL 和錯誤處理等複雜工作流程更易處理。其次,Agents-as-Tools 模式讓 Supervisor 只在需要時,才把專門代理(Coder、Validator、Reporter、Tracker)當作工具呼叫。每個代理都在獨立上下文中工作,並只傳回結果,從而減少上下文用量,同時保留領域專業知識。
本節會展示此架構如何解決路由、規劃及協調問題。
[第 1 層] Coordinator → Planner → Plan Reviewer
此層會將用戶請求轉化為獲批准的執行計劃。
1.1 Coordinator(路由):並非每項請求都需要高成本的協調流程
Coordinator 是用戶請求的入口。它會直接處理基本問候,並透過 handoff_to_planner 標記,將數據分析等複雜任務交給 Planner。
關鍵的設計決定在於模型選擇:由於 Coordinator 只負責分類,因此會使用輕量級模型 Claude Haiku,避免在處理基本問候時承擔 Opus 級別的成本,同時提供快速回應。
# builder.py: conditional edges for routing decisions
builder.set_entry_point("coordinator")
builder.add_edge("coordinator", "planner", condition=should_handoff_to_planner)
路由條件由 Coordinator 的提示詞決定:任何需要使用工具、推理或多步思考的請求,都會交由 Planner 處理。
1.2 Planner(制定計劃):複雜分析需要先拆解,再開始執行
在 Deep Insight 的多智能體架構中,Planner agent 負責將任務分派給各個智能體,擔當關鍵角色。在實質工作開始前,它會把大型任務拆分成較小的步驟,再由各個專門智能體逐一執行,讓每個智能體只需處理較少的上下文。
Planner 會使用啟用了 Extended Thinking 的 Claude Opus 模型制定分析計劃,並將計劃整理成 [ ] 清單格式,列明分派給各個智能體的具體任務,並儲存在 full_plan 變數中。它會把請求拆分成 5–10 個清晰步驟,如以下例子所示:
## title
Yummy Food Consumer Purchase Patterns and Advertising Effectiveness Analysis Report

## steps

### 1. Coder: Comprehensive Data Analysis and Insight Generation
- [ ] Load all data files from './data/*' path and understand structure
- [ ] Analyze consumer purchase history (patterns, preferences, customer segments)
- [ ] Analyze advertising data by channel (cost, effectiveness, channel comparison)
- [ ] Category-level analysis (fresh food, convenience food, health food ad effectiveness)
- [ ] Calculate key business metrics (conversion rate, CPA, ROAS, etc.)
- [ ] Generate visualizations (5+ charts, consumer segment charts)
- [ ] Derive strategic marketing insights
- [ ] Generate calculation metadata (for validation)

### 2. Validator: Calculation Verification and Citation Metadata Generation
- [ ] Identify verification targets and extract filter calculations
- [ ] Load data files directly and perform recalculations
- [ ] Verify accuracy of per-channel performance metrics
- [ ] Validate data consistency of visuals and graphs
- [ ] Generate citation metadata (reference numbers for verified items)

### 3. Reporter: Marketing Analysis Report Generation
- [ ] Write report overview
- [ ] Create structured report using verified analysis results
- [ ] Insert visualizations and analysis sections
- [ ] Present marketing strategy recommendations and improvement proposals
- [ ] Generate professional marketing report in DOCX format
1.3 Plan Reviewer
Plan Reviewer 是一個 HITL 節點,會向用戶展示計劃,並收集批准或修改意見。如收到意見,它會返回 Planner 修改計劃;如獲批准,便會把任務交給 Supervisor。系統會設定最多修改次數(MAX_PLAN_REVISIONS),以防止無限循環。
# builder.py: Plan Reviewer's bidirectional conditional edges
builder.add_edge("plan_reviewer", "planner", condition=should_revise_plan)
builder.add_edge("plan_reviewer", "supervisor", condition=should_proceed_to_supervisor)
builder.set_max_node_executions(25)
在網頁版中,Plan Reviewer 會顯示瀏覽器彈出視窗,讓用戶閲讀計劃並批准計劃或輸入修改意見。如未收到回應,300 秒倒數結束後便會自動批准計劃。
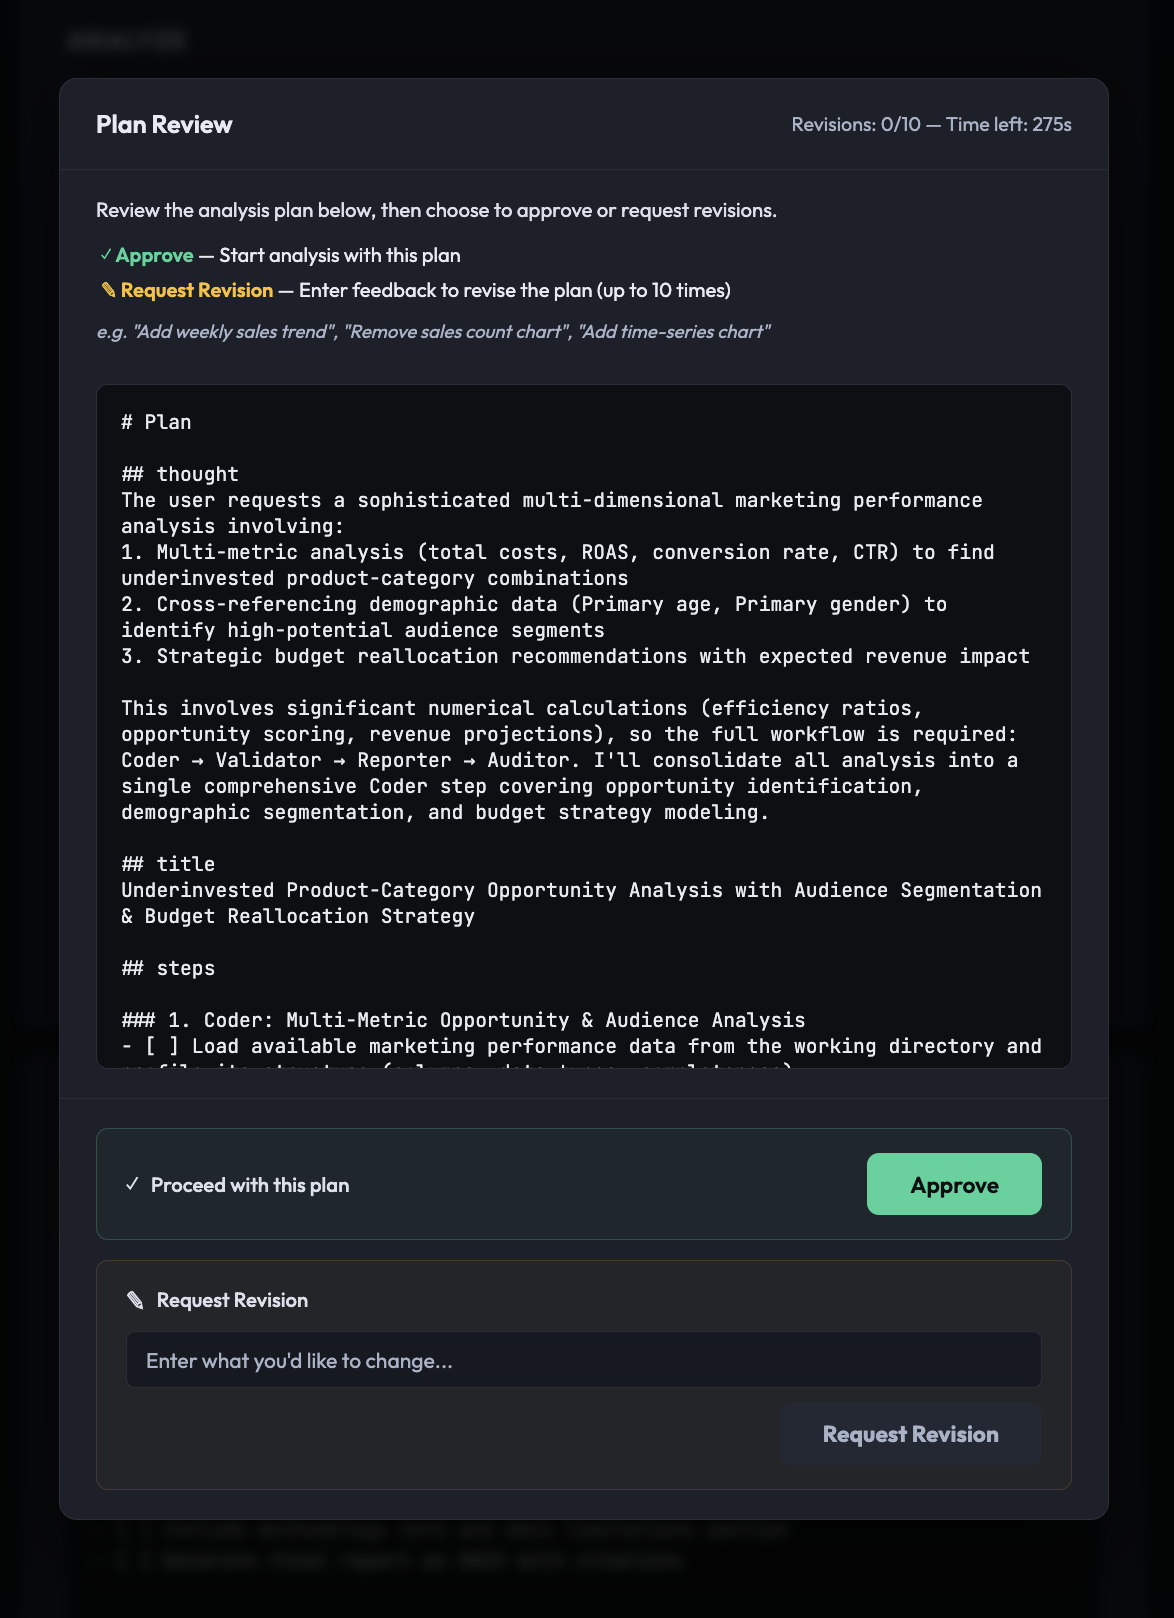
圖 3:Plan Reviewer agent 在網頁介面中的執行過程
若沒有規劃,智能體便會在執行時自行決定所有事項;中途修正會令先前的工作失效,而用戶亦無法瞭解進度。透過 Planner 和 Plan Reviewer,用戶可以審閲及修改計劃、即時監察進度,並只重新執行失敗的步驟。
[第 2 層] Supervisor(協調器):專門智能體需要一位指揮者
Supervisor 會依次執行 Planner 的 full_plan,並透過 Tool Use 呼叫已註冊為工具的第 3 層智能體(Coder、Validator、Reporter、Tracker)。
# nodes.py: registering sub-agents as tools on the Supervisor
agent = strands_utils.get_agent(
    agent_name="supervisor",
    system_prompts=apply_prompt_template(prompt_name="supervisor", prompt_context={}),
    model_id=os.getenv("SUPERVISOR_MODEL_ID", os.getenv("DEFAULT_MODEL_ID")),
    prompt_cache_info=(True, "default"),
    tool_cache=True,
    tools=[coder_agent_tool, reporter_agent_tool, tracker_agent_tool, validator_agent_tool],
    streaming=True,
)
Supervisor 的 system prompt 設定了嚴格的工作流程規則:
- 強制執行次序:Coder、Tracker、Validator、Tracker、Reporter、Tracker。每個智能體執行後,都會呼叫 Tracker 追蹤進度,讓 Supervisor 管理整體任務狀態。
- 完成區段規則:在目前智能體的所有清單項目都標記為 [x] 前,Supervisor 不會轉交給下一個智能體。
- 保留上下文:Supervisor 會將 clues 和 full_plan 變數傳給每個工具智能體,保留完整上下文並防止資訊遺失。
[第 3 層] Coder、Validator、Reporter、Tracker:分工提升品質
每個第 3 層智能體(Coder、Validator、Reporter、Tracker)都會封裝為 PythonAgentTool,並接收來自 Supervisor 的 Tool Use 呼叫。在 Strands SDK 中,每個智能體都是獨立的 Agent() 實例,並有自己的 system prompt、model ID 和工具集。
| 智能體 | 角色 | 工具 | 主要輸出 |
| Coder | 數據分析、圖表生成、洞察推導 | write_and_execute_tool, bash_tool, file_read, skill_tool | *.png 圖表、calculation_metadata.json |
| Validator | 數值計算覆核、引文生成 | write_and_execute_tool, bash_tool, file_read | citations.json、validation_report.txt |
| Reporter | DOCX 報告生成 | write_and_execute_tool, bash_tool, file_read | final_report.docx、final_report_with_citations.docx |
| Tracker | 清單進度狀態更新 | 無(僅限 LLM 推理) | 已更新的 full_plan |
Supervisor 會按照 Planner 的清單,依以下次序呼叫 Tool Use:
- Coder – 載入數據、編寫並執行分析程式碼、產生 PNG 圖表、將結果累積至 all_results.txt,並留下
calculation_metadata.json供核實。 - Tracker(第一次)– 將已完成的清單項目由 [ ] 更新為 [x],讓 Supervisor 據此決定是否繼續。
- 驗證器-根據來源數據重新執行
calculation_metadata.json中的每項計算。誤差在 0.01 以內即為通過,否則會被標記。已驗證的計算結果會送至citations.json,供報告器引用。 - 追蹤器(第 2 輪)-在核對清單中反映驗證器的完成狀態。
- 報告器-讀取 all_results.txt 和
citations.json,產生兩個版本的最終 DOCX 報告,分別附有和不附有引用。 - 追蹤器(第 3 輪)-反映所有任務的最終完成狀態。
每個 Agent 完成後,追蹤器都會執行,讓監督器追蹤進度並確保遵守完成規則(所有項目都標記為 [x] 前,不得繼續)。由於它只透過 LLM 推理更新核對清單,不使用工具,因此額外開銷很低。
各 Agent 的 LLM 模型配置
Deep Insight 會按照各 Agent 的職責調整模型和設定。這不是模型選擇,而是為了優化成本和品質而作出的架構決策。
| Agent | 模型 | 延伸思考 | 提示詞快取 | 職責 |
| 協調器 | Haiku | 停用 | 否 | 快速路由:將成本降至最低 |
| 規劃器 | Opus | 啟用(約 8,192 tokens) | 否 | 深入思考:提供高品質規劃 |
| 監督器 | Sonnet | 停用 | 是 | 執行流程編排:透過快取節省成本 |
| 程式碼編寫器 | Sonnet | 停用 | 是 | 程式碼生成/執行:快取對重複呼叫成效顯著 |
| 驗證器 | Sonnet | 停用 | 否 | 數值驗證:每次數據都不同,無需快取 |
| 報告器 | Sonnet | 停用 | 是 | 報告生成:快取對長提示詞成效顯著 |
| 追蹤器 | Sonnet | 停用 | 否 | 狀態更新:輕量工作,無需快取 |
監督器、程式碼編寫器和報告器 Agent 使用提示詞快取,快取其系統提示詞和工具定義,令重複呼叫的輸入 token 成本最多降低 90%。協調器只會執行一次,而驗證器和追蹤器每次執行時的上下文都不同,因此快取對它們沒有成效,會維持停用。這種選擇性快取策略,是有意作出的成本與效能取捨。
解決方案詳情 2:正式環境部署與營運
如果解決方案詳情 1 説明瞭系統的功能,本節則會説明系統如何在甚麼環境中安全運作。從這裏開始,內容都會涵蓋正式環境營運所需的基礎設施決策。具體而言,本節會介紹 LLM 生成程式碼的安全執行環境,以及團隊掌握營運狀況的方式。
1. 程式碼執行:LLM 生成的程式碼需要安全的執行環境
Coder 代理會編寫及執行 Python,以進行數據分析。在自行託管版本中,程式會透過 subprocess.run() 在本機執行;但在正式環境(AgentCore)中,安全性和隔離至關重要。在正式伺服器上直接執行由 LLM 生成的程式碼存在風險:模型可能會刪除系統檔案、在無限迴圈中耗盡資源,或存取其他用戶的分析數據。Deep Insight 透過 AWS Fargate 和 ALB,為每個工作階段建立獨立的暫時容器來解決這個問題。這些元件並非各自隔離運行。如圖 1 所示,AgentCore runtime、ALB 和 Fargate 任務均在同一個私有 VPC 內運行。VPC 端點讓這些元件無須經過公用互聯網,便可連接至 Amazon Simple Storage Service (Amazon S3)、Amazon Bedrock 和 Amazon Elastic Container Registry (Amazon ECR)。安全羣組會限制哪些元件可以連接至 Code Interpreter 容器。AWS Identity and Access Management (IAM) 角色會限制各元件只能存取所需的 AWS 資源。Amazon CloudWatch 會收集容器記錄檔,以及來自 AgentCore Observability 的可觀測性數據;AgentCore Observability 是 Amazon Bedrock AgentCore 的一項功能。
- 自訂容器 Docker 映像:為多代理系統預先最佳化的沙盒,內含字型、系統程式庫和 Python 套件。
- 容器隔離:每個分析工作階段都會在私有 VPC 子網絡中使用獨立的 Fargate 容器,無法直接存取互聯網。
- 2 步執行:LLM 生成的程式碼會經 base64 編碼,透過 HTTP 傳送並寫入檔案(步驟 1),然後透過 subprocess 執行(步驟 2)。
- 工作階段黏性:即使代理多次執行程式碼,ALB 黏性工作階段 Cookie 也會將代理路由回同一個容器。
- 產物管理:分析完成後,圖表、報告和記錄檔會上載至 Amazon S3。容器會在一小時後自動終止。
容器隔離可以保護基礎設施,但無法管控代理生成的內容。Validator 代理會重新核實計算結果,但無法偵測上載數據中隱藏的提示注入指令,也不會篩查 LLM 生成的文字是否包含有害或缺乏根據的內容。對於正式環境部署,我們建議加入 Amazon Bedrock Guardrails 作為負責任 AI 控制措施:對用戶提示詞及上載數據套用內容篩選和提示攻擊偵測,並對代理輸出進行情境根據檢查,確保報告文字以來源數據和經核實的計算結果為根據。
2. 運作與監察:團隊需要掌握系統狀況
只靠程式碼並不足以構成完整的正式環境系統。團隊必須評估系統健康狀況、診斷問題及檢視結果,因此 Deep Insight 提供 Web UI 和 Ops 儀錶板。
Web UI (deep-insight-web)
這是一個以 FastAPI 為基礎的網頁介面,透過 AgentCore Native Protocol (boto3.invoke_agent_runtime()) 與後端通訊。用戶可以上載數據並輸入提示詞,然後透過 Server-Sent Events (SSE) 串流監察進度。計劃生成後,彈出視窗會讓用戶批准計劃或提供修改意見(HITL)。完成後,用戶可以直接下載報告。介面支援韓文和英文。
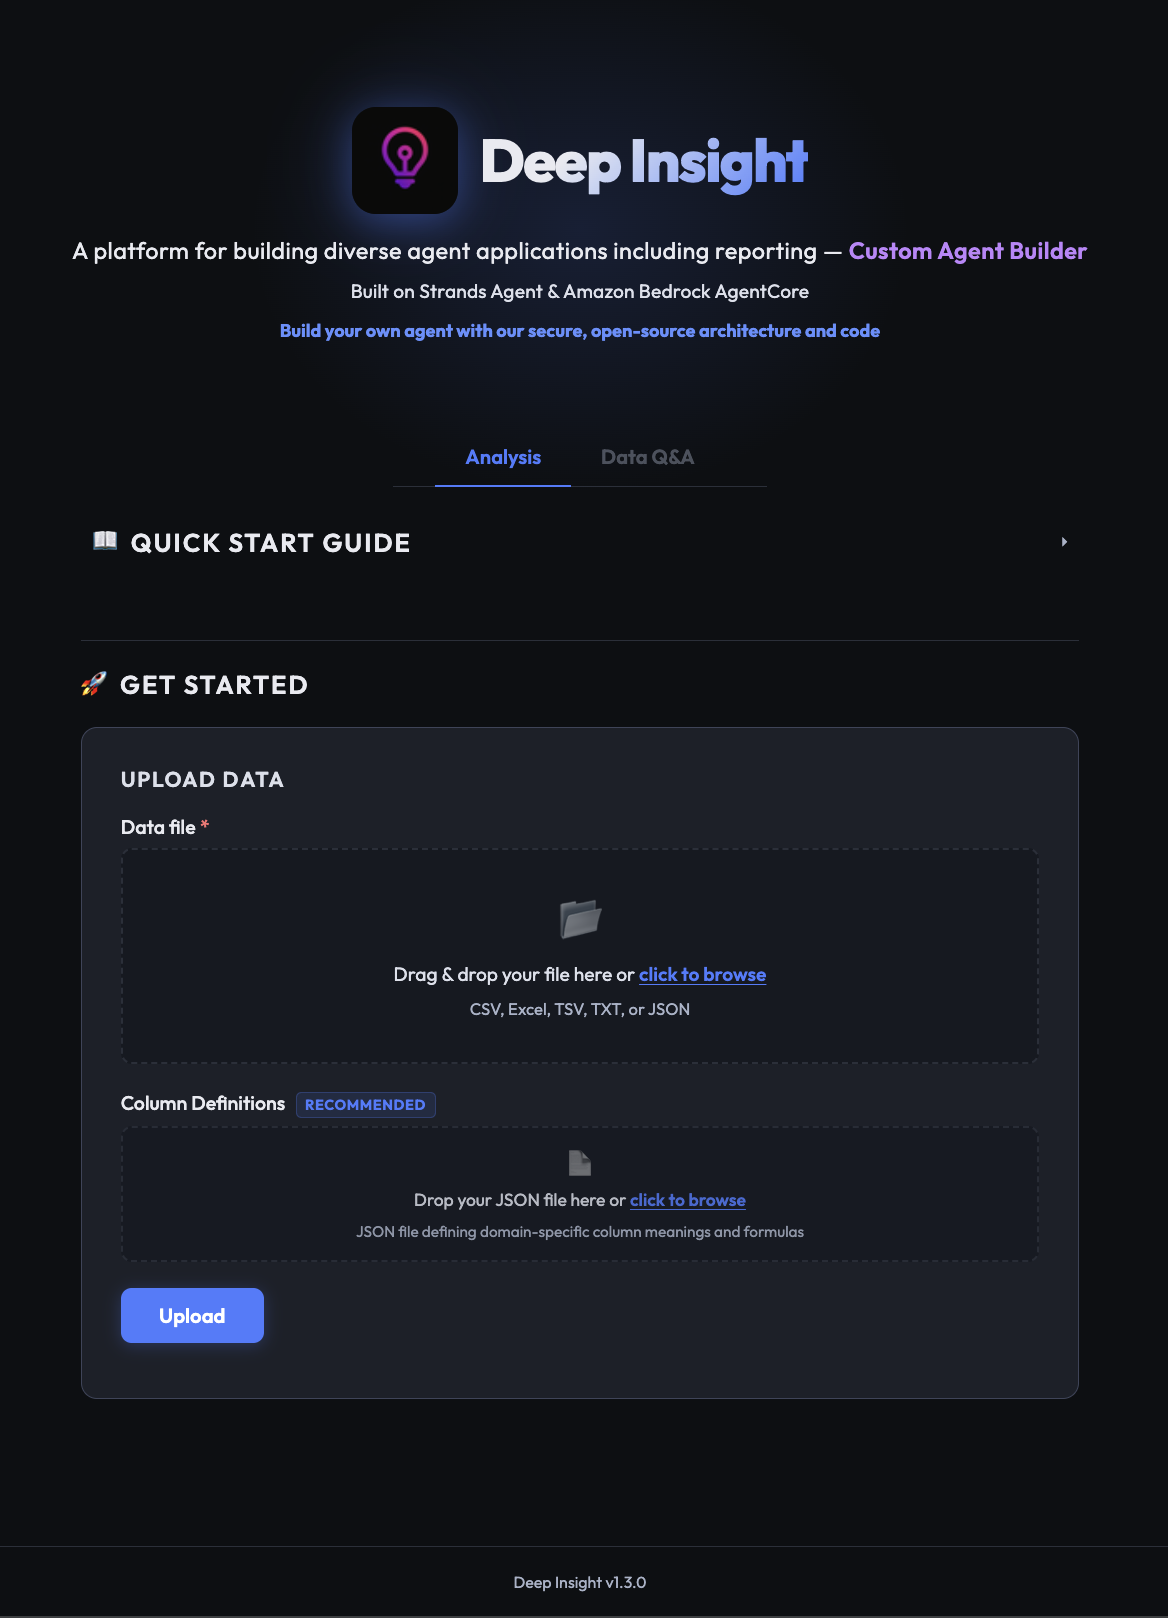
圖 4:Deep Insight 網頁版截圖
Ops 儀錶板 (deep-insight-web/ops)
Ops 儀錶板屬於選用功能。即使沒有這項功能,Deep Insight 仍可正常運作;但對有需要的團隊而言,儀錶板還提供以下功能:
- 任務追蹤:所有分析任務指標,包括狀態、token 用量和經過時間,均會記錄在 Amazon DynamoDB。
- 失敗通知:分析失敗時,系統會透過 Amazon SNS 即時向管理員發送電郵。
- 管理員專用儀錶板透過 Amazon Cognito 的 JSON Web Token (JWT) 驗證機制加以保護,確保任務監察安全。
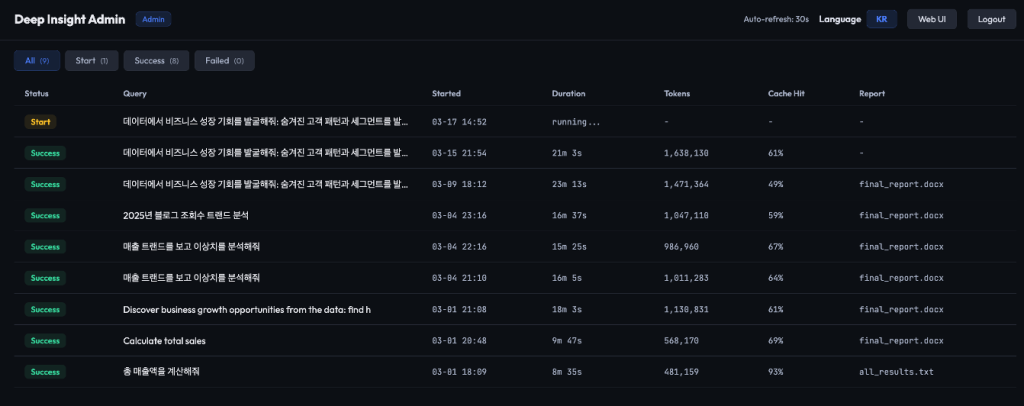
圖 5:Deep Insight Ops 儀錶板畫面截圖
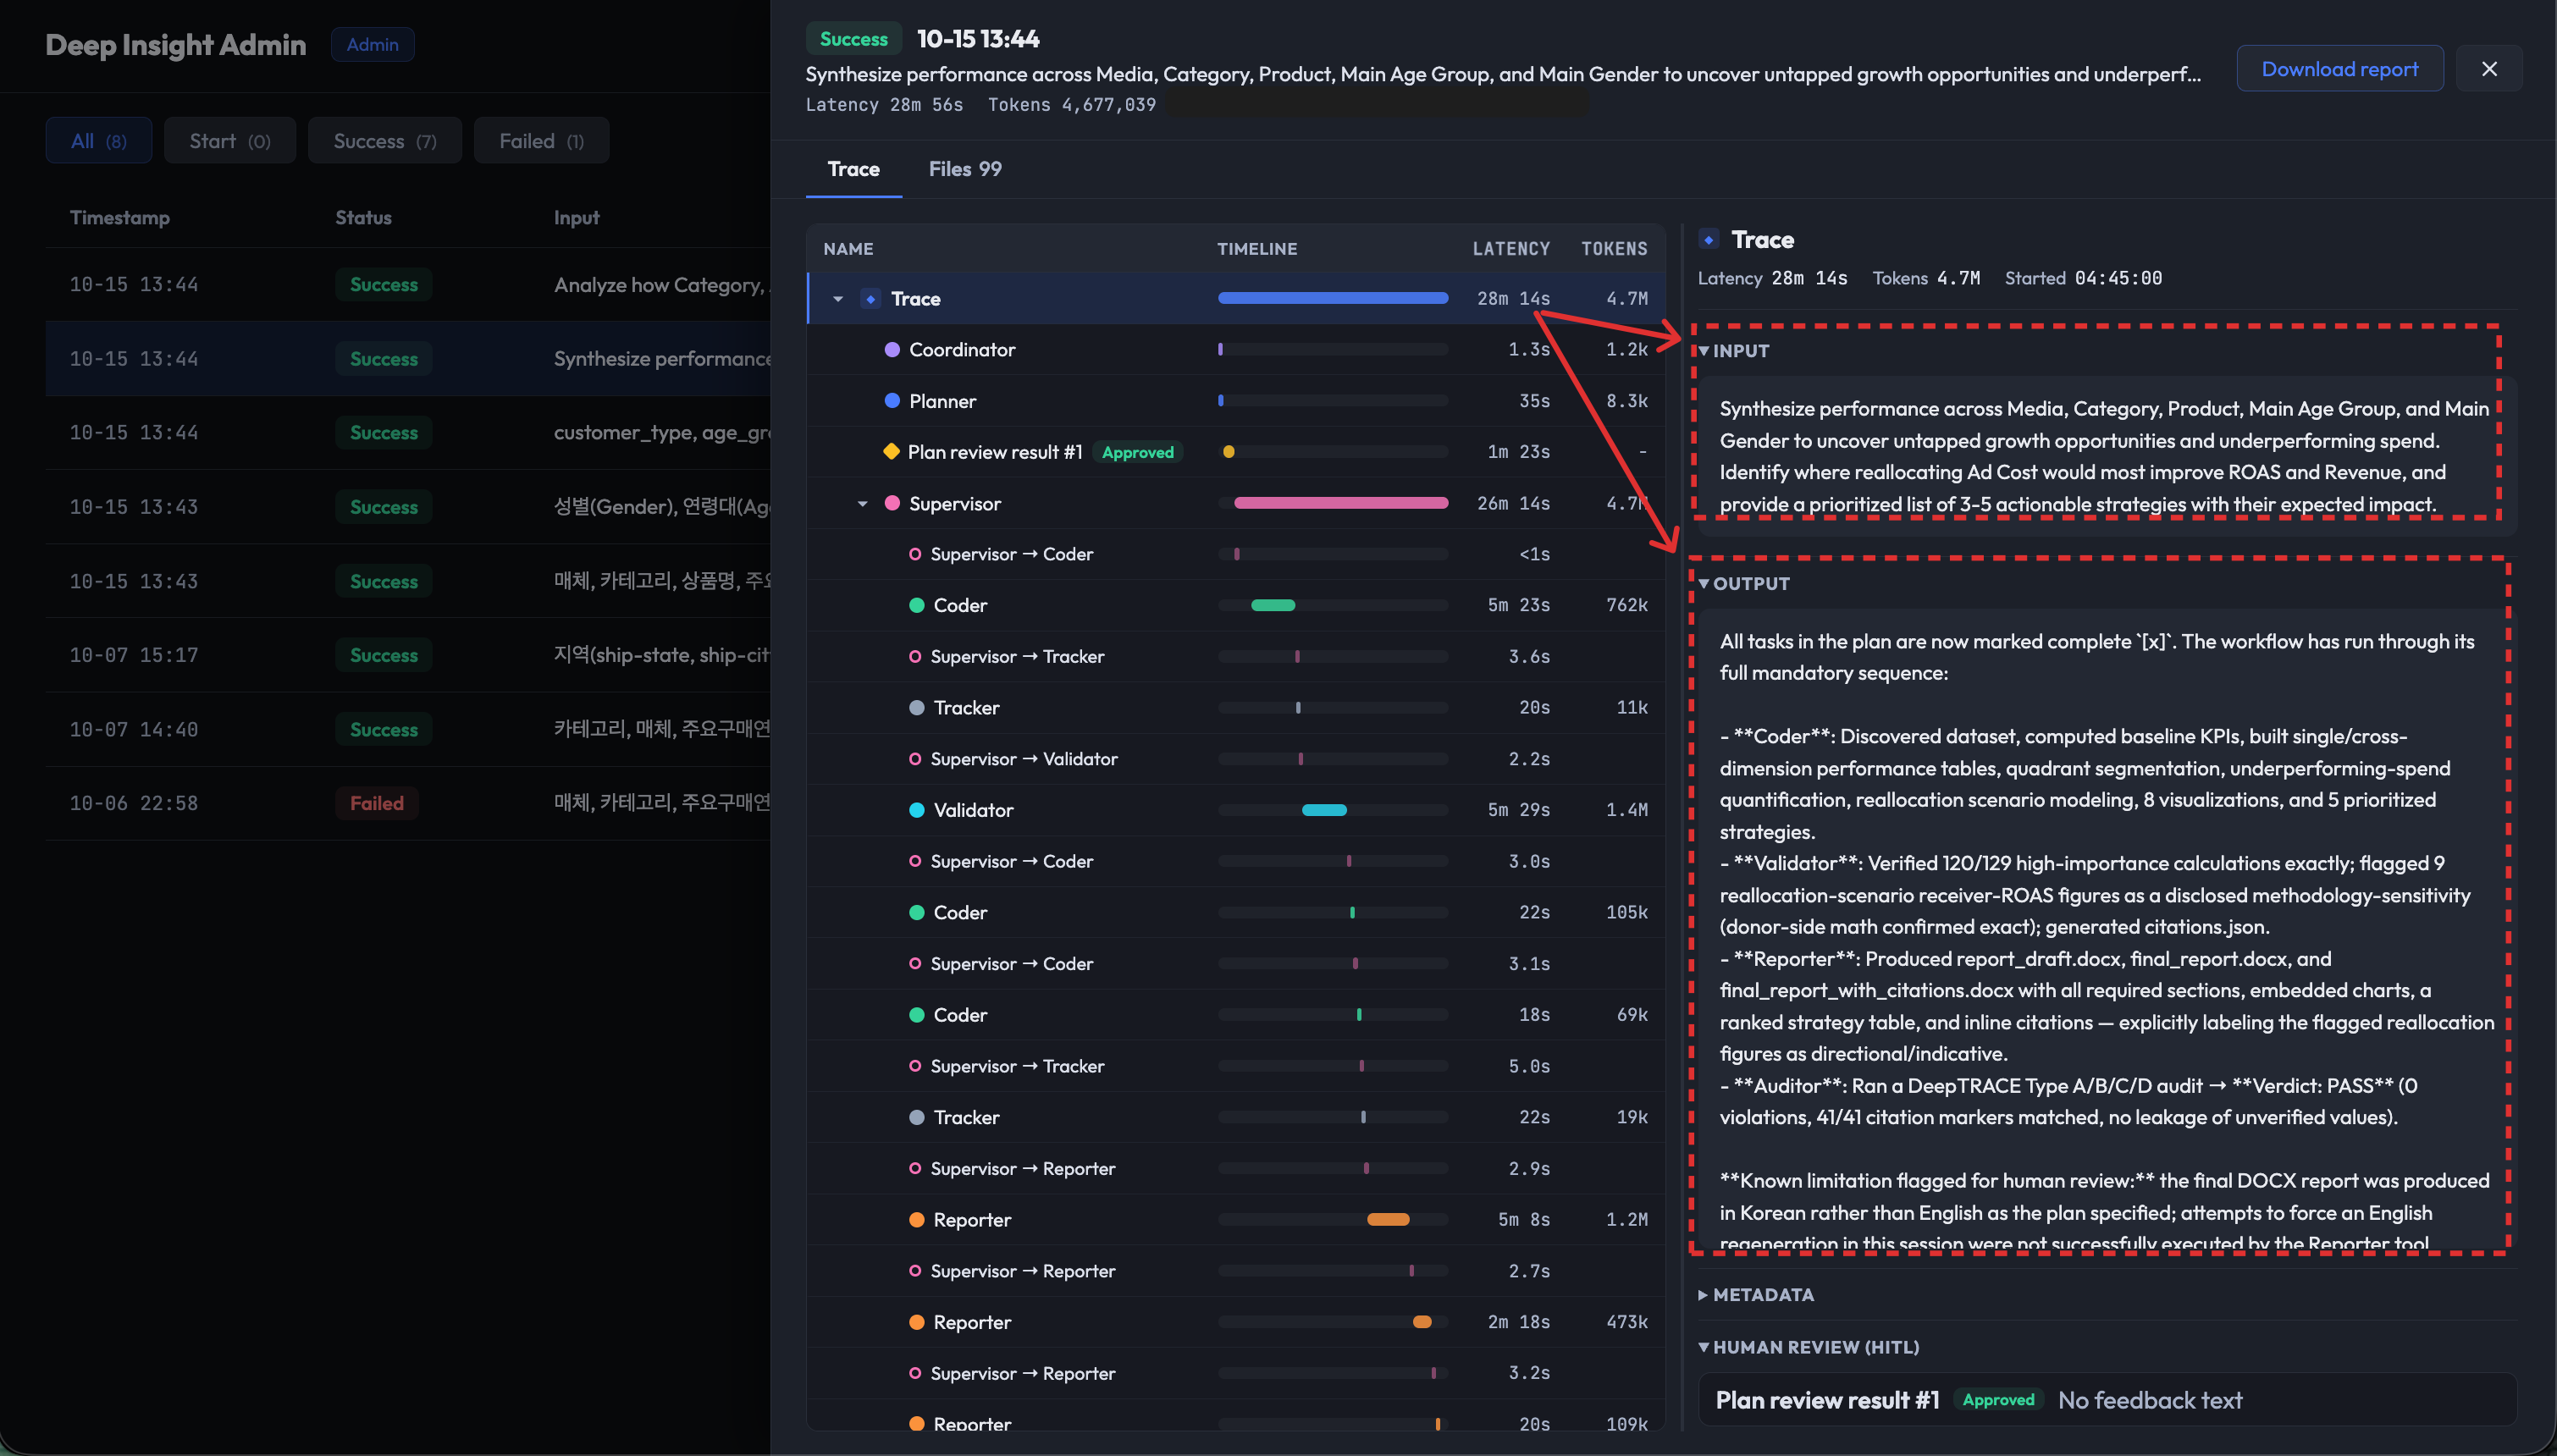
圖 6:Deep Insight Ops 儀錶板詳細檢視畫面
延伸 Deep Insight 架構
Deep Insight 的多代理架構不限於數據分析報告生成這個單一領域。以下兩個例子展示,階層式編排的設計原則在截然不同的領域同樣有效。
個案 1:LG Electronics:Agentic AI 驅動的市場營銷洞察擷取系統
LG Electronics 韓國銷售部門以與 Deep Insight 相同的多代理架構建構 ChatInsight。當時,數據分析需求往往需時 2–3 週,而且市場營銷人員與數據科學家之間容易出現需求意圖流失。協調者按複雜程度分流,規劃器追蹤任務,監督者則編排編碼器和報告撰寫器;代理之間的狀態會透過 all_results.txt 檔案累積傳遞。原本需時 3 天的分析,現在只需 30 分鐘,生產力提升 288x。不懂 SQL 的市場營銷人員也可讓代理探索數據並提出策略(請參閲 AWS Tech Blog 上的 LG Electronics Agentic AI 洞察擷取系統)。
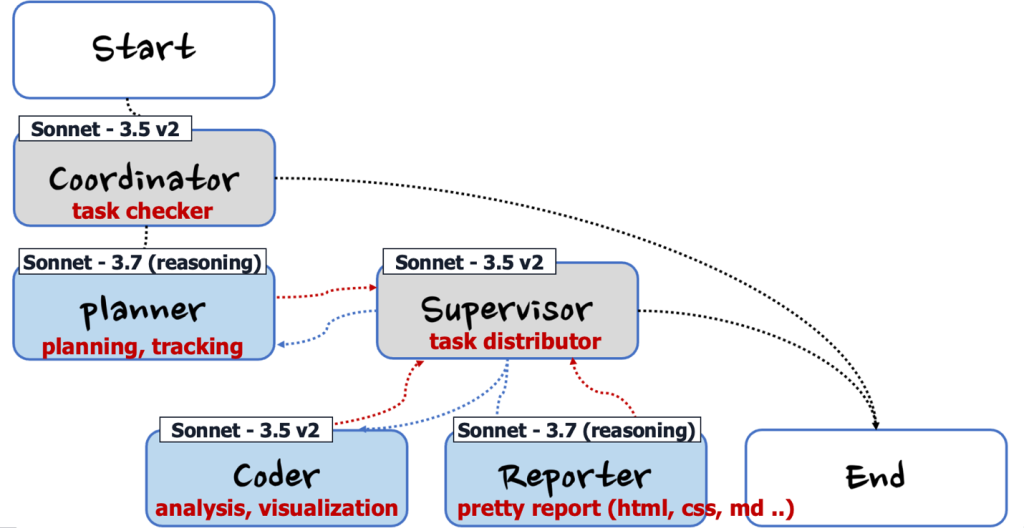
圖 7:LG Electronics Agentic AI 市場營銷洞察系統架構
個案 2:TechRecon:AI 驅動的科技偵察代理(re:Invent 2025)
TechRecon 在 AWS re:Invent 2025(場次 SNR203)發表,將 Deep Insight 的架構應用於科技策略。輸入一間公司及其所屬行業後,研究員會收集科技趨勢,編碼器負責分析,驗證器負責核實,報告撰寫器則產出技術版圖分析和技術立場文件。這套架構與 Deep Insight 幾乎相同,採用 Strands Agents SDK 的 Graph 模式,以及 Extended Thinking 和 Prompt Caching;研究員取代編碼器,成為主要執行代理。這展示了該設計是一種通用模式:只要替換代理的角色和提示詞,同一套編排架構便能解決截然不同的問題。
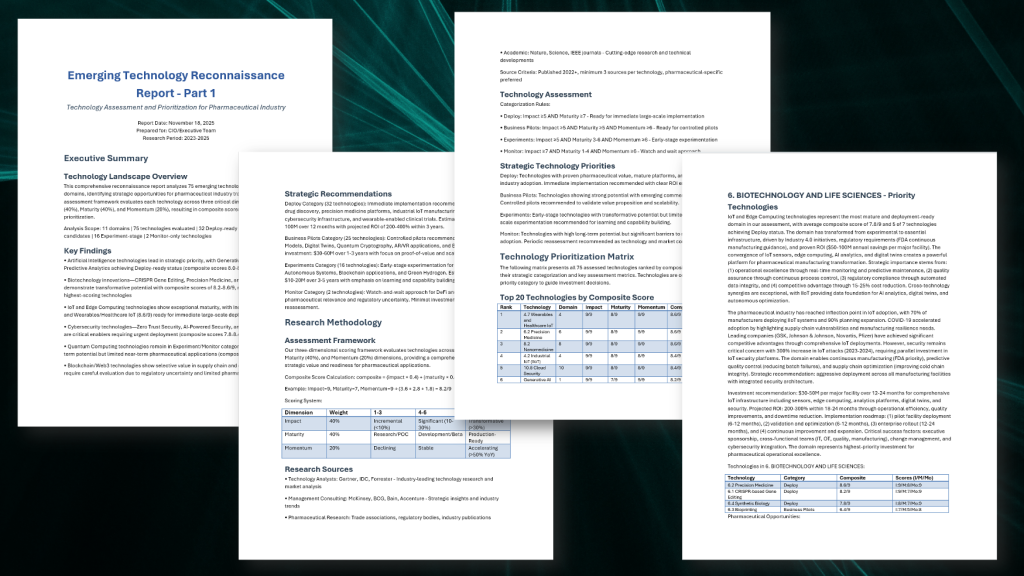
圖 8:TechRecon 的結果
(瞭解更多:TechRecon GitHub | AWS re:Invent 場次影片)
結論
要建立能在正式環境中運作的代理,關鍵不在模型能力,而在架構。Deep Insight 提供了一套經驗證的方案:
- 工作流程管理:Strands Agents SDK 的 Graph 模式可定義代理之間的執行次序,並實作人在迴圈中(HITL)分支;Agents-as-Tools 模式則讓監督者只在需要時呼叫專用代理。
- 推理引擎:我們按角色分配 Amazon Bedrock 上的 Claude 模型(先 Haiku,再 Opus,然後 Sonnet),以平衡成本和品質。
- 部署:Amazon Bedrock AgentCore 提供受管理的執行環境,具備工作階段隔離、私有 VPC 部署及 OpenTelemetry 可觀測性。
- 程式碼執行:Application Load Balancer 配合 Fargate 上的 Amazon Elastic Container Service (Amazon ECS),在每個工作階段專用的臨時沙盒容器中隔離大型語言模型(LLM)生成的程式碼執行,避免系統檔案存取、資源耗盡及非預期的資料披露等安全問題。
- 運作:Web UI 的 SSE 串流,以及 Ops 儀錶板(DynamoDB + Cognito + SNS),讓整個團隊掌握各項情況。
LG Electronics 的市場營銷洞察系統,以及在 re:Invent 2025 發表的 TechRecon 個案,驗證了這些設計原則。
在第 2 部分,我們會探討四個層面的上下文工程技術,説明如何在此架構之上克服上下文視窗限制,涵蓋由架構層級隔離、提示詞設計、工具最佳化,以至驗證保障措施,並將我們的方法與 Anthropic 的工程研究作比較。
Deep Insight 是開源的。探索程式碼,並按你的領域需要擴展。
作者簡介

Yoonseo Kim
Yoonseo 是一名解決方案架構師,協助客戶運用 AWS 技術解決業務挑戰。她對 AI/ML 深感興趣,專注於協助客戶設計及最佳化 Agentic AI 工作負載,以及相關的支援基礎架構和評估環境。

Jesam Kim
Jesam 是一名解決方案架構師,協助企業客戶採用雲端技術並解決業務挑戰。他專注於 AI/ML,包括推薦系統和生成式 AI,協助客戶設計符合業務需求的架構。

Jiyun Park
Jiyun 是一名解決方案架構師,協助軟件及互聯網行業的客戶將工作負載遷移至雲端。她與客戶合作設計雲端方案,助他們達成業務目標。

Kyutae Park
Kyutae, Ph.D. 是一名 AI 專業解決方案架構師,憑藉在機器學習、MLOps 和 Agentic AI 方面的豐富經驗,協助各行各業的客戶設計及建構應用型 AI 工作負載。他專注於透過 Agentic AI 推動智能自動化和營運創新,將自主決策和多智能體協作架構引入實際業務環境。透過這些工作,他協助客戶運用 AWS AI/ML 服務及應用生成式 AI,取得具體業務成果並建立可持續的競爭優勢。

Gonsoo Moon
Gonsoo 是 AWS 的 AI/ML 專業解決方案架構師。憑藉在各類 AI/ML 使用案例及正式環境部署方面的經驗,他與客戶緊密合作,解決他們的 AI/ML 挑戰。他亦與數據科學家、開發人員及分析師分享 AI/ML 知識,致力為韓國及世界各地帶來正面改變。

Chloe Kwak
Chloe 是 Amazon Web Services 韓國零售團隊的高級解決方案架構師。她協助韓國的零售及電子商務客戶設計可擴展且具成本效益的雲端架構,並採用 AI/ML 服務,加快實現業務成果。
來源:AWS Machine Learning Blog · aws.amazon.com