StackLLaMA:以 RLHF 訓練 LLaMA 的實作指南
StackLLaMA: A hands-on guide to train LLaMA with RLHF
Hugging Face 發佈 StackLLaMA,這是一個以 LLaMA 7B 為基礎、經 RLHF 微調、用於回答 Stack Exchange 問題的模型;完整訓練流程納入 Hugging Face TRL library。文章逐步示範監督式微調、獎勵模型訓練及 PPO 強化學習,並介紹 Stack Exchange 數據的偏好評分與 LoRA 等記憶體效率方法。
文章串聯 SFT、偏好獎勵模型與 PPO 三階段,並示範以 8-bit 載入和 LoRA 降低 RLHF 微調的記憶體需求,呈現可復用的訓練流程。
ChatGPT、GPT-4 和 Claude 等模型都是強大的語言模型,經過一種稱為人類回饋強化學習(RLHF)的方法微調,使模型更符合我們期望的行為,也更貼合我們希望使用它們的方式。
這篇網誌會展示透過以下組合,訓練一個 LLaMA 模型,讓它能使用 RLHF 回答 Stack Exchange 上問題的完整步驟:
- 監督式微調(SFT)
- 獎勵/偏好建模(RM)
- 人類回饋強化學習(RLHF)
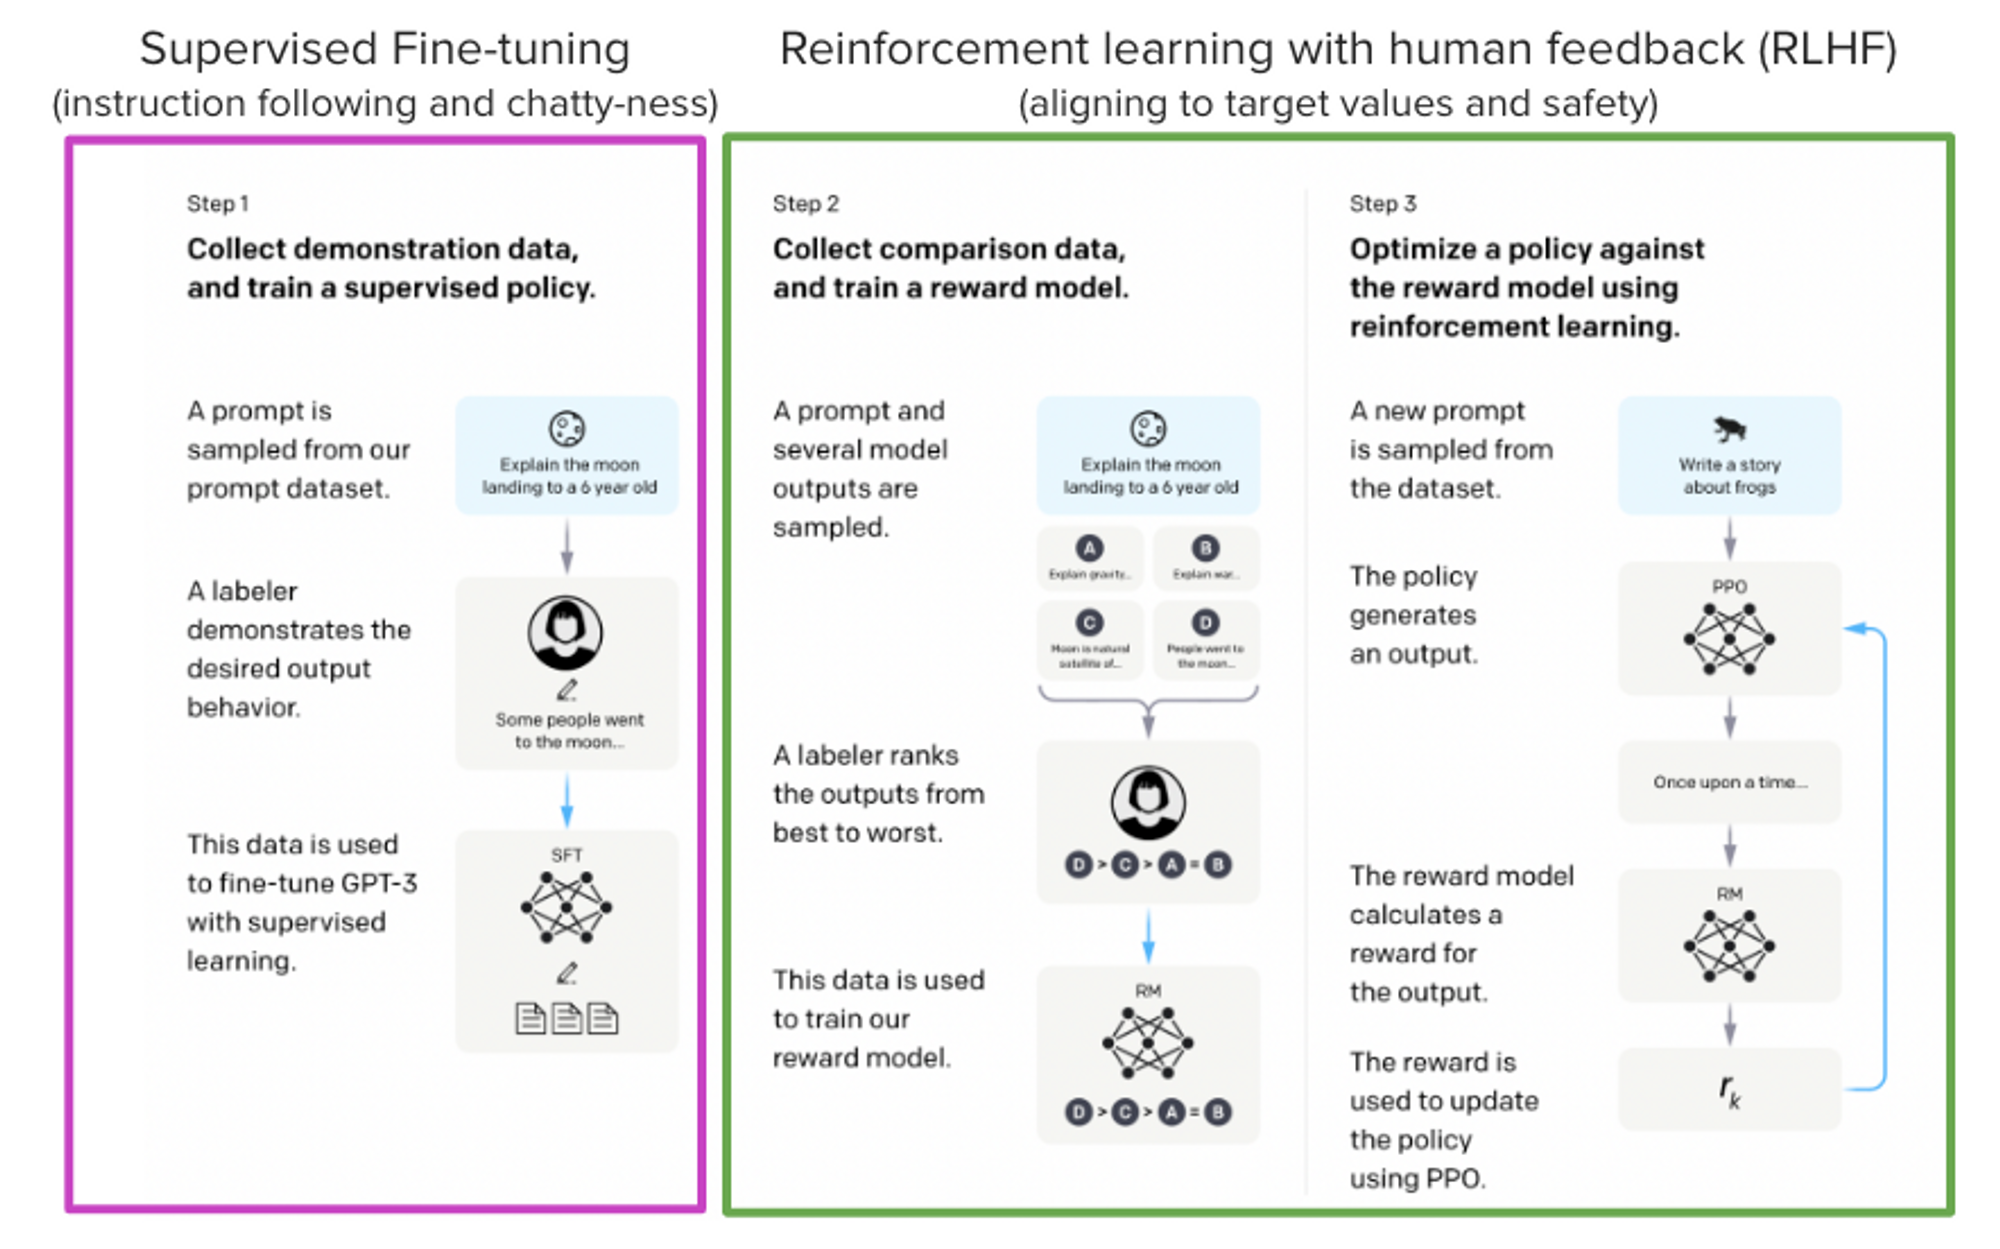 摘自 InstructGPT 論文:Ouyang、Long 等人,〈以人類回饋訓練語言模型遵循指令〉,arXiv 預印本 arXiv:2203.02155(2022)。
結合這些方法後,我們推出了 StackLLaMA 模型。你可在 🤗 Hub 上找到此模型(原始 LLaMA 模型請參閲 Meta 的 LLaMA 發佈文章),而整套訓練流程已納入 Hugging Face TRL 函式庫。想初步瞭解模型的能力,不妨試試下方示範!
LLaMA 模型
進行 RLHF 時,起點必須是一個能力不錯的模型:RLHF 步驟只是微調,用來讓模型的互動方式和回應符合我們的期望。因此,我們選用最近推出、效能出色的 LLaMA 模型。LLaMA 是 Meta AI 最新開發的大型語言模型,規模介乎 7B 至 65B 參數,訓練資料介乎 1T 至 1.4T tokens,能力相當強。我們會以 7B 模型作為以下所有步驟的基礎! 如要取得模型,請填寫 Meta AI 提供的表格。
Stack Exchange 資料集
收集人類回饋既複雜又昂貴。為了在建立實用模型的同時,為本示例啟動整個流程,我們使用了 StackExchange 資料集。此資料集包括 StackExchange 平台上的問題及相應答案(涵蓋程式碼相關的 StackOverflow 及許多其他主題)。它很適合這個用途,因為答案附有獲得的讚數,以及標記哪個答案已獲提問者接受。
我們採用 Askell 等人(2021)描述的方法,為每個答案評分:
score = log2 (1 + upvotes) rounded to the nearest integer, plus 1 if the questioner accepted the answer (we assign a score of −1 if the number of upvotes is negative).
稍後會看到,訓練獎勵模型時,每個問題都需要兩個答案作比較。有些問題有數十個答案,因此可組成許多配對。我們每題最多抽取十組答案配對,以限制每題的資料點數量。最後,我們把 HTML 轉換為 Markdown,整理格式,令模型輸出更易閲讀。你可在此處找到資料集及其處理筆記本。
高效訓練策略
即使訓練最小型的 LLaMA 模型,也需要大量記憶體。簡單計算一下:bf16 中每個參數佔 2 bytes(fp32 中為 4 bytes),此外 Adam optimizer 等工具還會使用 8 bytes(詳情請參閲 Transformers 的效能文件)。因此,僅將 7B 參數模型放入記憶體就需要 (2+8)*7B=70GB,而計算 attention score 等中間值時,所需記憶體可能更多。這樣一來,即使使用單張 80GB A100,也無法訓練模型。你可以透過半精度訓練或效率更高的 optimizer 等技巧多擠出一點記憶體,但遲早仍會用盡。
另一個做法是採用參數高效微調(PEFT)技術,例如 peft 函式庫,讓模型以 8-bit 載入時也能進行低秩適應(LoRA)。
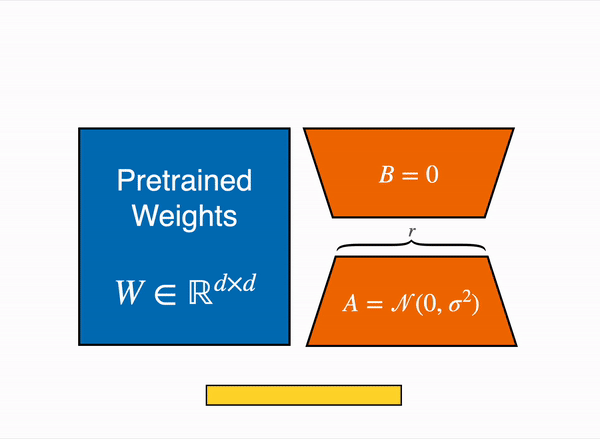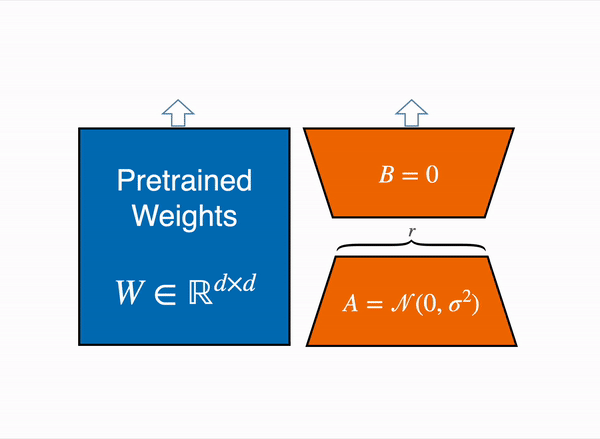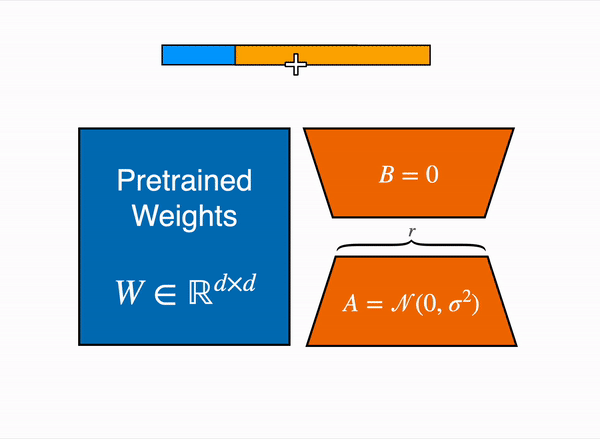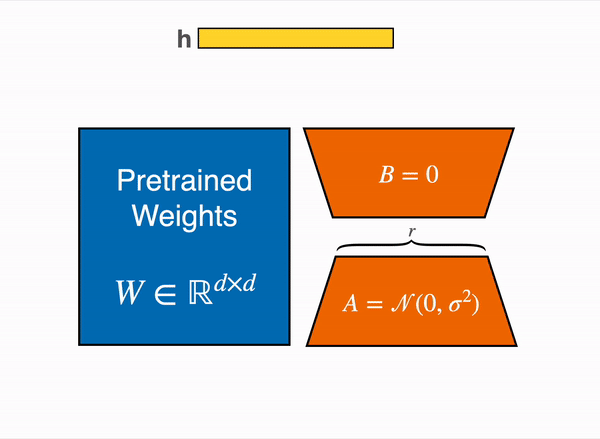
線性層的低秩適應:額外參數(橙色)加在凍結層(藍色)旁,並將編碼後的隱藏狀態與凍結層的隱藏狀態相加。
以 8-bit 載入模型可大幅減少記憶體用量,因為每個參數的權重只佔一個 byte(例如 7B LLaMA 在記憶體中佔 7GB)。LoRA 不會直接訓練原始權重,而是在某些指定層(通常是 attention layers)上加上小型 adapter layers,因此需要訓練的參數數量大幅減少。
在這種情況下,一個經驗法則是每十億個參數預留約 1.2–1.4GB(視乎 batch size 和 sequence length),以容納整套微調配置。如上方連結的網誌所述,這樣便能以低成本微調更大型模型(例如在 NVIDIA A100 80GB 上訓練最多約 50–60B 規模的模型)。
這些技術讓使用者能在個人裝置和 Google Colab 上微調大型模型。值得一提的示範包括在 Google Colab 微調 facebook/opt-6.7b(在 float16 中佔 13GB),以及 openai/whisper-large(使用 15GB GPU RAM)。想深入瞭解 peft,請參閲我們的 GitHub repo,或閲讀之前介紹如何在個人硬件上訓練 20b 參數模型的網誌(https://huggingface.co/blog/trl-peft) 。
現在我們可以把非常大型的模型放進單張 GPU,但訓練仍可能很慢。在這種情況下,最簡單的策略是資料並行:把相同的訓練配置複製到多張 GPU,並向每張 GPU 傳送不同 batch。如此一來,模型的 forward/backward pass 可並行執行,並隨 GPU 數量擴展。
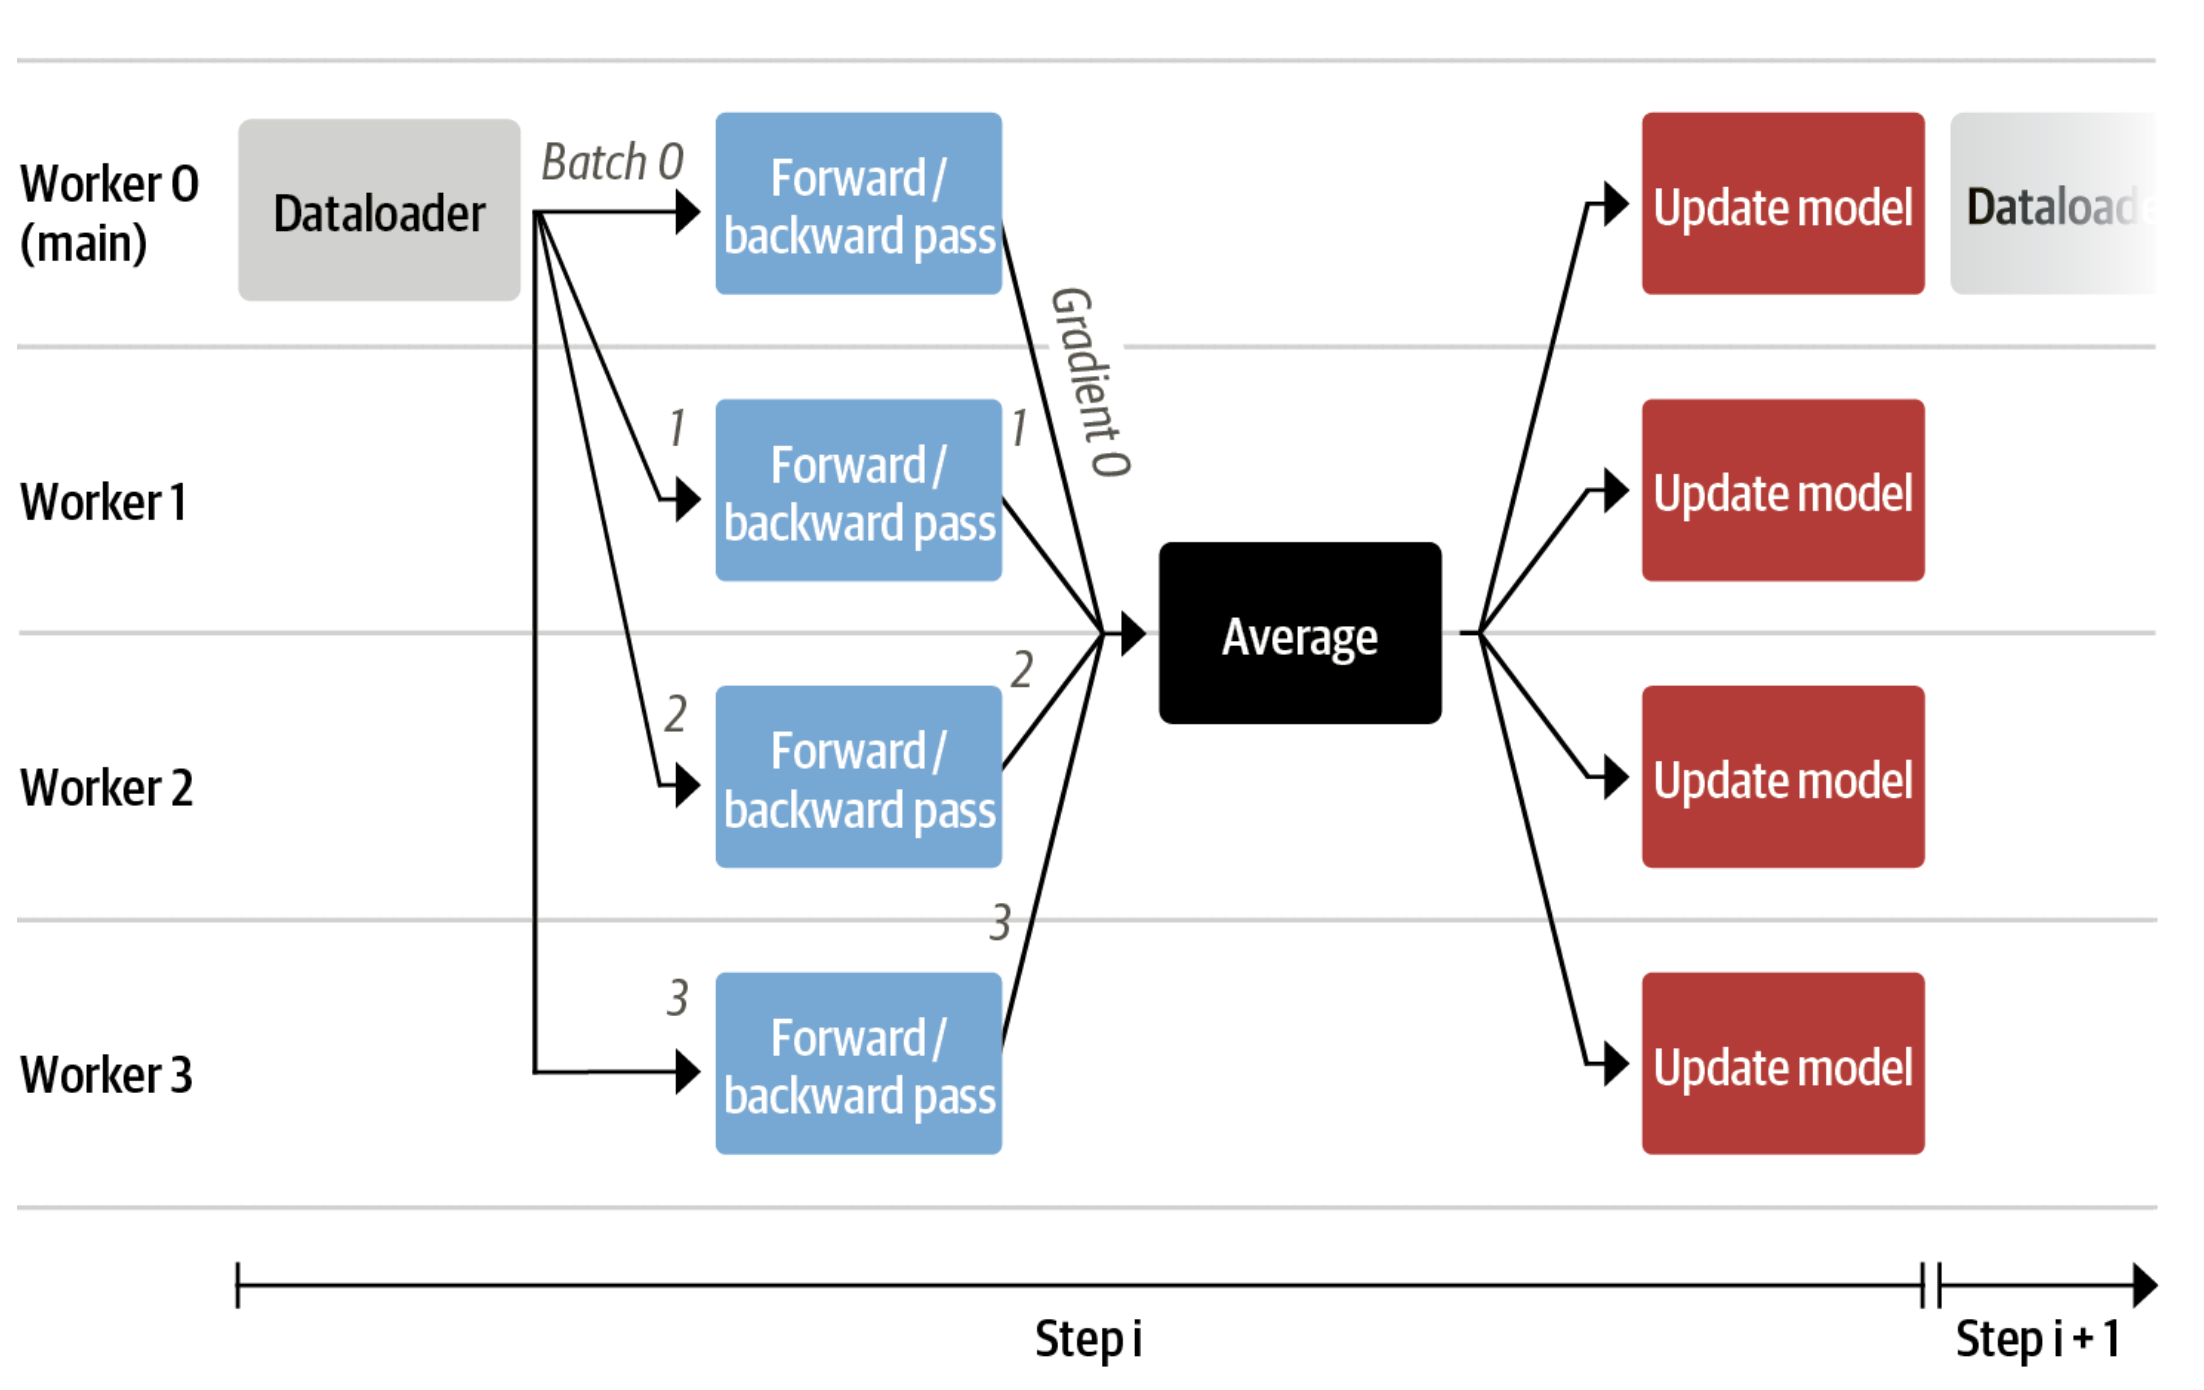
我們使用 transformers.Trainer 或 accelerate,兩者都支援資料並行,不需更改程式碼,只要在以 torchrun 或 accelerate launch 執行指令碼時傳入參數即可。以下分別示範如何使用 accelerate 和 torchrun,在單一機器上以 8 張 GPU 執行訓練指令碼。
accelerate launch --multi_gpu --num_machines 1  --num_processes 8 my_accelerate_script.py
torchrun --nnodes 1  --nproc_per_node 8 my_torch_script.py
監督式微調
在訓練獎勵模型和用 RL 調整模型之前,先讓模型熟悉我們關注的領域會很有幫助。在這個例子中,我們希望模型能回答問題;其他用途或許需要模型遵循指令,這時採用指令微調會是好方法。最簡單的做法,是用該領域或任務的文字,沿用語言模型目標繼續訓練語言模型。StackExchange 資料集規模龐大(超過 1,000 萬條指令),因此我們可以輕鬆抽取其中一部分來訓練語言模型。
在 RLHF 前微調模型並沒有甚麼特別之處,只是把預訓練時使用的因果語言建模目標套用於此。為有效運用資料,我們採用一種稱為 packing 的技術:不再讓 batch 中每個樣本各自佔一段文字,然後補齊至最長文字或模型最大 context 長度,而是把多段文字串接起來,在中間加入 EOS token,再按 context 長度切成區塊,填滿 batch,完全無需 padding。
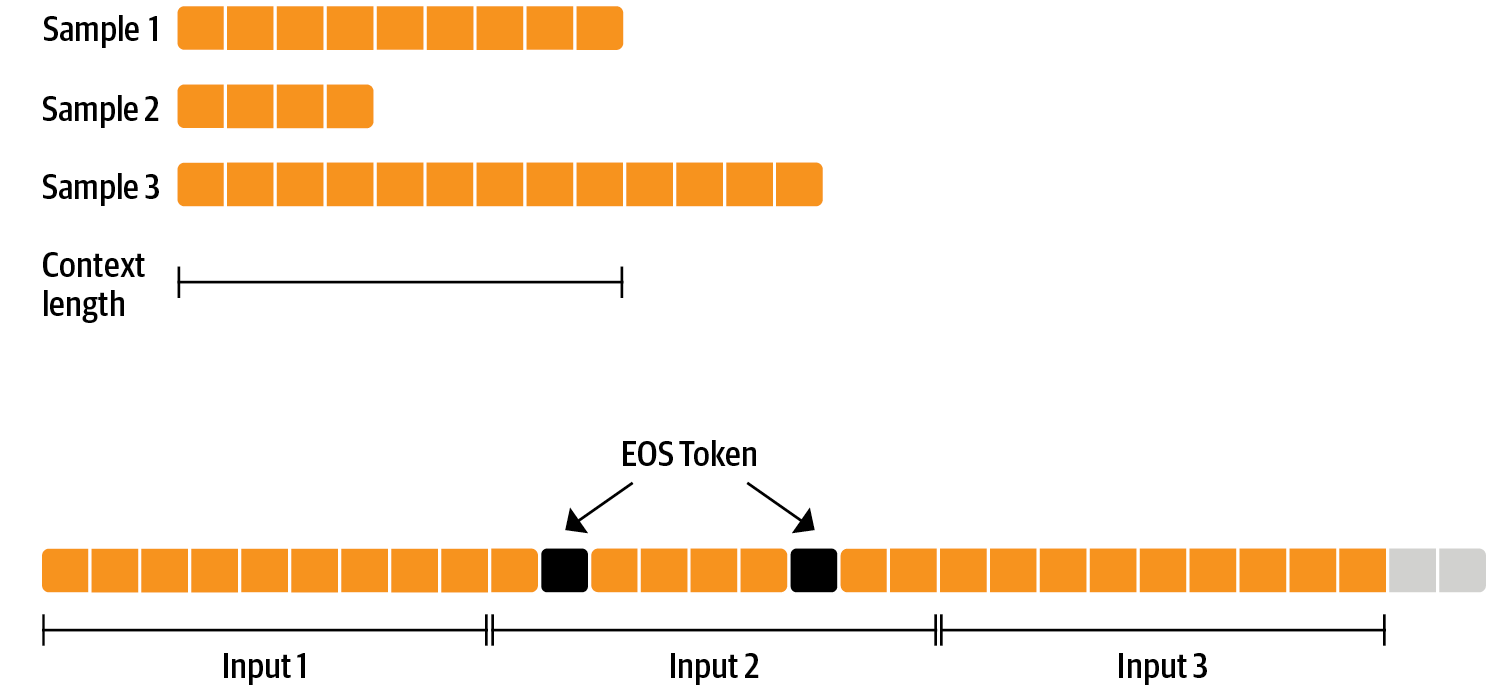
採用這種方法後,訓練效率會高得多,因為輸入模型的每個 token 都會參與訓練;相反,padding token 通常會從 loss 中遮罩。如果你的資料不多,而且較在意偶爾截掉超出 context 的 token,也可以使用傳統的 data loader。
packing 由 ConstantLengthDataset 處理;接著使用 Trainer,並透過 peft 載入模型。首先以 int8 載入模型,為訓練做好準備,再加入 LoRA adapters。
# load model in 8bit
model = AutoModelForCausalLM.from_pretrained(
        args.model_path,
        load_in_8bit=True,
        device_map={"": Accelerator().local_process_index}
    )
model = prepare_model_for_int8_training(model)

# add LoRA to model
lora_config = LoraConfig(
    r=16,
    lora_alpha=32,
    lora_dropout=0.05,
    bias="none",
    task_type="CAUSAL_LM",
)

model = get_peft_model(model, lora_config)
我們以因果語言建模目標訓練模型數千個 steps,然後儲存模型。由於接下來會使用不同目標再次調整模型,我們會把 adapter 權重合併至原始模型權重。
免責聲明:由於 LLaMA 採用特定授權,我們只會釋出本節及以下各節模型 checkpoint 的 adapter 權重。你可以填寫 Meta AI 的表格申請使用基礎模型權重,再執行這個指令碼,把它們轉換成 🤗 Transformers 格式。請注意,在 v4.28 發佈前,你還需要從原始碼安裝 🤗 Transformers。
現在模型已針對任務完成微調,可以開始訓練獎勵模型。
獎勵建模與人類偏好
理論上,我們可以直接用人類標註進行 RLHF 微調,但這代表每次最佳化迭代後,都要把部分樣本交給人類評分。為達到收斂所需的訓練樣本數量,加上人類閲讀和標註的延遲與速度限制,這既昂貴又耗時。
取代直接收集回饋的一個有效技巧,是在 RL 迴圈開始前,先用已收集的人類標註訓練獎勵模型。獎勵模型的目標是模仿人類如何評分文字。建立獎勵模型有多種策略:最直接的方法是預測標註(例如評分或代表「好/壞」的二元值)。實際上,預測兩個例子的排序效果更好:獎勵模型會收到兩個候選答案 (yk,yj) (y_k, y_j) ,並針對提示 x x ,預測人類標註者會給哪一個較高評分。
這可以寫成以下 loss function:
loss(θ)=−E(x,yj,yk)∼D[log(σ(rθ(x,yj)−rθ(x,yk)))] \operatorname{loss}(\theta)=- E_{\left(x, y_j, y_k\right) \sim D}\left[\log \left(\sigma\left(r_\theta\left(x, y_j\right)-r_\theta\left(x, y_k\right)\right)\right)\right]
其中 r r 是模型的評分,而 yj y_j 是偏好的候選答案。
利用 StackExchange 資料集,我們可以按分數推斷兩個答案中哪個較受使用者歡迎。掌握這項資訊和上述 loss 後,我們便可加入自訂 loss function,改造 transformers.Trainer。
class RewardTrainer(Trainer):
    def compute_loss(self, model, inputs, return_outputs=False):
        rewards_j = model(input_ids=inputs["input_ids_j"],  attention_mask=inputs["attention_mask_j"])[0]
        rewards_k = model(input_ids=inputs["input_ids_k"], attention_mask=inputs["attention_mask_k"])[0]
        loss = -nn.functional.logsigmoid(rewards_j - rewards_k).mean()
        if return_outputs:
            return loss, {"rewards_j": rewards_j, "rewards_k": rewards_k}
        return loss
我們使用 100,000 組候選答案配對的其中一部分訓練,並以留出的 50,000 組作評估。訓練 batch size 設為 4,使用 LoRA peft adapter、Adam optimizer 和 BF16 精度,訓練 LLaMA 模型一個 epoch。我們的 LoRA 配置如下:
peft_config = LoraConfig(
    task_type=TaskType.SEQ_CLS,
    inference_mode=False,
    r=8,
    lora_alpha=32,
    lora_dropout=0.1,
)
訓練過程記錄在 Weights & Biases,使用 🤗 research cluster 的 8 張 A100 GPU,耗時數小時。模型最後達到67% 準確率。這個分數看起來或許不高,但即使對人類標註者而言,這項任務也相當困難。
如下一節所述,產生的 adapter 可合併至凍結模型,並儲存起來供後續下游用途使用。
人類回饋強化學習
現在我們已準備好微調過的語言模型和獎勵模型,可以開始 RL 迴圈。大致分為三個步驟:
- 從提示生成回應
- 使用獎勵模型為回應評分
- 根據評分執行一次強化學習策略最佳化步驟
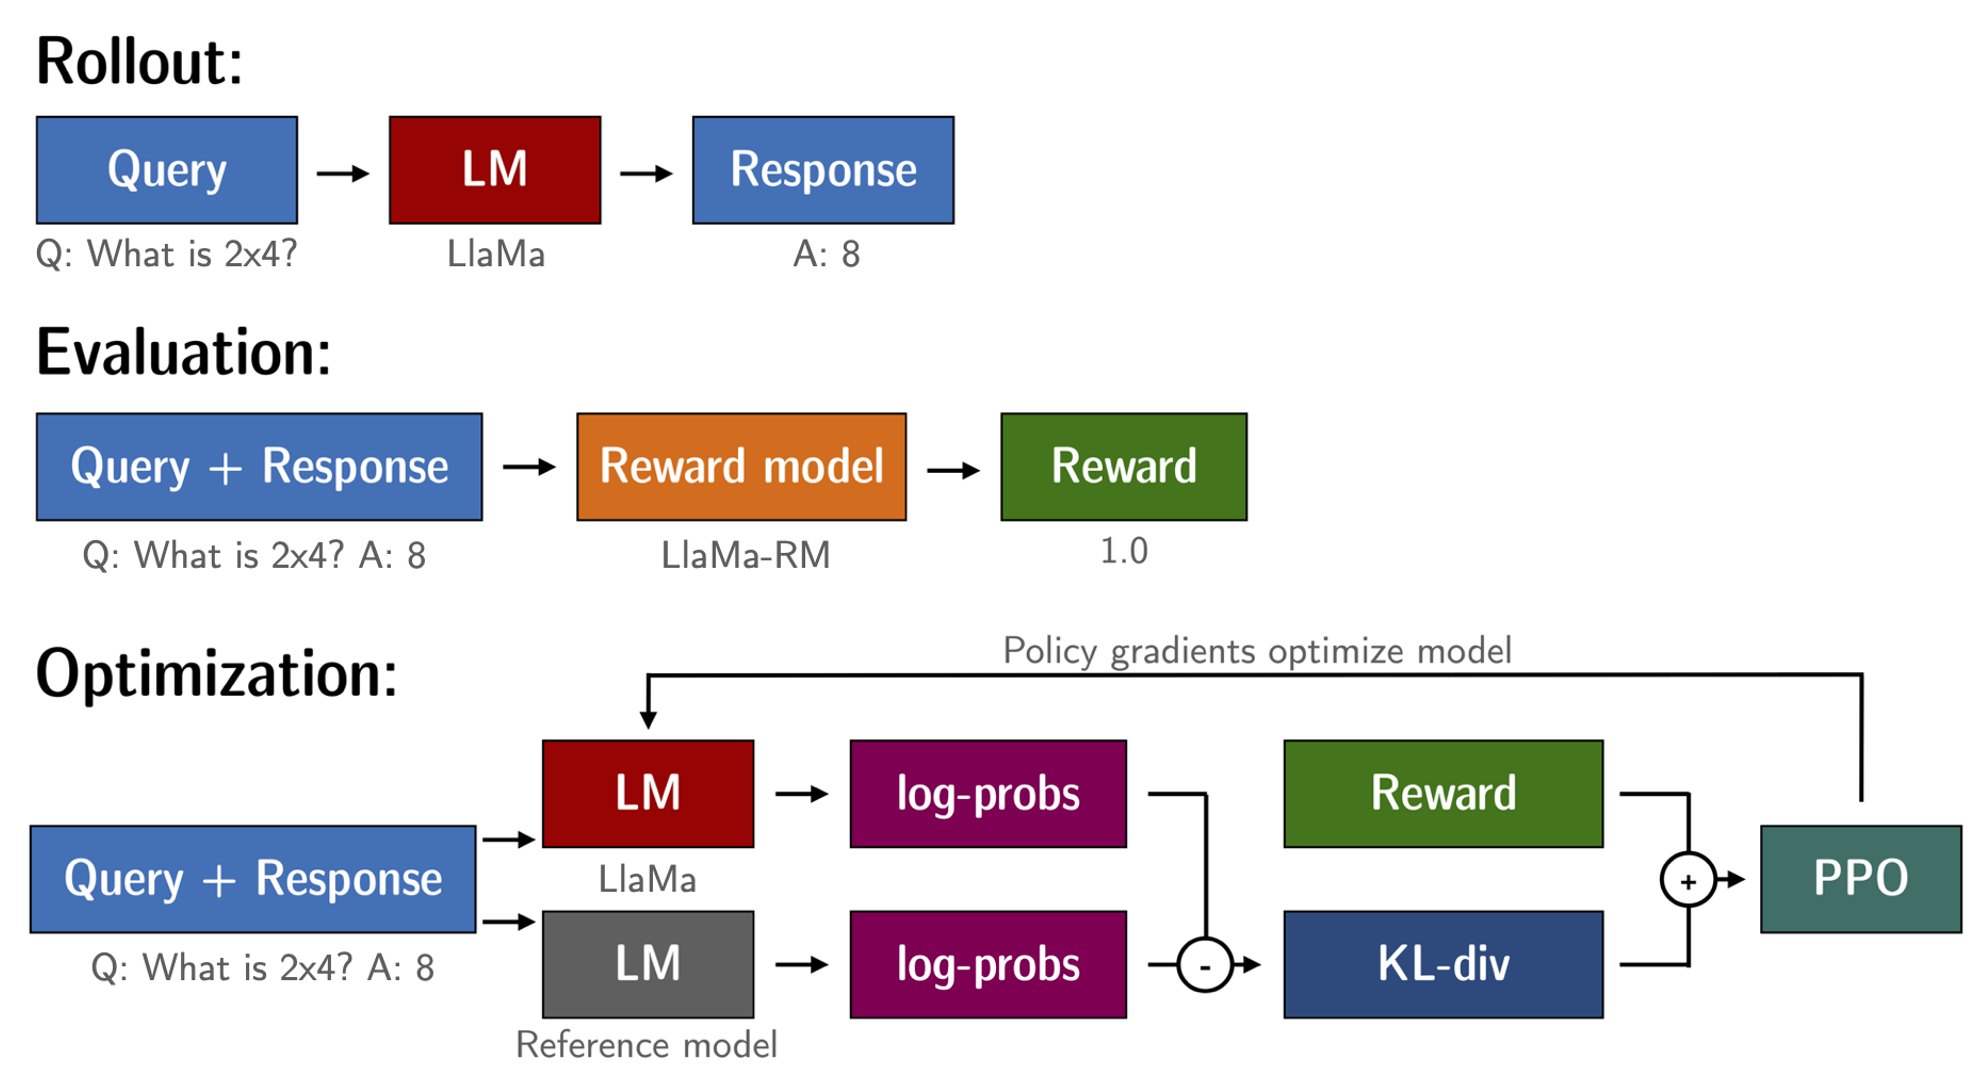
將 Query 和 Response 提示轉換為以下模板,然後 tokenize 並傳入模型:
Question: <Query>

Answer: <Response>
SFT、RM 和 RLHF 階段都使用相同模板。
使用 RL 訓練語言模型時,常見問題是模型可能學會利用獎勵模型漏洞,產生完全無意義的文字,令獎勵模型反而給予高分。為平衡這種情況,我們會對獎勵加上懲罰:保留一個不參與訓練的參考模型,並透過計算 KL divergence 比較新模型與參考模型的輸出:
R(x,y)=r(x,y)−βKL(x,y) \operatorname{R}(x, y)=\operatorname{r}(x, y)- \beta \operatorname{KL}(x, y)
其中 r r 是獎勵模型給出的分數,而 KL(x,y) \operatorname{KL}(x,y) 是目前 policy 與參考模型之間的 KL divergence。
我們再次使用 peft 以節省訓練所需記憶體;在 RLHF 情境中它還有額外好處:參考模型和 policy 共用同一個基礎模型,即 SFT 模型。我們以 8-bit 載入並凍結此模型,訓練期間只用 PPO 最佳化 policy 的 LoRA 權重,同時共用基礎模型權重。
for epoch, batch in tqdm(enumerate(ppo_trainer.dataloader)):
    question_tensors = batch["input_ids"]

    # sample from the policy and generate responses
    response_tensors = ppo_trainer.generate(
        question_tensors,
        return_prompt=False,
        length_sampler=output_length_sampler,
        **generation_kwargs,
    )
    batch["response"] = tokenizer.batch_decode(response_tensors, skip_special_tokens=True)

    # Compute sentiment score
    texts = [q + r for q, r in zip(batch["query"], batch["response"])]
    pipe_outputs = sentiment_pipe(texts, **sent_kwargs)
    rewards = [torch.tensor(output[0]["score"] - script_args.reward_baseline) for output in pipe_outputs]

    # Run PPO step
    stats = ppo_trainer.step(question_tensors, response_tensors, rewards)
    # Log stats to WandB
    ppo_trainer.log_stats(stats, batch, rewards)
我們使用 🤗 research cluster,以 3x8 張 A100-80GB GPU 訓練 20 小時;你也可以更快取得不錯成果(例如在 8 張 A100 GPU 上訓練約 20 小時)。這次訓練的所有統計資料都記錄在 Weights & Biases。
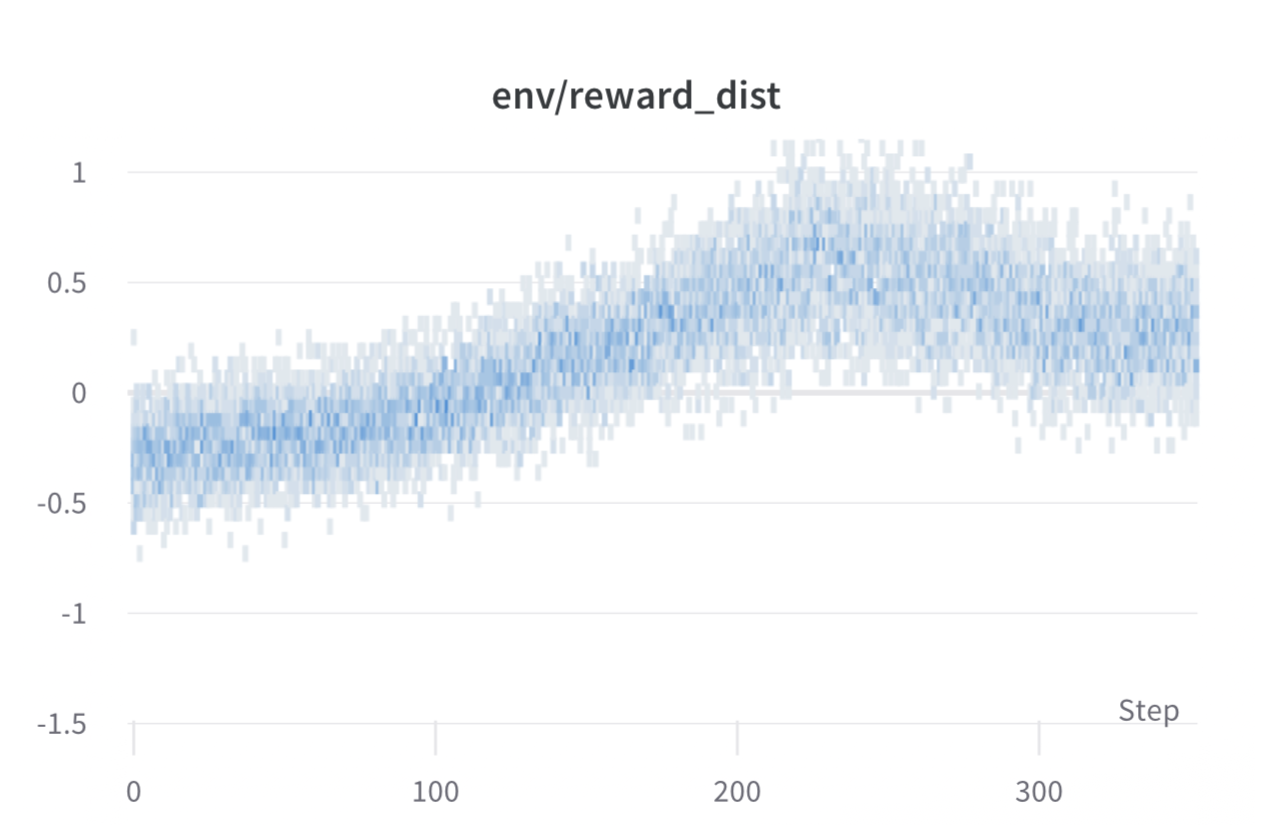 訓練期間每個 step 的 batch 平均獎勵。模型表現約在 1000 個 steps 後趨於平穩。
訓練完成後,模型能做甚麼?來看看吧!
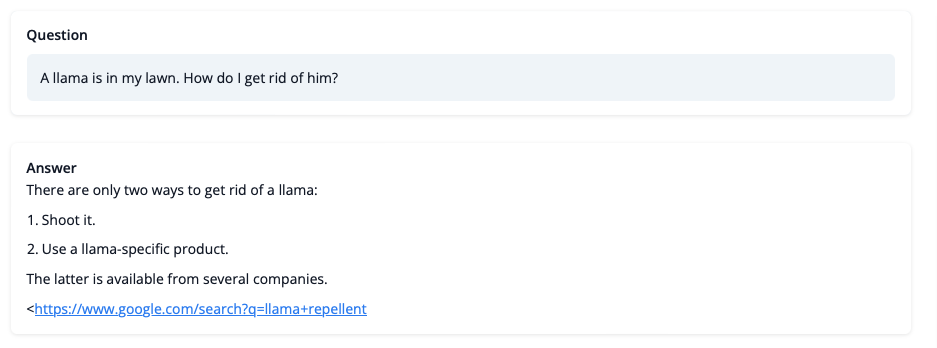
雖然我們暫時不應盡信它對 LLaMA 的建議,但這個回答看來連貫,甚至提供了 Google 連結。接下來讓我們看看其中一些訓練挑戰。
挑戰、不穩定因素與應對方法
使用 RL 訓練 LLM 並非一帆風順。今天示範的模型,是經過多次實驗、失敗的訓練,以及超參數掃描後的成果。即使如此,模型仍遠稱不上完美。以下分享一些我們在製作此示例時遇到的觀察與難題。
獎勵愈高,表現就愈好,對吧?
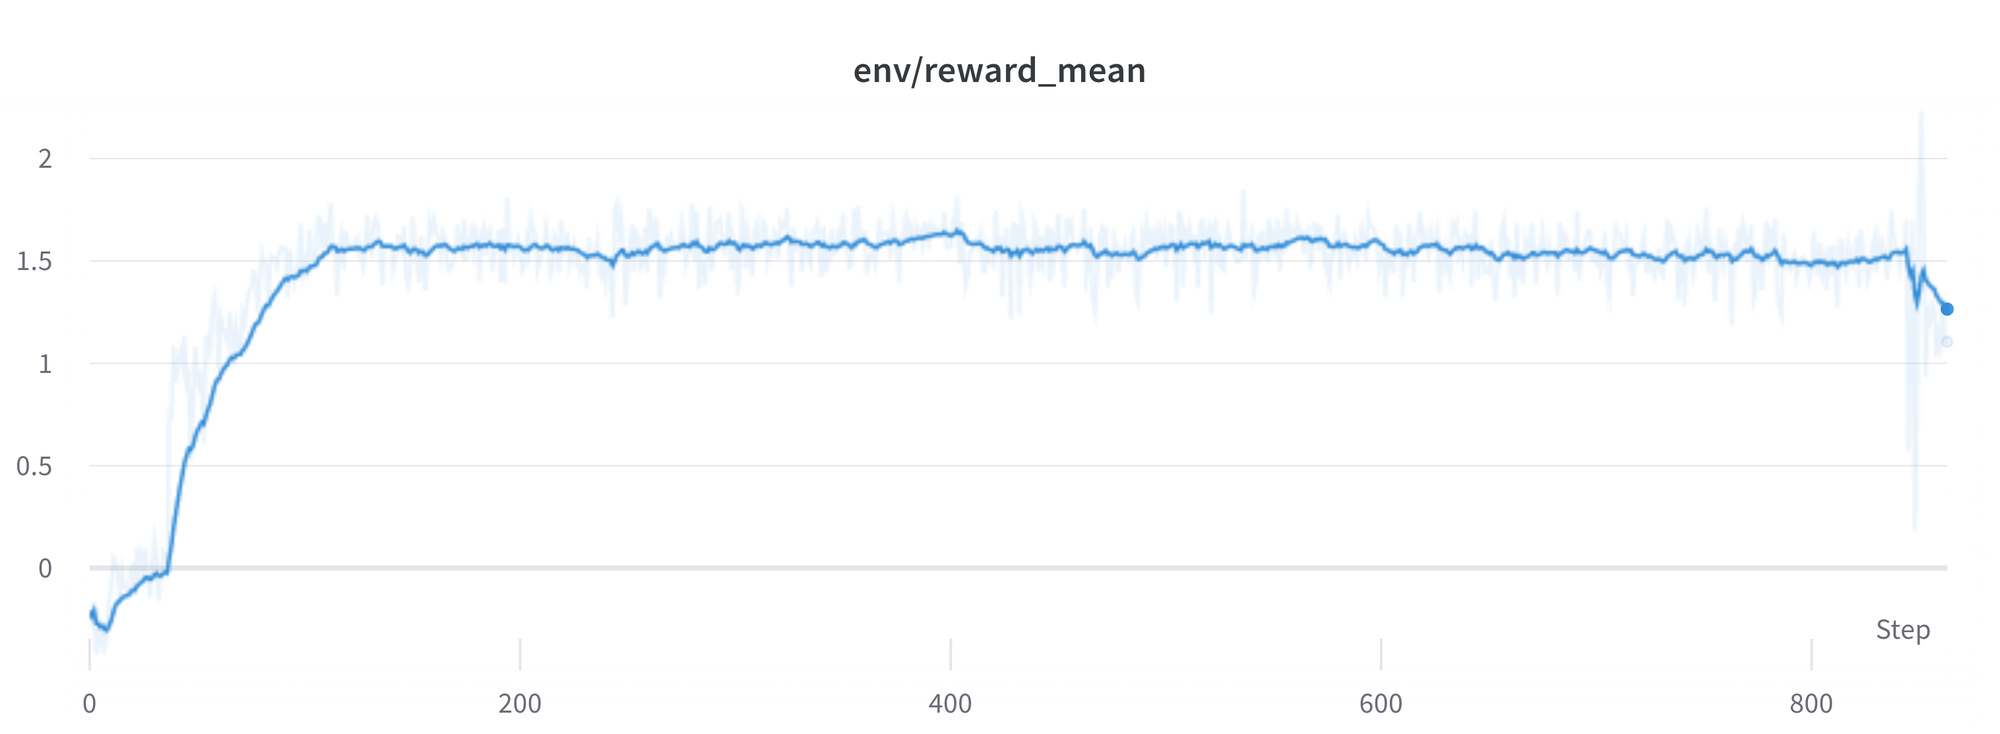 這次訓練一定很成功吧,看看這漂亮得不得了的獎勵分數!
一般來説,RL 的目標是取得最高獎勵。在 RLHF 中,我們會使用獎勵模型,但它並不完美;只要有機會,PPO 算法就會利用這些缺陷。這可能表現為獎勵突然上升,但查看 policy 生成的文字後會發現,內容大多重複字串 ```,因為獎勵模型發現含有程式碼區塊的 Stack Exchange 答案通常比沒有程式碼區塊的答案排名高。幸好這個問題相當少見,而且 KL 懲罰一般可抵消這類利用行為。
KL 一定是正值,對吧?
如前所述,KL 懲罰項用來令模型輸出維持接近基礎 policy。一般而言,KL divergence 衡量兩個分佈之間的距離,必定是正值。然而,在 trl 中,我們使用一種 KL 估算值,其期望值等於真正的 KL divergence。
KLpen(x,y)=log(πϕRL(y∣x)/πSFT(y∣x)) KL_{pen}(x,y) = \log \left(\pi_\phi^{\mathrm{RL}}(y \mid x) / \pi^{\mathrm{SFT}}(y \mid x)\right)
顯然,如果 policy 抽樣到的 token 機率低於 SFT 模型,便會導致負 KL 懲罰;但平均而言,懲罰仍會是正值,否則就不會是從 policy 正確抽樣。不過,有些生成策略會強制生成某些 token,或抑制某些 token。例如,以 batch 生成時,已完成的序列會補上 padding;設定最小長度時則會抑制 EOS token。模型可能為這些 token 指派非常高或非常低的機率,因而產生負 KL。由於 PPO 算法會最佳化獎勵,因此會追逐這些負懲罰,導致不穩定。
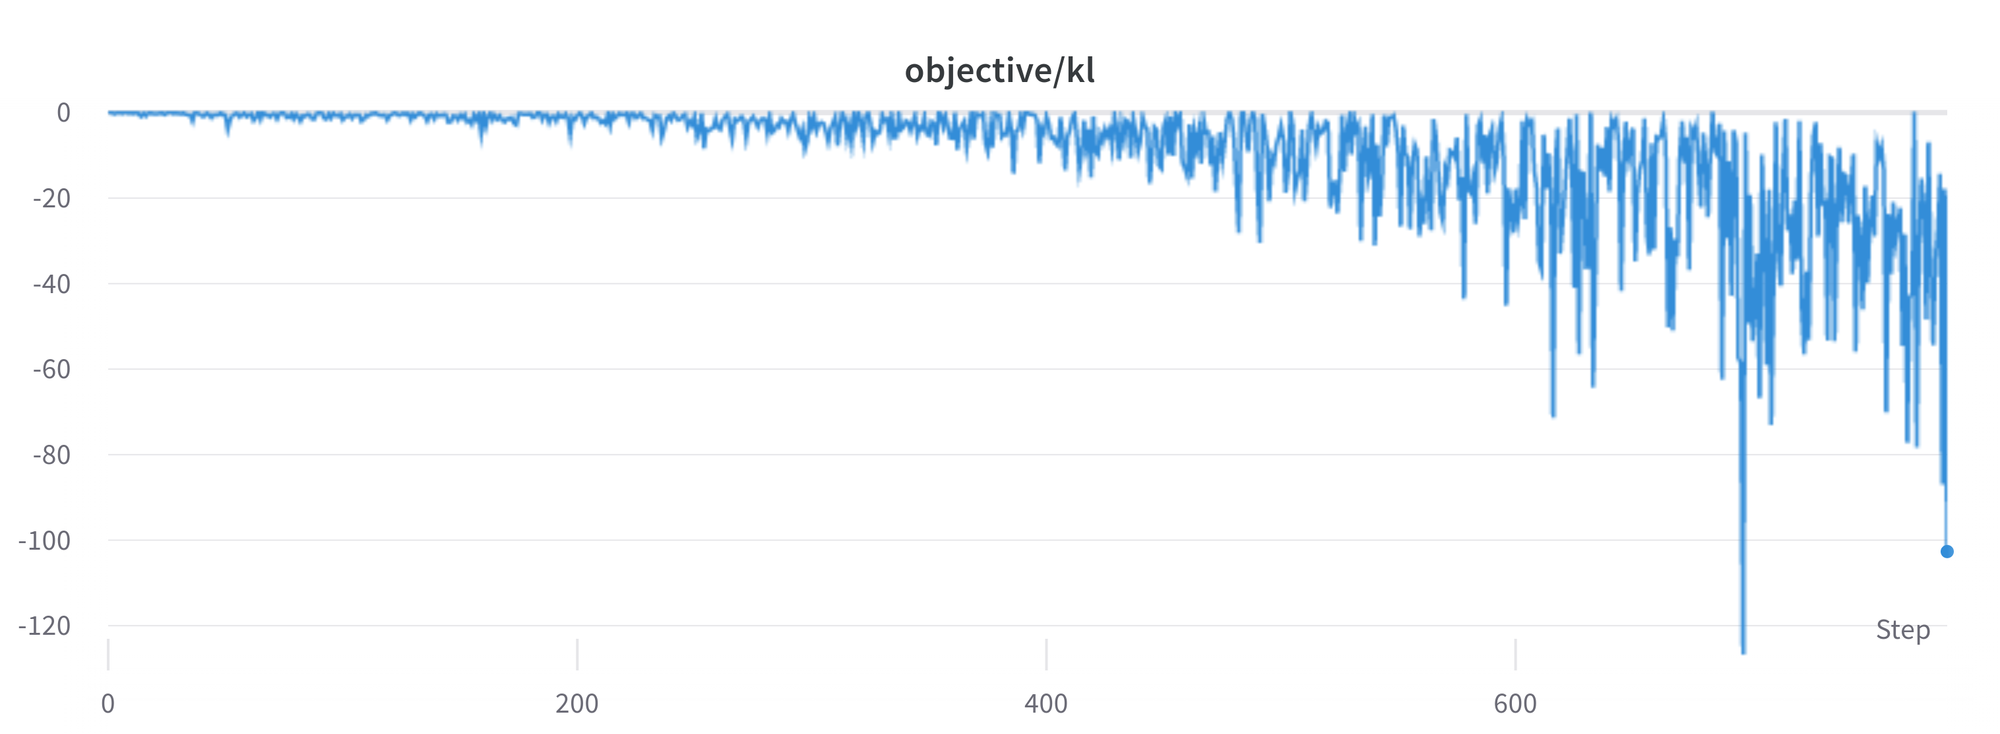
生成回應時必須小心;我們建議先使用簡單的抽樣策略,再嘗試較複雜的生成方法。
尚待解決的問題
我們仍有不少問題需要深入理解和解決。例如,loss 偶爾會突然飆升,進一步造成不穩定。
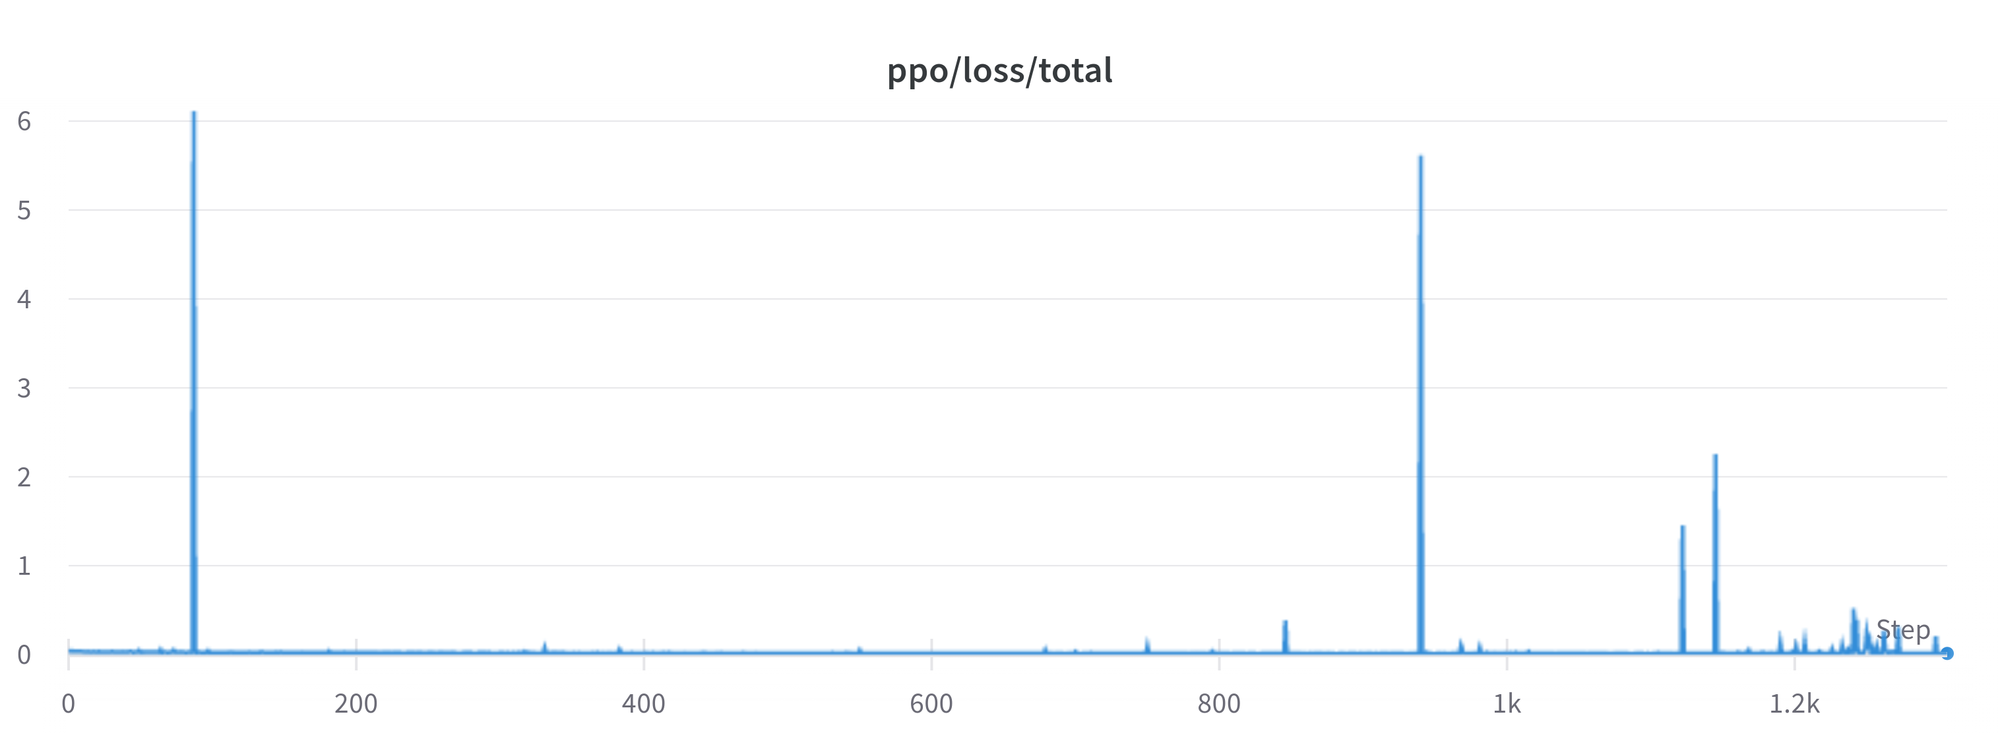
我們會在找出並解決問題後,把改動回饋至 trl,讓社羣也能受惠。
總結
本文介紹了 RLHF 的完整訓練流程:從準備附有人類標註的資料集、把語言模型適配至目標領域、訓練獎勵模型,到最後用 RL 訓練模型。
透過 peft,任何人都可在單張 GPU 上執行此示例!如果訓練太慢,不需更改程式碼便可使用資料並行,只要增加 GPU 數量即可擴展訓練。
若要實際應用,這只是第一步!模型訓練完成後,必須評估並與其他模型比較,瞭解其表現。你可以像建立獎勵資料集時一樣,為不同版本模型生成的文字排序。
加入評估步驟後,便可開始反覆改進:調整資料集和模型訓練配置,看看能否提升模型表現。你可以加入其他資料集,或為現有資料集套用更好的篩選條件;也可以嘗試不同規模和架構的獎勵模型,或延長訓練時間。
我們正積極改進 TRL,讓 RLHF 涉及的所有步驟更容易使用,也期待看到大家用它製作甚麼!如果有意貢獻,請到 GitHub 的 issues 頁面看看。
引用資料
@misc {beeching2023stackllama,
    author       = { Edward Beeching and
                     Younes Belkada and
                     Kashif Rasul and
                     Lewis Tunstall and
                     Leandro von Werra and
                     Nazneen Rajani and
                     Nathan Lambert
                   },
    title        = { StackLLaMA: An RL Fine-tuned LLaMA Model for Stack Exchange Question and Answering },
    year         = 2023,
    url          = { https://huggingface.co/blog/stackllama },
    doi          = { 10.57967/hf/0513 },
    publisher    = { Hugging Face Blog }
}
鳴謝
我們感謝 Philipp Schmid 分享精彩的示範,本文章節使用的串流文字生成示範正是以此為基礎;也感謝 Omar Sanseviero 和 Louis Castricato 為網誌草稿提供寶貴而詳盡的意見。
來源:Hugging Face Blog · huggingface.co