AWS 以 Amazon Bedrock AgentCore 建立可用於正式環境的 AI 智能體評估框架
Building trust in AI agents: A production-ready evaluation framework with Amazon Bedrock AgentCore
AWS Sales, Marketing, and Global Services(SMGS)團隊以 Amazon Bedrock AgentCore Evaluations 建立九階段評估框架,涵蓋 AI 智能體由開發到正式環境運作的完整生命週期。
文章把工具、單一智能體與多智能體協作納入九階段評估流程,並展示如何透過回歸門檻、線上監測及追蹤資料定位品質退化。
北極星
每個競相部署 AI 代理的機構,都面對同一個現實考驗:示範時表現出色的代理,投入正式環境後可能在不知不覺間退化;等到有人察覺時,信任已經破裂。傳統軟件出錯時往往會明顯失效,代理卻可能悄然出錯。它們給出的答案看似有把握、讀起來流暢,實際上卻是錯的。當這些答案左右真實的商業決策時,代價不只是功能失效,而是與用戶之間的關係受損。
這正是品質問題的核心。因此,挑戰不在於打造只成功運作一次的代理,而在於證明它們能持續運作,並在大規模環境下涵蓋每個子代理、每個工作流程及每次發布。能在代理時代勝出的團隊,會把品質視為代理本身的作業系統,而不是最後才做的 QA 步驟:持續量度、自動防護,並在每次互動中改進。在這篇文章中,我們會介紹如何運用 Amazon Bedrock AgentCore,為可投入正式環境的大規模代理式方案建立持續品質循環。
業務問題
這套方案供內部使用,採用 Amazon Bedrock AgentCore 及其他 AWS 服務,讓銷售人員和銷售主管可以透過 Amazon Quick,以淺白英文提出業務問題。在這個簡單體驗的背後,有多個專門子代理協同運作:Performance Insights Agent 負責按負責區域提供收入及表現資訊;Customer Insights Agent 負責客戶洞察;Data Insights Agent 負責對基礎數據集執行 text-to-SQL;用戶亦可直接存取儀錶板。答案會按每位用戶的負責區域及角色層級安全權限設定範圍。一線團隊會用這些答案協助規劃客戶帳戶策略及準備客戶會議,因此數字必須準確。最嚴重的失誤不是系統崩潰,而是答案流暢而自信,卻悄然出錯。在發布前評估 Customer Insights Agent 時,我們正好發現了這類問題:
- 它把某位客戶某項服務三個月的收入 $410.08,報告為「$410.08 Million」。
- 它把標示為 Sales Revenue 的數據,報告成 Sales Revenue excluding Adjustments。
- 它提供了一個資料中完全不存在的年度經常性收入估算值。
- 它把自行計算的結果當成有來源佐證的事實。
在不同的執行過程中,監控狀態一直顯示正常。但監控只告訴我們系統有作出回應,沒有告訴我們答案是否正確。
如果這些錯誤未被發現便隨版本發布,一線團隊就要承受後果。銷售人員若向客戶重複一個被誇大的數字,可能會失去客戶的信任。這正是我們在發布前找出問題的原因。風險不會在發布後消失:每增加一個代理,或更改數據、提示詞、程式碼或模型,風險都會上升。即使沒有發布,風險也會增加,因為上游管道每週都會更新數據。協調發布亦帶來相關風險:如果數據變更、工具變更和配套的提示詞更新原定一併推出,卻分開到位,系統便會在所有變更完成之前處於不匹配狀態。在一次發布前測試中,單是這段不匹配時期,就令通過率從 78 percent 降至 38 percent。為了在每次發布前及正式環境中持續發現這類失誤,我們需要一套框架,能夠顯示答案是否有根據且正確,並追查每項失誤在數據、提示詞或代理程式碼中的根本原因。
在 AWS,Sales, Marketing, and Global Services (SMGS) Operations 團隊開發了一套正式投入運作的多代理系統,服務全球 AWS Field Sales 團隊。這套系統服務兩類不同用戶。對前線銷售團隊而言,它以隨選、對話式智能取代數小時的手動數據分析,協助銷售人員瞭解業務狀況、發掘風險和機遇,並更快採取行動。對管理層而言,系統支援每週業務檢討(Weekly Business Reviews,WBR)等業務管理例行流程,無需手動準備報告,便能從整個業務組閤中發掘重要訊號。同一個代理式系統,既服務前線銷售人員,也服務大規模檢視績效的管理層。
代理式系統協調日益擴大的專用子代理組合,各自負責不同能力領域。其中包括:績效洞察代理會根據複雜的銷售數據生成自然語言商業智能分析,將原始指標轉化為可供銷售人員採取行動的洞察。客戶洞察代理會整合產品使用情況、支援記錄、合約狀態及互動數據等訊號,建立每位客戶的 360 度全方位概況,協助銷售人員瞭解客戶所處的旅程階段及下一步所需。數據洞察代理是一個 text-to-SQL 代理,客戶團隊可用通俗英文查詢結構化分析數據,無需編寫任何 SQL。本文其餘部分提及的代理,指的就是這三個代理。
要在大規模環境下可靠地協調這些代理,我們清楚認識到一點:代理品質不是可以留待日後處理的營運問題,而是系統投入運作的先決條件。單一子代理效能下降,就可能在毫無察覺下令其後的每個回應出錯,而傳統監控無法偵測這類問題。正因如此,完整的全生命週期評估框架並非可有可無,而是不可或缺。Amazon Bedrock AgentCore 的一項功能 AgentCore Evaluations 是支撐這套框架的核心連接機制,並配合 Amazon Bedrock Guardrails(安全防護)、Amazon CloudWatch(指標、警示、追蹤)、Amazon Simple Storage Service (Amazon S3) 和 Amazon Redshift(評估資料持久化)、Amazon Quick(儀錶板),以及 AWS Lambda(自訂評估器)。
本文分享我們如何應對在企業級規模運行 AI 代理時最艱鉅的營運挑戰,以及 Amazon Bedrock AgentCore Evaluations 如何成為代理品質的核心。具體而言,本文涵蓋:
- 代理各有不同規則 – 為何代理需要不同的營運規範,以及為何傳統監控(延遲、錯誤率、運作時間)無法讓你察覺最重要的故障。
- 涵蓋整個流程的藍圖 – 我們以 AgentCore Evaluations 建立的九階段評估框架,涵蓋代理開發生命週期的每個階段,從首次提交到投入正式環境。
- 從理論到實踐 – 具體模式,包括持續整合與持續交付(CI/CD)回歸測試閘門、金絲雀評分、漂移偵測及自動化回饋迴路,以及 AgentCore Evaluations 如何為每種模式提供支援。
- 真正重要的指標 – 我們的代理組合在部署信心、預防回歸及迭代速度方面所帶來的可量度成效。
為何代理需要結構化評估框架
傳統軟件具有確定性:相同輸入會產生相同輸出。機器學習(ML)模型引入概率性輸出,而 MLOps 也因此應運而生,用以管理模型的訓練、版本管理、監察及重新訓練。AI Agent 增添了第三層運作複雜性:自主進行多步驟推理,令問題由「有沒有出現故障?」轉變為「Agent 是否在整條推理鏈上作出合理決策?」
Agent 承襲前兩者的難題,亦帶來一些新問題。對於相同輸入,Agent 會沿着不同的推理路徑運作,因此具有非確定性。它們會在路由、工具選擇及整合等環節作出一連串決策,單一步驟可能悄然失敗,並令所有後續環節出錯。最關鍵的是,它們會在毫無明顯跡象下退化:延遲維持低水平,錯誤率維持不變,但 Agent 回應的質素卻逐漸下降,因為 Agent 仍然在回應,只是答錯了。
Agent 評估是專門用來捕捉這類問題的實踐,涵蓋五個維度:安全(行為是否符合既定界限?)、質素(Agent 能否提供正確、連貫且有根據的回應?)、效能(速度和可靠性是否足夠?)、成本(能否有效率地大規模運行?)及營運管控(能否迅速偵測、診斷及補救問題?)。成熟的評估實踐會在 Agent 的整個生命週期內,持續涵蓋這五個維度。
在本文中,我們分享如何在正式環境的多 Agent 系統中,落實這五個評估維度。安全與保安是我們的首要考量。任何 Agent 若未達到安全標準,都不會部署,也不會繼續運行。本文花最多篇幅討論質素,因為它是五個維度中最難處理妥當的一項,也最受惠於專門框架;但其優先級仍低於安全。效能、成本和營運管控則與安全和質素一樣,融入生命週期的每個階段。重要的是,這套框架適用於 Agent 層級架構中的每個層級。在工具層級,每項功能(例如客戶消歧工具、圖譜檢索工具)都有自己的評估規範。在Agent 層級,每個子 Agent 都會接受端對端評估。在多 Agent 層級,編排路徑會按連貫性、路由正確性,以及跨 Agent 邊界的整合準確度進行評估。
九個階段會同時套用於三個層級,而這種層級架構並非此產品專有。這是我們建立或整合新的正式環境 Agent 時,應採用的思考框架。大部分團隊都從 Agent 層級開始評估,然後便止步於此。但 Agent 層級的質素取決於其所依賴的工具,而多 Agent 系統則帶來第三個失效面向,單靠任何一個層級都無法察覺。穩健的評估實踐必須涵蓋這三個層級;每個層級都會在九個階段中使用自己的黃金測試集、評估器及晉級準則。
Agent 評估框架:九個階段,一個閉環
這九個階段描繪了 Agent 從首次提交程式碼到正式環境上線的整個生命週期;每個階段都回應團隊在 Agent 逐步成熟時面對的一個問題。
Agent 生命週期與九個常見問題
每個開發正式環境 Agent 的團隊,都會在 Agent 日漸成熟的過程中遇到以下問題:
階段 1:基礎: 「怎樣才算好?」
第 2 階段:實驗: 「哪個版本較好?」
第 3 階段:合併(CI): 「我有沒有弄壞甚麼?」
第 4 階段:閘門(CD): 「適合在正式環境使用嗎?」
第 5 階段:金絲雀: 「有沒有東西在不知不覺間壞掉?」
第 6 階段:對手: 「如果有人試圖攻破它,會怎樣?」
第 7 階段:漂移: 「正式環境中的品質有沒有逐漸偏移?」
第 8 階段:脈搏: 「我們如何知道它此刻運作正常?」
第 9 階段:回饋循環: 「它如何自動變得更好?」
我們利用 AgentCore Evaluations,為 Agent 生命週期的每個階段建構一套框架。這九個階段並非事後拼湊在一起的獨立工具,而是同一個連續評估平台上的九個環節,由 AgentCore Evaluations 提供支援,涵蓋從首次提交到正式環境回應的整個流程,如圖 1所示。
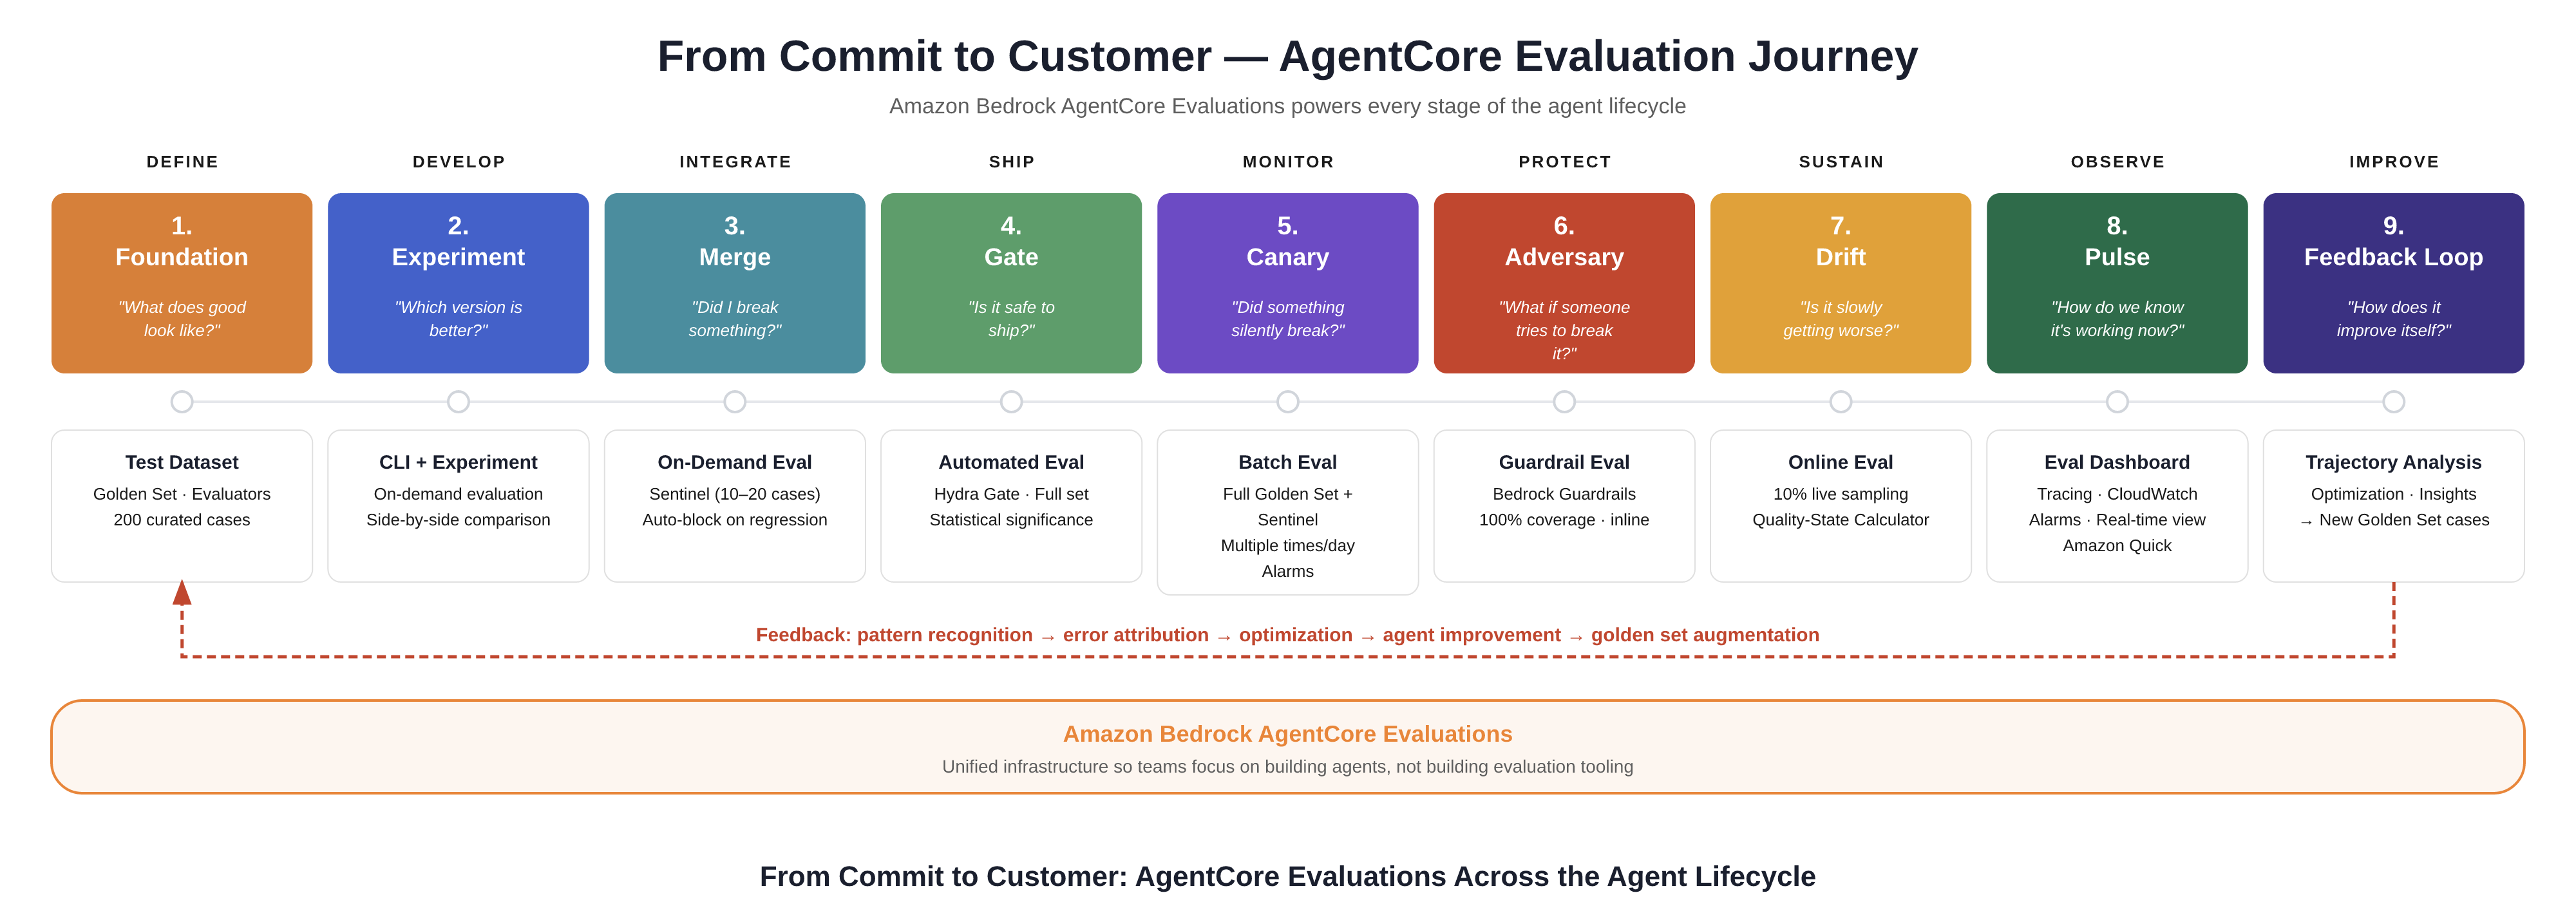
圖 1:AgentCore Evaluations 的九階段流程,從定義到改進
以下説明我們如何處理每個階段:行之有效的模式、背後支援的 AgentCore 服務,以及在正式環境中的運作方式;系統設計如圖 2 所示。

圖 2:AgentCore 評估框架的系統設計
第 1 階段:基礎。定義品質
評估 Agent 的基礎,不在於選擇合適的工具,而在於提出正確的問題:這個 Agent 如何才算成功?我們又如何知道它何時失效?答案必須來自客戶,而非模型。這是一個反覆迭代的過程。隨着我們觀察 Agent 在正式環境中的實際表現,對成功的定義也變得更加明確。此處定義的一切(失效閾值、評估器組合、黃金資料集、安全規則、延遲預算及成本目標),都是其後每個階段必須遵守的規範。如果第 1 階段的定義含糊不清,後續每個關卡都只能靠猜測。
第 1.1 階段:先定義業務指標。首先要問,這個 Agent 要達成甚麼目標。兩類終端用戶角色對成功有不同的定義:
- 對賣家而言,成功代表能在與客戶交談前,適時取得準確、最新且詳略合宜的情報。
- 對管理層而言,成功代表每週及跨業務檢討都能取得可靠資料,而毋須花大量時間手動準備。這些是業務成果,而非模型屬性。
第 1.2 階段:將業務指標轉化為評估指標。針對每項成果,找出能確認 Agent 已達成該成果的訊號。每個訊號都會成為一項追蹤指標,並設有明確閾值及警報條件。準確的帳戶情報對應實體解析準確度及依據率。賣家信任度對應忠實度及幻覺率。賣家採取行動對應有用性及範圍遵循度。管理層檢討的可靠性對應準確度通過率及回應覆蓋率。這項轉化必須涵蓋五個層面:除了品質閾值,還要定義安全護欄政策、為每項工具及每個 Agent 設定 p50、p90 和 p99 延遲目標、制定每次查詢的成本預算,並定義服務水平協議(SLA),以決定何時觸發警報,以及警報會觸發哪份操作手冊。
尤其在準確度方面,由於解決方案的輸出會直接影響收入決策、續約策略及高層檢討,因此要求非常嚴格。信心十足但錯誤的答案,不只會浪費銷售人員的時間,還會令他們在實際業務情境中作出錯誤決策。我們根據實際上線錯誤,界定了六種失誤類型;任何一種都代表回應不準確:
- 指標錯置:客戶和期間正確,但回傳了錯誤指標。以每 100 個回應中出現的次數追蹤。
- 期間錯誤:某個時間區間的數據被標示為另一個時間區間,例如將按年變動(YoY)數字呈現為按月變動(MoM),或反之。以引用正確時間區間的比例追蹤。
- 實體錯誤:混淆帳戶名稱或子公司。以實體識別準確率追蹤。
- 純粹幻覺:數字沒有根據,也沒有可追溯的來源。以根據率追蹤。
- 符號錯誤:指標正確,但貨幣或單位符號錯誤。以範圍遵循率追蹤。
- 未經授權的計算:衍生出資料來源中沒有、亦未獲批准的數值。以每 100 個回應中出現的次數追蹤。
整體準確度通過率是主要指標;按維度追蹤,才能令指標具備可操作性。除了準確度,我們亦會追蹤回應相關性、忠實度、實用性、指令遵循、工具選擇準確度。正確答案若埋在三段文字之中,或遲遲才送達,對銷售人員而言同樣算是失敗。
階段 1.3:建立反映這些指標的評估器組合。單一評估器類型無法涵蓋各種可能的失誤模式。我們結合四種類型:
- AgentCore 內置評估器,用於廣泛的基準覆蓋。相關性、忠實度和實用性,均可直接對應到AgentCore Evaluations原生提供的評估範本。
- 自訂評估器,按分類中的每種失誤類型各設一個:指標錯置評估器、期間錯誤評估器、客戶錯誤評估器、純粹幻覺評估器、符號錯誤評估器,以及未經授權的計算評估器。這六種評估器均未涵蓋在原生範本之中。這些是我們在 AgentCore 框架之上建立、針對特定領域的訊號。預先了解哪些指標已由原生範本涵蓋,哪些則需要自訂評估器,本身就是設計決策的一部分。
- 第三方評估器,我們部署了第三方開源程式庫 DeepEval 和 AutoEval 提供的託管評估器。
- 確定性評估器,用於核對已知確切正確答案的基準真值,例如收入、續約日期和合約狀態。
對於沒有單一正確答案的推理質素和實用性,我們會改用 LLM-as-judge 評分準則,當中包括相關性、忠實度和實用性的內置準則,亦支援完全自訂的準則。AgentCore Evaluations 原生提供基準真值評估和 LLM-as-judge 評估,讓我們無須自行建立評分引擎,就能開展這兩種評估流程。確定性評估器能精確核對事實;LLM-as-judge 則能廣泛評估推理。
階段 1.4:建立黃金測試集,測試評估指標。在工具層級,每項關鍵工具都有各自確定的真值配對:客戶識別必須解析為確切的標準實體,否則便視為失敗。在Agent 層級,對真實用戶查詢進行主題分析,建立涵蓋四種問題類型的資料集(綜合型、報告型、推理型及模糊型);每種類型都需要不同的評估策略,並每月重新檢視。在多 Agent 層級,端對端協調場景可找出只有在 Agent 互動時才會出現的錯誤。黃金測試集不只是品質資料集,還包括安全測試案例、延遲基準測試案例及成本參考案例,讓階段 3 和 4 能以同一套精心整理的資料集,檢查五個維度。
黃金測試集是一份持續更新的文件,內容來自三個來源。從生產環境整理的案例,取樣自賣家和領導層的真實查詢,包括階段 7 納入的低分即時工作階段。從失敗案例整理的案例,來自預備環境或生產環境中發現的每項回歸問題,包括階段 3 納入的哨兵案例,以及階段 9 納入的永久回歸防護案例。合成邊界案例則是刻意設計的,確保涵蓋已知重要、但不能等到實際遇上才處理的場景,例如上述四種問題類型,以及階段 4 中母公司與子公司、股票代號的消歧案例。這套資料集會以版本控制、接受審查,並持續從這三個來源擴充。
階段 2:實驗。找出勝出的版本
每項變更(提示詞更新、新工具、模型升級、資料集更新)都會引出同一個問題:這個版本是否真的更好?對於一個大規模服務全球 AWS 前線團隊的系統,直覺並不是可以接受的答案。
在合併變更前,我們會執行 AgentCore On-Demand Evaluation,使用同一套評估器套件,根據同一套黃金測試集評分。開發團隊會使用品質、延遲和成本指標,以及上下文 token,整理下游比較資料;這些資料會同時按五個維度進行評估,如圖 3所示。若模型的準確度提升 5 percent,但延遲變為兩倍、成本變為三倍,並不代表它一定勝出。
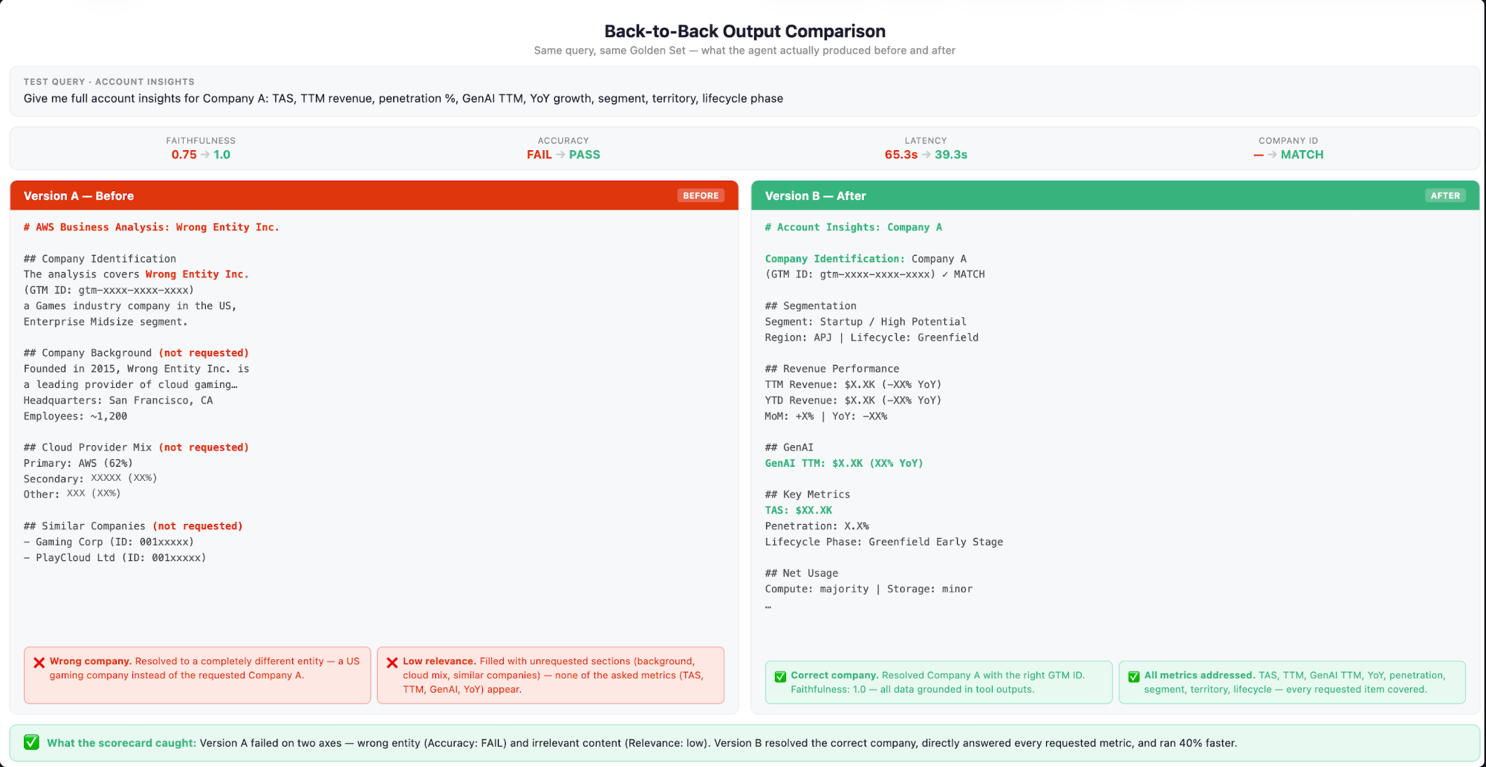
圖 3:在 AgentCore On-Demand Evaluation 中,按品質、延遲和成本並列比較兩個候選 Agent 的回應。圖中的數字和數值僅供示意。
我們以全面評分表追蹤品質,而不是隻看單一數字。單看通過率並不足以反映整體情況。每次評估執行都會按分類法中的各種失敗類別,提供完整分析:不只顯示品質有否改善,也指出改善之處及原因,如圖 4 的評分表所示。每次評估亦會完整記錄:輸入、輸出、檢索到的上下文、評分及評估原因都會儲存在 S3 和我們的數據湖,形成持續的可觀測性層,讓我們追查失敗的根本原因:代理看到甚麼、生成了甚麼,以及出錯的原因。經過三個月的定向反覆改進,這份評分表推動通過率由 93 percent 提升至穩定的 96 percent:純粹幻覺由每 10,000 個回應 138 次降至少於 52 次,未經授權的計算則由 59 次降至少於 44 次,證明檢索運作正常,成效來自生成端的修正。若沒有各類別的詳細分析及其背後的追蹤資料,我們的反覆改進就只能盲目進行。
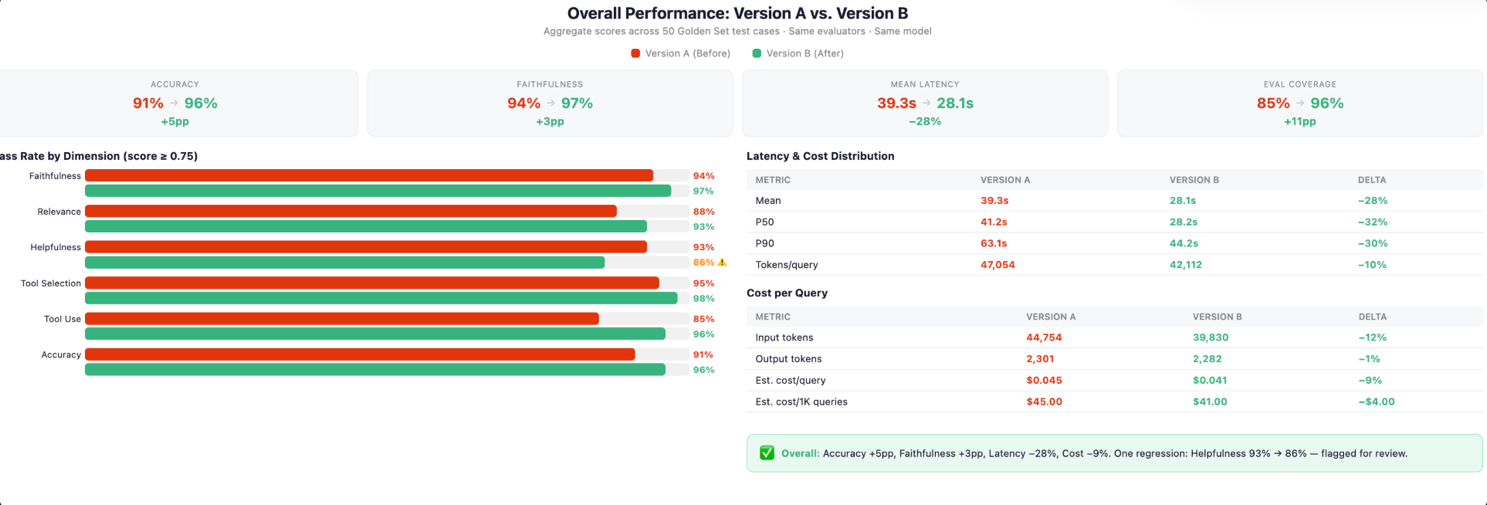
圖 4:評估評分表,展示各類別的失敗分析及通過率趨勢。圖中的數字及數值僅供示例。
第 3 階段:合併(CI)。在合併時防止回歸
第 3 階段是上線前的關卡。它在暫存環境中執行,由程式碼及設定變更觸發,目的是在不良變更進入正式環境前將其阻截。如果第 3 階段發現回歸,就不會發佈任何內容。
工程師或科學家可以透過多種方式更改系統:提示詞、底層數據、工具或模型。變更在本機看來沒有問題,測試亦通過,但改善科技業帳戶回應的提示詞,可能會在不知不覺間令金融服務業帳戶的回應變差。若沒有自動化關卡,這項變更就會進入正式環境。
我們的 CI 評估會透過 AgentCore On-Demand Evaluation,在每次部署至暫存環境時自動觸發。工程師毋須記得手動執行評估,任何部署都不能在不知情下略過關卡。評估只需數分鐘便會完成,因為它只評估哨兵集,而不是完整的黃金標準集。速度是刻意設計的:哨兵集的範圍足夠精簡,可在每次部署時執行,同時亦具代表性,能捕捉最重要的失敗。
哨兵集是經挑選的案例,涵蓋五個維度中風險最高的情境。品質回歸超出容忍範圍,就會阻止部署;違反安全界線亦會同樣被阻截。若某項變更令 p90 延遲倍增,除非經過審慎決定,否則不會繼續部署。Token 成本飆升會在大規模累積前被標示。每次哨兵測試執行後,評分都會以自訂指標發佈至 CloudWatch;品質評分、延遲、每次查詢成本及安全通過率亦會一併發佈。若任何指標超出第 1 階段的閾值,CloudWatch 警示便會觸發。每次執行亦會記錄並儲存,為第 8 階段及第 9 階段所依賴的審計追蹤提供資料。我們在每個層級都維護獨立的哨兵集:工具、代理及多代理。即使某項變更提升了代理層級的品質,卻令關鍵工具退化,仍會被阻截。哨兵集每月檢視一次;若有回歸問題流入正式環境,便會立即加入永久案例,避免再次影響用戶。
這項機制會捕捉到的一個例子。資料正規化更新後,消歧工具開始對部分帳戶名稱格式傳回未能解析的實體。Agent 收到未能解析的實體後,根據最可能的匹配結果作答,向錯誤的客戶傳回真實資料。我們的工具層級哨兵測試正好涵蓋這類邊界情況:受影響帳戶名稱格式的實體解析基準答案檢查未能通過,因此部署自動遭到阻止。這項變更從未進入生產環境。
階段 4:閘門(CD)。以量化信心交付
哨兵測試涵蓋 15 個案例。生產環境涉及數以萬計的查詢模式,橫跨數百種帳戶類型、地區和賣家分類。通過哨兵測試是必要條件,但並不足夠。
候選版本交付前,我們會使用 AgentCore On-Demand Evaluation,針對完整黃金集,按各評估維度進行評估。我們稱之為品質閘門。它以量化的交付決策,取代「看起來沒問題」的判斷。
沙盒執行與工具模擬。可以把這想成重播,而非即時呼叫。我們會預先凍結一份已知且具版本管理的工具正確行為資料集。候選版本在閘門評估期間發出的每個工具呼叫,都會被攔截,並由這份凍結資料集提供回應,而非呼叫真實系統。我們分兩個步驟建立這份凍結資料集。首先,逐一測試各項工具:向工具提供黃金集中一組保留輸入,這些輸入的正確答案已知,然後將工具實際傳回的結果與已知答案比較評分。這能在 Agent 介入前,確認工具本身是否正常運作(實體解析、檢索、SQL 生成)。其次,確認工具回應正確後,我們會將同一批經驗證的答案凍結至重播資料集,供 Agent 在閘門評估期間使用。這表示測試只評估 Agent 本身的推理能力,不受即時工具的速度或可用性影響;而且每個候選版本都使用同一份凍結資料集重播,因此直接比較的任何分數差異反映的都是 Agent,而非工具變異。
端對端綜合評分。閘門亦會進行整體評估:由完整的候選 Agent 端對端回答 200 條保留問題,並使用 LLM-as-judge 評分規準,按所有評估維度評分。以下三種情況任何一種出現,閘門都會自動關閉:整體分數較候選版本本身上一次的評估結果退步、未能勝過目前的生產環境基準,或 200 條問題中低於個別問題門檻的比例超過指定百分比。候選版本必須通過全部三項條件,才能避免簡單平均分可能掩蓋的問題:模型即使提升平均分,但若同時悄悄令更多個別問題不合格,仍不能通過。
這套機制能捕捉到的其中一個例子。模擬測試考驗的是 Agent 本身的推理能力,而不只是底層工具。我們的黃金測試集包含一個層級不匹配案例:Customer Insights Agent 和 Data Insights Agent 針對同一位客戶回傳不同的營收數字,兩者各自都正確;一個以母帳戶為範圍,另一個則以子公司為範圍。兩個數字都沒有錯。這個案例會測試 Agent 能否根據查詢的語義和提出者的角色推斷正確範圍(銷售人員可能需要子公司的數字,而管理層的查詢可能需要母帳戶的彙總數字),而不是採用預設值、取平均,或要求銷售人員消除歧義。候選版本未能通過:面對範圍限定為子公司的問題,它回傳了母帳戶層級的數字。這個案例的黃金測試集基準答案已指定問題預期的範圍,因此 Quality Gate 即時標示出不匹配:數字本身沒錯,但適用範圍錯了。
第五階段:金絲雀。捕捉部署後的靜默故障
第五階段是部署後監察機制。它會在正式環境中持續運行,使用即時流量和合成評估案例進行測試,負責捕捉那些並非由程式碼變更觸發、因此第三階段看不到的問題。第三階段防範工程師所作變更引發的問題;第五階段則防範其他所有問題,例如上游數據變動、模型行為演變、第三方依賴項變更,或只會在真實環境負載下出現的其他狀況,例如延遲增加或流量模式改變。
產品所用的數據環境由數以千計的上游結構描述和數據管道供應。每天都有數十條管道更新,卻不會觸發部署或 CI 閘門。Agent 程式碼沒有變更,模型也沒有變更,但它推理所用的數據已經改變,品質因此可能在沒有提示的情況下下降。我們曾因此付出代價:一條上游管道更新時改動了結構描述,Agent 開始引用錯誤時間範圍的數據,而我們收到的第一個訊號不是自動警示,而是銷售人員的查詢。第五階段讓我們能在第一個 30 分鐘評估時段內發現這類問題。
我們在兩種互補的排程下執行 AgentCore Batch Evaluation,而選擇這種執行頻率是經過深思熟慮的。
我們從兩方面的經驗中確定採用 30 分鐘週期:15 分鐘會產生太多誤報;60 分鐘則會令真正的品質下降要到兩小時後才被記錄。我們把每個 30 分鐘週期稱為一個評估時段。透過連續三個評估時段,系統可在 90 分鐘內捕捉到真實趨勢,同時過濾單一查詢造成的雜訊。每個時段都會從黃金測試集中輪流抽選案例評分,確保 24 小時內涵蓋全部案例。
門檻刻意設得比 CI/CD 閘門低。單一評估時段未通過是運維訊號,不是事故。只有連續三個評估時段都超出門檻,我們才會通知值班人員。我們曾因此付出代價:第一個月採用單一時段門檻時,值班人員完全不再信任這套系統。每天一次,系統會以閘門門檻執行完整黃金測試集,作為具權威性的每日評分報告。30 分鐘評估時段用來顯示趨勢;每日測試則負責確認趨勢並建立工單。
每次執行都會向 CloudWatch 發佈各項指標(準確率、幻覺率、依據率、延遲及成本),並採用可區分兩種執行頻率的警報邏輯。金絲雀測試會在三個層級執行:工具層級的評分可在檢索工具品質下降、影響 Agent 層級的回應之前,及早發現問題。
以下是另一個這套機制能捕捉到的例子。 上游索引更新後,檢索工具開始傳回相關性較弱的內容區塊,而非回答查詢所需的精確脈絡。延遲正常,錯誤率為零。Agent 仍根據依據薄弱的脈絡進行推理,產生流暢而肯定的回應;答案看似正確,引用的數字卻有誤。沒有任何基礎設施警報觸發。金絲雀測試在首個 30 分鐘時段便捕捉到問題:工具層級哨兵測試的依據率及檢索精確率下降,於賣家根據這些品質下降的答案採取行動前觸發 CloudWatch 警報。偏低的評估器分數標示出確切的問題追蹤記錄。當值工程師隨即在 AgentCore 開啟該追蹤記錄,並在幾分鐘內追查出脈絡品質下降源於檢索工具。
第 6 階段:對抗者。防範濫用
並非所有不良輸出都源自模型品質下降。為提取未獲授權的帳戶資料而精心設計的查詢,以及嵌入檢索文件中的提示詞注入,都是一個服務數以千計用戶、並處理敏感業務數據的系統中可預見的模式。
安全不是一個階段,而是貫穿全部九個階段。我們在每次互動的兩個環節套用 Amazon Bedrock Guardrails。在輸入端,我們會驗證查詢範圍並篩查提示詞注入。在輸出端,我們會確認不會向未獲授權的用戶呈現敏感資料,而且 Agent 沒有遭操控而違反政策。這些檢查會在 100% 的流量上同步執行,確保回應送達用戶前完成檢查。
我們設定兩層防護欄,各自涵蓋一類不同的威脅:
內容篩選器會偵測並封鎖輸入及輸出中的有害或不當內容。我們會在 VIOLENCE、HATE、SEXUAL、MISCONDUCT及 INSULTS等類別套用篩選器。觸發這些篩選器的請求或回應,會在送達賣家或呈現給用戶之前遭到封鎖。
提示詞安全篩選器透過單一個 PROMPT_ATTACK 防護欄類別,防範三種子類型的威脅:JAILBREAK(試圖覆寫 Agent 的系統指示或繞過其操作界限)、PROMPT_INJECTION(檢索文件、工具輸出或用戶查詢中包含的非預期指令),以及 PROMPT_LEAKAGE(試圖提取系統提示詞或內部設定)。在使用檢索增強生成(RAG)的多 Agent 系統中,透過檢索內容發動的提示詞注入確實構成風險。賣家帳戶數據中的非預期文件,可能試圖在推理過程中改變 Agent 的行為。
安全規則在第 1 階段訂明,在第 3 及第 4 階段檢查有否回歸問題,並在生產環境中持續執行。
第 7 階段:漂移。維持品質,並以即時流量驗證
品質可能因多種因素下降:上游數據變更而未觸發部署、模型逐漸過時,以及用戶透過查詢不斷試探邊界,而任何黃金測試集都無法完全預見這些查詢。第 7 階段會在賣家察覺之前偵測到這些問題,並在全面推出前,使用真實用戶流量驗證候選方案。
漂移偵測。我們使用 AgentCore Online Evaluation,持續透過第 1 階段定義的不同評估器抽樣檢查 10% 的即時流量,讓偏離離線基準的情況能即時顯現。評分會輸入 Quality-State Calculator,在同一時段監察品質、延遲和成本。
一個生產環境案例。我們以合成邊界案例建立客戶識別的黃金測試集,包括姓名變體、子公司查詢和縮寫。它在離線評估中表現良好。但在即時流量中,賣家會使用合成案例未涵蓋的股票代號(「AMZN 出了甚麼事?」)、簡稱和錯字進行查詢。Quality-State Calculator 在連續三個 30 分鐘時段中,顯示品質出現漂移:凌晨 1:30 為 98%,凌晨 2:00 為 81%,凌晨 2:30 為 80%。滾動指標跨越門檻時,CloudWatch 便向值班人員發出通知。值班工程師向代理程式查詢:「凌晨 1 時至 3 時期間,客戶識別準確率發生了甚麼變化?」代理程式提供趨勢摘要,指出股票代號查詢和簡稱是導致失準的原因。代理程式的追蹤記錄即時顯示了根本原因。解決方法是將低分的即時工作階段加入黃金測試集,並更新消歧工具,在解析前先將輸入格式標準化。準確率在下一個評估週期內回復至基準水平。
即時流量會帶動兩個持續改進循環:低分工作階段會作為新的邊界案例加入黃金測試集;低分追蹤記錄的羣組則會為提示詞修訂、工具更新和路由調整提供參考。
A/B 測試:候選代理程式通過品質門檻後,AgentCore Gateway(Amazon Bedrock AgentCore 的一項功能)會將部分真實流量分流至現有代理程式和候選代理程式。按需評估確認候選代理程式在已知案例中沒有退步;線上評估則確認它能應對只有真實用戶才會產生的長尾輸入和新穎措辭。候選代理程式必須在所有評估器維度上勝出或打和,才能全面推出。
第 8 階段:脈搏——即時掌握品質狀況
一次對代理程式的呼叫,可能涉及三個子代理程式、五種工具和兩條檢索路徑。品質警報響起時,説「代理程式管線中有些地方出問題」並不是可供執行的操作手冊。第 8 階段會將第 5、6 和 7 階段的訊號匯集至可觀測性層,提供足夠精細的資訊以便採取行動。
AgentCore Observability(Amazon Bedrock AgentCore 的一項功能)是基礎。對於託管於 AgentCore runtime(Amazon Bedrock AgentCore 的一項功能)的代理程式,每次執行都會透過 OpenTelemetry 自動加入監測,為每個推理步驟輸出結構化遙測資料,包括呼叫的工具、呼叫順序、輸入和輸出、延遲及 Token 消耗量,並以自訂指標和日誌形式直接發佈至 CloudWatch;前提是已啟用 CloudWatch Transaction Search(只需設定一次)。評估器評分則透過獨立管線處理:評分來自評估設定,而非執行監測,並寫入專屬的 CloudWatch 日誌羣組。每次評估執行的完整輸出也會儲存至 S3 和我們的數據湖,供以下兩個儀錶板使用:
- 可透過對話查詢評估和可觀測性結果的儀錶板。
- 用於趨勢分析、評分卡追蹤,以及比較完整歷史記錄中不同代理程式的 Amazon Quick 儀錶板。
最上層提供按角色設計的檢視畫面。值班工程師會看到以追蹤記錄為先的檢視畫面:只需按一下,即可從 CloudWatch 警報前往觸發警報的 AgentCore Observability 追蹤記錄。追蹤記錄會顯示每個呼叫過的工具及其呼叫次序、每個步驟的延遲、token 消耗量、成本,以及完整的推理脈絡;這些資訊足以讓人無需開啟第二個工具,就能由「警報觸發」查明「根本原因」,如圖 5 所示。
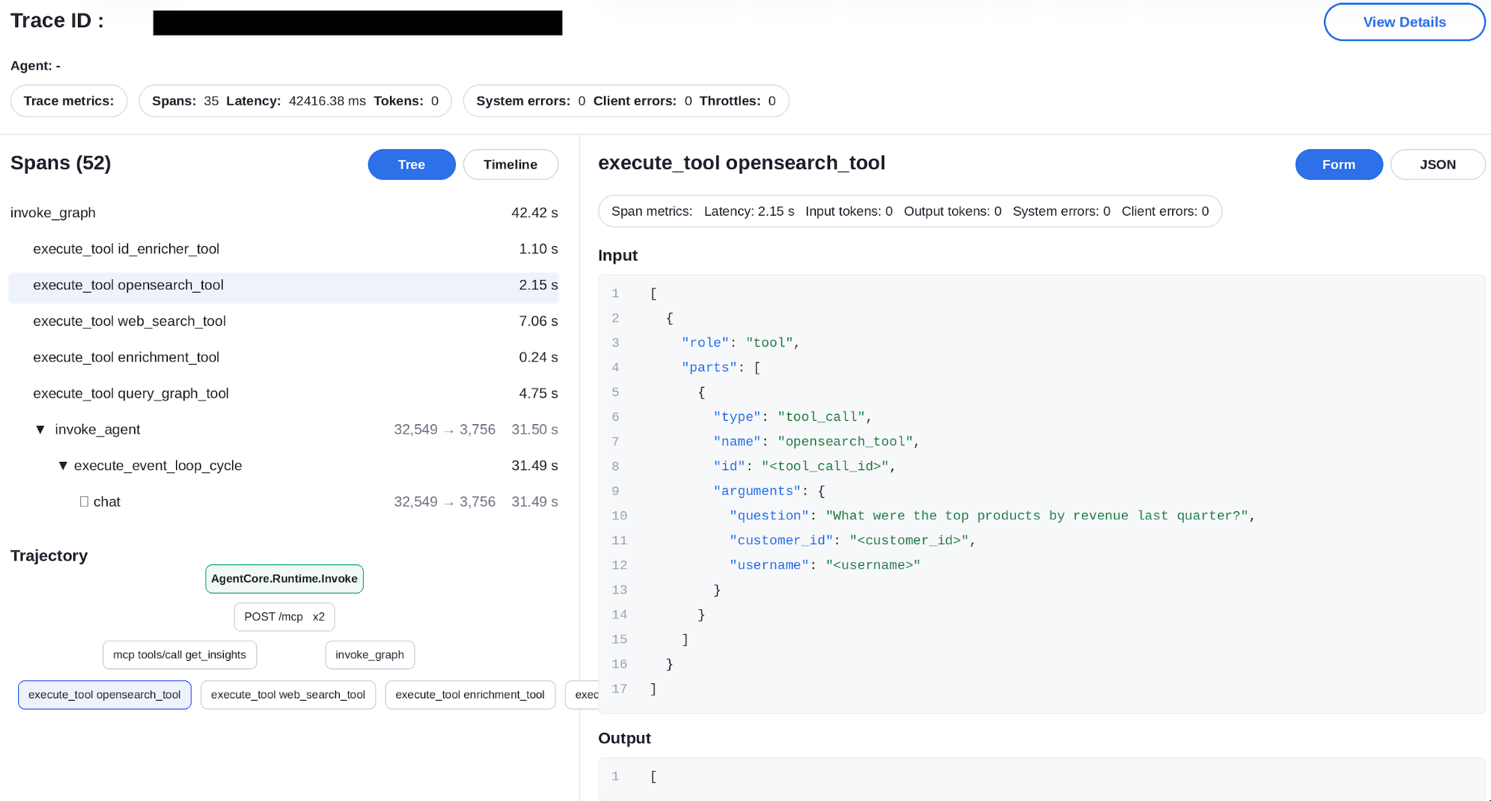
圖 5:Customer Insights Agent 的 AgentCore 執行追蹤記錄,展示 span 樹、執行軌跡及 span 層級指標。圖中的數字和數值僅供説明。
產品經理可使用 Amazon Quick 趨勢儀錶板,按子 Agent 和功能查看質素評分,並逐次比較不同版本。領導層則可透過單頁健康狀況摘要,查看與每週及跨業務檢討相符的全部五個維度;只需一分鐘快速檢查,即可回答「我們的 Agent 表現如何?」
圖 6 展示每週評估儀錶板的概覽:本週執行結果中,由自訂評估器和 AgentCore 內置評估器共同得出的合併通過率,以及延遲。圖中的數字和數值僅供説明。
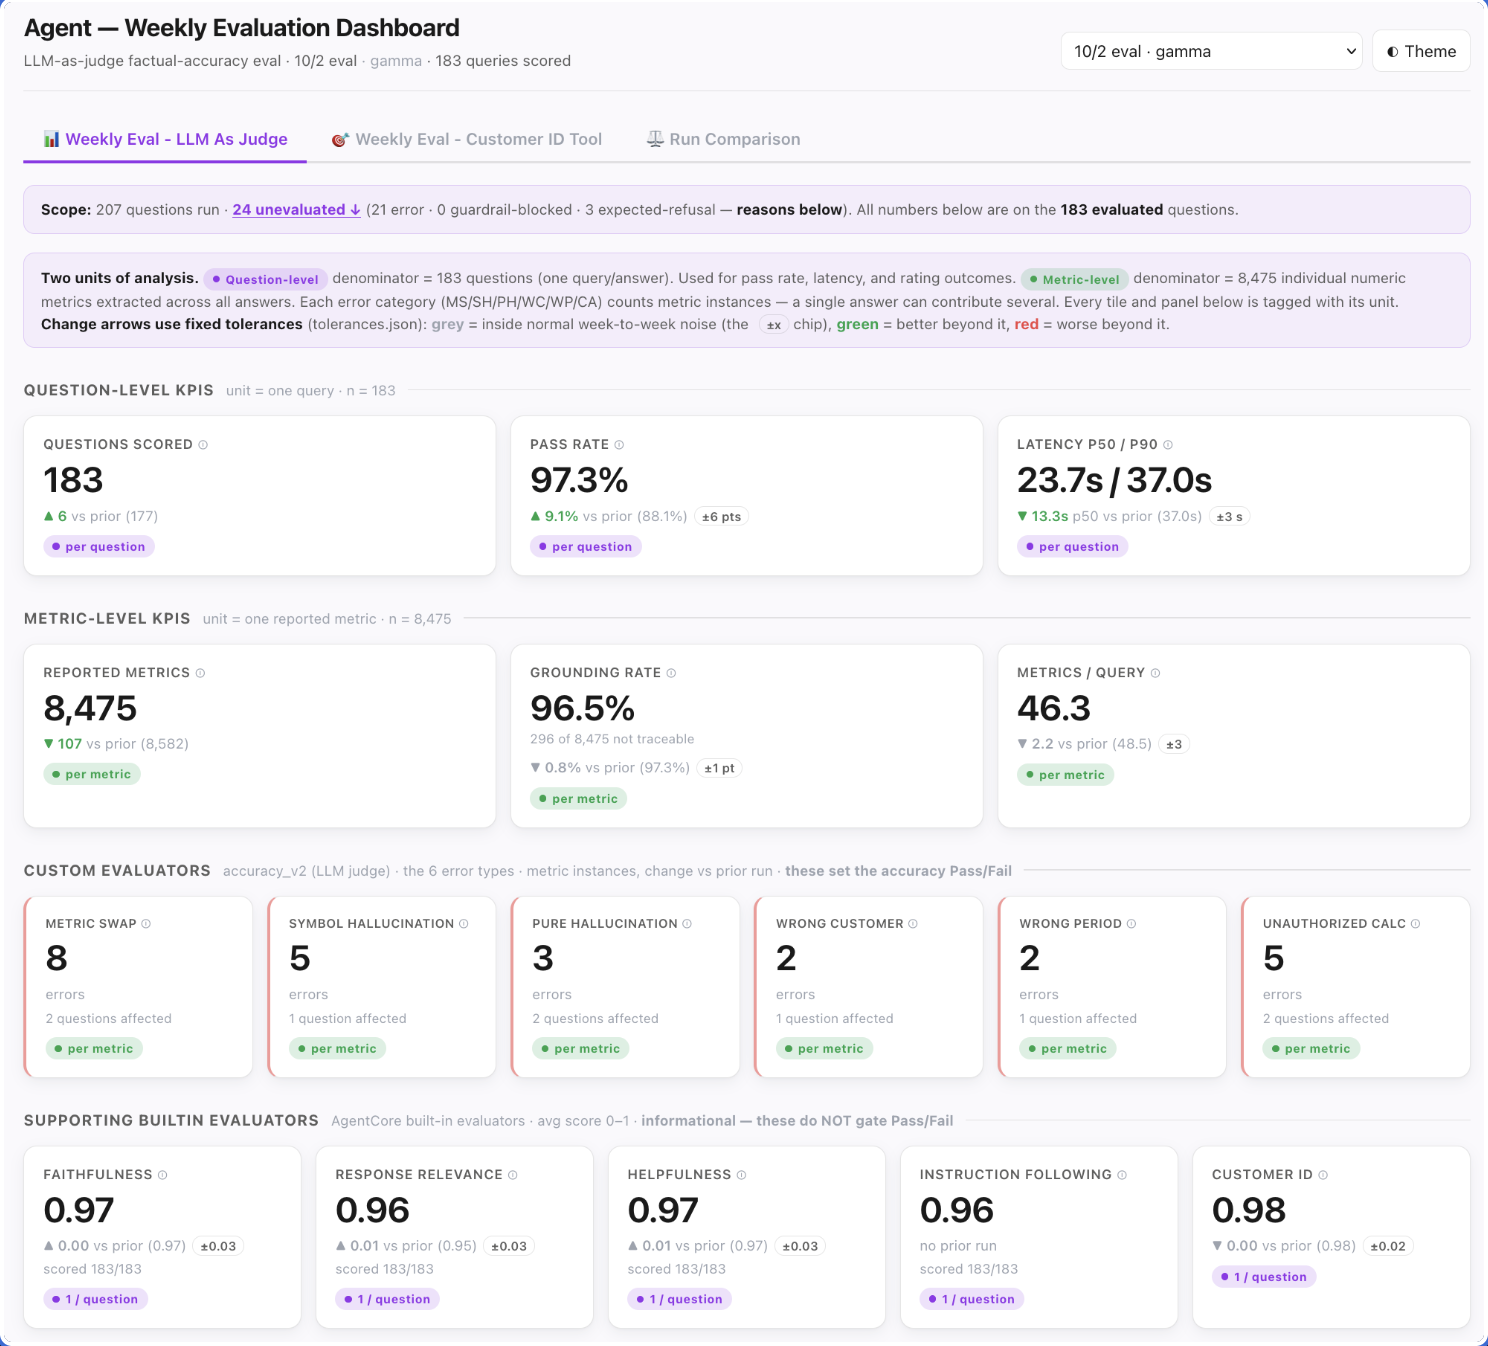
圖 6:每週評估儀錶板概覽,顯示合併通過率和延遲。圖中的數字和數值僅供説明。
圖 7 以自訂評估器的失敗類別為層級,深入分析同一次執行結果,詳細列出哪些錯誤類型(指標調換、幻覺、客戶 ID 遺漏等)導致差距,以及每種錯誤影響了多少條問題。圖中的數字和數值僅供説明。
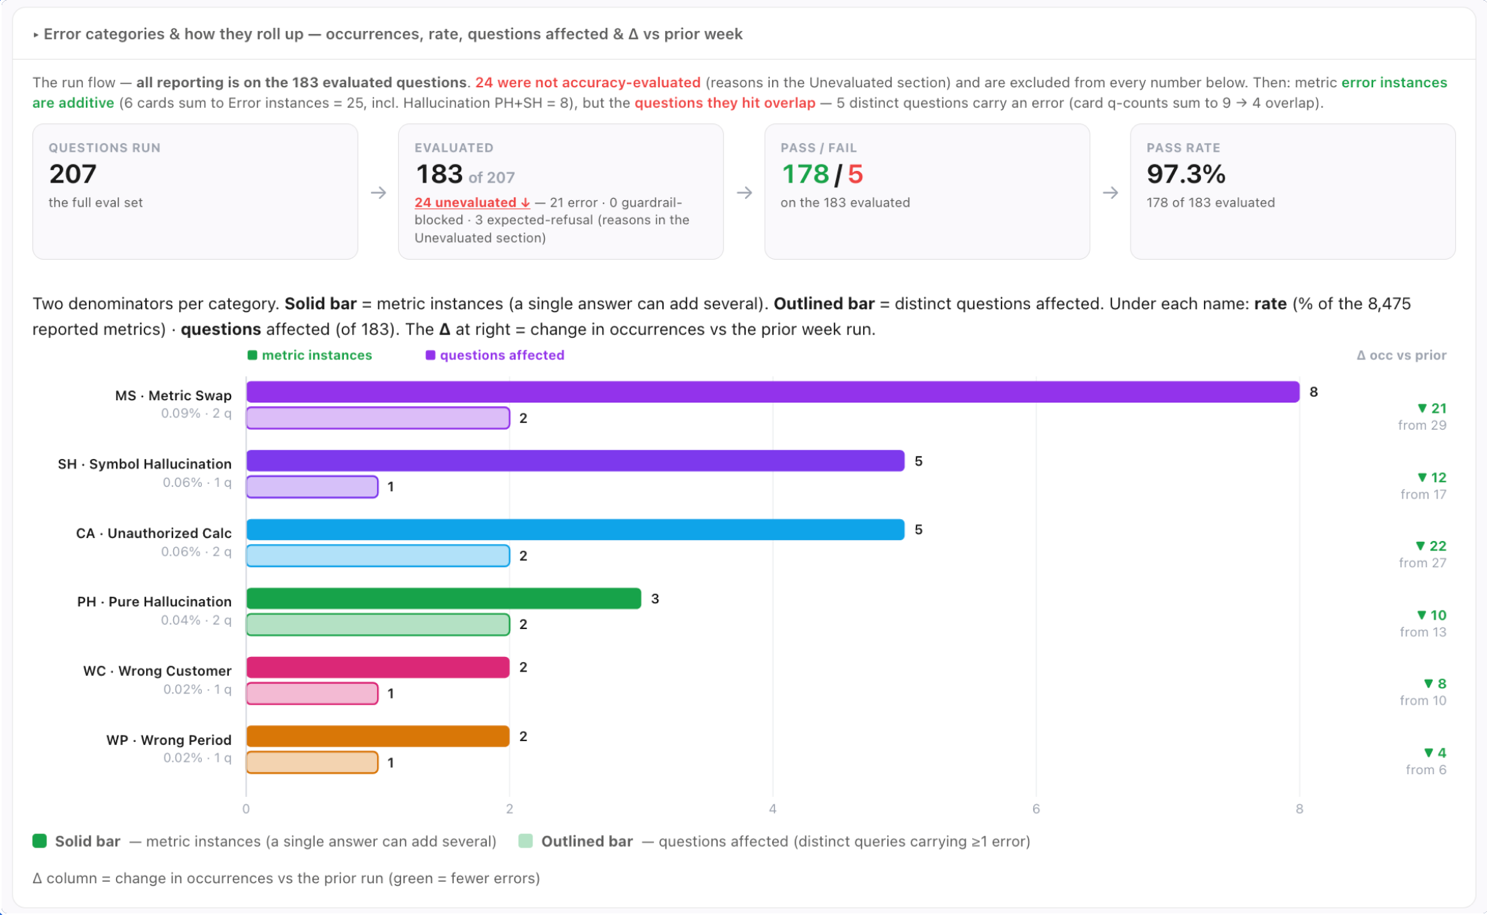
圖 7:每週錯誤報告儀錶板,按類別細分失敗情況。圖中的數字和數值僅供説明。
在第 8 階段之前,平均偵測時間(MTTD)為數天至數週。進入第 8 階段後,時間縮短至四小時內,而最先收到的訊號是附有 AgentCore 追蹤記錄的 CloudWatch 警報。
第 9 階段:回饋循環。持續改進
這個階段會將觀察結果轉化為行動,令系統的質素隨時間持續提升。我們使用 AgentCore 優化功能(Amazon Bedrock AgentCore 的一項能力)來完成這個循環。
- 系統提示詞建議:分析 Agent 追蹤記錄,並產生以數據驅動、經優化的系統提示詞,提升目標評估器的表現。此方案會利用失敗模式,加入具體的行為指示。
- 工具描述建議:分析 Agent 追蹤記錄,並產生更精確的工具描述,以減少工具選擇上的混淆。這尤其有助於減少 Agent 在面對含糊請求時選錯工具的情況。
來看一個例子:
AgentCore 優化功能實例
改進項目:
目標評估器: 幻覺:模型在無關情境中,逐字重現少樣本示例內的硬編碼值。原因:少樣本示例包含真實的金額和客戶名稱(例如「$4.2M」、「Acme Corp」),模型會記住這些內容,並在無關查詢中洩漏出來。
修正方法:將少樣本示例中的硬編碼值替換為通用佔位符(例如
$[AMOUNT]、[CUSTOMER_NAME]),讓模型學習回應結構,而不會記住特定資料點。影響和結果:已套用修正。每 10,000 次回應中的純幻覺個案由 138 次降至不足 52 次,整體內容依據率則由 93% 提升至 96%。
AgentCore optimization 利用建議,根據真實 Agent 執行軌跡及目標評估器,產生系統提示詞和工具描述的修改方案。AgentCore optimization 建基於 AgentCore Evaluations。低分執行軌跡會納入黃金集,作為永久回歸防護,避免同一失敗再次影響用戶。
Agent 評估關鍵指標一覽
評估指標於階段 1 定義,在九個階段中執行,並在正式環境中持續監察。這套指標並非一成不變。隨着我們從正式環境中的 Agent 學習,新的失敗模式會浮現,新的維度會變得可量度,指標亦會相應演進。以下是我們最初採用的指標,以及目前追蹤的項目。
| 層級 | 指標 | 衡量內容 | 追蹤方式 |
| 質素:Agent | 整體準確率通過率 | 沒有任何分類失敗的回應所佔百分比 | 主要評分卡指標 |
| 質素:Agent | 指標替換率 | 客戶及期間正確,但回傳了錯誤指標 | 每 100 個回應中的發生次數 |
| 質素:Agent | 錯誤期間率 | 來自錯誤時間範圍的數據 | 引用正確時間範圍的百分比 |
| 質素:Agent | 錯誤客戶率 | 混淆帳戶名稱或附屬公司 | 實體解析準確率 % |
| 質素:Agent | 來源依據率 | 可追溯至檢索來源的數值 | 有來源依據的回報數值百分比 |
| 質素:Agent | 範圍遵循率 | 回應有解答所提問題 | 切題回應百分比 |
| 質素:Agent | 未經授權計算率 | 未獲批准的衍生數值 | 每 100 個回應中的發生次數 |
| 質素:Agent | 相關性/忠實度/有用性 | AgentCore 內置維度所評估的回應質素 | AgentCore 內置評估器評分 (0–1) |
| 質素:工具 | 客戶識別準確率 | 工具解析至完全相符的標準實體 | 正確解析百分比(確定性) |
| 質素:工具 | 工具選擇準確率 | Agent 為查詢選擇正確工具 | AgentCore 內置評估器評分 (0–1) |
| 質素:工具 | 檢索精確率 | 檢索到的內容包含所需資訊 | 檢索結果包含相關內容的百分比 |
| 質素:工具 | SQL 生成準確率 | Data Insights Agent 生成正確 SQL | 結果集正確的百分比(確定性) |
| 質素:工具 | 工具通過率 | 回傳有效回應的工具呼叫所佔百分比 | 每項工具的成功率 |
| 質素:多 Agent | 端對端準確率通過率 | 完整協調流程產生正確回應 | 通過所有評估器的情境百分比 |
| 質素:多 Agent | 路由準確率 | 協調器將工作路由至正確的子 Agent | 路由正確百分比(確定性) |
| 質素:多 Agent | 綜合忠實度 | 合併子 Agent 輸出時沒有造成失真 | 跨 Agent 邊界的 LLM-as-judge 評分 |
| 質素:多 Agent | 上下文傳遞準確率 | 在 Agent 之間傳遞的上下文正確且完整 | 沒有上下文遺失的執行軌跡百分比 |
| 安全 | 防護欄攔截率 | 在輸入或輸出階段被攔截的請求所佔百分比 | 每 1,000 個請求 |
| 安全 | 輸入/輸出違規率 | 被標記為違反政策的查詢或回應所佔百分比 | 佔請求/回應總數的百分比 |
| 安全 | 防護欄延遲 | 防護欄檢查增加的延遲開銷 | p99(目標:低於 50ms) |
| 效能 | 端對端延遲 | 由收到查詢至送出回應所需時間 | p50、p90、p99 |
| 效能 | 各子 Agent/工具延遲 | 各子 Agent 及各工具的執行時間 | 分別計算 p50、p90、p99 |
| 效能 | 延遲回歸率 | 超出階段 1 延遲門檻的 CI 執行 | CI 執行百分比 |
| 成本 | 每次查詢成本 | 每個端對端用戶請求的 token 總成本 | 輸入 + 輸出 token 數 × 價格 |
| 成本 | 每次成功回應成本 | 每次查詢成本除以通過率 | 懲罰成本高昂的失敗 |
| 成本 | 每次查詢的平均工具呼叫次數 | 推理效率。呼叫次數上升表示效能下降 | 每次查詢的平均值 |
| 營運控制 | MTTD / MTTR | 按失敗類別計算的偵測及補救時間 | 小時(MTTD 目標:少於 4h) |
| 營運控制 | 自動化偵測率 | 評估偵測到的事故數量與用戶投訴數量的比較 | %(目標:高於 95%) |
| 營運控制 | 警報誤報率 | 沒有對應實際效能下降的警報 | 佔警報總數的 % |
結論
九階段 Agent 評估框架帶來的影響具體而且可量度。以往需要數天或數星期才會浮現、而且通常要等賣家投訴才會發現的品質倒退,如今可由自動評估在四小時內發現。以往依賴主觀判斷的部署決策,現在要求每個評估器都通過量化門檻。提示詞迭代週期由數天縮短至數分鐘。安全防護由定期審核轉為每個請求均覆蓋 100% 防護措施。延遲惡化會在 CI 閘門被發現,避免影響正式環境。以往要到數星期後查看帳單才會發現的成本意外,如今會在第 2 階段評估,並在變更發佈前由品質閘門把關。而「代理程式流程中的某個環節出了問題」如今只需按一下,就能從 CloudWatch 警報查看完整的 Agent 執行追蹤記錄,當中每個推理步驟一目瞭然。
業界早已學過這一課。DevOps 教會我們,未經自動化測試便發佈程式碼是魯莽之舉。MLOps 教會我們,部署模型而不進行監控很危險。AgentOps 對 AI Agent 帶來同樣的啟示:沒有持續、多層次評估便運作 Agent,就如盲目飛行。
本文介紹的九階段框架並非只適用於銷售情報 Agent。部署多 Agent 系統的團隊,無論系統會進行推理、呼叫子 Agent 和工具,還是整合回應,都會在相同的生命週期中面對這些問題。你的失效分類會有所不同;你的黃金數據集會反映所屬領域;你的評估器組合會按用戶需求調整。不變的是這項原則:評估不是最後一道 QA 步驟,而是 Agent 本身的運作系統,持續量度、自動防護,並透過每次互動不斷改進。
如果你正在建構供正式環境使用的 Agent,並希望為系統引入這種嚴謹的評估方式,Amazon Bedrock AgentCore Evaluations 可提供所需的平台:用於實驗的隨選評估、用於持續監控的批次評估、用於即時流量的線上評估、內置及自訂評估器、數據集評估(公開預覽)、CloudWatch 整合,以及 AgentCore 的最佳化功能,包括用於完善反饋循環的建議和 A/B 測試。從第 1 階段開始,為你的 Agent 界定理想表現的標準,其餘交由框架處理。
準備好開始了嗎?請參閲 Amazon Bedrock AgentCore 文件中的 評估 Agent 效能。如果你正在建構供正式環境使用的 Agent,並希望探討如何將此框架應用於你的系統,我們樂意提供協助。歡迎直接聯絡我們,或透過你的 AWS 帳戶團隊聯絡我們。
如要進一步瞭解 Amazon Bedrock AgentCore Evaluations,請參閲 AWS 文件中的評估代理效能。如要閲讀技術介紹,請參閲使用 AgentCore Evaluations 建立可靠的 AI 代理。如要了解我們如何建構 Performance Insights Agent,請參閲AWS SMGS 如何運用 Amazon Bedrock AgentCore 的 AI 對話助理轉變業務管理。如要了解 AgentCore 的建議與最佳化功能,請參閲AgentCore 最佳化:透過建議和 A/B 測試改進代理品質循環
致謝
我們衷心感謝各位行政贊助人和導師,正是他們的願景與指導,讓這項計劃得以實現:Damien Forthomme,應用科學經理 III;Akhand Singh,數據工程主管;Sujit Narapareddy,AWS Insights 總監;Monica Jain,高級 技術產品經理,以及 AWS AI 產品管理高級經理 Norman Braddock;Muhammad Umar Javed,應用科學家 III,L6。
關於作者

Rui Li
Rui 是 AWS Sales, Marketing, and Global Services (SMGS) 的應用科學家。她負責研究如何令 AI 代理值得信賴,讓 AWS 銷售人員、領導層和客戶能放心依賴這些代理。她的工作涵蓋比較代理評估方法和最佳化方式,並將其轉化為可擴展、可重用的評估框架,支援在生產環境中負責任地使用多代理 AI。AWS 各團隊均可採用這套框架,全面檢查代理品質、放心推出更新,並在客戶察覺問題前及早發現。透過將評估與持續改進連結起來,她的工作令 AWS AI 代理隨時間變得更準確可靠,並建立客戶對 AWS 作為生產級代理式 AI 平台的信任。

Chandana Srinivas
Chandana 是 AWS Sales, Marketing, and Global Services (SMGS) 的高級產品經理。她負責制定策略並交付代理式 AI 產品,讓 AWS 銷售人員和領導層能大規模獲取可信賴的客戶洞察。她負責的產品組合包括以知識圖譜和自然語言查詢系統構建的客戶洞察代理。她亦負責推動這些產品的代理評估策略。

Mihir Gadgil
Mihir 是 AWS Sales, Marketing, and Global Services (SMGS) 的高級數據工程師,專長於企業級數據解決方案和生成式 AI 應用程式。他擁有超過 9 年經驗,並持有資訊科技與管理碩士學位,專注於建構穩健的數據管道、複雜的數據模型,以及 ETL/ELT 流程。他的專業知識透過創新的數據工程解決方案和先進分析能力,推動業務轉型。

Alok Singh
Alok 是 AWS 資深軟件開發工程師,專門建設可擴展的基礎設施、網絡服務和 AI/ML 方案。他擁有超過 12+ 年經驗,曾設計多個可投入正式環境使用的系統,包括一個建基於 Amazon SageMaker 的端到端 ML 平台,讓數據科學家可在一星期內將模型部署至正式環境;為 AWS 銷售團隊開發代理式 AI 方案;以及一個為全球 AWS 客戶處理數十億個事件的大規模計費系統。他的專業範疇涵蓋分佈式系統、雲端架構和生成式 AI,並專注透過創新的工程方案帶來可衡量的業務成效。

Madhu Samhitha Vangara
Madhu 是 AWS 全球生成式 AI 專業解決方案架構師,專注於 Amazon Bedrock AgentCore 和 Strands Agents 的代理式 AI 市場推廣策略。她深入瞭解企業業務價值,並曾在 Juniper Networks、VMware、Barclays 和 IGCAR 累積業界經驗。她將新興 AI 能力和研究成果轉化為客戶可衡量的成效。她曾在 AWS re:Invent、NVIDIA GTC 和 AI Summit 等 AI 會議演講,專長包括 Agent 優化、代理式工作負載、合作夥伴網絡,以及可投入正式環境使用的代理式 AI。她持有 UMass Amherst 計算機科學碩士學位。工作以外,她受過印度古典舞蹈訓練,亦熱愛藝術。

Bharathi Srinivasan
Bharathi 是 AWS 資深生成式 AI 數據科學家。Bharathi 與企業客戶合作,應對大規模生成式 AI 挑戰,包括非確定性系統的穩健性與驗證、GenAI 和代理式 AI 平台的治理,以及動態代理式 AI 系統的質素。
來源:AWS Machine Learning Blog · aws.amazon.com