Property Finder 如何修正 Amazon Bedrock 評測偏差並降低模型成本
Fix evaluation bias to unlock better models on Amazon Bedrock
Property Finder 評估將視覺 AI 工作負載遷移至 Amazon Bedrock 時,發現 96.8% 的評測標籤直接沿用單一模型預測,因而重新建立專家標註的評測集。
文章以房地產影像分類案例,説明專家標註、多標籤設計和逐輪提示詞優化如何減少評測偏差,並讓不同模型的比較更貼近實際正確性。
本文由 Property Finder 的 Khaled Thabit、Meriem Boughrara 和 Mohamed Desouky 合著。
數碼房地產應用程式 Property Finder 的工程團隊發現,他們的評估標籤中有 96.8% 直接沿用單一模型的預測,未經人類專家核實。其真實標註系統性地偏向現有模型,令所有替代方案看起來都表現較差。標籤本身也有錯誤,但偏差才是阻礙客觀比較模型的原因。他們在將視覺 AI 工作負載遷移至 Amazon Bedrock 上成本效益更高的方案時,發現了這個問題。
Property Finder 每天在中東和北非(MENA)處理數以萬計的房地產圖片。其系統會評估每張圖片的 11 項質素屬性,包括浮水印偵測、房間分類、傢具配置狀態、相片質素和建築指標。每天新增數以千計的房地產放盤,每個放盤平均有 15 張圖片。所有圖片都需要在上架前進行質素評估。
Property Finder 需要一個成本效益更高的方案。但以這些標籤作衡量,任何替代方案都處於劣勢。
最棘手的地方不是找出更好的模型,而是發現評估方法本身才是障礙。
本文分享 Property Finder 如何找出評估偏差、建立無偏差的真實標註,並運用進化式提示詞最佳化,在 Amazon Bedrock 上選出合適的模型,以低 86% 的成本達到更高準確度。我們會介紹所用的方法和迭代示例,並分享可應用於你自己的工作負載的經驗。
下圖展示 Property Finder 與 AWS Generative AI Innovation Center 團隊所用的提示詞最佳化循環,透過反覆迭代提升 Amazon Bedrock 上的分類準確度。
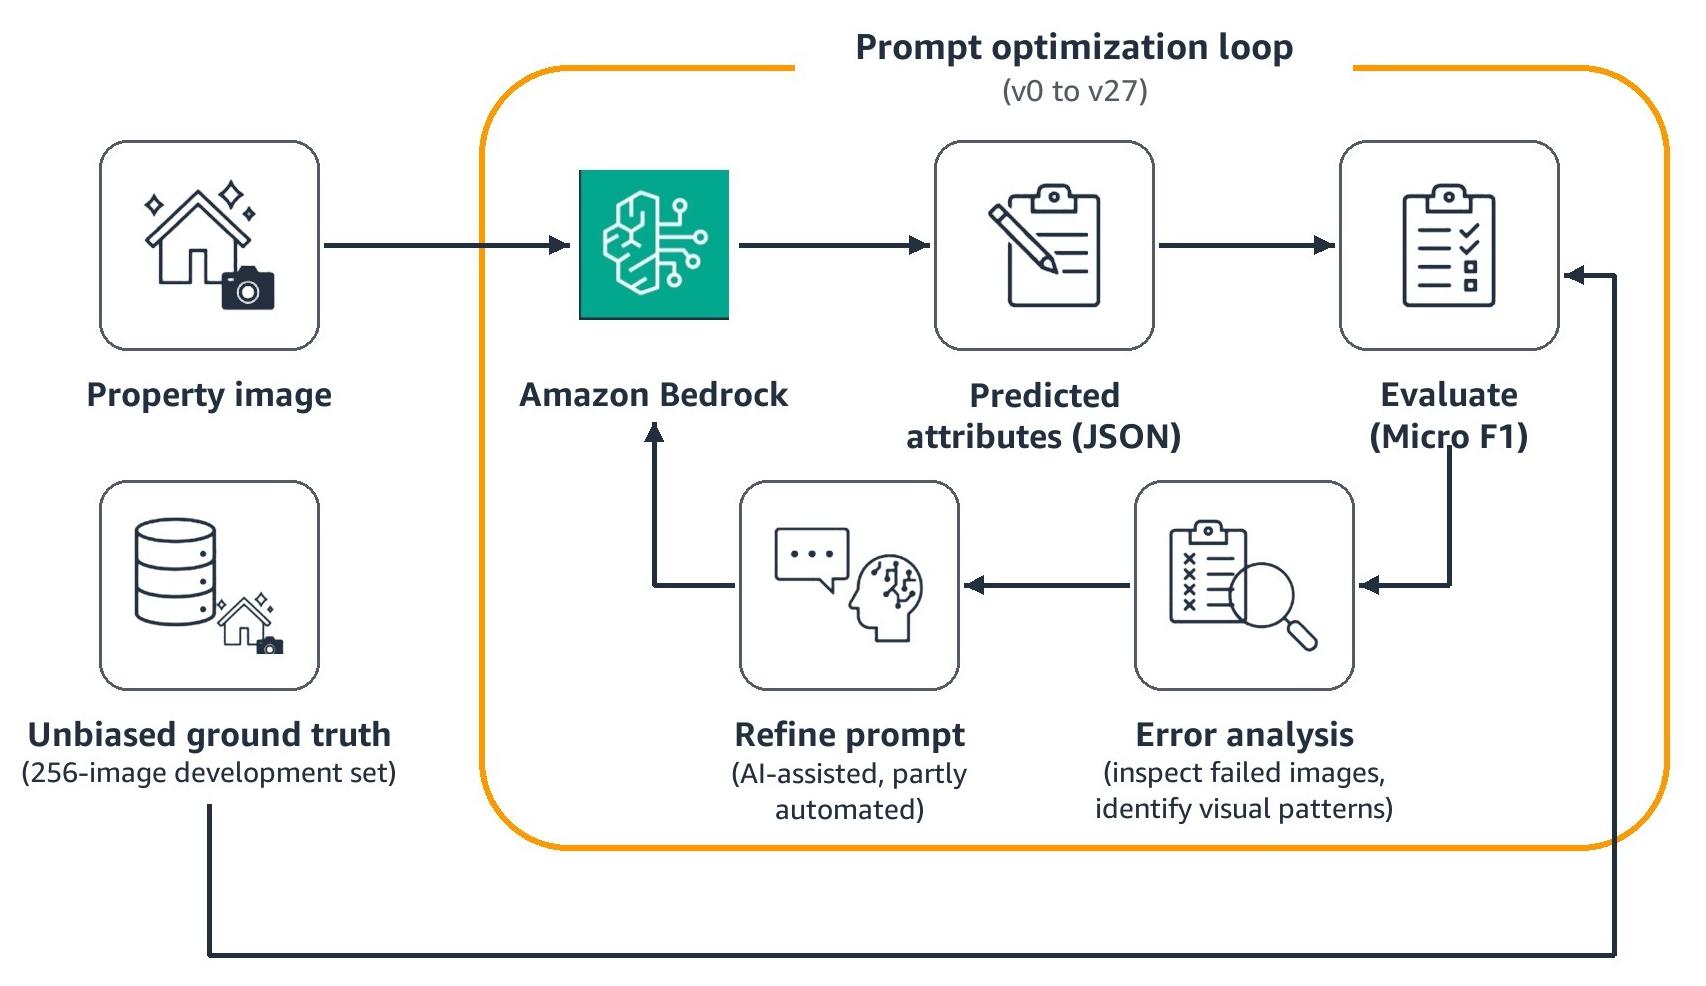
圖 1:提示詞最佳化循環架構
圖中展示了反覆迭代的提示詞最佳化循環。系統將房地產圖片輸入 Amazon Bedrock,並以 JSON 格式輸出預測屬性。最佳化期間,系統會以 256 張由專家標註的開發集圖片為基準,使用 Micro F1 為這些預測評分。接着,錯誤分析會檢查分類失敗的圖片並找出視覺模式,據此制定下一個版本的提示詞。循環由 v0 迭代至 v27。AI 助手協助改進提示詞,後期版本則採用自動化最佳化。
你的評估可能在説謊
不少團隊都遇過這種情況:你想比較視覺模型,於是建立評估數據集。最常見的標註方法,是執行目前使用的模型,並將其輸出當作真實標註。這個模型一直在正式環境中運作,也沒有人投訴,所以這些標註應該夠準確。
但這樣做會形成循環式評估:任何替代方案都會按它與現有模型行為的相似程度接受評判,而非按實際正確性評判。
Property Finder 的評估數據集正正有這個問題。在所有已標註樣本中,96.8% 直接來自現有視覺語言模型(VLM)的預測,而非經過獨立的人類核實。任何替代模型甚至在處理第一張圖片之前,就已在評估方式上處於結構性劣勢。
隱藏錯誤證實了問題的嚴重性。浮水印文字擷取中,字元層級的錯誤被標記為正確,包括虛構的品牌名稱和漏字。照片分類則強行為包含多種房間類型的圖片指定單一標籤。
在人手標註的樣本中,剩餘 3.2% 的樣本出現了標註者自行加入、超出原始規格的類別,例如提示詞中沒有 Office 標籤,標註時卻出現了這個類別。若答案標準由你想要取代的模型所制定,模型比較便失去效力。
建立值得信賴的真值資料
要打破這個循環,需要具備實際領域知識的人類專家,獨立重新進行標註。他們不參考之前的模型輸出,也無法查看現有模型的預測結果。
數據集範圍
Property Finder 團隊以人工標註了 356 張阿聯酋圖片,以及另一組埃及圖片。團隊從涵蓋具代表性的行業範疇、尚未標註的實際房源中挑選這些圖片。本文報告阿聯酋圖片的結果。埃及圖片用於跨地區檢查,共 230 張,本文不會報告相關結果。最先完成標註的 256 張阿聯酋圖片構成開發集,用於調校。最終模型比較所用的評估集涵蓋全部 356 張圖片,當中包括開發階段測試後標註的 100 張圖片。356 張圖片大致足以偵測模型之間中等程度的差異。個別屬性中的罕見類別樣本較少,因此可能無法偵測這些屬性上的較小差異。
專家標註
一位策略及分析專家標註了所有圖片。這位專傢俱備房地產房源質素標準方面的專門知識。AWS Generative AI Innovation Center 團隊透過專門的釐清會議,進行系統性的質素審查。這些審查釐清了模糊個案,並確保整個數據集的標註一致。
轉用多標籤分類
房地產圖片經常透過門口展示多個房間,或同時呈現多種重疊的質素特徵。由單標籤分類轉為多標籤分類,紓緩了主要的人為模糊問題。
一張透過門口拍到睡房的走廊照片,確實同時屬於這兩類。容許使用多個標籤後,便能評估模型答對了甚麼,而非因為它提出合理的次要預測而扣分。
混合式方法亦可補充這套方法:由不同模型系列提出候選標籤並找出分歧,再由人類專家裁定每個個案,因此不會直接將任何模型輸出用作標籤。這可減輕日後擴充數據集時的標註負擔。
指標選擇
微平均 F1 是主要指標,因為它對每項預測給予相同權重,符合業務上追求整體標籤正確性的目標。報告亦列出宏平均 F1,因為微平均 F1 受常見類別主導,可能掩蓋模型在罕見屬性上的弱項。各標籤的精確率和召回率有助找出特定的失誤模式。每個樣本的交並比(IoU)用來衡量每張圖片的預測標籤與專家標籤的重疊程度。九項單標籤屬性(例如旋轉或浮水印偵測)每張圖片只有一個正確答案。AWS 團隊亦以完全匹配準確率評分,即答案與專家標籤相符的圖片比例。
將提示詞最佳化視為強化學習
採用無偏評估後,你便可以開始改進。無法正確衡量的事物,就無法改進。
最佳化流程遵循一個類似強化學習的循環。你可以把每個提示詞版本視為一個 Agent,把 Micro F1 評分視為獎勵訊號,並把錯誤分析視為改進方向的梯度。這個概念與 GEPA (Genetic-Pareto reflective prompt evolution) 相似:對提示詞組件進行變異、評估適應度、選出存活者,然後反覆迭代。在這次合作中,AWS 團隊主要根據錯誤分析精煉各個版本,並由 AI 助手檢視分類失敗的圖片、提出修改建議。
MIPROv2 是 DSPy 程式庫中的自動化提示詞最佳化框架,為 v27 的圖片分類任務補充了這個手動流程。
起點
第一個提示詞(v0)使用通用的分類指示,以下為簡化示例:
「將這張圖片分類為以下其中一個類別:客廳、廚房、睡房、浴室……」
Property Finder 的專有模型 A 是正式環境的基準模型,在包含 256 張圖片的開發集上取得 0.55 的 Micro F1。它使用為其模型系列調整的提示詞 v22。v21 之前的評分採用較早的單標籤設定,因此不能直接比較。
逐次迭代
AWS 團隊在多個候選模型上測試早期版本,並加入結構化輸出格式及針對不同屬性的定義。
最具啟發性的修正來自圖片層級的錯誤分析。在早期的單標籤版本中,模型總是把透過門口可見的房間分類為次要房間類型。AWS Generative AI Innovation Center 團隊加入明確指示,要求根據佔據畫面大部分的房間進行分類。其後改用多標籤輸出,保留主要房間作為一個標籤,並容許把透過門口可見的房間列為其他標籤。
地區化調整帶來了下一步提升。在某些地區,房源照片上會有裝飾性的阿拉伯文字疊加圖案,但這些並非浮水印。針對這類文字制定規則後,整個類別的誤報都得以消除。
v21 提示詞將圖片分類和房間類別改為多標籤輸出,並成為所有模型共用的起始提示詞。使用這個提示詞時,Meta 的 Llama 4 Maverick 17B Instruct 在開發集上取得 0.75 的 Micro F1。此後,AWS 團隊分別調整各模型的提示詞。對這個模型而言,v24 著重處理房間大小估算過高、多標籤處理及輸出格式問題。接著,自動最佳化的 v25 將關鍵任務移到前面。到了 v27,MIPROv2 重新整理了圖片分類任務,模型在該任務上的 Micro F1 達到 0.76。
終點
最終提示詞 v27_PF 是在 v27 的基礎上,加入 Property Finder 為渲染圖、帶有邊框或相框的圖片,以及走廊制定的規則。與 v27 一樣,它保留了阿拉伯文字規則和輸出格式指示。每次模型呼叫後的正規化步驟,會處理剩餘的格式差異。
使用 v27_PF 時,Llama 4 Maverick 17B Instruct 在包含 356 張圖片的評估集上取得 0.80 的 Micro F1;專有模型 A 使用 v22 時則取得 0.56。評估集包含 256 張開發圖片,而兩個模型的提示詞都曾根據這些圖片進行調整。因此,這些分數偏樂觀。
由專有模型 A 轉用 Llama 4 Maverick 17B Instruct,並為兩者各自使用調整過的提示詞,令開發集上的 Micro F1 由 0.55 升至 0.81,相對提升 47%。
失敗做法的經驗教訓
並非所有做法都成功。2-bucket 做法把浮水印屬性和其他屬性分開,分別透過兩次 API 呼叫處理,未有帶來明顯的準確度提升。帶框圖片偵測的表現亦大幅下降。如果提示詞沒有包含浮水印屬性,模型便會把浮水印疊層誤認為圖片邊框。
無論使用哪個模型,通用提示詞都無效。房地產圖片的領域特性太強,無法單靠一套通用指令處理。
結果:成本、準確度及速度
AWS Generative AI Innovation Center 團隊使用不偏不倚的評估框架,在 Amazon Bedrock 上評估多個模型。所有模型均以共用的 v21 提示詞起步,然後在開發集上按各自的模型系列進行調整。專有模型 A 經過一輪調整,使用 v22。Llama 4 Maverick 17B Instruct 則經過多輪調整,使用 v24 至 v27,並加入 Property Finder 的邊界案例規則,因此投入了更多調整工作。最終與專有模型 A 的比較使用了 356 張圖片的評估集。Property Finder 根據 11 項屬性的整體準確度及成本效益,為其正式環境工作負載選用了 Llama 4 Maverick 17B Instruct。有關各 AWS 區域的模型供應情況,請參閲 Amazon Bedrock 各 AWS 區域支援的模型。
下表列出 Llama 4 Maverick 17B Instruct (v27_PF) 在 356 張圖片的評估集上,各單一標籤屬性的完全匹配準確度。九項屬性中有六項的得分達到 90% 或以上,而且在全部 11 項屬性上均與專有模型 A 持平或表現更佳。在每張圖片可有多個標籤的照片分類項目中,兩者得分相同。
| 屬性 | 完全匹配準確度 |
| 旋轉偵測 | 100% |
| 人物偵測 | 97% |
| 帶框圖片偵測 | 97% |
| 浮水印偵測 | 94% |
| 渲染偵測 | 93% |
| 傢俱狀態 | 91% |
| 房間是否正在施工 | 81% |
| 房間大小 | 65% |
| 浮水印文字擷取 | 55% |
每 1,000 張圖片的成本
Property Finder 每天為數以萬計的圖片評分,因此每張圖片的成本十分重要。Llama 4 Maverick 17B Instruct 是具成本效益的開放權重模型,而且處理管線只需一次呼叫,便可取得一張圖片的所有屬性。
| 結果 | 數值 |
| 每 1,000 張圖片的估計成本 | $2.35 |
| 與 Property Finder 之前的設定相比,成本減幅 | 86% |
這些數字是截至 2025 年 12 月在美國東部(俄亥俄州)區域的估算。Llama 4 Maverick 17B Instruct 的數字以每張圖片 9,000 個輸入 token 和 200 個輸出 token 計算,取自原本兩次呼叫的成本分析。使用正式環境提示詞進行單次呼叫時,約需 7,500–8,000 個輸入 token,因此這是上限估算。86% 的減幅是與 Property Finder 之前使用 v21 提示詞的設定之成本分析估算相比。準確度比較使用的是由 v21 調整而成的 v22,因此成本可能不同。如需瞭解最新價格,請參閲 Amazon Bedrock 定價。
推理速度
Property Finder 在生產環境中運行這條經過最佳化的流程,每日使用 Amazon Bedrock 上的 Llama 4 Maverick 17B Instruct 處理數以萬計的圖片。根據其自行監測的結果,Property Finder 發現與先前的設定相比,推理延遲降低了 40–60%。
將此方法應用於你的工作負載
先審核評估標籤。如果這些標籤來自模型預測,而非人類專家,你也會面對 Property Finder 發現的同一類偏差問題。
為數百個具代表性的樣本建立由領域專家標註的基準真值,並保留一個不會用於調整的獨立測試集。如果分類任務涉及互相重疊的屬性,請採用多標籤評估指標。然後,透過圖片錯誤分析反覆調整提示詞,並將每次迭代視為演化式最佳化循環中的一代。
部署這類流程時,請加入負責任 AI 管控措施。例如,你可以使用 Amazon Bedrock Guardrails 執行內容政策,並過濾不當的模型輸出。這條流程中的屬性預測沒有附帶經校準的信心分數,因此可採用實用訊號,挑選需要人工審查的圖片。模型之間的意見不一致便是其中一種訊號。當兩個模型對某項屬性給出不同答案時,圖片往往含糊不清。對每張圖片都使用第二個模型會增加成本,因此可以先抽取樣本。在依賴這項訊號之前,先檢查它在開發集上能多常發現實際錯誤。
結論
本文介紹了 Property Finder 如何找出評估偏差、建立無偏差的基準真值,並運用演化式提示詞最佳化,在 Amazon Bedrock 上透過模型選擇以較低成本取得更高準確度。
這項成果有賴三個要素共同配合:透過無偏差評估誠實衡量成效;無須重新遷移平台即可評估並切換不同模型系列的靈活性;以及經過仔細演進、針對領域調整的提示詞。Amazon Bedrock 提供了所需基礎,讓 Property Finder 可透過單一 API 使用多個模型系列,沿用 AWS 的治理和安全控制措施,並在新模型推出時採用,而無須更改其基礎設施。
如要開始在 Amazon Bedrock 上進行模型評估和選擇,請瀏覽 Amazon Bedrock 説明文件。如果你需要大規模處理視覺工作負載,並希望建立無偏差的評估框架,請聯絡 AWS Generative AI Innovation Center。
歡迎在留言中分享你在模型評估和提示詞最佳化方面的經驗。
致謝
AWS 的其他貢獻者包括 Yousuf Albannai、Amine Sehili、Thomas Ounnas、Aris Tsakpinis、Rafik Soliman、Nikhil Ulhas Pandit 和 Sneh Sharma。
關於作者

Khaled Thabit
Khaled Thabit 是 Property Finder 的數據工程總監,負責領導公司的數據和 AI 策略。他熱衷於運用 AI 和數據,塑造中東和北非(MENA)房地產市場的未來。

Meriem Boughrara
Meriem Boughrara 是 Property Finder 的資深數據工程師,負責領導整個平台的 AI 和數據工程計劃。她監督 AI 驅動方案的項目交付,並與跨職能團隊緊密合作,將方案投入生產環境。

Mohamed Desouky
Mohamed Desouky 是 Property Finder 的數據工程師,負責建立和維護數據管道,為 MENA 各市場由 AI 驅動的房源質素系統提供支援。他樂於構建可擴展的數據解決方案,帶來可量化的業務成效。

Mina Metias
Mina Metias 負責管理 AWS Generative AI Innovation Center 在 MENA 地區的團隊,統籌客戶合作項目,涵蓋需求探索至投入生產部署,並支援交付可量化的業務成果。

Vadim Selyutin
Vadim Selyutin 是 AWS Generative AI Innovation Center 的高級數據科學家。他為客戶合作項目提供技術領導,與各機構合作,設計、構建和交付生成式 AI 解決方案,涵蓋構思至投入生產部署。

Mohamed Noordeen Alaudeen
Mohamed Noordeen Alaudeen 是 AWS Generative AI Innovation Center 的數據科學家,負責構建和部署生成式 AI 解決方案,為各行業的企業客戶解決實際業務問題。他樂於應對複雜的技術挑戰,並將其轉化為可投入生產的解決方案。
來源:AWS Machine Learning Blog · aws.amazon.com