Amazon SageMaker AI 上如何以實測設定 TTS 自動擴縮容目標
Stop guessing auto scaling targets for TTS on Amazon SageMaker AI
AWS 示範在 Amazon SageMaker AI 即時端點部署 Kokoro-82M,並以實測取代 TTS 自動擴縮容目標的猜測。在 ml.g5.xlarge 上,Q_max 為 50;實際擴容耗時為 260.2 秒,另計入按政策設定界定、未經本次測量的 60 秒偵測延遲,規劃 T_total 為 320.2 秒。
文章以單機可承受併發量和實際擴容耗時兩項測量,推導 TTS 端點的擴縮門檻與冷卻時間,並展示 Kokoro-82M 的部署流程。
自行託管的文字轉語音(TTS)端點流量突然激增,請求開始排隊。最多用戶正在收聽時,延遲升至服務水平目標(SLO)以上。這個端點背後的自動擴展策略原本應可避免這種情況,但用來觸發擴展的目標值只是估算;這類估算往往悄然失準,直到真實流量證明它有誤。
如果這個數字估錯,代價會以兩種方式之一齣現,而且兩者都不會觸發警報。估得過於保守,GPU 執行個體便會大多閒置。這筆成本會出現在每張帳單上,卻不會觸發事故報告。估得過於進取,整個執行個體羣便會承受無人察覺的風險。每個執行個體承載的並行請求數,超出其在延遲承諾範圍內可處理的數量。直到真實流量激增,令排隊時間超出 SLO,問題才會浮現;而這正是最多用戶正在收聽的時候。這就是隱藏的落差。在主控台上看似正常的策略,可能早已無法滿足它原本應服務的用戶。
本文會把一個擁有 82 million 個參數的 TTS 模型 Kokoro-82M,以自訂容器部署至 Amazon SageMaker AI 即時端點。部署由 AWS Cloud Development Kit (AWS CDK) 堆疊負責。我們會在實際運作中的端點進行兩項測量,以取代估算。Q_max 是單一執行個體在違反 SLO 前可持續承載的最高並行請求數;T_total 則是完整擴展所需的時間。我們以這兩個數字計算擴展門檻、縮減門檻,以及兩種冷卻時間。本文所有數字,均來自實際部署,以及對本文引用的 aws-samples 儲存庫進行的測量。
為甚麼預設自動擴展指標不適用於 TTS
大部分有關 Amazon SageMaker AI 自動擴展的公開指南,針對的是短時間的同步請求/回應呼叫,或大型語言模型(LLM)服務;後者自然會採用每秒生成的 token 數作為指標。TTS 合成不屬於這兩種模式:單一請求會令連線保持開啟數秒,期間沒有可掛接指標的 token 生成迴圈。Kokoro-82M 是非自回歸模型,屬於 StyleTTS2 衍生模型,採用 ISTFTNet 解碼器,並以對抗方式訓練,而非透過自回歸的下一個 token 預測或迭代去噪。它只需經過一次按時長對齊的處理,便能生成完整語音片段。根本沒有生成迴圈可供加入逐 token 指標。判斷 TTS 執行個體是否過載,其實比想像中簡單:當下有多少請求正在排隊及處理。
部署的策略會以 ConcurrentRequestsPerModel 作為擴展依據;這是 Amazon SageMaker AI 原生提供的指標,不需要由本專案容器的程式碼自行發出。採用 Amazon SageMaker AI 提供的指標進行擴展,可避免一類常見故障:自訂指標設定看似正確,實際上卻沒有任何內容發佈至該指標。
ConcurrentRequestsPerModel 會發布 10 秒時間窗內的 Maximum 統計值,這與基準測試用戶端直接量度的平均在途請求數不同。這套工具會處理兩者之間的差異。在並發量階梯的每一級,工具都會在相同負載下量度這兩個數值,並記錄兩者的比率。然後,工具會用這個比率將用戶端量得的閾值轉換為 Amazon CloudWatch 使用的單位,再寫入可部署的設定。在本文的 Kokoro-82M 測試中,每一級量得的比率均正好是 1.0,因此用戶端量得的閾值與 Amazon CloudWatch 回報的閾值完全一致。
解決方案概覽
此解決方案會在 Amazon SageMaker AI 即時端點上,以自訂容器部署 Kokoro-82M,然後以兩項在該實際運作中的端點上量度所得的數據,取代憑估算設定的自動擴展目標:Q_max,即單一執行個體在符合 SLO 的情況下可服務的並發上限;以及 T_total,即實際擴展所需的時間。語音合成請求會經過四個層面:用戶端、Amazon SageMaker AI 端點、該端點後方 GPU 執行個體上的自訂容器,以及容器內的 Kokoro-82M 模型。
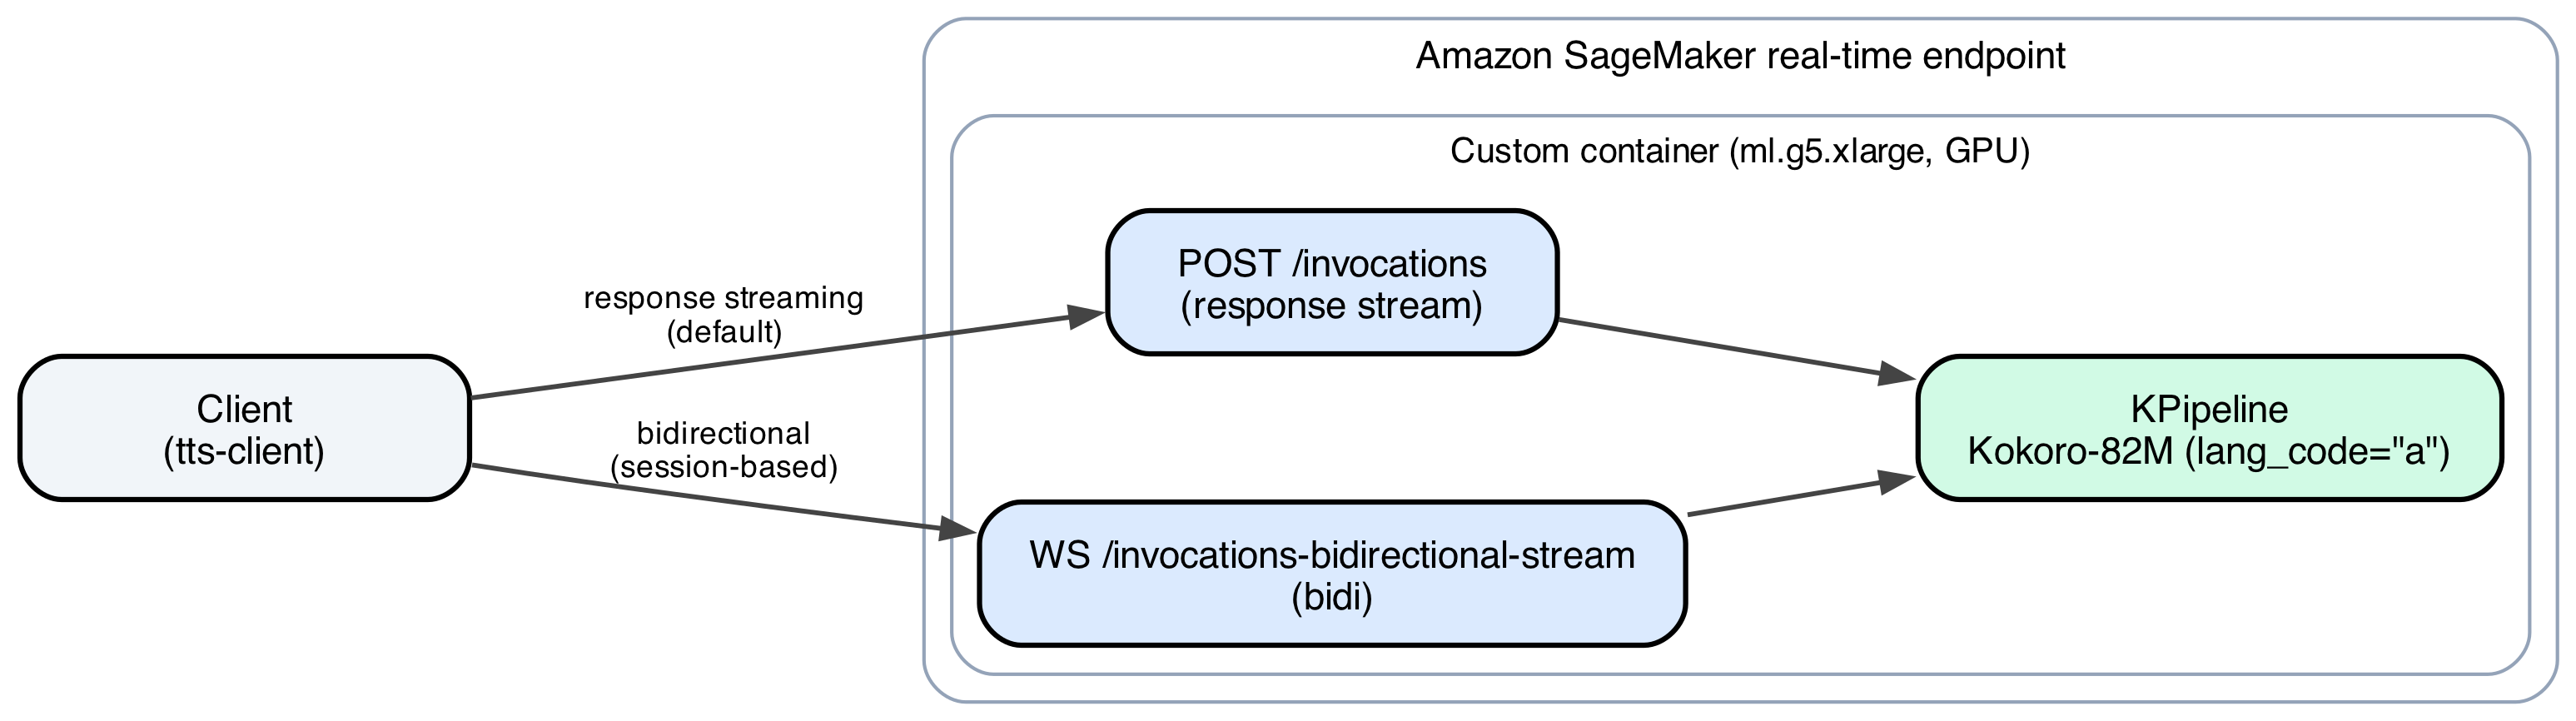
圖 1:Kokoro-82M 的請求路徑,從用戶端經過 Amazon SageMaker AI 端點和自訂容器,到達模型
容器支援兩種傳輸模式:回應串流(InvokeEndpointWithResponseStream),會在音訊合成過程中即時串流傳回,讓語音尚未合成完成,播放便可開始;以及雙向串流(InvokeEndpointWithBidirectionalStream),會保持同一個長時間開啟的工作階段,以處理多則訊息。
在自訂容器中執行 Kokoro-82M,而非透過託管推理工具套件執行,令本文其餘部分得以實現。由你控制的容器可自行實施准入限制,並公開 Amazon SageMaker AI 已發布的精確並發訊號,而不必把借用的指標硬套在並非為此設計的工作負載上。負責部署此端點的 AWS CDK 堆疊,只有在模型已有實際量度所得的 plan 後,才會加入自動擴展資源,因此憑估算設定的配置絕不會在無聲無息間進入正式環境。本文其餘部分將説明這項量度。
先決條件
如要跟隨本教學操作,你需要:
- An AWS account with permissions to create AWS Identity and Access Management (IAM) roles, Amazon Simple Storage Service (Amazon S3) buckets, Amazon Elastic Container Registry (Amazon ECR) repositories, and Amazon SageMaker AI resources.
- 注意:範例容器固定使用較舊版本的 PyTorch,而該版本有已知安全公告(
PYSEC-2026-2286,已在 torch 2.10.0 修正)。在任何概念驗證以外的用途前,請檢視並升級該版本固定設定。
- 注意:範例容器固定使用較舊版本的 PyTorch,而該版本有已知安全公告(
- 已安裝AWS CDK v2,並已在目標帳戶及區域完成 bootstrap。
- Python 3.11 或更新版本、uv,以及用於建置容器映像檔的 Docker。
- 執行本文的擴展測量前,
ml.g5.xlarge服務配額在基線用量之上至少須有一個可用名額。 - 本文提及的GitHub 儲存庫中的部署程式碼。
操作步驟
完成本教學後,你將會為 Kokoro-82M 建立一項正在運作的 Amazon SageMaker AI 自動擴展政策。該政策完全根據在你自己的端點上量度所得的兩項數據制定,而非憑估算得出。
部署端點堆疊
端點會透過三個 AWS CDK 堆疊依序部署:SpeechFoundationStack 會建立 IAM 角色和用於快取模型權重的 Amazon S3 儲存貯體;SpeechModelCacheStack 會將模型的 Hugging Face 權重同步至該儲存貯體一次;SpeechEndpointStack 會建置容器映像檔、將映像檔推送至 Amazon ECR,並建立 Amazon SageMaker AI 模型、端點設定及端點。
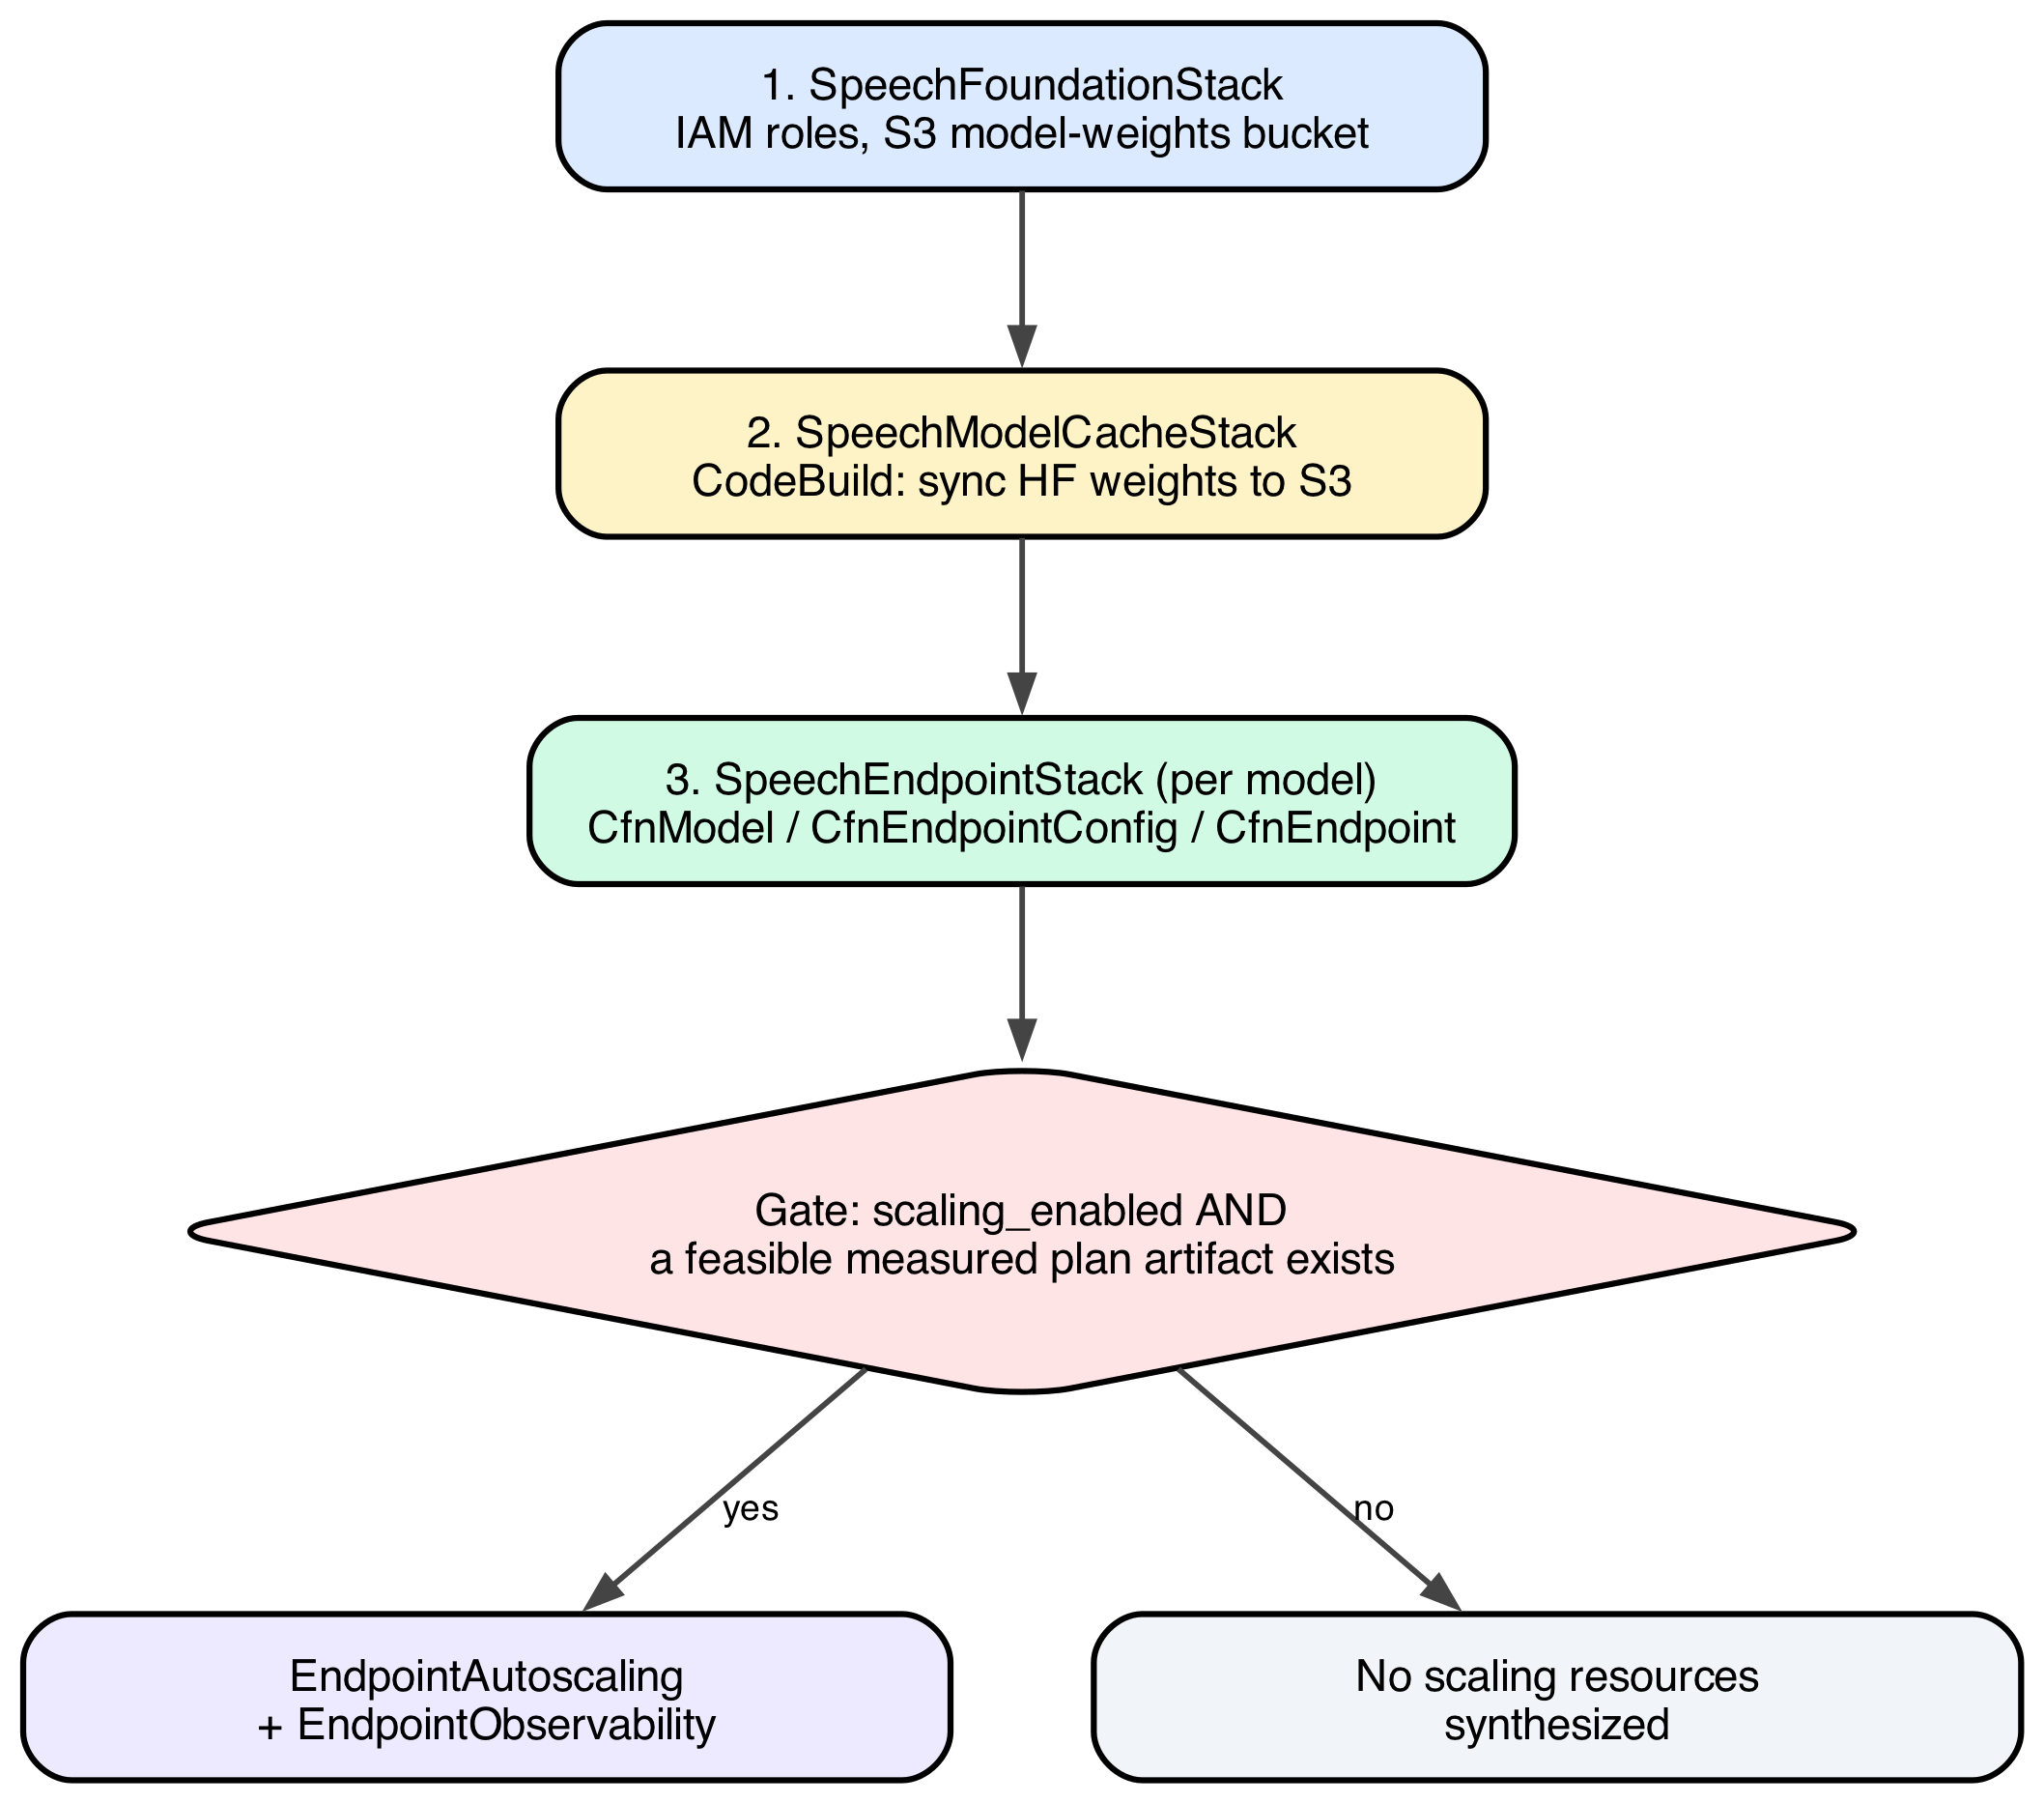
圖 2:三個 AWS CDK 堆疊,以及決定是否產生自動擴展資源的閘門
第三個堆疊中的閘門可防止預設、未經量度的擴展設定進入正式環境。scaling_enabled 是一個靜態旗標;只要 max_instances 設定值大於 min_instances,它便會設為 true,但單憑這個旗標,無法得知背後的數值是否曾經量度。堆疊會在合成時加入第二項獨立檢查:這個模型是否有真實可行的 plan 成品?只有兩項條件都成立時,堆疊才會合成擴展資源:一個 EndpointAutoscaling 構件,用於連接擴展政策和警示;以及一個 EndpointObservability 構件,用於加入監察該政策的儀錶板和警示。模型即使有 scaling_enabled=True,但沒有相關量度結果,也會與沒有 scaling_enabled=False 的模型一樣,輸出 沒有擴展資源。
專案的 CLI 以單一指令包裝三個堆疊,並按依賴次序執行:
uv run speech-infra deploy kokoro-82mSpeechModelCacheStack 會執行 AWS CodeBuild 專案,將模型的 Hugging Face 權重同步至快取的 Amazon S3 儲存貯體一次。端點冷啟動時便毋須從互聯網下載權重。通過前述 scaling_enabled 檢查後,SpeechEndpointStack 會建置容器映像、將映像推送至 Amazon ECR,並建立 Amazon SageMaker AI 模型、端點設定和端點。
此方法會打包成命令列工具鏈,並按固定次序執行:

圖 3:按次序執行的工具鏈,每個指令都會將成品交給下一個指令
步驟 1:檢查漂移
drift 每次都會先執行,早於任何會耗費金錢或令端點承受負載的操作。它會以唯讀方式核對實際部署的內容(可擴展目標、擴展政策、警示狀態)與設定檔所述的部署內容。否則,先前模型留下的孤立政策,或已停止或取消的 qmax 或 ttotal 執行,都可能在量度期間悄悄改變容量,令量度數據失準。
uv run tts-bench drift若結果正常,系統會回報沒有不一致項目,並以 preflight-ok 狀態結束,讓你可以繼續執行 qmax。已停止或取消的 qmax 或 ttotal 執行,是最常見的已回報不一致來源,因為它可能令自動擴展停留在單一執行個體。繼續之前,uv run tts-bench thaw --endpoint speech-kokoro-82m 會還原已部署的政策,因為 qmax 和 ttotal 都假設已部署狀態與設定檔完全一致。
步驟 2:量度 Q_max,即並行處理上限
Q_max 是仍可令請求在 SLO 時限內、以第 95 百分位到達首個音訊位元組的最大並行數;並行數即一個執行個體上排隊中的請求數加上正在執行的請求數。量度方式是閉環負載梯級測試:將並行數 N 固定在指定值,然後逐級提高 N,直至未能符合 SLO。閉環測試可避免協調遺漏問題;在固定到達率測試中,伺服器變慢會令用戶端減少發送請求,而非呈現真實的排隊延遲,這正是該問題的缺陷。
uv run tts-bench qmax --model kokoro-82m --dry-run
uv run tts-bench qmax --model kokoro-82m
--dry-run 會列印執行時間表和實際耗時估算,過程中不會呼叫 AWS,讓你可以先預算即時執行約 36 分鐘所需的成本。即時指令會在執行期間暫停自動擴展,並將容量固定為一個執行個體;指令結束時會自動還原,因此得出的數值是真正的單一執行個體上限。
負載梯級測試記錄了以下結果:
| 並行數 | p95 TTFAB(毫秒) | 符合 3,000 毫秒 SLO? |
| 1 | 65.4 | 是 |
| 5 | 286.2 | 是 |
| 10 | 568.5 | 是 |
| 20 | 1,129.3 | 是 |
| 30 | 1,689.8 | 是 |
| 40 | 2,245.0 | 是 |
| 50 | 2,805.7 | 是(Q_max) |
| 60 | 3,374.8 | 否(超出限制) |
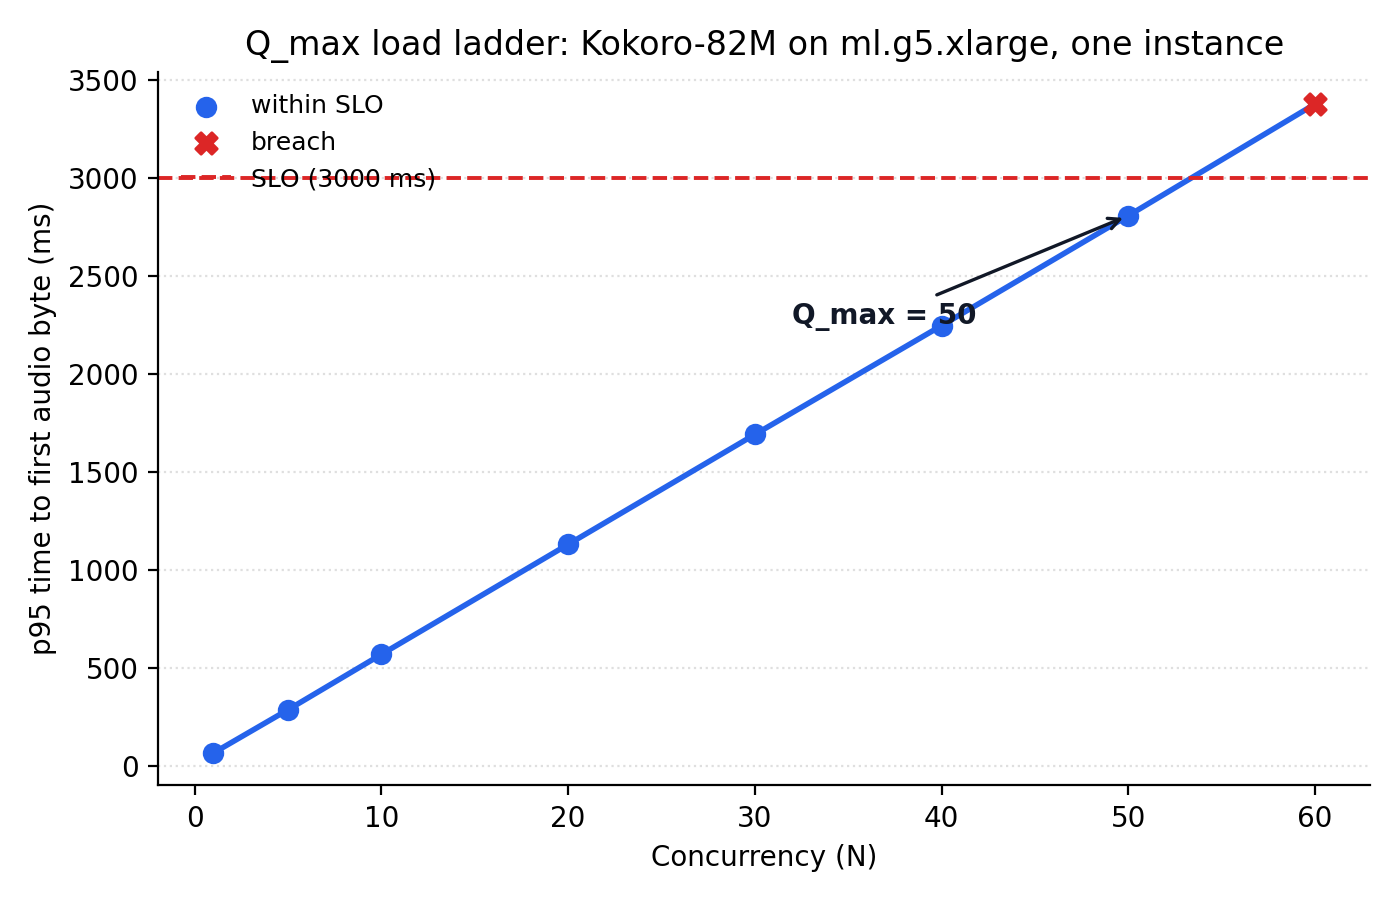
圖 4:p95 首個音訊位元組時間與並行數的關係,並標示 SLO 線及並行數 60 時的超出限制點
Q_max = 50,而且結果已界定出範圍:第 60 級實際超出 SLO,因此 50 是實際上限,而非下限。同一次測試亦量度了無競爭服務時間,即完全沒有排隊時單一請求所需的時間:平均值 61.3 ms,p95 為 66.1 ms。這個數值會觸發本文稍後介紹的另一項獨立警報。
步驟 3:量度 T_total,即實際擴展時間
T_total是指從要求增加容量,到新增容量開始承載健康流量,實際經過的時間。量度方法是直接強制擴展,略過已部署政策本身的偵測邏輯,然後為每個可辨識階段記錄時間戳記。
uv run tts-bench ttotal --model kokoro-82m --qmax <qmax-artifact>ttotal需要以 qmax 產物作為輸入,因為它會根據該階梯實際量度出的級別作出復原判斷,而且不會使用透過不同網絡傳輸方式量度的階梯資料執行。
強制擴展分為八個量度階段:
| 階段 | 所需時間 | 佔 T_total 的比例 |
| 提出容量請求至 desired_set | 30.0 s | 9.4% |
| desired_set 至日誌中顯示執行個體 | 180.8 s | 56.5%(佔比最高) |
| 日誌中顯示執行個體至容器啟動 | 3.7 s | 1.2% |
| 容器啟動至 framework_init | 0.0 s | 0.0% |
| framework_init 至 weights_ready | 6.5 s | 2.0% |
| weights_ready 至 warmup_done | 1.0 s | 0.3% |
| warmup_done 至 in_service | 20.7 s | 6.5% |
| in_service 至流量恢復 | 47.4 s | 14.8% |
| 量度所得總時間(t_total_s) | 260.2 s | |
| + 政策偵測延遲上限(未經量度) | 60.0 s | |
| 規劃採用的 T_total | 320.2 s |
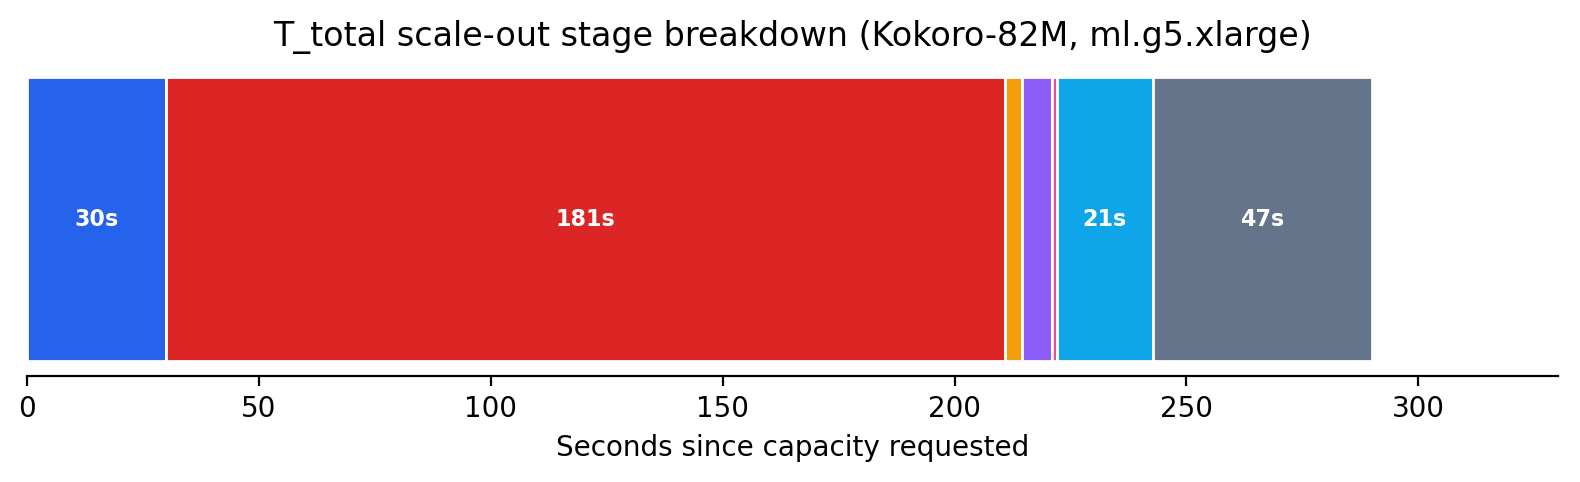
圖 5:實際擴展的八個量度階段,從提出容量請求到流量恢復
佔比最高的階段是 Amazon Elastic Compute Cloud (Amazon EC2) 執行個體佈建,加上容器映像檔拉取,需時 181 秒,佔規劃採用總時間的 56%。要大幅縮短 T_total,關鍵不是修改應用程式代碼,而是縮小映像檔,或使用預熱容量集區。從「日誌中顯示執行個體」開始的所有後續階段合計只有 79 秒,相對較短。
在量度所得的 260.2 秒上加計的 60 秒,並非本次測試的量度結果。這個上限是根據政策本身的設定估算(警報評估週期乘以評估週期數,再加上冷卻時間),因為本次測試刻意略過政策的偵測邏輯,以便單獨量度純粹的佈建時間。plan會根據完整的 320.2 秒總時間計算突增流量所需的餘裕,因為這段反應時間是任何正式環境擴展過程的實際一部分,即使本次量度並未涵蓋它。
步驟 4:使用 plan 推導已部署政策
plan是唯一不會接觸 AWS 的指令。它會讀取 qmax 和 ttotal 產物,結合兩項由操作人員選定的輸入:3,000 ms p95 TTFAB 的 SLO,以及 1.25x 的突增比例(執行個體羣組可在一個擴展週期內承受流量增長 25 percent,而不會違反 SLO),並進行以下計算。然後,它會輸出報告,為每項結果提供判定:ok、warn,若計劃確實無法實行,則為 stop。
uv run tts-bench plan --qmax <qmax-artifact> --ttotal <ttotal-artifact> --peak-rps 5000--peak-rps旗標(此處為每秒 5,000 個請求,並假設低谷流量為 10)用於計算執行個體羣組的規模,不會納入以下門檻計算。
h  = surge_ratio - 1                    = 1.25 - 1 = 0.25

C_scale_max = (1 - h)     x Q_max       = 0.75 x 50   = 37.50
C_scale_min = (1 - 2h)    x Q_max       = 0.50 x 50   = 25.00

W_max = SLO - S_p95 = 3.000s - 0.066s = 2.934sC_scale_max是再新增一個執行個體的併發量門檻,會比 Q_max 低 h 的突增比例,讓執行個體羣組在要求增加容量時仍有佇列餘裕。C_scale_min是移除一個執行個體的併發量門檻,設為 Q_max 的 (1 - 2h),確保負載大幅低於再次觸發擴展的水平後,才會觸發縮減。
最終部署的設定,完全按照工具產生的內容:
"kokoro-82m": ModelEndpointConfig(
    model_name="kokoro-82m",
    instance_type="ml.g5.xlarge",
    min_instances=1,             # trough 10 rps; 3 is the smallest safe floor for scale-in
    max_instances=9,             # peak 5000 rps
    scaling_target_value=37.500, # C_scale_max, in Amazon CloudWatch units (ratio measured as 1.0)
    scale_in_threshold=25.000,   # C_scale_min, in Amazon CloudWatch units
    ttfab_slo_ms=3000,
    queue_max_depth=50,          # enforced by the container's own admission gate
    scale_out_cooldown_s=30,     # short: one instance added at a time
    scale_in_cooldown_s=960,     # long: see below
)
兩項冷卻時間刻意採用不對稱設定。擴展時即使判斷錯誤,代價也很低:最壞情況是,為一個其實不需要的執行個體多付 30 秒的費用。縮減的代價則不對稱,因為移除後又再次需要的容量,重新補回要花完整的 T_total(320 秒)。縮減冷卻時間設為約 T_total 的三倍,確保只有當負載確實持續下降後,才會觸發縮減決策。
容器本身的准入控制會另外強制執行 queue_max_depth=50,其值等於 Q_max:超過該深度後,請求會立即遭拒,並傳回 503 queue_saturated 回應,而不會繼續排隊至已無法符合 SLO 的程度。FirstChunkLatencyP95 警報會監察已在提供服務的執行個體上的服務時間,門檻設為 65 ms(並行數為 1 時測得的 p95 服務時間);這比包含排隊時間的端到端 SLO 更嚴格。
Kokoro-82M 測試有兩項發現值得一提,因為這些是工具正確指出的已知且已接受的取捨,而非缺陷:
surge_survival(警告):將C_scale_max(37.5)維持在Q_max(50)之下,會令一個執行個體在觸發擴展的一刻便達到 97.4% 使用率,而新增執行個體需要完整等待T_total才能到位。突增比率會預留額外的佇列位置,但要撐過實際流量突增,關鍵在於流量,也就是佇列排空的速度;使用率達 97.4% 時,流量處理餘裕所剩無幾。scale_in_safety(警告):從由N個執行個體組成的叢集中移除一個執行個體,會令其餘每個執行個體的並行數乘以N / (N-1)。只有當該比率低於C_scale_max / C_scale_min(此處為 1.5)時,縮減才會保持穩定,而這需要N >= 3。最低容量設為 1 個執行個體時,從 2 個縮減至 1 個會令剩餘執行個體的並行數恰好達到Q_max,再次回到觸發擴展的上限。較長的冷卻時間可減輕這種反覆震盪,但無法完全消除。將最低容量提高至 3,即可從架構上消除這種情況,但低流量期間會因此維持更多容量。
每個 qmax 或 ttotal 產物的檔名,都會編碼其測量所依據的設定,並將執行個體類型及容器映像檔摘要濃縮成 slug(例如 g5xlarge-8b1b96bc)。ttotal 和 plan 都會拒絕配對指紋不一致的產物。透過 --allow-config-mismatch 可將此行為降級為警告,但預設會拒絕配對。
步驟 5:使用 validate 確認已部署的政策
validate 是指令鏈中的最後一個指令,也是第二個不會修改任何內容的指令,另一個是 drift。它會將實際部署的擴縮政策與 plan 產物中的數值比較,確認兩者相符後,你才可將設定視為已生效。
uv run tts-bench validate --model kokoro-82m --plan <plan-artifact>結果沒有問題,即確認已部署的可擴縮目標上的 scaling_target_value、scale_in_threshold 及兩項冷卻時間,均與 plan 推導出的內容相符。任何不一致都表示已部署的政策與測量所得的計劃出現偏差,應先解決問題,再依賴端點的自動擴縮行為。
測試與驗證
本文提及的每個 qmax、ttotal 及 plan 產物,都是已提交至儲存庫的檔案,而非一次性的本機輸出。前述完整操作範例,包括其中每個數字,均可透過使用兩個已提交的測量檔案重新執行 plan,獨立重現;整個過程不會呼叫 AWS,亦不會產生任何新費用:
$ uv run tts-bench plan --qmax <qmax-artifact> --ttotal <ttotal-artifact> --peak-rps 5000
scaling_target_value : 37.500 (C_scale_max)
scale_in_threshold    : 25.000 (C_scale_min)
surge_survival        : warn
scale_in_safety       : warn
清理
若要移除本操作指南中建立的資源,只需執行一條指令,按相反次序拆除各堆疊:
uv run speech-infra destroy kokoro-82mspeech-infra destroy 會移除 Amazon SageMaker AI 模型、端點設定、端點,以及與其連接的任何自動擴展或 Amazon CloudWatch 資源。它不會清空用來快取模型權重的 Amazon S3 儲存貯體,也不會刪除存放容器映像檔的 Amazon ECR 儲存庫,因為這兩者都可以由多個模型共用。如果不再需要這些資源,請手動清空並刪除 Amazon S3 儲存貯體,以及移除 Amazon ECR 儲存庫;已儲存的模型檢查點和容器映像檔在移除前仍會產生少量儲存費用。
結論
在 Amazon SageMaker AI 即時端點上以自訂容器部署 Kokoro-82M,並以兩項在實際運作中的端點上取得的量度,取代憑估計作決定:Q_max,即單一執行個體在違反 SLO 前可維持的最高並行請求數;以及 T_total,即實際擴展所需的時間。根據這兩個數值,便可透過計算得出擴展閾值、縮減閾值,以及兩個冷卻時間。以 ConcurrentRequestsPerModel 作為擴展依據(這是 AWS 發佈的原生指標),並直接量度其單位換算,而非自行假設,才能讓這項設定反映實際並行請求數。
最終得到的自動擴展政策,每個數值都有根據,均源自對你自己的端點所作的實際量度,而非沿用其他工作負載模式的假設。這個分別能把設定檔中的猜測——可能在不知不覺間多付費用,或違反 SLO——轉化為一套有據可依的政策,其並行請求數上限和擴展所需時間都有實際量度支持,而非單憑聲稱。
這套由四個數值組成的模型並非 TTS 專用:選定 SLO 和突增比率,量度 Q_max 和 T_total,再推算其餘數值。它適用於對延遲敏感、受並行請求數限制的 Amazon SageMaker AI 即時端點。例如,即時圖像嵌入端點會在 GPU 前向傳播期間保持每個請求處於開啟狀態,其限制因素同樣是並行請求數上限,而非吞吐量指標。相同的 qmax/ttotal/plan 流程可原樣套用。那裏的真正瓶頸是同時處理中的請求,而非從不同工作負載模式借用的吞吐量指標。此處的具體數值 Q_max=50 和 T_total=320s 適用於在 ml.g5.xlarge 上運行的 Kokoro-82M。換用其他模型或執行個體類型,數值便會不同;產生這些數值的方法和工具則不變。這五個命令組成的工具鏈——drift、qmax、ttotal、plan 和 validate——可原樣套用於下一個以此方式部署的模型。
複製範例儲存庫,然後對你自己的端點執行這五個命令:drift、qmax、ttotal、plan 和 validate,以制定一套經量度驗證的政策。參閲Amazon SageMaker AI 自動擴展文件,按你的 SLO 調整閾值,並開啟 SageMaker AI 主控台,觀察政策如何因應即時流量。如需協助建立類似以量度為本的部署,請聯絡你的 AWS 帳戶團隊。
作者簡介

Joseph Cottingham
Joseph 是 AWS Generative AI Innovation Center 的機器學習工程師,負責設計和交付 AI 系統,協助組織把構想轉化為正式投入生產的方案。他的技術背景涵蓋韌體、軟件和機器學習,並專精於高吞吐量、事件驅動架構,確保 AI 工作負載在大規模運作時保持高效能。Joseph 專注於尖端研究與實際營運的交匯點,交付能切實改變組織及其運作系統的解決方案。
來源:AWS Machine Learning Blog · aws.amazon.com