Code Llama 推出 7B、13B、34B 參數規模的編碼模型
Code Llama: Llama 2 learns to code
Code Llama 推出 7B、13B 和 34B 參數版本,是以 Llama 2 為基礎、專攻編碼任務的模型家族。基礎模型以 500 billion tokens 的程式碼資料訓練,另有 Python 專用版和指令微調版;模型採用與 Llama 2 相同的社羣授權,可商用。
文章並列 7B、13B、34B 參數規模、Python 與指令微調變體,以及 Hugging Face 接入方式,便於比較模型選擇和部署路徑。
簡介
Code Llama 是一系列以程式碼任務為主的 Llama 2開放存取頂尖版本,我們很高興把整合成果帶到 Hugging Face 生態系統!Code Llama 採用與 Llama 2 相同、寬鬆的社羣授權,亦可用於商業用途。
今天,我們很高興發布以下內容:
- Hub 上的模型,附有模型卡和授權條款
- Transformers 整合
- 整合至 Text Generation Inference,支援快速、高效率、適用於正式環境的推理
- 整合至 Inference Endpoints
- 整合至 VS Code 擴充功能
- 程式碼基準測試
程式碼大型語言模型是軟件工程師令人期待的新工具,因為它們可以透過 IDE 程式碼補全提升工作效率、代寫文件字串等重複或煩瑣工作,亦可建立單元測試。
目錄
甚麼是 Code Llama?
Code Llama 推出一系列模型,參數規模分別為 7、13 和 34 billion。基礎模型以 Llama 2 為起點,再使用 500 billion 個程式碼 token 訓練。Meta 以這些基礎模型微調出兩種不同版本:專精 Python 的版本(額外使用 100 billion 個 token 訓練),以及能理解自然語言指令的指令微調版本。
這些模型在 Python、C++、Java、PHP、C#、TypeScript 和 Bash 等語言中展現頂尖表現。7B 和 13B 基礎版及指令版均支援根據周邊內容填入程式碼,非常適合作為程式碼助理。
Code Llama 的訓練脈絡視窗為 16k。除此之外,三種模型版本都經過額外的長脈絡微調,能處理最長 100,000 個 token 的脈絡視窗。
透過近期 RoPE 縮放技術的發展,Llama 2 的 4k 脈絡視窗得以擴展至 Code Llama 的 16k,並可外推至 100k。社羣發現,可以在線性空間或頻率域內插值 Llama 的位置嵌入,透過微調更容易轉換至較大的脈絡視窗。Code Llama 採用頻率域縮放時會保留餘量:微調長度只佔縮放後預訓練長度的一部分,令模型具備強大的外推能力。
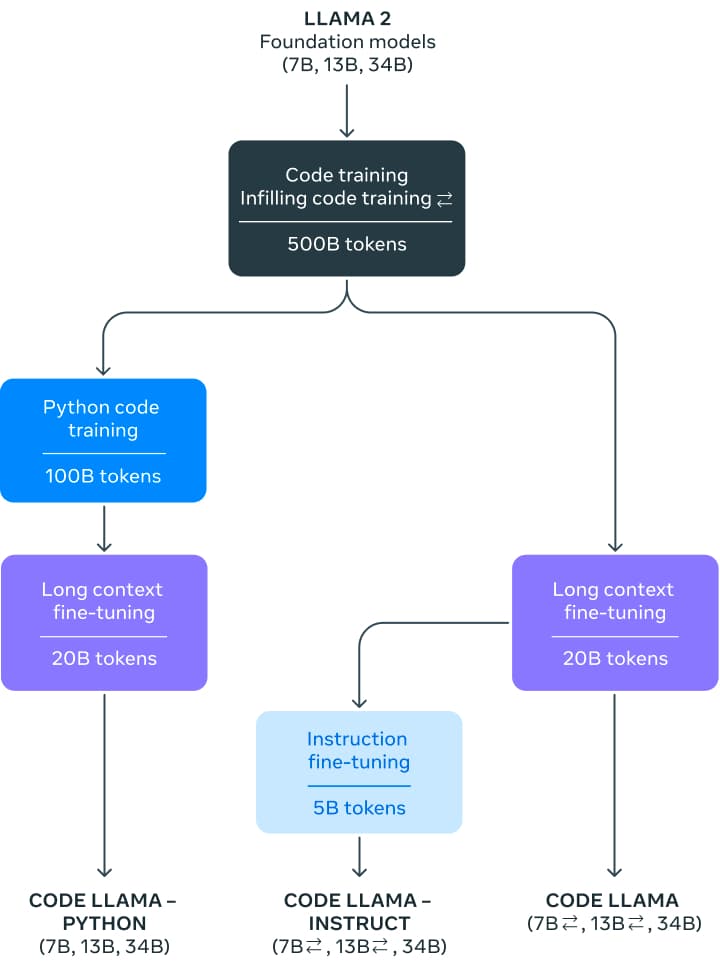
所有模型最初都使用 500 billion 個 token,在接近去重的公開程式碼資料集上訓練。資料集亦包含部分自然語言資料,例如程式碼討論和程式碼片段。可惜,目前沒有更多資料集細節。
指令模型使用了兩個資料集:為 Llama 2 Chat 收集的指令微調資料集,以及自我指令資料集。後者使用 Llama 2 編寫程式設計面試題,再使用 Code Llama 生成單元測試和解答,最後透過執行測試進行評估。
如何使用 Code Llama?
Code Llama 已整合至 Hugging Face 生態系統,支援 transformers 4.33 版本起的版本。
示範
你可以在 這個 Space 輕鬆試用 Code Llama 模型(13 billion 參數!),或使用下方嵌入的互動環境:
這個互動環境使用 Hugging Face 的 Text Generation Inference,與 HuggingChat 使用相同技術;我們會在以下章節介紹更多詳情。
如果你想試用較大型的 34B 指令微調模型,它現在已在 HuggingChat 推出!可在此試用:hf.co/chat。記得選擇 Code Llama 模型。你亦可查看這個聊天示範,並複製一份供自己使用。示範自成一體,你可以檢視原始碼並按需要調整!
Transformers
從 transformers 4.33 起,你可以使用 Code Llama,並運用 HF 生態系統中的所有工具,例如:
- 訓練和推理程式碼及示例
- 安全檔案格式(
safetensors) - 與
bitsandbytes(4-bit 量化)和 PEFT(參數高效微調)等工具整合 - 使用模型執行生成的工具和輔助程式
- 匯出模型以供部署的機制
!pip install --upgrade transformers
關於資料類型的注意事項
使用 Code Llama 等模型時,請留意模型的資料類型。
- 32-bit 浮點數(
float32):PyTorch 慣例是在初始化模型時一律以float32載入,不論模型權重原本以何種精度儲存。為配合 PyTorch,transformers亦遵循這項慣例。 - 16-bit Brain 浮點數(
bfloat16):Code Llama 使用這種精度訓練,因此我們建議後續訓練或微調時使用。 - 16-bit 浮點數(
float16):我們建議推理時使用這種精度,因為它通常比bfloat16快,而評估指標顯示相較於bfloat16沒有明顯退化。你亦可使用bfloat16執行推理;微調後,我們建議分別以float16和bfloat16檢查推理結果。
如上所述,transformers 會以 float32 載入權重(不論模型以何種精度儲存),因此載入模型時必須指定所需的 dtype。若要微調 Code Llama,建議使用 bfloat16,因為使用 float16 可能導致溢位和 NaN。執行推理時,我們建議使用 float16,因為 bfloat16 可能較慢。
程式碼補全
7B 和 13B 模型可用於文字/程式碼補全或填入。以下程式碼片段使用 pipeline 介面示範文字補全。只要選用 GPU 執行環境,即使使用 Colab 免費方案亦能運作。
from transformers import AutoTokenizer
import transformers
import torch

tokenizer = AutoTokenizer.from_pretrained("codellama/CodeLlama-7b-hf")
pipeline = transformers.pipeline(
    "text-generation",
    model="codellama/CodeLlama-7b-hf",
    torch_dtype=torch.float16,
    device_map="auto",
)

sequences = pipeline(
    'def fibonacci(',
    do_sample=True,
    temperature=0.2,
    top_p=0.9,
    num_return_sequences=1,
    eos_token_id=tokenizer.eos_token_id,
    max_length=100,
)
for seq in sequences:
    print(f"Result: {seq['generated_text']}")
輸出可能類似以下內容:
Result: def fibonacci(n):
    if n == 0:
        return 0
    elif n == 1:
        return 1
    else:
        return fibonacci(n-1) + fibonacci(n-2)

def fibonacci_memo(n, memo={}):
    if n == 0:
        return 0
    elif n == 1:
        return
Code Llama 專精程式碼理解,但本身仍是語言模型。你可以使用相同的生成策略,自動補全註解或一般文字。
程式碼填入
這是程式碼模型專有的任務。模型會學習生成最符合現有前綴和後綴的程式碼(包括註解)。程式碼助理通常採用這種策略:根據遊標位置之前和之後的內容,填入遊標目前所在的位置。
7B 和 13B 模型的基礎版和指令版均支援這項任務;任何 34B 模型或 Python 版本都不支援。
要成功使用這項功能,必須留意模型訓練此任務時所用的格式,因為格式會以特殊分隔符標示提示的不同部分。幸好,transformers 的 CodeLlamaTokenizer 讓整個流程非常簡單,如下方示例所示:
from transformers import AutoTokenizer, AutoModelForCausalLM
import transformers
import torch

model_id = "codellama/CodeLlama-7b-hf"
tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    torch_dtype=torch.float16
).to("cuda")

prompt = '''def remove_non_ascii(s: str) -> str:
    """ <FILL_ME>
    return result
'''

input_ids = tokenizer(prompt, return_tensors="pt")["input_ids"].to("cuda")
output = model.generate(
    input_ids,
    max_new_tokens=200,
)
output = output[0].to("cpu")

filling = tokenizer.decode(output[input_ids.shape[1]:], skip_special_tokens=True)
print(prompt.replace("<FILL_ME>", filling))
def remove_non_ascii(s: str) -> str:
    """ Remove non-ASCII characters from a string.

    Args:
        s: The string to remove non-ASCII characters from.

    Returns:
        The string with non-ASCII characters removed.
    """
    result = ""
    for c in s:
        if ord(c) < 128:
            result += c
    return result
在底層,tokenizer 會自動按 <FILL_ME> 分割,建立符合原始訓練模式的格式化輸入字串。這比自行準備格式更穩妥:可避免 token 黏連等極難除錯的問題。
對話指令
如上所述,基礎模型可用於補全和填入。Code Llama 亦推出了指令微調模型,可用於對話介面。
要準備這項任務的輸入,必須使用類似我們 Llama 2 網誌文章所述的提示範本,以下再次列出:
<s>[INST] <<SYS>>
{{ system_prompt }}
<</SYS>>

{{ user_msg_1 }} [/INST] {{ model_answer_1 }} </s><s>[INST] {{ user_msg_2 }} [/INST]
請注意,系統提示是可選的。沒有系統提示,模型也能運作;但你可以用它進一步設定模型的行為或風格。例如,如果你想模型一律用 JavaScript 回答,可在此説明。系統提示之後,要提供對話中所有先前互動:使用者問了甚麼,模型又回答了甚麼。與填入任務一樣,必須留意使用的分隔符。輸入的最後部分必須是新的使用者指令,用來提示模型作答。
以下程式碼片段示範範本的實際運作方式。
- 第一個使用者查詢,不含系統提示
user = 'In Bash, how do I list all text files in the current directory (excluding subdirectories) that have been modified in the last month?'

prompt = f"<s>[INST] {user.strip()} [/INST]"
inputs = tokenizer(prompt, return_tensors="pt", add_special_tokens=False).to("cuda")
- 第一個使用者查詢,附有系統提示
system = "Provide answers in JavaScript"
user = "Write a function that computes the set of sums of all contiguous sublists of a given list."

prompt = f"<s>[INST] <<SYS>>\\n{system}\\n<</SYS>>\\n\\n{user}[/INST]"
inputs = tokenizer(prompt, return_tensors="pt", add_special_tokens=False).to("cuda")
- 包含先前回覆的進行中對話
流程與 Llama 2 相同。為求最清晰易懂,我們沒有使用迴圈,也沒有把示例程式碼泛化:
system = "System prompt"
user_1 = "user_prompt_1"
answer_1 = "answer_1"
user_2 = "user_prompt_2"
answer_2 = "answer_2"
user_3 = "user_prompt_3"

prompt  = f"<<SYS>>\n{system}\n<</SYS>>\n\n{user_1}"
prompt  = f"<s>[INST] {prompt.strip()} [/INST] {answer_1.strip()} </s>"
prompt += f"<s>[INST] {user_2.strip()} [/INST] {answer_2.strip()} </s>"
prompt += f"<s>[INST] {user_3.strip()} [/INST]"

inputs = tokenizer(prompt, return_tensors="pt", add_special_tokens=False).to("cuda")
載入 4-bit 模型
Code Llama 整合至 Transformers 後,亦立即支援載入 4-bit 模型等進階功能。這樣可在 NVIDIA 3090 等消費級 GPU 上運行大型 32B 參數模型!
以下示範如何以 4-bit 模式執行推理:
from transformers import AutoTokenizer, AutoModelForCausalLM, BitsAndBytesConfig
import torch

model_id = "codellama/CodeLlama-34b-hf"
quantization_config = BitsAndBytesConfig(
   load_in_4bit=True,
   bnb_4bit_compute_dtype=torch.float16
)

tokenizer = AutoTokenizer.from_pretrained(model_id)
model = AutoModelForCausalLM.from_pretrained(
    model_id,
    quantization_config=quantization_config,
    device_map="auto",
)

prompt = 'def remove_non_ascii(s: str) -> str:\n    """ '
inputs = tokenizer(prompt, return_tensors="pt").to("cuda")

output = model.generate(
    inputs["input_ids"],
    max_new_tokens=200,
    do_sample=True,
    top_p=0.9,
    temperature=0.1,
)
output = output[0].to("cpu")
print(tokenizer.decode(output))
使用 text-generation-inference 和 Inference Endpoints
Text Generation Inference 是 Hugging Face 開發、適用於正式環境的推理容器,方便部署大型語言模型。它具備連續批次處理、token 串流、多 GPU 快速推理的張量平行處理,以及適用於正式環境的日誌和追蹤等功能。
你可以在自己的基礎設施試用 Text Generation Inference,亦可使用 Hugging Face 的 Inference Endpoints。要部署 Codellama 2 模型,請前往 模型頁面,再按一下 Deploy -> Inference Endpoints 小工具。
- 7B 模型建議選擇「GPU [medium] - 1x Nvidia A10G」。
- 13B 模型建議選擇「GPU [xlarge] - 1x Nvidia A100」。
- 34B 模型建議選擇「GPU [1xlarge] - 1x Nvidia A100」,並啟用
bitsandbytes量化,或選擇「GPU [2xlarge] - 2x Nvidia A100」
注意:你可能需要電郵至 api-enterprise@huggingface.co 申請提高配額,才能使用 A100。
你可以在這篇網誌瞭解如何使用 Hugging Face Inference Endpoints 部署大型語言模型。這篇 網誌 亦介紹了支援的超參數,以及如何使用 Python 和 Javascript 串流接收回應。
使用 VS Code 擴充功能
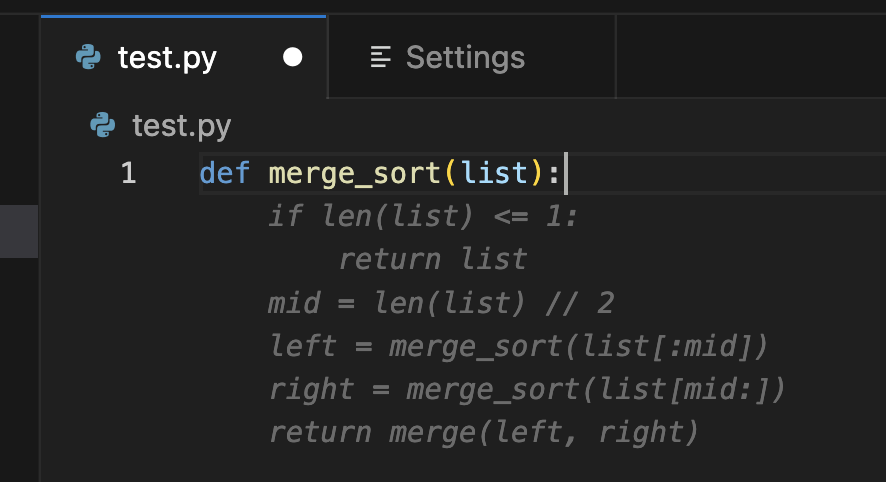
HF Code Autocomplete 是 VS Code 擴充功能,可用來測試開源程式碼補全模型。這項擴充功能是 StarCoder 專案的一部分,現已更新以支援中型基礎模型 Code Llama 13B。請在此處瞭解如何安裝擴充功能,以及如何搭配 Code Llama 執行。
評估
程式碼語言模型通常使用 HumanEval 等資料集進行基準測試。當中包含程式設計挑戰:模型會收到函式簽署和文件字串,並須完成函式主體。之後,系統會執行一組預先定義的單元測試,驗證提出的解答。最後回報通過率,表示有多少解答通過所有測試。pass@1 表示模型只產生一個候選解答時,解答通過測試的比率;pass@10 則表示在 10 個候選解答中至少有一個通過測試的比率。
HumanEval 是 Python 基準測試,但社羣已大力嘗試把它翻譯成更多程式語言,從而進行更全面的評估。MultiPL-E 就是其中一種方法,可把 HumanEval 翻譯成十多種語言。我們根據這項方法提供多語言程式碼排行榜,讓社羣比較不同模型在各種語言上的表現,評估哪個模型最適合自己的用途。
| 模型 | 授權 | 資料集已知 | 可用於商業用途? | 預訓練長度 [token] | Python | JavaScript | 排行榜平均分數 |
|---|---|---|---|---|---|---|---|
| CodeLlaMa-34B | Llama 2 授權 | ❌ | ✅ | 2,500B | 45.11 | 41.66 | 33.89 |
| CodeLlaMa-13B | Llama 2 授權 | ❌ | ✅ | 2,500B | 35.07 | 38.26 | 28.35 |
| CodeLlaMa-7B | Llama 2 授權 | ❌ | ✅ | 2,500B | 29.98 | 31.8 | 24.36 |
| CodeLlaMa-34B-Python | Llama 2 授權 | ❌ | ✅ | 2,620B | 53.29 | 44.72 | 33.87 |
| CodeLlaMa-13B-Python | Llama 2 授權 | ❌ | ✅ | 2,620B | 42.89 | 40.66 | 28.67 |
| CodeLlaMa-7B-Python | Llama 2 授權 | ❌ | ✅ | 2,620B | 40.48 | 36.34 | 23.5 |
| CodeLlaMa-34B-Instruct | Llama 2 授權 | ❌ | ✅ | 2,620B | 50.79 | 45.85 | 35.09 |
| CodeLlaMa-13B-Instruct | Llama 2 授權 | ❌ | ✅ | 2,620B | 50.6 | 40.91 | 31.29 |
| CodeLlaMa-7B-Instruct | Llama 2 授權 | ❌ | ✅ | 2,620B | 45.65 | 33.11 | 26.45 |
| StarCoder-15B | BigCode-OpenRail-M | ✅ | ✅ | 1,035B | 33.57 | 30.79 | 22.74 |
| StarCoderBase-15B | BigCode-OpenRail-M | ✅ | ✅ | 1,000B | 30.35 | 31.7 | 22.4 |
| WizardCoder-15B | BigCode-OpenRail-M | ❌ | ✅ | 1,035B | 58.12 | 41.91 | 32.07 |
| OctoCoder-15B | BigCode-OpenRail-M | ✅ | ✅ | 1,000B | 45.3 | 32.8 | 24.01 |
| CodeGeeX-2-6B | CodeGeeX 授權 | ❌ | ❌ | 2,000B | 33.49 | 29.9 | 21.23 |
| CodeGen-2.5-7B-Mono | Apache-2.0 | ✅ | ✅ | 1400B | 45.65 | 23.22 | 12.1 |
| CodeGen-2.5-7B-Multi | Apache-2.0 | ✅ | ✅ | 1400B | 28.7 | 26.27 | 20.04 |
注意:上表分數取自發布時的程式碼排行榜。隨着新模型推出,分數亦會改變,因為模型之間會互相比較。詳情請參閲排行榜。
其他資源
來源:Hugging Face Blog · huggingface.co